UserRL: Training Interactive User-Centric Agent via Reinforcement Learning
Salesforce AI Research
统一 gym 环境 + LLM 模拟用户的 user-centric agent RL 框架。系统比较 turn-level 与 trajectory-level reward 设计,结论:SFT cold-start 必要、deliberate trajectory scoring 更优、开源 simulator (Qwen3-32B) 是 GPT-4o 的可行替代。
核心思路
问题:把 agent 接进 RL 训练近来很火(multi-turn rollout 已成标配),但 agent 的终极价值是”帮到真人用户”,而真人交互具有 diversity(偏好/目标/沟通风格异质)和 dynamics(多轮过程中意图/约束会漂移)两大特性——现有训练 pipeline 既没有统一的方式去表示这些用户能力,也难以在训练中模拟真实、动态的交互。
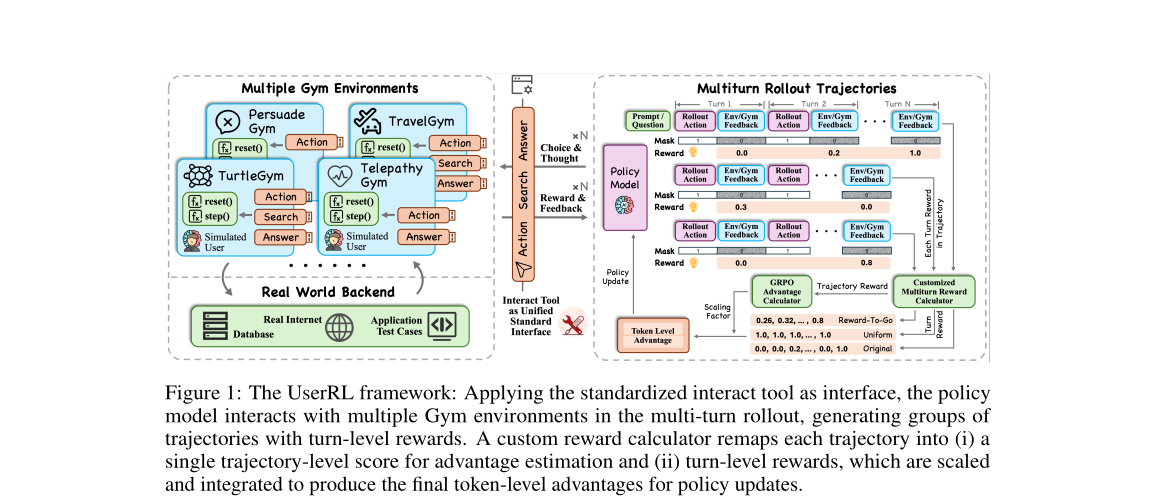
关键 idea:UserRL = 8 个统一 gym 环境 + LLM 模拟用户 + GRPO 多轮 RL,把”用什么 reward 形态、用哪种 simulator、要不要 SFT cold start”这些工程超参当成一等公民来做系统消融。框架的核心创新是把所有 agent-环境交互压缩成 Action / Search / Answer 三种标准操作(统一 interact_with_env tool 接口),并把奖励解耦成两个可独立替换的维度:turn-level reward shaping(一条轨迹内各 turn 怎么分信用)与 trajectory-level scoring(一条轨迹归一成一个标量给 GRPO 做组内归一化)。结论很务实:Equalized/R2G 最好、SFT cold start 是解锁交互能力的前提、开源 Qwen3-32B 当 simulator 训练完全可迁移到 GPT-4o 评测。
整体实现思路
端到端 pipeline 分三段:
-
Gym 构造:每个 gym =
task(确定性有限自动机,reset()初始化、step()按规则转移并吐出 turn reward,保证评测严格可复现)+user(某些 action 被解释成对模拟用户的输入,由 LLM 生成对话/偏好判断/答案,保证动态自然)。8 个 gym 用同一套 Action/Search/Answer 接口暴露,覆盖 intent 澄清、说服、海龟汤、读心、函数发现、旅行预订、工具调用、搜索问答。 -
SFT cold start:用 GPT-4o 同时扮演 agent 和 user 在 5 个训练 gym 里 rollout,按轨迹质量排序,每个 gym 取 top-K 凑成 1k 条蒸馏轨迹,做全参 SFT 初始化(LlamaFactory)。剩余所有训练 task(只需 task 描述,不需轨迹)进 RL。
-
多轮 GRPO RL:policy 通过
interact_with_envtool 与多个 gym 多轮交互,每个 query 采 8 条轨迹成一组,每条轨迹带 turn-level reward;自定义 reward calculator 把每条轨迹重映成 (i) 一个 trajectory-level 标量(做组内 advantage 归一化)和 (ii) 各 turn 的 turn-level reward(再 broadcast 到 token),二者整合成 token-level advantage 做 PPO-clip 更新(VERL 框架,去掉 KL loss 鼓励探索)。
子模块实现(可复现细节)
1. 标准化 Tool 接口(所有 gym 统一)
interact_with_env 是一个 function-call schema,参数只有两个:choice ∈ {action, answer, search} 和 content(string)。三种操作语义:
- Action:直接与模拟用户对话,content 是 utterance,gym 返回用户回复。
- Search:检索外部知识(工具列表、travel options、网页),gym 与后端交互返回检索内容。
- Answer:提交候选解,gym 按规则判对错(仅 goal-oriented 任务有 verifiable answer)。
每个 gym 可用的子集不同(如 PersuadeGym 只允许 Action,因为说服无 verifiable answer;TurtleGym 三种全开)。agent 每步先在 <think></think> 里推理再调 tool。
2. 八个 Gym 的奖励规则(逐个,含数值)
| Gym | 数据源 | 能力 | turn reward 规则(关键数值) | 是否 LLM-sim |
|---|---|---|---|---|
| IntentGym | IN3 | 意图理解/消歧 | 揭示 detail 重要度计分:High=1.0 / Med=0.7 / Low=0.4;每多覆盖一个 detail 罚 0.2(鼓励聚焦提问);两次 LLM call(response gen T=0.7 + coverage eval T=0.0) | 是 |
| PersuadeGym | Persuasion | 说服/策略推理 | 7 档立场 Strongly Agree(0)…Strongly Disagree(1),reward = 朝 disagree 移动的档数 / 6;回退或不变=0 | 是 |
| TurtleGym | 新造 | 创造性推理 | Action 返回 Yes/No/Maybe;Answer 按加权 criteria 打 {0, 0.5, 1.0}×权重;增量奖励:仅超过历史最佳分才给正 reward(差值),阈值 0.9 终止 | 是 |
| TelepathyGym | 新造 | 假设检验 | Action 返 Yes/No/Maybe;Answer 二值 {1.0 命中 / 0.0} | 是 |
| FunctionGym | 新造 | 数学推理/泛化 | Action 算隐藏函数(无 reward);Search 取测试用例;Answer 在 1e-6 容差内匹配=1.0 否则 0.0 | 否(纯规则) |
| TravelGym | UserBench | 偏好引导/个性化 | Action 分类 {1 普通/2 偏好相关/3 不可用/4 太模糊}→reward {0, 0.2, 0, 0};Search 成功=0.2(每 5 次模拟一次系统报错);Answer best=1.0 / correct-not-best=0.8 / wrong=罚 | 复用 UserBench |
| TauGym | Tau-Bench | 工具使用 | Action 对话;Search 取工具/help;Answer 执行工具调用,按 Tau-Bench 逐步打分;max_steps=30 | 复用 Tau-Bench |
| SearchGym | Bamboogle | 通用问答 | Search 走 Serper API(max 5 次,无 reward);Answer LLM judge(T=0.0)=1.0/0.0 | 是(仅判分) |
默认 max_steps=20(TauGym 30),step penalty 默认 0.0,reward scale 默认 1.0。FunctionGym 完全规则化无 LLM 用户。
3. 多轮 rollout 与符号
轨迹 ,,每 turn 对应生成 token 序列 ,gym 吐 turn reward 。
4. Turn-level reward shaping(轨迹内分信用)
把原始 变成 ,再 broadcast 到 token:。四种方案:
- Naive:,太稀疏(很多 turn=0)→ 训练崩溃,实验中直接弃用。
- Equalized: 常数,每 turn 同等(等价于原始 GRPO)。
- Reward-to-Go (R2G):,,累积折扣未来奖励,奖励早期 enabling moves。
- Exponential Mapping (EM):把 非线性映到 :。保证微小正进展不被吞掉。
5. Trajectory-level scoring(整条归一成标量给 GRPO)
GRPO 需要单标量做组内归一化,两种:
Sum=原始任务完成度;R2G=加时间偏好(鼓励更少 turn 内更早拿到进展)。
6. 分组 advantage 与目标
对 query 采 rollout 组 (),用所选 算组内均值 、标准差 ,每个 token 的归一化 advantage:
注意分子用的是 turn-level 而非整条 score——这正是 turn-level 与 trajectory-level 解耦的关键:归一化基准来自 trajectory score,但实际打到 token 的是 turn-level 信号。目标用 PPO-clip 且去掉 KL loss:
。
7. 关键超参
- RL:,EM 的 ,train batch 128,max_prompt 1152 / max_response 8192,actor lr 1e-6,ppo mini batch 16,KL loss=False、entropy coeff=0,rollout 引擎 sglang,rollout n=8,max_turns=16,total epochs 15,8×H200 约 1.5 天。RL 数据约 2k task,预留 5% 做 validation 挑 best ckpt。
- SFT:全参,cutoff 16384,per-device bs 2 × grad accum 4,lr 1e-5,3 epoch,cosine + warmup 0.1,bf16,4×H200 约 1 小时。
- 训练 simulator:Qwen3-32B(一次训练约 2k×15×8×16 ≈ 4M 次请求,闭源模型成本不可接受)。评测 simulator:GPT-4o(请求量小、指令跟随更强)。评测 temperature 0.0,max_turns 16。
实验设置与结果
数据切分:TravelGym/TurtleGym/FunctionGym/TauGym/PersuadeGym 用于训练;IntentionGym/TelepathyGym/SearchGym 完全 held-out(测交互目的的泛化)。模型 Qwen3-4B/8B(主),14B/32B 看 raw scaling;闭源 baseline GPT-4o(-mini)、Gemini-2.5-Pro/Flash。指标:TravelGym/TauGym 用 UserBench/Tau-Bench 协议算最终选择正确率,其余=turn reward 之和;总分=8 gym micro-average。
四种配置记为 A/B(A=turn shaping,B=traj scoring):Equalized/Sum(最接近原始 GRPO 的基线)、Equalized/R2G、EM/R2G、R2G/R2G。
主结果(Avg 列,越高越好)
| 模型/配置 | Avg | 备注 |
|---|---|---|
| Qwen3-8B (Equalized/R2G) | 0.5652 | 8B 最佳 |
| Qwen3-8B (EM/R2G) | 0.5343 | |
| Qwen3-8B (R2G/R2G) | 0.5539 | |
| Qwen3-8B (Equalized/Sum) | 0.5076 | 最差 |
| Qwen3-4B (Equalized/R2G) | 0.5269 | 4B 最佳 |
| Qwen3-4B (Equalized/Sum) | 0.4656 | 最差 |
| Qwen3-32B (Raw) | 0.3128 | raw 最大也不行 |
| Qwen3-4B (Raw) | 0.2929 | |
| Gemini-2.5-Pro | 0.4702 | 最强闭源 |
| GPT-4o | 0.4449 | |
| GPT-4o-mini | 0.1729 |
结论一:Equalized/R2G 一致最优,Equalized/Sum 一致最差。说明 trajectory-level scoring(R2G vs Sum)比 turn 级细粒度区分更决定性——R2G 能捕捉”零 reward turn 不等于零贡献”(如 TelepathyGym 里澄清提问不给直接 reward 但缩小答案空间)。在 R2G 固定时,turn 级方案(Equalized/EM/R2G)差异不大,简单 Equalized 就够。
结论二:训练后小模型在交互任务上能超闭源。Qwen3-8B 在 TravelGym/PersuadeGym/IntentionGym 超过 Gemini-2.5-Pro 和 GPT-4o;但 TurtleGym/TelepathyGym/SearchGym(需工具集成 + 策略推理)闭源仍领先。
结论三:raw scaling 单独无效。32B raw 仅 0.3128,训练后的 4B/8B 远超;scaling 效应要在交互训练后才显现。
结论四:把已有 benchmark 套进统一 tool 接口会掉分(TravelGym/TauGym 比原 UserBench/Tau-Bench 低,即便顶级闭源)——暗示原 benchmark 可能有数据泄漏/过拟合,且”通过标准化工具正确交互”本身是难点。
关键消融
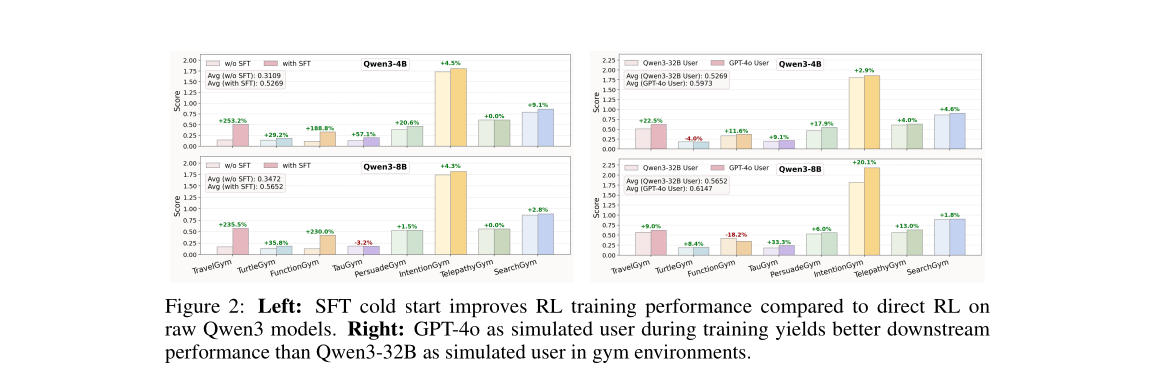
- SFT cold start 必要:无 SFT 早早 plateau 在低位;有 SFT 起点更高且持续提升,部分 gym 增幅 >100%(如 TravelGym +253%)。SFT 提供初始交互能力,RL 再放大。
- Simulator 选择:用 GPT-4o 当训练 simulator 普遍略高(4B 0.5269→0.5973,8B 0.5652→0.6147,主要因训练/评测同 simulator 对齐),但用低成本 Qwen3-32B 训练也能很好迁移到 GPT-4o 评测——开源 simulator 是可行选择。
交互效率/效果
| 模型 | Effective Turns↑ | Time-Weighted Perf↑ |
|---|---|---|
| Qwen3-8B (Equalized/R2G) | 6.6463 | 0.6516 |
| Qwen3-8B (Equalized/Sum) | 6.1842 | 0.4530 |
| Qwen3-4B (Equalized/R2G) | 6.1307 | 0.6423 |
| Qwen3-32B (Raw) | 2.8079 | 0.2852 |
| Gemini-2.5-Pro | 5.7731 | 0.5263 |
| GPT-4o | 3.4087 | 0.4024 |
- Effective Turns=拿到最后一个非零 turn reward 前用的 turn 数;训练后模型能用上更多有效交互(raw 模型常只在前 2-3 turn 拿奖励),但即便最佳也仅 6.6/16,仍有空间。
- Time-Weighted Performance:turn 奖励乘 求和,鼓励早拿分。所有 R2G 系列都超 Sum 系列——验证 R2G 在效果之外还提升效率。
真人交互(TurtleGym/TelepathyGym,5 名 CS 博士生当 oracle)
| 模型 | TurtleGym | TelepathyGym |
|---|---|---|
| Qwen3-4B (GPT-4o User) | 0.1844 | 0.6098 |
| Qwen3-4B (Real User) | 0.2952 (+0.1108) | 0.7805 (+0.1707) |
| Qwen3-8B (GPT-4o User) | 0.1854 | 0.5610 |
| Qwen3-8B (Real User) | 0.3127 (+0.1273) | 0.7805 (+0.2195) |
真人下反而更好:GPT-4o 多答 “Yes/No/Maybe”,真人会把任务当协作游戏给更丰富线索(如”事情发生在过去但不算太久”),说明模型被当协作者比当执行器更有效。
思考与可参考价值
局限:(1) 任务仍偏对话/工具类,未覆盖纯 GUI / code agent;(2) RL 只跑 GRPO,PPO/DPO/DAPO 等未对照;(3) 论文自承 turn-wise reward 区分有上限——EM 把所有零 reward turn 映到同一中间值,无法分辨”有洞察的提问 vs 无关提问”;R2G 假设越靠近 reward turn 越重要,会忽略关键进展发生在轨迹早期的情况;作者认为未来需要 environment-specific 的、可学习的 reward shaping;(4) 真人测试仅 5 人、preliminary,行为方差大。
对电商/搜索推荐/Agent 的可借鉴点:
- 偏好引导即推荐:TravelGym 的设计(Action 分类成 普通/偏好相关/不可用/太模糊,给 0/0.2/0/0 的密集 turn reward)几乎就是电商导购/对话式推荐的 reward 范式——把”问对偏好”做成可奖励的中间动作,best/correct-not-best/wrong 分 1.0/0.8/罚,可直接迁移到商品多轮澄清-推荐。
- R2G > Sum 的工程结论可直接抄:在多轮电商 agent RL 里,与其纠结每 turn 信用怎么精细分,不如把 trajectory score 从 naive sum 换成 reward-to-go(),既提效果又提早转化效率(Time-Weighted 指标)——对”少问几句就成单”的电商场景天然对齐。
- 开源 simulator 省钱可行:4M 请求/训练用 Qwen3-32B 当模拟买家、评测才上强模型,结论是能迁移——给”自建用户模拟器跑 RL”提供了成本下界参考。
- SFT cold start 是前提:纯 RL 在交互任务上会 plateau,先用强模型蒸 1k 条高质轨迹做全参 SFT 再 RL,是解锁交互能力的必要步骤。
- 统一 Action/Search/Answer + 单 tool schema 的极简接口设计,便于把异构推荐/客服/搜索环境统一进一套 RL pipeline,值得作为工程模板。
- Effective Turns / Time-Weighted Performance 双指标:用来同时衡量”是否充分利用多轮”和”是否尽早成交”,可直接用于评估电商对话 agent 的”啰嗦度 vs 转化”权衡。