UserGPT Technical Report
Alibaba Group
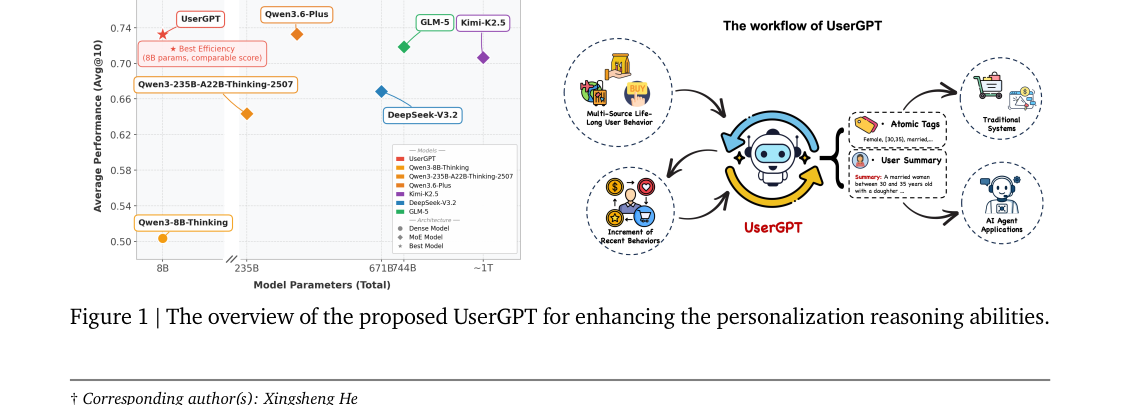
把 user profiling 从 "判别 + 离散标签" 改为 LLM 生成 narrative summary。配套四模块用户行为仿真引擎(BDI 三层 Persona-Need-Intent + Markov 状态机 + 跨平台 Tool Graph + QA 校验)造合成轨迹,再用 Curriculum SFT + DF-GRPO 训 8B;HPR-Bench 上 Avg@10 0.7325 / AccEx 0.7528,行为序列压缩 97.9%。
核心思路
问题一句话:如何把一个用户长达数年、跨平台、充满噪声的海量行为日志,蒸馏成一份逻辑自洽、可解释、信息密度高的用户画像(既要结构化标签,又要 narrative summary)?
关键 idea / 范式转变:抛弃”判别 + 离散标签”的传统 user profiling 范式(每个属性训一个独立判别模型,输出碎片化、逻辑常自相矛盾、长尾泛化差),改用生成式范式——把用户行为序列当作一种”语言”,用 LLM 直接做 language modeling 生成画像。
论文的两个核心洞察:
- 数据侧:真实长期跨平台行为数据因隐私不可得,且原始日志的符号化/事件驱动模态与 LLM 不匹配。于是用一个高保真 User Behavior Simulation Engine 造数据,再用 Data-Centric Semantization 把 raw log 翻译成 LLM 友好的语义化输入。
- 模型侧:即便 GPT-5 / Gemini 3 / Qwen3.6-Plus 这类 SOTA,在 implicit / temporal persona reasoning 上仍力不从心(实验显示 Thinking 与 Non-Thinking 差异微乎其微,说明通用 CoT 不足以补上这个 gap)。于是用 Curriculum-Driven Post-Training(多阶段 SFT + 新 RL 算法 DF-GRPO)把一个 8B 模型训到接近百倍参数 SOTA 的水平。
最终落点:把多年行为压成几百~1.2K token 的 narrative summary(压缩率高达 97.9%),这份 summary 可作为下一代 AI Agent 的可插拔记忆模块(pluggable memory)。
整体实现思路
端到端 pipeline 分三大段,对应论文 §2 / §3 / §4:
-
语料构建(§2)= 仿真 + 语义化
- User Behavior Simulation Engine:四模块(Persona-Driven Agent / Environment & Interaction Agent / Simulation Engine with Persona Evolution / Quality Assurance)协同,生成多年、跨平台(电商/外卖/OTA/POI)、persona 会演化的合成用户轨迹。
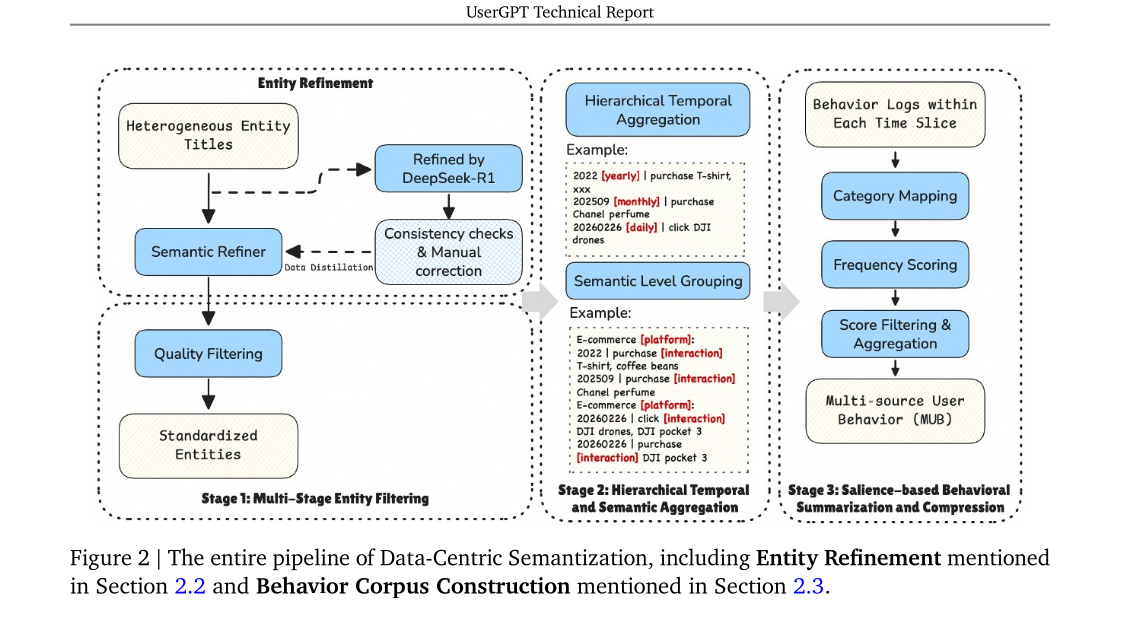
- Data-Centric Semantization:先做 micro 级 Entity Refinement(实体去噪/补全 → 标准化),再做 macro 级 Behavioral Corpus Construction(多级时空聚合 + salience 压缩),把 raw log 转成结构化的 Multi-source User Behavior (MUB)。整条 pipeline 数据缩减 >75%。
-
建模与适配(§3)= Curriculum-Driven Post-Training
- 把 user profiling 形式化为”多输出分类(atomic tags)+ 文本生成(composite summary)“的联合问题 \(f: U \to \mathcal{Y}^a \times \mathcal{Y}^s\)。
- 多阶段 SFT(Stage 1 标准题 → Stage 2 争议题 → Stage 3 summary 硬题)从 atomic 推理逐步过渡到 composite summary 生成。
- RL:用自研 DF-GRPO(Dual-Filter GRPO)继续对齐 summary 质量。
-
评测(§4-5)= HPR-Bench
- 自建 Holistic Persona Reasoning Bench,含 atomic portrait tag infer(HPR-Benchtag,18 个标签/5 维度)和 profile summarization(HPR-Benchsum,自由文本生成),经五步管线(采样 → 预标注 → 难度分层 → 自动质控 → 人工 ≥5 专家验证)构建。
骨干模型:Qwen3-8B(SFT 用改自 LLaMA Factory 的框架 + DeepSpeed + Flash-attention-2 + bf16;RL 用 ROLL 框架)。
子模块实现(可复现细节)
1. User Behavior Simulation Engine(§2.1)
输入:人口统计/心理画像分布先验(对齐中国人口统计)。输出:多年、跨平台、含噪声的 raw 行为日志。
- Persona-Driven Agent(受 BDI / LifeSim 启发的三层 Persona–Need–Intent cognition):
- Core Persona:融合 AlignX 的 90 维偏好空间 + SocioVerse 的 15 维标注体系,覆盖 demographics、Big Five 人格、心理消费需求。
- Latent Needs:从 LifeSim 的 “Desire Pool” 初始化,用 LLM 从真实评论挖掘消费意图,构建专门的 “Consumption Desire Library”;按 Core Persona + 当前生命阶段激活匹配的潜在需求。
- Specific Intent:环境触发(购物节/社会热点)时,潜在需求结晶为含目标平台/动作类型/预期结果的具体意图。
- Agent 随机选 (Core Persona, Latent Need, Specific Intent) 三元组,补全缺失维度并保证内部一致性,再按生命阶段(入学/毕业/工作)时序推进生成轨迹。
- Environment & Interaction Agent:模拟时空动态(每日推进,标记 618 / 双 11 / 开学季 / 春节 / 社会热点 + 按轨迹生成 POI),并扩展 VitaBench 构建 Cross-Platform Tool Graph(电商/外卖/OTA/POI;POI 用 Foursquare 数据集的时间戳与 POI 类型)。
- Simulation Engine with Persona Evolution:用 MDP 建模行为状态转移(idle → browsing → searching → ordering),每个 timestep 按认知状态 + 环境状态调整转移概率;Persona Evolution 分两路——event-driven(怀孕/搬迁/转职等重大事件触发长期质变)与 behavior-driven(固定间隔如每月按近期反馈微调动态偏好)。
- Quality Assurance:逻辑一致性校验(实时检测/修正 behavior-persona-platform-intent 矛盾)+ 噪声注入(误点击、共享账号)+ 人工抽检。
2. Entity Refinement:micro 级去噪(§2.2)
动机:raw entity 异质,两类问题——(1) Semantic Noise(电商标题里塞营销词,如”孕妇湿巾”的”孕妇”会让模型误推用户属性);(2) Information Sparsity(OTA 等新兴内容如网红景点,post-date LLM 预训练 cutoff,缺元数据导致 cold-start)。
方法:一个微调的轻量 LLM Semantic Refiner(Qwen3-1.7B),双策略:
- Entity Rewriting(去噪压缩):对电商等噪声实体用 “rewrite-and-extract”,蒸馏成 1 个核心实体 + ≤3 个 salient 属性,剥离营销噪声保留核心语义(品牌/受众)。
- Entity Enrichment(归一增广):对稀疏实体查内部知识库补元数据(类目/地址),再压缩成统一标准格式。
训练/评测:用 DeepSeek-R1 按 schema 合成训练数据 + 一致性检查 + 人工修正;专家标注约 6,000 样本测试集。效果(Table 2,BLEU/ROUGE 上轻量 Refiner 反超 DeepSeek-R1 与 NER+规则):
| Method | BLEU n=1 | BLEU n=2 | ROUGE-1 | ROUGE-L |
|---|---|---|---|---|
| NER + 手工规则 | 0.4196 | 0.1870 | 0.4775 | 0.4631 |
| DeepSeek-R1 | 0.6213 | 0.3962 | 0.6691 | 0.6547 |
| Semantic Refiner (Ours) | 0.6451 | 0.4294 | 0.6975 | 0.6787 |
该步平均 token 长度降 >50%。
3. Behavioral Corpus Construction:macro 级结构化(§2.3)
Hierarchical Spatio-Temporal Behavior Corpus 范式,三阶段:
- Stage 1 多级实体过滤:NER + 类目约束 + 文本复杂度分析 + 停用词表,剔除无信息实体。
- Stage 2 分层时空 + 语义聚合:
- Semantic Level Grouping:按来源 + 交互类型(search/click/purchase/visit)分组,解耦不同生活面意图。
- Hierarchical Temporal Aggregation(仿人类记忆 coarse-to-fine):长期历史只聚合高影响动作(如 purchase)到月/年粒度捕捉稳定生命阶段;短期历史保留 search/click/purchase 全集到日粒度捕捉新兴意图。
- Stage 3 salience 压缩:每个时间片内所有行为映射到统一类目体系(如母婴/消费电子/户外运动)→ 计算每类目交互频次作为 salience score → 只保留 Top-K 最显著类目的核心行为,滤掉注入噪声与死循环序列。这相当于一个隐式 attention,引导模型聚焦关键信息。
输出 MUB 格式(清晰呈现时间/来源/行为类型/频次/内容):
[Source: E-commerce] [TIME: 2026-01-28] [TYPE: Click] [COUNT: 5] | Wet Wipes, Milk Powder, ...
[Source: Delivery] [TIME: 2025-12] [TYPE: Purchase] | Starbucks Latte, ...
整条 Semantization pipeline 数据缩减 >75%。
4. 问题定义与合成数据挑战(§3.1-3.2)
设 \(U\) 为某用户 MUB;定义 \(K\) 个 atomic 属性 \({y^a_1,\dots,y^a_K}\):
- 类别属性(如性别)值空间 \(\mathcal{Y}^a_k = {y^a_{k,1},\dots,y^a_{k,m_k}} \cup {\text{NA}}\);
- 开放域属性(如兴趣偏好)值空间 \(\mathcal{Y}^a_k = \mathcal{T}\)(自然语言文本空间)。
外加 composite summary \(y^s\)。联合任务:学映射 \(f: U \to \mathcal{Y}^a \times \mathcal{Y}^s\),\((\hat{\mathbf{y}}^a, \hat{y}^s) = f(U)\),优化目标是 atomic 属性间逻辑自洽 + 与 ground-truth 行为事实对齐。
合成数据四大挑战:① Semantic Hallucination(如按奶粉段位推婴儿月龄会出错);② Contextual Fragmentation(Persona Contamination 共享账号 / Temporal Evolution Blindness 同时标”单身”和”育儿” / Intent Misattribution 把代购/送礼当个人偏好);③ Intrinsic Data Noise(over-interpretation 把偶发点击当稳定特征);④ Cost-Performance 权衡。
5. Curriculum-Driven Post-Training(§3.3)
Prompt Engineering:引入简洁 CoT(防 overthinking),加 task-specific 约束修复特定 failure mode(如”买 renter-friendly 商品不等于租客”)。Prompt 模板 = Role(专业画像分析师)+ Task(objective + constraint)+ Input(MUB)+ Output(valid JSON,含简洁 reasoning + 属性)。
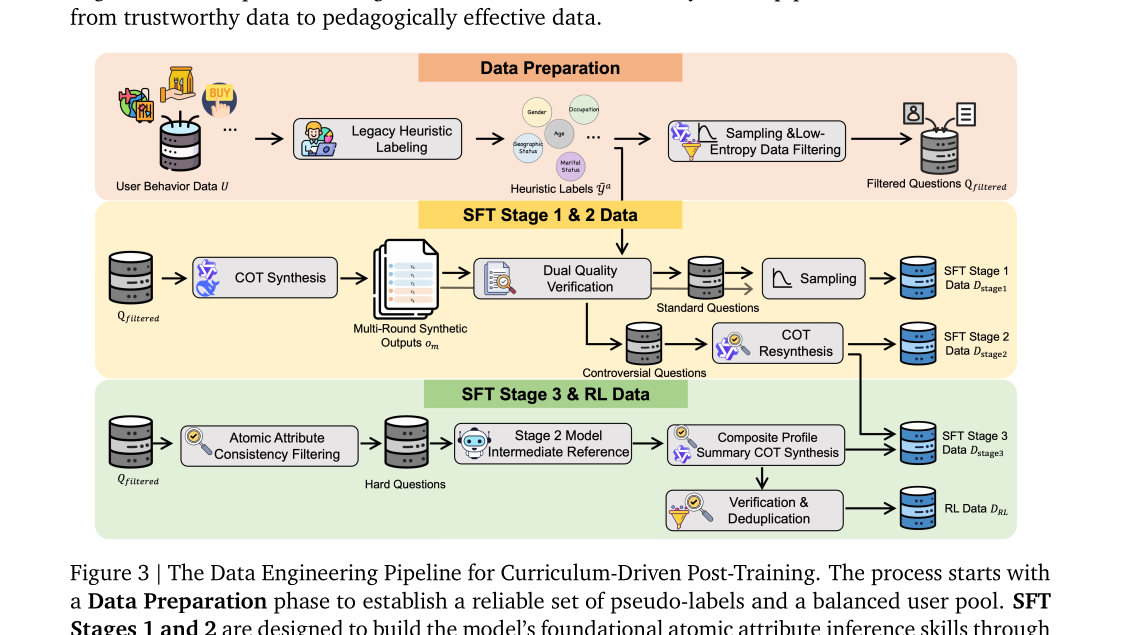
Data Preparation:
- 规则函数 \(\tilde{\mathbf{y}}^a = \text{RULE}(U)\) 产生 atomic 伪标签(legacy heuristic label 当 pseudo ground truth)。
- 分层采样平衡 demographics → 初始候选集 \(Q_{init}\)(1M 题)。
- Low-Entropy 过滤:用 Qwen3-8B Thinking 评估,丢掉模型预测与 legacy 标签完全一致的”易题”(无梯度价值):\(Q_{filtered} = {q \in Q_{init} \mid \text{LLM}(q) \neq \tilde{y}^a_q}\),1M → 490K。
Multi-Stage SFT(三阶段,难度递增):
- Stage 1(标准题,建立输出规范):用两个异质 30B 模型(Qwen3-30B-A3B-Thinking-2507、DeepSeek-R1-Distill-Qwen-32B)对每题生成 5 路输出 \(\mathbf{o}={o_1..o_5}\);atomic 抽取算子 \(\hat{y}^a_{o_i} = \mathcal{F}^a(o_i)\);只有 ≥4/5 抽取标签与伪标签一致才接受,随机取一个正确输出入 \(D_{stage1}\): \[ D_{stage1} = {(q, o_{rand}) \mid q \in Q_{filtered},\ \textstyle\sum_{i=1}^{5}\mathbb{1}(\hat{y}^a_{o_i}=\tilde{y}^a_q) \geq 4} \] 产出 ~210K 验证题 → 采样 ~130K。
- Stage 2(争议题,增强鲁棒):选 \(0 < \sum \mathbb{1}(\cdot) < 4\)(模型间分歧但至少一个对齐 legacy 标签)的题,用更强的 Qwen3-235B-A22B-Thinking-2507 重合成 \(o_r\),要求 \(\mathcal{F}^a(o_r)=\tilde{y}^a_q\): \[ D_{stage2} = {(q, o_r) \mid 0 < \textstyle\sum_{i=1}^{5}\mathbb{1}(\hat{y}^a_{o_i}=\tilde{y}^a_q) < 4,\ \mathcal{F}^a(o_r)=\tilde{y}^a_q} \] ~250K → ~170K。
- Stage 3(硬题,composite summary):context window 从 16K 扩到 36K(处理近十年历史);选 ~130K 逻辑一致 seed 用户,用 Qwen3-235B-A22B-Thinking-2507 + Stage2 atomic 属性作中间参考,生成 composite summary \(o_c\);只保留 \(o_c\) 内全部 atomic 属性都严格对齐 legacy 标签的样本,并混入 Stage2 子集防遗忘: \[ D_{stage3} = {(q, o_c) \mid q \in Q_{hard},\ \mathcal{F}^c(o_c)=\tilde{\mathbf{y}}^a} \cup D’_{stage2} \] ~37K 硬题 + Stage2 → ~73K。
SFT 超参(Table 3):lr 2e-5(cosine),batch size 256(32 卡 × per-device 2 × grad accum 4),grad clip 1.0,AdamW(β1=0.9, β2=0.999, ε=1e-8),bf16;max seq Stage1/2=16K、Stage3=36K;训练步数 485 / 658 / 391。
RL(§3.3.4):
- RL 数据:从 Stage3 summary 过滤(对齐 legacy 标签 + 与 SFT 去重)→ 分层采样(每性别×年龄组各 100)→ \(D_{RL}\) = 1,829 样本。
- 目标 GRPO:对每 prompt 采 G 个响应,advantage 用组内 reward 归一 \(A_i = (r_i - \text{mean})/\text{std}\),带 KL 正则 \(-\beta \mathbb{D}{KL}[\pi\theta | \pi_{ref}]\)(无 critic)。
- Reward 三件套:Format Reward(
<think>/<answer>+ valid JSON,二值 0/1);Atomic Accuracy Reward(离散属性直比 GT,开放属性用 GTE embedding 算相似度,score = 正确标签数 / 总 atomic 数);Summary Quality Reward(强 thinking 模型当 judge,评 completeness/consistency/conciseness/aesthetics 四维加权)。 - DF-GRPO(双层过滤):① Sample-Level——丢掉触顶 max seq(截断)或 Format Reward 不过的样本;② Group-Level——设全局阈值 \(\varepsilon_{low}/\varepsilon_{high}\),组平均 reward 低于 \(\varepsilon_{low}\)(质量差)或高于 \(\varepsilon_{high}\)(已优化好)则整组排除,避免次优梯度与过优化。剩余样本 total reward = Atomic Accuracy + Summary Quality(format 已隐式满足)。
- RL 超参:total batch 128,每 iter 一次梯度更新,lr 1e-6,max seq 40K,采样 temperature 0.7 / top-p 0.9。
实验设置与结果
骨干:Qwen3-8B。Baseline:判别模型 DNN;Non-Thinking(Qwen3-8B、Qwen3-235B-A22B-Instruct-2507);Thinking(Qwen3-8B、Qwen3-235B-A22B-Thinking-2507、Kimi-K2.5、DeepSeek-R1-0528、DeepSeek-V3.2、GLM-5、Qwen3.6-Plus)。
指标定义:
- HPR-Benchtag:Avg@k(k=10,n 次独立推理取正确平均),跨 18 个 atomic tag / 5 维度(LS 生命阶段、HC 家庭情境、LI 生活方式、EP 教育职业、GC 地理)。
- HPR-Benchsum:Grounding 用 AccEx(从 summary 抽 atomic 标签的准确率,抽取器 Qwen3-32B)与 COVEx(覆盖率);Generation 用 BLEU / Scoresim;Qualitative 用 DeepSeek-V3.2 当 judge 评 4 维(0-10)。
Tag prediction(HPR-Benchtag,Table 4,Avg@10):
| Model | #Params | Avg | LS | HC | LI | EP | GC |
|---|---|---|---|---|---|---|---|
| DNN(判别) | — | 0.5846 | 0.7156 | 0.4000 | 0.6525 | 0.5616 | — |
| Qwen3-8B Thinking(backbone) | 8B | 0.5035 | 0.6224 | 0.3831 | 0.6244 | 0.4770 | 0.4599 |
| Qwen3-235B-A22B-Thinking-2507 | 235B/A22B | 0.6434 | 0.6411 | 0.4135 | 0.6438 | 0.6261 | 0.7478 |
| DeepSeek-V3.2 | 671B/37B | 0.6684 | 0.6842 | 0.4981 | 0.6753 | 0.6693 | 0.7314 |
| GLM-5 | 744B/A40B | 0.7186 | 0.7691 | 0.5345 | 0.7098 | 0.7037 | 0.7838 |
| Qwen3.6-Plus | — | 0.7329 | 0.7907 | 0.5965 | 0.6991 | 0.6694 | 0.7993 |
| UserGPTSFT | 8B | 0.7325 | 0.7776 | 0.6088 | 0.6999 | 0.8212 | 0.7548 |
| UserGPT(SFT+RL) | 8B | 0.7306 | 0.7879 | 0.5962 | 0.6945 | 0.8164 | 0.7546 |
→ 8B 的 UserGPT 相对 backbone Qwen3-8B-Thinking 提升 +45.10%(0.5035→0.7306),几乎追平 ~万亿/百倍参数的 Qwen3.6-Plus(0.7329)。EP 维度(教育职业)甚至显著领先所有 baseline。
Summary generation(HPR-Benchsum,Table 5):
| Model | AccEx | COVEx | BLEU_2 | BLEU_4 | Scoresim | Comp. | Consis. | Concis. | Aesth. |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3-8B Thinking | 0.5192 | 0.8801 | 0.0817 | 0.0153 | 0.7732 | 4.71 | 9.85 | 4.85 | 4.92 |
| Qwen3-235B-A22B-Thinking-2507 | 0.7014 | 0.9638 | 0.1880 | 0.0592 | 0.7917 | 6.25 | 9.81 | 6.13 | 7.18 |
| GLM-5 | 0.6775 | 0.9422 | 0.1804 | 0.0514 | 0.8113 | 6.04 | 9.87 | 6.19 | 6.57 |
| Qwen3.6-Plus | 0.5713 | 0.9046 | 0.1371 | 0.0262 | 0.7728 | 5.45 | 9.88 | 5.59 | 7.82 |
| UserGPTSFT | 0.6899 | 0.9587 | 0.1631 | 0.0378 | 0.7854 | 6.04 | 9.84 | 6.13 | 6.42 |
| UserGPT | 0.7528 | 0.9747 | 0.1931 | 0.0691 | 0.8215 | 6.36 | 9.90 | 6.59 | 6.05 |
→ AccEx 0.7528 反超 Qwen3-235B-A22B-Thinking-2507 的 0.7014(+7.31%);相对 backbone:AccEx +50.47%、COVEx +10.75%、judge 总分 +18.77%。RL 相比纯 SFT:AccEx +9.12%、COVEx +1.67%。
压缩(Figure 6):平均输入 15K token 历史 → 压成 1.2K token summary,token 减少 up to 97.9%,而 COVEx≈0.9747 证明核心标签未丢。
Out-of-domain(Table 6):相比 Qwen3-8B Thinking 仅降 1.32 pt,但显著超 Non-Thinking 变体 +5.95 pt——证明 post-training 没造成通用能力灾难性坍塌。
消融结论:
- 数据质量(Figure 7):同量数据,只用 controversial 硬题训练 → Pass@1 0.7316 / Pass@5 0.8922 / Pass@10 0.9259,显著优于混合(易+标准+争议)随机子集。
- Curriculum 必要性(Table 7):Stage1 单独使 Pass@1 0.5030→0.6996(+39%);+Stage2 → 0.7326(建 atomic “what”);+Stage3 summary 不再提 atomic 精度但 AccEx 0.4926→0.6595、COVEx 0.8206→0.9563(教”how”组织叙事);同量数据下 curriculum(易→难顺序)比 naive 混合训练 AccEx +4.6%,且 Pass@5/10 最高。
- DF-GRPO(Table 8):SFT 0.6899 → vanilla GRPO 0.7046 → group-level 0.7323 → DF-GRPO 0.7528(AccEx)。去掉 group-level(仅 sample-level)AccEx 跌回 0.6949(接近 SFT),证明 group-level 过滤对训练稳定性最关键。
思考与可参考价值
局限:
- 所有 SOTA 数字均来自自建 HPR-Bench,且 HPR-Bench 与训练数据同源仿真生成——存在 simulator-train / simulator-eval 同源风险,缺乏跨外部 benchmark 的画像准确性验证(OOD 只测了通用/电商 QA,非画像本身)。
- 仿真高度针对中国电商场景(618/双 11/POI/中国人口统计对齐),跨地区跨域迁移性未验证。
- technical report 未放代码/权重,社区难独立复现;很多”Qwen3.6-Plus / Kimi-K2.5 / GLM-5”等模型是 2026 年内部对标,可比性需谨慎。
- “97.9% 压缩不掉点”在 HPR-Bench 任务上成立,但对长尾 fine-grained behavior 是否真无信息损失存疑(论文自己也把 multi-hop 隐式推理列为 future work)。
- Incremental Profiling(§6 的 \(Summary_t = \text{UserGPT}(Summary_{t-1} + \Delta Behavior_t)\) 增量更新 + event/time 触发)仅是 vision,无实验。
对电商/搜索推荐/Agent 的可借鉴点:
- Simulator-as-trainer 闭环:user simulator 不只是”训/评 agent 的外部环境”,可反过来当 LLM persona 后训练的核心数据源。这条 simulator → synthetic trajectory → SFT+RL 链路可直接迁移到推荐/搜索的用户表征 LLM——尤其在真实标注稀缺、隐私受限场景。
- DF-GRPO 双层过滤是通用 patch:sample-level(丢截断/格式错)+ group-level(\(\varepsilon_{low}/\varepsilon_{high}\) 阈值丢太差/太好的组)可直接套到任何 long-form generation 的 GRPO/RLVR,缓解稀疏 reward 下数据效率与过优化问题;消融显示 group-level 是稳定性关键。
- Narrative summary 作新用户表征接口:把多月行为压成几百 token 的自然语言 summary,下游推荐/搜索可直接当 context 注入,替代传统不可读的 user embedding,且天然适配 LLM-based ranker / agent memory。
- Persona–Need–Intent 三层 cognition + Persona Evolution:是当下最系统的 e-commerce user simulator 设计模板,可迁移到健康/教育/内容消费等任何长期 user-modeling 场景,不限电商。
- Curriculum 的”what vs how”分工洞察:atomic 训练建事实预测能力、summary 训练建叙事组织能力——对任何”先抽属性再生成报告”的工业 pipeline(如商品理解、用户洞察报告)都有指导意义。
- Entity Refinement(去营销噪声):电商标题塞营销词导致属性误推(“孕妇湿巾”→误判用户怀孕)是真实痛点,用 1.7B 轻量模型 rewrite-and-extract 反超 R1,是低成本可落地的预处理组件。