Training Proactive and Personalized LLM Agents (UserVille / PPP)
CMU × OpenHands
UserVille 把精确指令 "打散" 成模糊用户输入并配多种交互偏好的 simulator;PPP 是多目标 RL,联合优化 productivity(完成度)+ proactivity(主动澄清)+ personalization(适配偏好)。
核心思路
问题一句话:现实里用户给 Agent 的指令是欠规范(vague)的(“修一下这个 bug” 却不说环境/复现步骤),且每个人交互偏好各异(有人只答选择题、有人讨厌被反复打断、有人要求用意大利语提问)。但现有 Agent RL(SWE-Bench / Search-R1 / R1 那一脉)几乎只优化 task success 一个维度,训出来的模型在模糊指令下要么瞎猜导致失败、要么乱问问题惹烦用户、要么无视用户偏好。
关键 idea:把”有效的人机协作”显式拆成三个可优化维度 P×P×P——Productivity(把任务做对)、Proactivity(在真正缺信息时问出”低成本、命中真 blocker”的好问题,且不滥问)、Personalization(按用户偏好调整提问的措辞/格式/时机/语言)。为此构造 UserVille 交互环境(把已有 benchmark 的精确 prompt 自动”模糊化”+ 配备带偏好的 LLM 用户模拟器 + 用户中心评测),再用 PPP——一个 GRPO/DAPO 风格的多目标 RL,把三类 reward 求和成单一标量信号去训 Agent。结论:在 SWE-Bench 与 BrowseComp-Plus 上,PPP 相对 GPT-5 等强基线平均 +21.6(vague prompt 设定下三维度均分 +16.72 over Seed-OSS-36B 基座)。
整体实现思路
端到端 pipeline 由 UserVille 环境构造 和 PPP RL 训练 两部分组成:
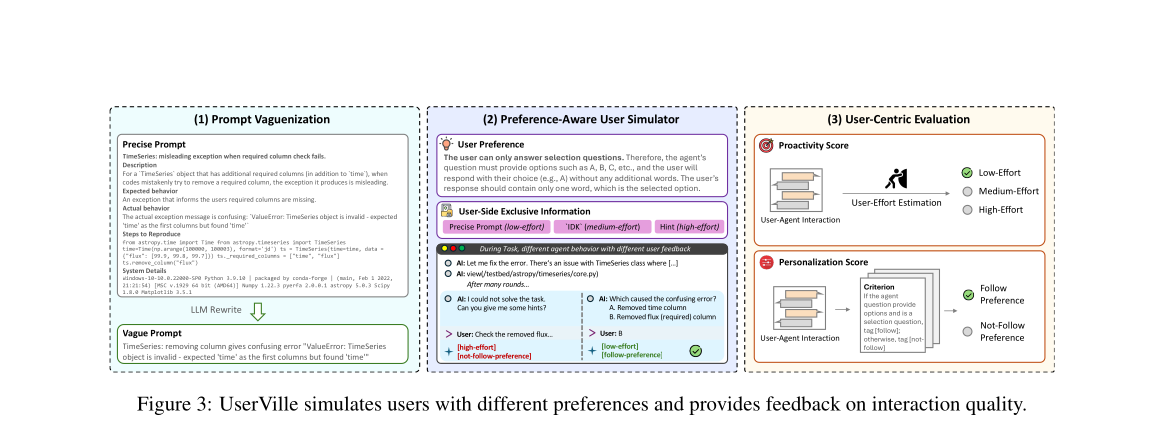
UserVille 三阶段(图见下):
- Prompt Vaguenization:用一个 LLM 把数据集里原本精确、自包含的 user prompt 改写成”只含部分信息、泛化掉具体细节、但意图不变”的 vague prompt。这样在用户模拟器(持有精确 prompt)和 Agent(只看到 vague prompt)之间制造信息不对称——Agent 必须靠提问把缺失信息补回来,而模拟器能据精确 prompt 给出权威回答。
- Preference-Aware User Simulator:用 LLM 模拟用户,行为由一组预定义 interaction preference 驱动(共 20 种,如”只答 A/B/C 选择题”、“不要问任何问题”、“先自己试再问真 blocker”、“用意大利语提问”等)。模拟器持有三层信息(精确 prompt=低成本可答 / Hint=高成本可答 / IDK=答不了)。
- User-Centric Evaluation:任务结束后输出 Proactivity(基于 user-effort 估计:每轮问题被打成 low/medium/high-effort)和 Personalization(每种偏好一个 reward function 判 follow / not-follow)反馈。
PPP 训练:把任务建模为 multi-turn tool-call ReAct Agent——交互被抽象成一个 ask_user 工具,Agent 每步输出 reasoning + tool call(要么调任务工具如 search/view/edit,要么调 ask_user 找模拟器)。把三类 reward 加权求和成 R = R_Prod + R_Proact + R_Pers,用 GRPO(带 DAPO 的 Clip-Higher + token-level loss)优化。
子模块实现(可复现细节)
1. 问题形式化(ReAct multi-turn tool agent)
给定 user prompt ,Agent 生成多轮轨迹 ,其中 是第 步 LLM 输出(含 reasoning + tool call,tool 可以是任务工具或 ask_user), 是对应的工具观测。轨迹概率按 ReAct 自回归分解:
ask_user 把”向用户提问”也变成一个普通工具调用,于是人机交互和工具调用统一在同一个 RL 轨迹里。
2. Prompt Vaguenization
- 输入:原数据集的精确 prompt(SWE issue 描述 / BrowseComp 问题)。
- 输出:vague prompt。
- 两条改写原则:(1) 保持与精确 prompt 相同 intent;(2) 只保留部分信息、泛化掉具体细节。
- 例(论文 Fig 12):精确 prompt 给出完整复现代码
ts._required_columns=["time","flux"]; ts.remove_column("flux")+ 系统环境;vague 版只剩一句removing column gives confusing error "ValueError: ... expected 'time' as the first columns but found 'time'"。Agent 必须靠提问才能拿到_required_columns这个关键复现细节。
3. Preference-Aware User Simulator(20 种偏好)
12 种用于训练(seen),8 种留作泛化评测(unseen)。每种偏好 = 一段自然语言描述 + 一个 reward criterion + 一个 reward function。摘录(完整见论文 Table 4/5):
| 类型 | 偏好(部分) | Reward Function | 罚的轻重 |
|---|---|---|---|
| seen | concise_question 简短提问 | -0.1 * stats['reward_0'] | 轻罚 |
| seen | detail_question 详细带上下文 | -0.1 * stats['reward_0'] | 轻罚 |
| seen | answer_more 至少问 3 个 | min(1*(ask_turn-3), 0) | 问少了罚 |
| seen | only_begin 只在开头答 | -int('ask_question' in messages[3:]) | 后续再问就罚 |
| seen | no_ask 不许问 | -int(ask_turn > 0) | 问就罚 |
| seen | do_selection 只答 A/B/C | -0.5 * stats['reward_0'] | 中罚 |
| seen | amateur 只答简单问题 | -0.1 * stats['reward_0'] | 轻罚 |
| seen | ask_many 一轮问完 | -int(ask_turn > 1) | 多轮就罚 |
| seen | one_question 一次只问一个 | -0.5 * stats['reward_0'] | 中罚 |
| seen | first_try 先自己试再问真 blocker | -0.1 * stats['reward_0'] | 轻罚 |
| unseen | lang_ita 必须意大利语 | -0.5 * stats['reward_0'] | 中罚 |
| unseen | json 提问须 JSON 包裹 | -0.5 * stats['reward_0'] | 中罚 |
| unseen | capital 全大写英文 | -0.5 * stats['reward_0'] | 中罚 |
| unseen | commas 不准有逗号 | -0.5 * stats['reward_0'] | 中罚 |
stats['reward_0'] 即”违反该偏好准则”的指示量(LLM-as-judge 或硬编码规则给出 Reward 0/1)。no_preference/professional 无 reward function。
4. User-Effort 估计(Proactivity 的判定核心)
每当模拟器回答一个问题,把这次回答需要的 user-effort 打成三类:
- Low-effort:问题可直接用原精确 prompt 里的信息回答(信息本就在用户初始意图里)。
- Medium-effort:模拟器答不了/拒答(回 “I don’t know”)——即无效或措辞差的问题。
- High-effort:模拟器得用精确 prompt 之外的信息才能答(模拟用户要去翻文档/读代码库),用任务特定 criteria 判定。
会话级 effort = 该 session 内任意单轮的最大 effort。另:若初始 prompt 是 vague 且 Agent 没问任何澄清就给出错误解,该 session 也直接判 high-effort(因为用户得花大力气去核验、纠错)。
5. 三类 Reward(PPP 的核心)
(i) Productivity Reward :任务可验证 reward。SWE-Func-Loc 用预测函数列表 vs ground-truth 的 F1;Deep-Research 用官方判分器的 EM;SWE-Full 用官方单测通过率。
(ii) Proactivity Reward = bonus + penalty:
- bonus:若所有 query 都是 low-effort,+0.05;
- penalty:每个 medium-effort query −0.1,每个 high-effort query −0.5;
- = bonus 与累计 penalty 之和。
(iii) Personalization Reward = bonus + penalty:
- bonus:若完全符合用户偏好,+0.05;
- penalty:按该偏好的 reward function(非正标量,见上表)累计;
- = bonus 与累计 penalty 之和。
总 reward:
R = R_{\text{Prod}} + R_{\text{Proact}} + R_{\text{Pers}} \tag{1}
注意三个奖励是直接相加成单一标量,再喂给 GRPO,没有显式权重超参——靠 bonus(+0.05) 与 penalty(−0.1/−0.5) 的幅度隐式平衡。
6. RL 算法(GRPO + DAPO)
对训练集中的 ,从旧策略 采 条轨迹 ,每条轨迹展平为 token 序列 。目标(采用 DAPO 的 token-level loss,归一化分母是组内总 token 数 ):
重要性比 与 组内相对优势:
- :只对 LLM 生成的 token 计 loss(屏蔽工具返回的 observation token)。
- 优势用 GRPO 组内 z-score 归一; 先 clip 到 [0,1] 再标准化。
- 采用 DAPO 的 Clip-Higher( 上界放宽)。
7. 关键超参与数据构造
- 基座:Seed-OSS-36B-Instruct;训练期用户模拟器:GPT-5-Nano。
- 训练数据重复:均匀采 12 种偏好 × vague prompt + 1 种 precise prompt = 13× 数据重复(12+1)。
- RL 配置(Verl 框架):lr 1e-6,batch size 64,group size 8,200 steps。
- 最大输出长度:SWE-Func-Loc 32K / SWE-Full 65K / Deep-Research 41K。
- Scaffold:SWE 基于 OpenHands;SWE-Func-Loc 用只读轻量模拟环境(只 localize 出需编辑的函数名列表),SWE-Full 用官方 Docker + 跑单测;Deep-Research 配
search+open_page工具,retriever 用 Qwen3-Embed-8B。
实验设置与结果
数据集:SWE = SWE-Gym 训练 / SWE-Bench-Verified 测试(过滤掉 ground-truth 全非 Python 实例后 488 条);Deep-Research = BrowseComp-Plus(450 训练 / 100 测试)。评测在 vague prompt 设定、对 20 种偏好(12 seen + 8 unseen)取平均。
指标定义:Productivity = F1(SWE-Func-Loc)/ EM(BrowseComp+)/ 单测通过率(SWE-Full);Proactivity Score = 会话级 effort 为 low-effort 则 1 否则 0;Personalization Score = follow 偏好则 1 否则 0(只在 Agent 至少问过 1 个问题的实例上平均)。
RQ1:交互对模糊指令至关重要(SWE-Func-Loc F1)
| 设定 | Before RL | +RL | 增益 |
|---|---|---|---|
| Precise prompt(无交互) | 64.50 | — | +5.70 |
| Vague prompt(无交互) | 44.11 | — | +7.52 |
| Vague prompt(有交互, PPP) | 44.11 | 64.50 | +21.66 |
结论:vague 比 precise 直接掉 F1(64.50→44.11);放开交互后基座模型并不会自己变好(交互策略差),但 RL 把 vague+交互拉回到 precise 水平,增益远大于另两个设定。
RQ2:三维度主结果(vague prompt,20 偏好均值)
| 方法 | Avg | SWE Prod | SWE Proact | SWE Pers | BC+ Prod | BC+ Proact | BC+ Pers |
|---|---|---|---|---|---|---|---|
| GPT-5 | 40.40 | 55.83 | 36.60 | 12.96 | 22.50 | 43.15 | 71.36 |
| GPT-5-Mini | 35.82 | 35.00 | 15.90 | 24.82 | 22.75 | 45.50 | 70.97 |
| GPT-4.1 | 38.86 | 25.08 | 11.35 | 53.04 | 22.50 | 41.40 | 79.77 |
| Seed-OSS-36B(基座) | 45.32 | 38.59 | 43.70 | 69.07 | 18.20 | 37.60 | 64.76 |
| PPP (Ours) | 62.04 | 56.26 (+17.67) | 75.55 (+31.85) | 89.26 (+20.19) | 26.63 (+8.43) | 47.69 (+10.09) | 76.85 (+12.09) |
| w/o Proact. | 55.05 | 53.35 | 37.75 (−5.95) | 94.21 | 23.00 | 44.79 | 77.18 |
| w/o Pers. | 53.23 | 55.48 | 87.15 | 47.25 (−21.82) | 26.60 | 47.42 | 55.48 (−9.28) |
| w/o Proact. & Pers. | 44.98 | 56.77 | 42.45 | 57.43 | 25.45 | 39.60 | 48.21 |
关键观察:
- 前沿 LLM(GPT-5)productivity 高但 proactivity / personalization 差;personalization 排序还和 productivity 排序不一致(GPT-4.1 比 GPT-5 系还高)。
- PPP 全维度提升,平均 +16.72(相对基座)。
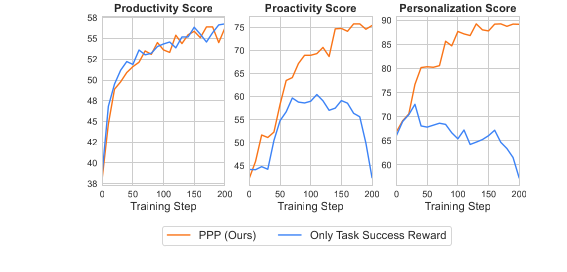
- 消融证明每个目标都必要:去掉 Proact. 则 proactivity 掉(SWE −5.95),去掉 Pers. 则 personalization 暴跌(SWE −21.82 / BC+ −9.28),全去掉则两者都差。
- 多目标有 trade-off:单优化某一维的变体在该维上略高于 PPP(如 w/o Pers 的 SWE Proact 87.15 > PPP 75.55),但 PPP 的 task score 往往最高——因为没 proactivity reward 的模型会狂问 high-effort 问题、不打真 blocker,反而拖低任务分。
RQ3:学到”策略性提问”
- Ask Ratio:PPP 训练后在 vague prompt 上 ask ratio 大涨(SWE-Func-Loc 50%→100%,Deep-Research 51%→85%),但在 precise prompt 上保持低 ask ratio——即会区分 precise vs vague,只在必要时问(minimally disruptive)。
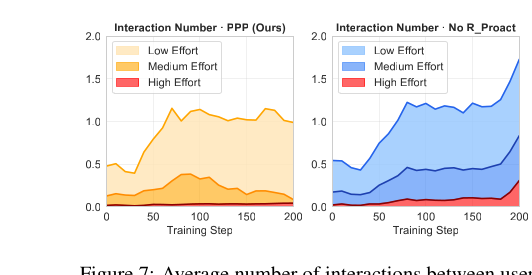
- increase-then-decrease 动态:PPP 的平均交互数从 ~0.5 升到 ~1.2,其中 low-effort 持续增多;medium-effort 先升后降;high-effort 始终很低。说明模型先学”多问”,再学”问得更好”。去掉 的消融则相反:medium/high-effort 问题越训越多,模型变”懒”,越来越依赖用户喂信息。
RQ4:泛化性
- 换用户模拟器:用 GPT-5-Nano 训出的模型换 GPT-5 / GPT-5-Mini / GPT-4.1 / GPT-4o 做评测,分数仅小幅波动(Productivity 54.66~58.06),更强的模拟器(GPT-5)评分略高——模型对模拟器鲁棒。
- unseen 偏好:8 个未见偏好上 personalization 随训练一致提升;而去掉 的消融 ~100 step 后开始无视偏好,连简单的
JSON_Format都从 1.00 掉到 0.30。 - 迁移到更复杂任务:只在 SWE-Func-Loc(定位子任务)上训,迁到 SWE-Full(真改代码 + 跑单测),vague prompt 下成功率 0.29→~0.36,平均交互数 0.10→1.8(十倍以上),且复刻同样的 increase-then-decrease 模式。(注:precise prompt 下 SWE-Full 成功率从 0.558 微降到 ~0.530,是为提升 vague 场景付的小代价。)
思考与可参考价值
局限:
- 用户模拟器是 LLM 而非真人,缺真人 user study 验证(作者在 Limitations 明确承认)。
- 20 种偏好是人工设计的、且偏好 reward 多为硬规则或 LLM-judge,可能过于规整,未从真实交互数据里学偏好。
- 三 reward 直接相加、靠 bonus/penalty 幅度隐式平衡,没做权重敏感性实验;多目标 trade-off 客观存在(单维变体在该维更高)。
- precise/SWE-Full 上 productivity 有轻微回退,说明强化交互不是免费午餐。
对电商 / 搜索推荐 / Agent 方向的可借鉴点:
- 把”澄清”建成一个
ask_user工具 + 多目标 reward 这套范式,几乎可直接搬到电商导购 / 客服 Agent:用户 query 天然 vague(“找个送男朋友的礼物”),Proactivity reward(low/medium/high-effort 分级)正好对应”问得准不准、烦不烦”,可量化”该问不问”(直接推错品)与”问太多”(流失)。 - User-Effort 三分类是个很实用的、可工程化的交互质量信号:low=问题答案就在用户已有意图里、medium=用户答不了、high=逼用户额外劳动。比单纯”问了几轮”更贴近真实满意度,适合做对话推荐 / 搜索澄清的在线 reward 或离线评测。
- Personalization 用”每偏好一个 reward function”:电商场景的”用户偏好”(简洁 vs 详细、要不要追问预算、语言/语气)可同构建模,且留 unseen 偏好测泛化这套协议值得复用。
- Prompt Vaguenization 制造信息不对称 是低成本把现成精确 benchmark 改造成交互式 RL 环境的通用 trick——推荐/搜索的 query 改写、意图泛化天然契合。
- only task-success reward 会让 Agent 变懒、滥问、无视偏好(图中蓝线一路下滑)这一负面发现,提醒做 Agent RL 时若只盯 GMV / CTR / 成功率,交互体验会被悄悄优化掉。