τ²-Bench: Evaluating Conversational Agents in a Dual-Control Environment
Sierra Research
τ-bench 的升级版:把环境改成 dual-control——LLM 模拟用户也能调工具。新增 Telecom 域用 Dec-POMDP 建模;附带可程序化生成 diverse / verifiable 任务的 task generator;user simulator 与环境紧耦合保证可靠性。
核心思路
问题一句话:现有 conversational agent benchmark(如 τ-bench)都是 single-control——只有 AI agent 能调工具改世界,模拟用户只是个”被动信息源”,只会说话。但真实技术支持场景里,用户得亲自动手(关飞行模式、重新插 SIM 卡、重启手机),agent 必须指挥用户去操作才能解决问题。这种”分布式控制”的能力,现有 benchmark 完全测不到。
关键 idea / 范式:把环境升级成 dual-control——给 LLM 模拟用户也配上一套工具(操作它自己那台”虚拟手机”),让 agent 和 user 共享一个动态世界、双边都能 act。整个交互形式化成 Dec-POMDP(去中心化部分可观测马尔可夫决策过程)。核心难点是要维持 complexity asymmetry(复杂度不对称):用户有了工具但能力必须被严格限制,仍然离不开 agent 的指导——否则用户自己就把问题解决了,测的就不是 agent 了。论文通过三条设计约束实现这点:① 用户工具只输出 human-readable 结果(不给结构化数据让用户自己推理);② 用户只做”被请求才反应”的 reactive tool use,不做规划;③ 用户行为由环境状态紧紧约束。
由此得到一个能同时考察 agent reasoning(推理域策略) 和 communication/coordination(指挥用户协作) 两种能力、并能把两者解耦诊断的 controlled testbed。实验直接给出最刺眼的结论:从 no-user(agent 独控所有工具)切到 dual-control(必须指挥用户),pass^1 暴跌约 18–25 个百分点,说明”指挥一个有自主性的用户”才是当前 agent 的真正瓶颈,而非纯推理。
整体实现思路
端到端 pipeline 是”一个被建模成 Dec-POMDP 的双玩家交互环境 + 程序化任务生成器 + 紧耦合用户模拟器 + 多模式诊断评测”。
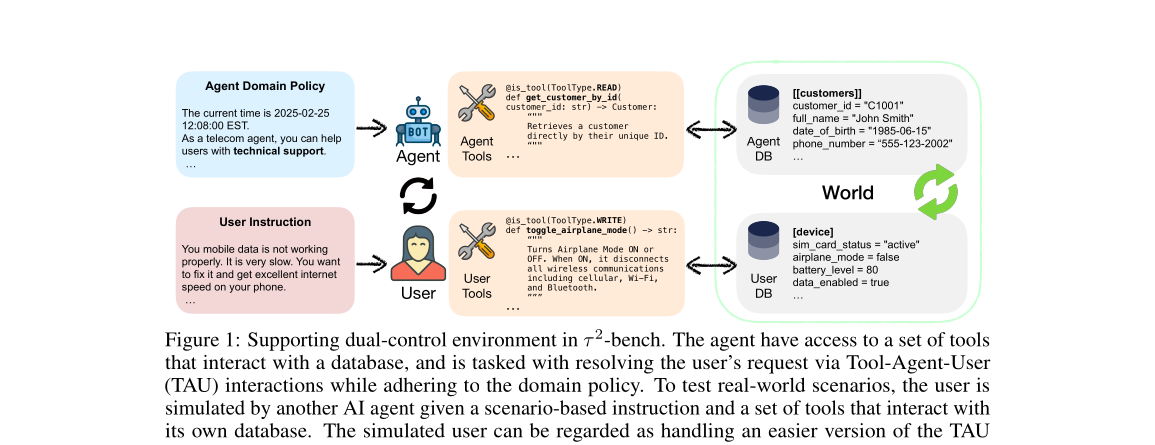
整个系统由两个 LLM 玩家(agent 与 simulated user)围绕一个共享世界交互:
- 共享世界 World = Agent DB(CRM:customers / lines / plans / bills)⊗ User DB(mocked phone:信号、飞行模式、SIM 状态、数据开关等)。两侧 DB 状态会互相影响——例如 agent 调
enable_roaming(customer_id, line_id)改 Agent DB,会让 User DB 那台手机真的能漫游。 - Agent 拿到 Domain Policy(含当前时间、可做的业务、step-by-step 排障流程),只能感知用户通过消息和工具回报的状态,负责诊断+决定动作序列+指挥用户。每一步要么发消息、要么调一个工具,二选一。
- Simulated User 拿到 scenario instruction(reason for call / known info / unknown info / task instructions)+ 一套用户工具(操作自己那台虚拟手机),按 agent 的指示被动地调工具、回报 human-readable 结果。它处理的是”更简单的对偶任务”——只需照指令行事,不需要推理解法。
- Task generator 把原子 subtask(init / solution / assertion 三元组)组合成可验证的复合任务,自动校验正确性。
- 评测在多种模式(Default / No-User / Oracle Plan)下跑 pass^k,把推理失败和协作失败拆开诊断。
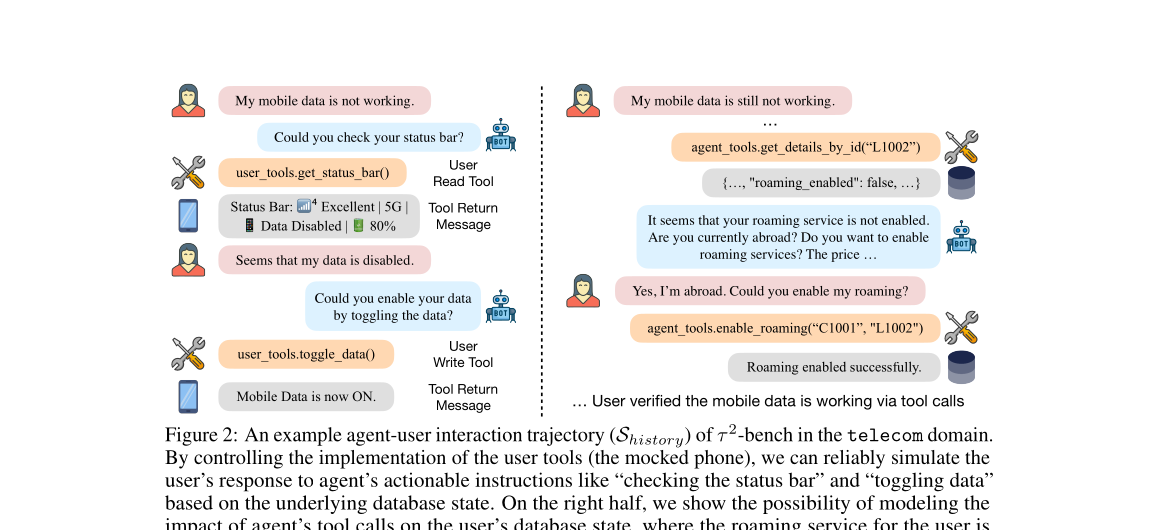
下图是一条真实的 telecom 交互轨迹(Shistory),展示了 user read tool(看状态栏)、user write tool(toggle data)、以及 agent 工具调用(enable_roaming)如何跨 DB 改变 user 那台手机的状态:
子模块实现(可复现细节)
1. Dec-POMDP 形式化
整个交互定义为元组 ,玩家 :
- 消息空间 :agent 与 user 间的自然语言消息集合。
- 状态空间 ,其中 是两侧数据库状态, 记录所有交互事件(动作 / 观察 / 消息)。telecom 里 是 CRM 数据, 是手机状态。
- 动作空间 :玩家 的动作 要么是工具调用 (以
tool_name(**kwargs)形式操作 ),要么是消息 。每回合只有一个玩家行动。 - 观察空间 :玩家 的观察 要么是工具观察 (数据 / 消息 / 报错),要么是对方玩家 的消息 。每回合只有一个玩家收到观察。
- 转移函数 :给定状态 和联合动作 ,产出新状态 和联合观察 。调工具可能改 并返回 ;发消息则令 。 总是更新 和 。
- 奖励函数 :基于最终全局状态给全局奖励,标志任务成败(如 telecom 里用户”无数据”问题被修复、由 user DB 状态验证)。
- 指令空间 :定义引导用户模拟的 scenario,以及 agent 必须遵守的 domain policy。
复现要点:tool 调用和 message 是互斥的单一动作;agent 系统提示里明确写”In each turn you can either: send a message OR make a tool call. You cannot do both”。
2. 用户工具的”复杂度不对称”设计(核心机巧)
这是整篇方法上最值得借鉴的部分。用户被赋予 agency 但不能太强,靠三条工程约束实现:
- 用户工具只产 human-readable 输出:例如
get_status_bar()返回一行带 emoji 的状态栏文本(📶 Excellent | 5G | 📱 Data Disabled | 🔋 80%),而不是结构化 JSON。这样用户没法靠结构化数据自己推理诊断,必须把信息”念”给 agent 听、由 agent 决策。 - 用户只做 reactive tool use:系统提示硬约束”Only call a tool if the agent has requested it”,用户不规划、不主动尝试解法。
- 环境紧约束行为:用户回应不靠大段 NL prompt 去编,而是由底层 DB 状态决定——agent 让”查状态栏”,工具就基于真实 DB 状态确定性地返回,simulator 难以幻觉。
telecom 域用户工具规模:15 个 write + 15 个 read(agent 侧是 6 write + 7 read)。
3. 程序化任务生成器(可验证 + 可控复杂度)
每个原子 subtask 定义为三元组 , 是 subtask 的第 个操作 DB 的函数调用:
- 初始化函数 :设置初始故障态,如
set_airplane_mode(True)。可以是相关 DB 里任意函数。 - 解函数 :解决该故障的工具调用,如
toggle_airplane_mode()。必须是 agent 或 user 可用的工具(否则任务不可解)。 - 断言函数 :最终状态 须满足的条件,如
assert_service_status("connected")。可以是任意函数。
组合规则:原子 subtask 按”互斥 / 可替代”分组(mutually exclusive 放同组);一个复合任务从每组至多选一个 subtask,拼接其函数调用。
自动正确性校验:依次施加所有 init→sol 后检查最终状态 是否满足全部 assertion;同时验证在全部 sol 施加前任务未被解决(保证 solution 步骤都是必需的,无冗余 / 无捷径)。
telecom 域:15 个原子 subtask 组,覆盖 3 个递增复杂度的 user intent(service_issue < mobile_data_issue < mms_issue,后两者常需先排查并修复底层 service_issue,形成天然难度梯度)。程序化组合得 2285 个任务,再下采样到 114 个做 intent × subtask 数的平衡分布。subtask 数 / action 数作为难度代理。
Persona 机制:每个 telecom 任务随机赋一个 persona——None / Easy(41 岁办公室管理员,技术中等、耐心、会确认理解)/ Hard(64 岁退休图书管理员,技术差、易慌、只在被问时才给信息、怕重启丢照片)。
4. 用户模拟器实现
用 gpt-4.1-2025-04-14 实现,function-calling agent 形式,工具走 OpenAI tools 格式。系统提示(User Simulation Guidelines)关键约束:
- 一次只生成一条消息;每回合 message 或 tool call 二选一。
- 严格跟随 scenario instruction,不许编造未提供的信息(未给的信息视为 unknown/unavailable);不许编造工具调用结果,必须 ground 在真实工具返回上。
- 信息渐进式披露:等 agent 问了再给。
- agent 一次让做多个动作时,回”我一次只能做一个,请一步步指示”。
- 带 tool call 的消息不展示给 agent,只有纯消息才发给 agent。
- 控制 token:目标达成发
###STOP###;被转人工发###TRANSFER###;scenario 信息不够继续发###OUT-OF-SCOPE###。
5. 任务评测准则
任务成功可用 5 类准则组合:DB check、status assertion(用 assertion 函数查 最终态)、natural language assertion(用 NL 描述查 ,如”agent 是否诊断出病因”)、communication info check、action matching(每个 是否真出现在轨迹中)。telecom 域只用 assertion 函数判成败。
实验设置与结果
Agent 设置:LiteLLM 统一调用;评测 gpt-4.1-mini、gpt-4.1、o4-mini、claude-3-7-sonnet;user simulator 固定用 gpt-4.1。每任务跑 4 次,temperature=0。agent 与 user 都是 function-calling agent。一次全域单 trial 成本约 0.086/$0.059 每任务)。
指标:pass^k = k 次独立运行全部成功的任务比例(沿用 τ-bench,越大 k 越严苛,衡量可靠性/一致性)。
域统计:
| 域 | Agent DB | Agent Tools | User Tools | Tasks |
|---|---|---|---|---|
| retail | 500 users, 50 products, 1000 orders | 7 write, 6 read | — | 115 |
| airline | 500 users, 300 flights, 2000 reservations | 6 write, 6 read | — | 50 |
| telecom | 5 plans, 9 lines, 4 customers | 6 write, 7 read | 15 write, 15 read | 114(full: 2285) |
主结果 pass^k(跨域):telecom 普遍更难,尤其 gpt-4.1 从 retail/airline 的 74%/56% 暴跌到 telecom 34%。
| 模型 | telecom pass^1 | telecom pass^4 | retail pass^1 | airline pass^1 |
|---|---|---|---|---|
| gpt-4.1 | 0.34 | 0.19 | 0.74 | 0.56 |
| gpt-4.1-mini | 0.44 | 0.18 | 0.66 | 0.51 |
| o4-mini | 0.42 | 0.26 | 0.71 | 0.59 |
| claude-3.7-sonnet | 0.49 | 0.25 | 0.79 | 0.50 |
claude-3.7-sonnet 的 telecom pass^1(49%)与 airline 持平,但 k 增大时 telecom 衰减更快 → 一致性差。
核心消融:Default vs No-User vs Oracle Plan(telecom,下图):
- No-User:agent 拿到问题工单,独控所有工具(含本该用户操作的)——只测推理 / tool-calling,剥离与用户的交互。
- Oracle Plan:直接给 agent 完整解题工具序列(含 user/agent 双方动作)——卸掉推理负担,只测”指挥用户执行已知计划”的协作能力。
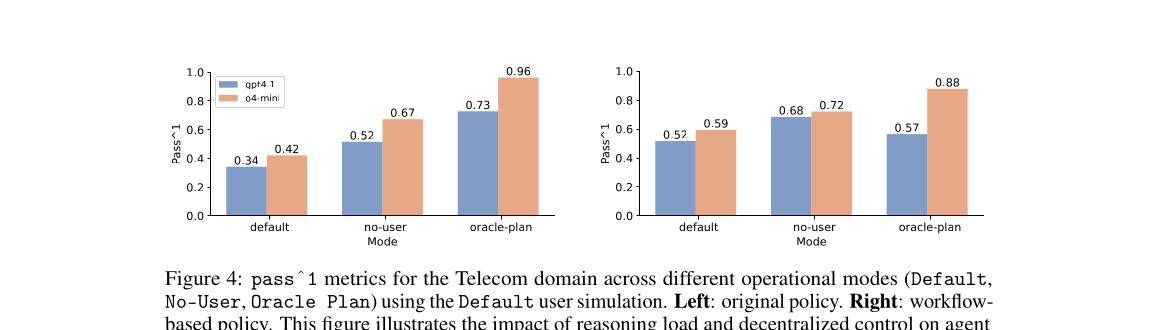
| 模式(原始 policy) | gpt-4.1 pass^1 | o4-mini pass^1 |
|---|---|---|
| Default(双控协作) | 0.34 | 0.42 |
| No-User(独控) | 0.52 | 0.67 |
| Oracle Plan(给解法) | 0.73 | 0.96 |
关键结论:
- No-User → Default 暴跌 18%(gpt-4.1)/ 25%(o4-mini)——指挥有自主性的用户才是真瓶颈,不是纯推理。
- Default → Oracle Plan 的差距 = 推理负担;o4-mini 从 oracle 信息中获益更大(reasoning model 更会用 ground truth)。
- Workflow policy(给更具体的排障流程) 在 Default/No-User 下略微提升,但在 Oracle Plan 下反而掉(gpt-4.1 从 0.73→0.57)——已有 ground truth 时再塞 workflow 会造成混淆。
action 数 / subtask 数维度:随 action 数增加 pass^1 单调下降,Default 模式 >7 actions 时接近 0;No-User 整体更高但差距随 action 增多收窄(从 0.3–0.4 缩到 <0.2)——长程可靠性是双模式共同难题,沟通不是唯一瓶颈。
issue type:失败主要来自更复杂的 mobile_data_issue / mms_issue(需多阶段推理 + 条件逻辑),service_issue 最易。
persona:Easy persona 成功率最高;None(无 persona)往往与 Hard 持平或更低——提示部署前必须用明确 persona 测试。
用户模拟器可靠性(人工双标注,每用户回合查 4 项:守 guideline / 守 instruction / 正确用工具 / 自然连贯):
| 域 | 对话数 | Critical Errors | Benign Errors | Total |
|---|---|---|---|---|
| airline | 100 | 13 (13%) | 34 (34%) | 47 (47%) |
| retail | 50 | 6 (12%) | 14 (28%) | 20 (40%) |
| telecom | 50 | 3 (6%) | 5 (10%) | 8 (16%) |
telecom 错误率 16%(critical 6%)远低于 retail/airline 的 40%/47%(critical 12%/13%)。原因正是 dual-control 设计:结构化接口 + 清晰动作空间天然把 simulator 导向正确行为,不靠大段 NL prompt。critical error 多源于过早终止或漏掉约束。
思考与可参考价值
局限:
- 仅 telecom 一个 dual-control 域;retail/airline 仍是 single-control,论文也坦承尚未把”给用户配工具提升可靠性”的方法迁移过去。
- 域扩展严重依赖人类专家(PRD→schema→tools→policy→manual refine 五阶段),自动化程度低,难以工业规模铺开。
- 未显式建模 expert-novice gap:真实客服里专家要揣摩新手心智模型并调整解释方式,本 benchmark 没测 agent 这种”因人施教”能力。
- user simulator 多样性受 generator 模板 + persona 三档约束。
对电商 / 搜索推荐 / Agent 方向的可借鉴点:
- dual-control 是导购 / 履约 / 售后 Agent 的真实形态:电商场景里用户也要动手——确认收货、改地址、退货寄回、绑卡、在 App 里点优惠券。把”用户也能 act”形式化进评测环境,比单边 agent 评测更贴近真实转化链路。可直接照搬”agent DB(CRM/订单)⊗ user DB(端侧状态)“的双库共享世界建模。
- “复杂度不对称”三原则是构建可靠 user simulator 的实用配方:① 用户工具只回 human-readable、不回结构化数据;② 用户 reactive、不规划;③ 用环境状态而非 NL prompt 约束行为。这把 user-sim 错误率从 ~45% 压到 16%,对任何要拿 LLM 当用户来训练 / 评测对话 agent(含推荐解释、客服 RL)的团队都直接可用——也正好契合把 τ²-bench 当训练环境做 RL(MUA-RL / UserRL 范式)。
- 程序化任务生成(init/sol/assert 三元组 + 互斥分组组合 + 双向自动校验):可验证、可控难度、防数据污染、零人工标注扩展任务集。做电商 agent 离线评测集时,用”故障注入函数 + 解函数 + 断言函数”组合爆破出几千个可证正确的任务,比手搓 case 鲁棒得多。
- No-User / Oracle Plan 解耦诊断:把”agent 推理对不对”和”agent 会不会指挥用户”两类失败彻底拆开。落地导购 / 客服 Agent 时,这套诊断能精准定位是策略推理弱还是协作指令弱,指导是该补 policy/RAG 还是该补多轮协作训练。
- persona 警示:无 persona 评测会高估线上表现(None≈Hard),上线前务必用覆盖低技术力用户的 persona 压测——对面向大众的电商客服尤其关键。