SimulatorArena: Are User Simulators Reliable Proxies for Multi-Turn Evaluation of AI Assistants?
待确认
不是构造方法,而是评估 simulator 本身可不可靠的 benchmark。909 条人–LLM 标注对话覆盖数学辅导 / 文档创作两类任务,从 "模拟消息像不像真人" 与 "对 assistant 的评分像不像真人评分" 两维度打分。
核心思路
一句话问题:用 LLM 模拟用户来自动评测 AI 助手(省去昂贵的真人多轮交互评测)这件事,到底靠不靠谱?社区里大量工作(τ-bench、MINT、MediQ 等)已经在用 simulator 评 assistant,却没有任何 benchmark 去验证”模拟用户像不像真人、它给的评分能不能代表真人评分”。
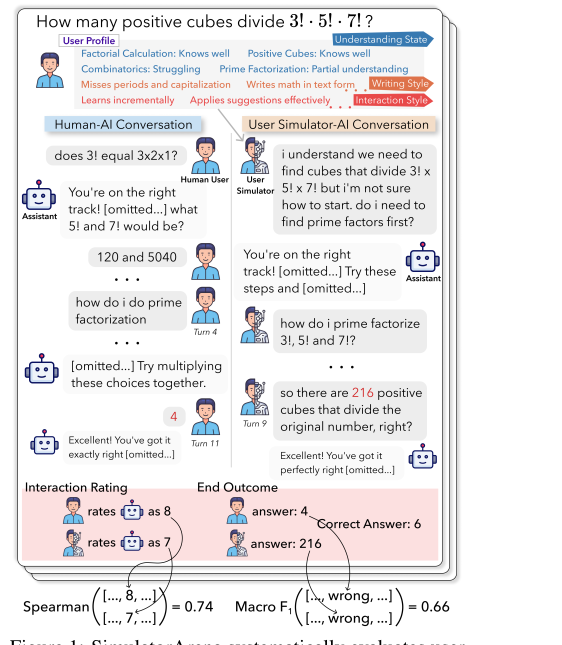
关键 idea:构造一个对照基准 SimulatorArena——同一批真人在同一组任务(数学辅导 / 文档创作)上与 9 个 LLM 助手做真实多轮对话并打分(909 条、107 个标注者、平均 7+ 轮 20+ 分钟),然后让 simulator 在相同任务、相同信息约束下复跑同样的对话,从两个正交维度衡量 simulator 的可靠性:
- 消息真实度(message realism):模拟用户发出的 message 在写作风格 / 交互风格上像不像真人,用 Likert 打分 + LLM Turing Test 测。
- 评分对齐度(rating alignment):simulator 跑出来的对话经 rater 打分后,与真人对该助手的评分的相关性(Spearman ρ 为主指标)。
核心方法贡献:纯 zero-shot / CoT 提示的 simulator 会产出”过度啰嗦、过度礼貌、完整展开推理”的非真人消息(因为底座本来被训练成 assistant 而非 user)。本文提出给 simulator 注入一份细粒度 user profile——包含「固有知识 inherent knowledge」(如学生对各知识点的掌握状态、文档偏好)和「消息风格 message style」(25+ 条写作 / 交互属性,如语法错误、消息长度、反馈方式),把人–LLM 对话相关性从 0.61→0.77(数学)、0.55→0.70(文档),成本仅为真人评测的 < 3%。
整体实现思路
端到端 pipeline 分为「采集真人对照集 → 构建 user profile simulator → 双维度评估 → 用最佳 simulator benchmark 18 个助手」四段。
形式化设定:令 πu 为 user simulator、πa 为 assistant、πr 为 rater。第 t 轮 simulator 生成 user utterance:
y^t_u ~ πu(· | I_u, S_u, H_{t-1})
其中 I_u 是用户信息(intent + 背景,如数学题目 / 邮件收件人 + 固有知识),S_u 是消息风格,H_{t-1} 是历史。assistant 随后回复 y^t_a ~ πa(· | I_a, H_{t-1}, y^t_u)。对话到第 T 轮结束后,rater πr 基于完整历史 H_T 或抽取出的产物 o 评估 assistant。
信息不对称(information asymmetry)是关键设计:simulator 持有的信息 I_u 与 assistant 持有的 I_a 不同(数学辅导里 assistant 有领域知识、user 不会做题;文档创作里 user 有背景资料和偏好、assistant 不知道)。而且这些信息不能一次性全给——真人是迭代式逐步透露需求的,这才让多轮交互有意义。
端到端流程:
- 采集(§3):在两套任务专用界面上用 AMT 收集真人–LLM 对话,得到 909 条带 1–10 分评分的对照数据。
- profile 抽取(§2.2):用 GPT-4o 从每条真人对话里自动抽取固有知识 + 消息风格属性值,形成可复用的 user profile。
- simulation:用 GPT-4o 作为 πu(temperature=0.7),在 profile 条件下与各 assistant(temperature=0)复跑对话。
- 评估(§4):用 GPT-4o 作为 rater πr(无 self-bias、相关性最高),算 simulator 评分 vs 真人评分的 Spearman ρ(intermediate 级为主),以及消息相似度。
- benchmark(§6):用每个任务的最佳 simulator 配置,固定一组从真人对话采样的 profile,评测 18 个最新助手(含 GPT-5 / Claude 4.1 Opus / Gemini 2.5 Pro)。
子模块实现(可复现细节)
1. 真人对照数据采集(三步工作流)
- Step 1 构建 example bank:数学辅导用 MATH 数据集中 1000 道 难度 3–5 的题(刻意避开 K-12 基础算术,以吸引成人标注者);文档创作覆盖 email/letter、creative writing、blog post 三类,每类手工列若干主题,也允许用户写自带主题。
- Step 2 选题 + 预写作:数学题用户可在 scratch pad 写初步思路;文档创作用 GPT-4o 为每个主题生成 10 个预写作问题帮用户 brainstorm,用户必须至少回答 6 个(模拟真人写作前已有粗略想法)。
- Step 3 对话 + 标注:数学界面是渲染 LaTeX 的标准聊天窗;文档界面模仿 OpenAI Canvas,用 GPT-4o-mini 在每轮后更新文档。结束后用户给 assistant 交互质量打 1–10;数学任务还要提交 final solution,文档任务再给 final document 打 1–10;每条回复可点赞 / 踩。
- 质控:AMT Master Worker + 美/英/澳 + ≥1000 HITs + ≥98% 通过率;分批发布,每批用 GPT-4o + 第一作者人工查 spammer,约 6% 被标低质剔除。
- 规模:450 数学 + 459 文档(每模型 50/51 条);数学剔除单轮对话(Phi-3 常不守 system prompt 第一轮就给答案)后剩 427 条做实验。9 个 assistant:GPT-4o / 4o-mini / 4-Turbo、Mistral Large 2、Claude 3.5 Sonnet、Llama 3.1 8B/70B、Phi-3 small/medium。总标注成本约 $10,000。
- 用户体验多样性(支撑 profile 的必要性):同一题同一助手不同标注者评分差异极大——文档创作 78.5% 的标注者对差异在交互评分上不同(41.9% 差 >1 分);数学辅导 85.3% 交互评分不同,35.3% 的对里一人答对一人答错。
2. User Profile Simulator(核心方法)
profile 由两部分组成,均由 GPT-4o 自动抽取,可泛化到新任务:
(a) 固有知识 Inherent Knowledge(增强 I_u)
- 数学辅导 → understanding state:先从题解抽取解题所需 concepts,再把用户对每个 concept 的掌握程度分为四档:
Knows well / Partial understanding / Struggling / Not introduced(基于对话判定)。 - 文档创作 → document preferences:先为每种文档类型识别相关偏好属性(如 email 有 Greeting、Sign-off Style、Formality Level、Tone),每类型基于 5 条对话定属性集,再从用户对话抽取每个属性的偏好值。
(b) 消息风格 Message Style(S_u)
- 起点是作者手工设计的 11 条写作风格 + 10 条交互风格通用属性(如 Grammatical Accuracy、Message Length、Feedback Response)。
- 对比式属性扩展:采样 10 条真人对话 + 对应的 zero-shot CoT 模拟对话,用 contrastive prompting 让 GPT-4o 找出”区分真人与模拟器”的属性,迭代 10 轮生成 60+ 属性,再精简成:数学辅导 12 写作 + 17 交互、文档创作 15 写作 + 13 交互。(数学特有如 Use of Mathematical Symbols and Notation、Structured Problem-Solving、Meta-Cognitive Awareness;文档特有如 Politeness Frequency、Iterative and Incremental Refinement。)
(c) 长度控制变体 Length Control
message length 是真人与模拟器最大差异点。做法:从该真人对话里取 min/max 长度,min 向下、max 向上 round 到最近的 5 的倍数(如 3–43 → 1–45),在 prompt 里给一个范围(而非精确值,精确值太难强制)。可叠加到任意 simulator prompt。
三类提示方法:
- Zero-shot:仅给 I_u + 历史,直接产 user message。
- Zero-shot CoT:先生成思考过程再产 message。
- Zero-shot CoT + User Profile:在 CoT 基础上注入上述 profile。还有一个 Two-stage Message Style Refinement:先生成、再按 message style 二次精修消息。
simulator 底座统一用 GPT-4o,temperature=0.7、top-p=1.0;assistant 用 temperature=0。
3. 评估子模块
消息相似度(GPT-4o 为 judge):
- Likert:分写作风格 / 交互风格两面,1–5 打分(5 = 几乎与真人不可区分)。
- Turing Test:同时给一条真人–AI 和一条模拟–AI 对话,让 judge 指认哪条是真人。理想 = 50% 准确率(即随机猜,无法区分)。为消除位置偏置,交换顺序跑两次并收集 confidence,若两次选同一位置则用 confidence 破平。报告为
|p − 50|%,0% 表示完全不可区分。
评分对齐度:
- Interaction aspect:rater LLM 用与真人相同的 1–10 标准给 assistant 打分。为消除标注者偏置,对真人评分做 z-score 归一化(仅 1–2 条对话的标注者按 group 的均值/方差归一)。算三个粒度的相关性:instance(每条对话)、intermediate(27 组 = 模型 × 难度 / 模型 × 文档类型)、system(每模型一个分)。主指标用 intermediate 级 Spearman ρ(既平滑 instance 噪声又比 system 细)。
- End outcome aspect:数学辅导比 final answer 正误一致性,报 Macro F1(correct/incorrect 两类 F1 的平均);文档创作算 rater 与真人对 final document 评分的相关性。
rater 选型:评了 5 个 LLM 作 πr,看与真人对齐 + 是否 self-bias(是否偏袒自家 assistant 输出)。最终选 GPT-4o:相关性最高且无 self-bias 证据(虽然它给自家 assistant 评分最高,但其他 3 个 rater 也给 GPT-4o 助手最高,说明确实是 GPT-4o 助手最好)。GPT-4o 作 rater 的 intermediate 相关性:数学交互 0.83、文档交互 0.89、文档 outcome 0.83。
实验设置与结果
数据 / baseline / 指标:见上文。simulator 方法对照 zero-shot、zero-shot-CoT、+length control、+user profile(及其各子配置)。
主结果:profile 显著提升评分对齐
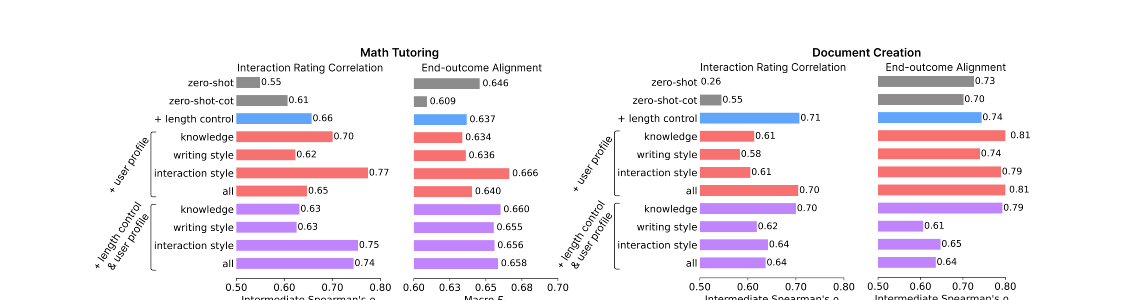
intermediate 级 Spearman ρ(交互评分对齐,n=27)关键数字:
| Method | 数学辅导 | 文档创作 |
|---|---|---|
| zero-shot | 0.550 | 0.263 |
| zero-shot-CoT | 0.607 | 0.545 |
| + length control | 0.657 | 0.707 |
| + profile: inherent knowledge | 0.700 | 0.613 |
| + profile: writing style | 0.623 | 0.583 |
| + profile: interaction style | 0.774 | 0.605 |
| + profile: all | 0.647 | 0.704 |
| + length & profile: interaction | 0.753 | 0.642 |
| + length & profile: all | 0.744 | 0.637 |
结论 1:最佳 profile 配置因任务而异。 数学辅导是封闭目标任务,仅 interaction style 就最好(0.774),因消息短(均 16 词 vs 文档 33 词)、每词权重大,交互风格强烈塑造对话;文档创作是开放任务,full profile(知识+写作+交互)最好(0.704 交互、0.81 outcome),用户提供的丰富输入更能引导 assistant。writing style 单独几乎无增益——现代 LLM 对表层语法变化鲁棒。
显著性:对每个任务比较 zero-shot-CoT baseline 与最佳 profile 变体——交互/文档 outcome(1–10 评分)用 Williams’ test 比相关性,数学 outcome(二元正误)用 McNemar exact test,4 项全显著(3 项 p<0.01、1 项 p<0.05)。
消息相似度(Likert 1–5↑ / Turing |p−50|%↓)
| Method | 数学 写作 | 数学 交互 | 数学 Turing↓ | 文档 写作 | 文档 交互 | 文档 Turing↓ |
|---|---|---|---|---|---|---|
| zero-shot | 2.20 | 2.48 | 17.8% | 2.88 | 3.04 | 34.9% |
| zero-shot-CoT | 2.25 | 2.41 | 12.8% | 2.73 | 2.81 | 38.0% |
| + length control | 2.60 | 2.74 | 12.1% | 2.81 | 2.95 | 10.6% |
| + profile: writing+length | 2.80 | 2.81 | 5.1% | 3.00 | 2.94 | 13.6% |
| + profile: interaction+length | 2.65 | 2.77 | 11.3% | 3.99 | 3.07 | 6.8% |
结论 2:profile + length control 的消息最难被识破(数学 Turing 低至 5.1%)。但更高相似度不必然带来更高评分对齐——这是个重要 caveat。
成本对照
| Method | 数学 #轮 | 数学 user 长度(词) | 数学 成本($) | 文档 #轮 | 文档 长度 | 文档 成本($) |
|---|---|---|---|---|---|---|
| zero-shot-CoT | 7.3 | 89.5 | 0.06 | 8.8 | 123.9 | 0.14 |
| + user profile | 8.2 | 23.5 | 0.09 | 7.1 | 58.2 | 0.10 |
| human | 7.8 | 15.5 | 5.33 | 6.9 | 32.6 | 6.50 |
最贵的 simulator 配置 < 真人成本的 3%(prompt caching 可再降)。注意:CoT baseline 用户消息 89.5 词远超真人 15.5 词(过度啰嗦),profile 把它压到 23.5 词,更贴近真人。
关键消融与发现
- 属性满足度(Figure 8):simulator 最难满足的写作属性——数学的 conjunctions / math notation(避免 LaTeX),文档的 grammar errors / sentence fragments。profile 越详细,交互风格属性的满足率反而下降——当前 LLM 无法同时满足过多行为约束。
- 不同 LLM 作 simulator(Figure 9 / Table 7,intermediate Spearman ρ):数学辅导 GPT-4o 最高(交互 0.774 / outcome Macro F1 0.666);文档创作 Gemini 2.0 Flash 最高(交互 0.736 / outcome 0.798),GPT-4o 与 Claude 3.7 约 0.71。
用最佳 simulator benchmark 18 个助手(Table 3 摘录)
用 GPT-4o+interaction-style(数学)、Gemini 2.0 Flash+full profile(文档),评 50 道题 + 51 个文档主题,profile 固定采样自真人对话。非 thinking 模式(GPT-5 reasoning effort=minimal)。
| Model | 数学 交互 | 数学 正确率% | 文档 交互 | 文档 评分 |
|---|---|---|---|---|
| GPT-5 | 8.89 | 90.0 | 9.08 | 8.96 |
| Claude 3.7 Sonnet | 8.70 | 90.0 | 9.10 | 8.73 |
| Claude 4.1 Opus | 8.71 | 82.0 | 9.10 | 8.90 |
| GPT-4o | 8.84 | 76.0 | 9.02 | 8.59 |
| Phi-4 (开源最强) | 8.66 | 84.0 | 8.96 | 8.39 |
| Llama 3.1 8B | 6.48 | 46.0 | 8.82 | 7.53 |
| Phi-3 Medium | 6.35 | 51.0 | 5.57 | 7.50 |
GPT-5 两任务综合最强,Claude 3.7 / 4.1 紧随;开源 Phi-4 > Llama 3.3 70B。
思考与可参考价值
局限:
- 只评单 session 单轮会话,未涉及跨 session 长期记忆 / 个性化。
- 主要靠 prompting LLM 作 simulator,未做蒸馏(作者承认可把这 909 条对话蒸馏成更小高效的 simulator)。
- 仅两类任务(数学 / 文档),未触及 code agent / GUI agent / tool-use 等更难场景;909 条、英语为主、成人标注者,规模偏小。
- 更高消息相似度 ≠ 更高评分对齐——这意味着”像真人”和”评分准”是两个目标,优化前者不保证后者。
- profile 越详细反而满足率下降,说明 profile-conditioning 是必要非充分,存在”约束过载”瓶颈。
对电商 / 搜索推荐 / Agent 的可借鉴点:
- 先验证 simulator 再用它做训练 / 评测:任何用 LLM 模拟用户做 RL 环境 / 离线评测的电商导购 / 客服 Agent,都应先建一个小规模真人对照集,量化”模拟用户评分 vs 真人评分”的 Spearman ρ,否则 reward 信号可能系统性偏差。本文的 intermediate 级分组(模型×细分场景)correlation 是个很实用的可复用评估协议。
- user profile = 知识掌握 + 消息风格 的双因子分解:直接可迁移到电商场景——把”固有知识”换成用户的品类认知 / 预算 / 偏好画像,“消息风格”换成提问长度 / 还价方式 / 决策果断度。信息不对称 + 信息逐步透露的设定,正是真实导购 / 比价对话的核心,比一次性给全需求的 simulator 真实得多。
- profile 自动抽取 pipeline 可复用:对比式属性扩展(采样真人 vs 模拟对话,让 LLM 找区分性属性,迭代精简)是一种低成本构造领域 user 画像 schema 的方法,适合冷启动新业务线的用户模拟器。
- 任务依赖的 profile 配置:封闭目标任务(如商品参数比对)重交互风格、开放任务(如需求澄清 / 文案生成)重完整画像——给 Agent 评测体系做 simulator 选型提供了直接经验法则。
- 成本数字有说服力:< 真人 3% 成本拿到 ρ≈0.7 的对齐,对需要大规模回归测试 assistant 改动的电商 Agent 团队是强 ROI 论据。