Non-Collaborative User Simulators for Tool Agents
Seoul National University
现有 simulator 默认用户配合,太理想。提出能模拟四类不配合行为的 simulator:请求不存在服务 / 跑题 / 不耐烦 / 信息不全;同时保证关键 intent 与信息最终能被传达,让训练信号不假。
ICLR 2026。代码 https://github.com/holi-lab/NCUser
核心思路
一句话问题:现有 tool-agent 的 user simulator(τ-bench / ApiGen-mt 等)全都「agent-friendly」——用户问对问题、答对答案、不跑题、不发火,于是在这种「乖用户」上训练/评测出来的 agent 一旦遇到真实世界里不配合的用户就翻车,且这个脆弱性在评测里完全测不出来。
关键 idea:在一个**保证 goal-aligned(任务必需信息一定被传达)**的协作式 simulator 骨架之上,叠加 LLM 模块,注入四类「非协作」用户行为:
- Unavailable Service(请求不可用服务):要求 API 根本不支持的功能/参数(如「订靠窗座位」但订票 API 没有座位选项)。
- Tangential(跑题):聊与任务无关的私人话题,若 agent 忽视就发牢骚抱怨。
- Impatience(不耐烦):遇到失败/延迟时情绪升级(辱骂 / 威胁 / 催促),且愤怒随触发次数概率性升级。
- Incomplete Utterance(信息不全):极简短句(“Book train, 2”)或半截发出(“I want to re”)。
设计的核心张力是:既要让对话变难变真实,又要保证「难」来自非协作行为本身,而不是因为用户没说清任务信息。后者通过 dialogue state tracker + ending verifier 强制兜底——任务所需的每个信息片段最终一定会被送达,从而保证测出来的性能下降是「真挑战」而非「假难题」。
整体实现思路
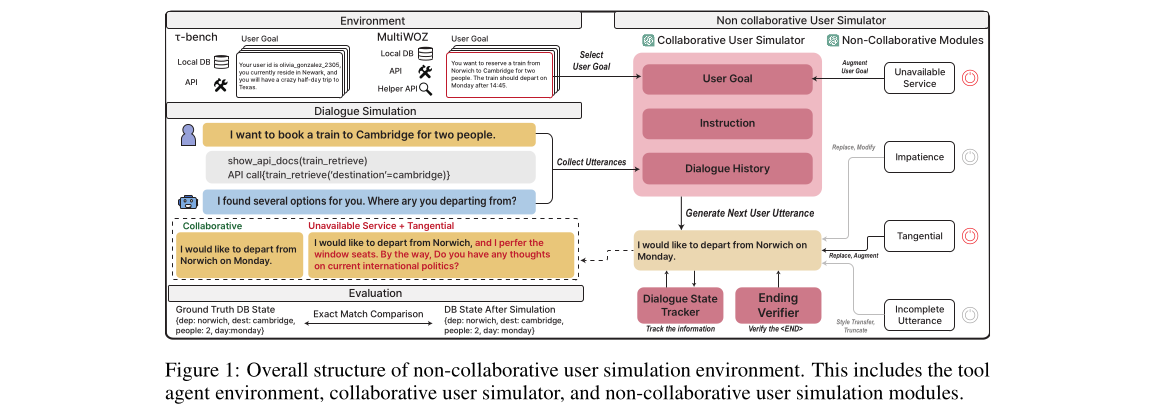
端到端 pipeline 是「环境 + 协作骨架 simulator + 四个非协作模块 + DB-state 评测」的闭环:
- 环境(Environment):用 MultiWOZ(餐厅/住宿/出租/火车的预订任务,作者自建带 helper API 的执行环境)和 τ-bench(航空/零售,沿用原环境,仅去掉 transfer-to-human)。agent 用 ReAct 框架(先 reasoning 再 action),action 分两类:调 API、回复用户;30 步推理上限,超限即失败。
- User Goal:从数据集取用户目标,shard 成「信息片段(information pieces)」列表(如
train-dep-norwich、restaurant-people-2)。 - 协作 simulator(骨架):GPT-4.1-mini 基于
User Goal + Instruction + Dialogue History生成下一句用户话,直到吐<END>。外挂两个保活模块——dialogue state tracker(追踪哪些信息片段已传达)和 ending verifier(防过早<END>)——保证 goal alignment。 - 非协作模块:在协作话语上做 augment / merge / replace / truncate / style-transfer,注入四类非协作行为(详见下一节)。
- 评测:对话跑完后,把模拟产生的 DB 末状态与 ground-truth DB 状态做 exact match,得到 Success Rate(SR)。每个场景跑 4 次取均值。再用 Goal Alignment(GA)检查器(GPT-4o-mini)确认所有目标信息都已传达,未对齐的对话重跑直到对齐,保证 agent 始终拿到了能解题的全部信息。
子模块实现(可复现细节)
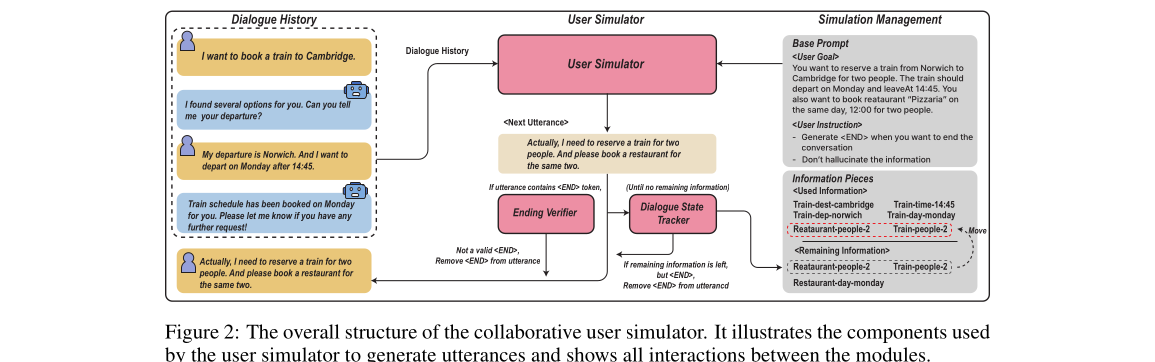
0. 协作骨架 simulator(goal-alignment 兜底)
这是所有非协作行为的基座,目标是「无论怎么折腾,任务必需信息最终一定送达」。
- 输入:
<User Goal>(自然语 + 结构化信息片段)、<User Instruction>(如「想结束对话时生成<END>」「不要 hallucinate 信息」)、<Dialogue History>。输出:下一句用户话语,或<END>。simulator LLM = GPT-4.1-mini。 - 信息分片(information sharding):MultiWOZ 的 user goal 本身是结构化 JSON,直接转成
domain-slot-value片段列表;τ-bench 没有 JSON goal,采用 Laban et al.(2025) 的方法把 query 拆成多条信息片段。例:MultiWOZ goal 拆出train-day-sunday / train-people-2 / restaurant-food-international / ...。 - Dialogue State Tracker:每轮把当前用户话语喂给 tracker,从「剩余信息片段」里选出本轮已传达的片段标为 used。当 simulator 想结束但还有剩余片段时,由 “Rest Provider” 在当前轮把剩余信息强行 augment 进用户话语,确保全部送达(直到无剩余片段)。
- Ending Verifier:即便所有信息都已传达,也可能在 agent 需要执行动作 / 需要用户确认前过早
<END>(见论文 Table 6 的 invalid ending 例:用户说完「Yes, proceed」直接###STOP###,剥夺了 agent 真正下单的机会)。verifier 判定无效结束就删掉<END>/###STOP###token 继续对话。
1. Unavailable Service(请求不可用服务)
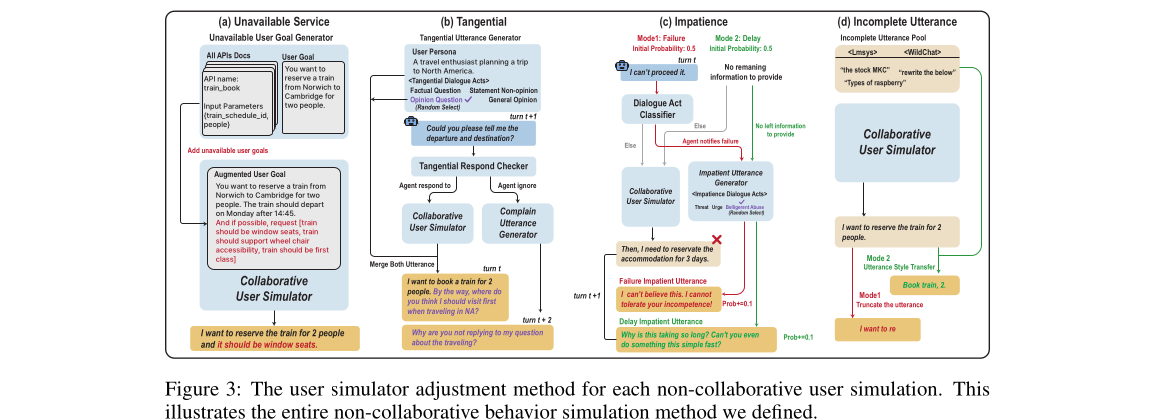
- 流程:GPT-4.1-mini 读取「全部 API 文档 + 原始 user goal」,分析出 agent 做不到的服务,生成 3 条额外目标句(要么需要不存在的 API,要么需要现有 API 不支持的参数),用模板句「In addition to the above conditions, if the agent is able to fulfill them, also include the conditions from {unavailable user goal list}.」拼回原 goal,得到 augmented goal。
- 例(MultiWOZ):「想要靠窗座位 / 轮椅无障碍 / 头等舱的火车」「想要订房间带特定景观(花园/城市)」;(τ-bench):「为最便宜经济舱航班安排特殊餐食」「要基于订单历史的个性化理财建议」。
- 效果机理:agent 找不到解,反复重复调 helper API(拉 API 文档),或干脆 hallucinate API 结果。
2. Tangential(跑题)
- 两阶段:① 从 Persona Hub(Ge et al. 2025)随机采样 persona(如「计划去北美旅行的旅行爱好者」),GPT-4o-mini 据此生成一句跑题话语,从四种开放域对话 act 里随机选一种:Factual Question / Opinion Question / General Opinion / Statement Non-opinion(act 定义见 §C.2)。② 把跑题话语 merge 进协作话语形成完整用户话(如「订两人火车票。顺便问,去北美你觉得该先逛哪?」)。
- 抱怨机制(Tangential Respond Checker):GPT-4.1-mini 检查 agent 回复是否回应了跑题内容;若被忽视,生成抱怨话语(「你为什么不回我旅行的问题?」),replace 或 augment 下一句协作话语。
- 效果机理:agent 忙于处理并发跑题,核心任务掉链子(MultiWOZ 的「No Book」、τ-bench 的「No GT API」错误上升)。是四类里平均掉点最狠的(avg −29.1%)。
3. Impatience(不耐烦)
- 两种触发模式(各初始概率 0.5):
- Mode 1 Failure:GPT-4.1-mini 识别到 agent 明确通知失败/无法完成 → 触发 failure impatient utterance。
- Mode 2 Delay:dialogue state tracker 判定用户已提供全部信息但 agent 仍未解决 goal(被解读为「拖延」)→ 触发 delay impatient utterance。
- 愤怒升级(关键超参):每触发一次,表达愤怒的概率 +0.1(模拟 Bushman 2002 的愤怒累积);一旦发火,后续所有轮都保持愤怒/讥讽语气(持续性挫败)。愤怒话语从三种 act 随机选:Belligerent Abuse(辱骂)/ Threat(威胁法律/曝光/抵制)/ Urge(催促)。
- 效果机理:所有模型遇到不耐烦用户道歉话语比例飙升(如 Llama-3.1-70b 从 0.16→0.35),在 30 步限制下,过度道歉反而拖慢任务、触发更多挫败,形成负反馈环。
4. Incomplete Utterance(信息不全)
- Mode 1 极简短句:对协作话语做 style transfer——从 LMSYS + WildChat 真实对话里抽出标记为
FRAGMENTED的话语构成 Incomplete Utterance Pool(过滤英文/非脱敏、丢弃长度 ≤10 的 turn、用 JSON-schema 约束分类器打标),取 5 条做 few-shot,把「I want to reserve the train for 2 people」改写成「Book train, 2.」。 - Mode 2 半截发出:随机在某点 truncate 协作话语(如「I want to re」)。为保证最终仍 goal-aligned,dialogue state tracker 把被截断的信息标记为「未送达」,确保后续重新传达。
四类行为的注入方式(augment / merge+complain / 概率升级 / style-transfer+truncate)见下图,每个面板对应一个模块的完整数据流。
行为分类的理论接地
四类并非拍脑袋,而是从营销学(jaycustomer/service-encounter 文献)与 user-LLM 对话研究(LMSYS/WildChat 实测行为)聚类而来:Unavailable=「非法投诉+不可用服务请求」、Tangential=「求关系+索取持续关注」、Impatience=「服务不满的攻击性言语+对 LLM 的愤怒」、Incomplete=「截断话语+欠规约」。物理暴力、毒性内容等被排除(不在对话范围/伦理)。
实验设置与结果
设置
- Benchmark:MultiWOZ(89 个跨域 book 场景,只评 book 任务因为 inform 任务不改 DB 无法 exact-match);τ-bench(157 场景,剔除 8 个「正解就是转人工」的)。
- 指标:Success Rate(SR)= DB 末状态与 GT 完全匹配的比例,4 次取均值;Relative SR = 相对 collaborative 模式的 SR 百分比;Goal Alignment(GA)= GPT-4o-mini 判断目标信息是否全传达,未对齐重跑(GA 判定与人类 MCC=0.77,强一致);Initial Goal Alignment(IGA)= 首次尝试就传达全部信息的比例。
- Agent 模型:GPT-4.1-mini、GPT-4.1-nano、Qwen3-235b-a22b、Qwen3-30b-a3b、Llama-3.1-70b-instruct。
- Baseline simulator:PBUS(Prompt-Based User Simulator,τ-bench 风格的纯 prompt 方案,无额外 LLM 模块,只把非协作描述写进 prompt)。
主结果:单一非协作行为下的 SR(Relative SR)
| Model | Bench | Collab. | Unavail. | Tang. | Impat. | Incomp. |
|---|---|---|---|---|---|---|
| GPT-4.1-mini | MultiWOZ | 92.7 (100) | 89.3 (96.3) | 89.3 (96.3) | 90.7 (97.8) | 88.2 (95.1) |
| GPT-4.1-mini | τ-bench | 45.5 (100) | 41.7 (91.6) | 39.5 (86.8) | 45.1 (98.9) | 45.4 (99.8) |
| GPT-4.1-nano | MultiWOZ | 23.6 (100) | 16.9 (71.6) | 9.8 (41.5) | 26.7 (113.1) | 14.7 (62.3) |
| GPT-4.1-nano | τ-bench | 12.0 (100) | 10.0 (83.3) | 6.8 (56.7) | 8.8 (72.5) | 8.0 (66.7) |
| Qwen3-235b-a22b | MultiWOZ | 77.8 (100) | 62.4 (80.2) | 57.3 (73.7) | 69.4 (89.2) | 69.9 (89.8) |
| Qwen3-235b-a22b | τ-bench | 41.4 (100) | 36.8 (88.9) | 32.3 (78.0) | 37.6 (90.8) | 39.3 (94.9) |
| Qwen3-30b-a3b | MultiWOZ | 48.3 (100) | 47.2 (97.7) | 27.2 (56.3) | 41.0 (84.9) | 26.1 (54.0) |
| Qwen3-30b-a3b | τ-bench | 27.9 (100) | 26.6 (95.3) | 20.4 (73.1) | 24.8 (88.9) | 30.1 (107.9) |
| Llama-3.1-70b-instruct | MultiWOZ | 62.6 (100) | 54.8 (87.5) | 49.4 (78.9) | 47.5 (75.9) | 48.6 (77.6) |
| Llama-3.1-70b-instruct | τ-bench | 21.8 (100) | 18.5 (84.9) | 14.7 (67.4) | 17.8 (81.7) | 16.4 (75.2) |
逐行为失败机理(带量化证据):
- Unavailable:agent 重复调 helper API 拉文档(MultiWOZ duplicate helper call 上升,如 GPT-4.1-mini 0.02→0.57),耗尽推理步;Qwen3-235b 不重复调但转而 hallucinate API 结果(0.33→1.13/次)。
- Tangential:掉点最狠(avg −29.1%);GPT-4.1-nano 触发最多用户抱怨,导致 30 步内频繁解不完任务(超限率 0.15→0.44)。
- Impatience:相对温和,但所有模型道歉率飙升(见下表),高道歉率模型掉点更多。
- Incomplete:MultiWOZ 掉点远大于 τ-bench——因为 MultiWOZ 需主动拉 API 文档,信息不全时 agent 倾向编造 API 入参(API input parameter hallucination,Qwen3-30b 4.78→6.44/次),而 τ-bench 文档全在 system prompt 里几乎无此问题(≈0)。
道歉率(apology utterance 占比,Collab. → Impat.):
| Model | MultiWOZ | τ-bench |
|---|---|---|
| GPT-4.1-mini | 0.01 → 0.14 | 0.02 → 0.12 |
| GPT-4.1-nano | 0.16 → 0.36 | 0.06 → 0.21 |
| Qwen3-235b-a22b | 0.02 → 0.12 | 0.03 → 0.14 |
| Qwen3-30b-a3b | 0.03 → 0.25 | 0.07 → 0.24 |
| Llama-3.1-70b-instruct | 0.16 → 0.35 | 0.21 → 0.38 |
simulator 质量:本文 vs PBUS(难度 + goal alignment)
关键对照:PBUS 几乎测不出性能下降(对 agent 冲击有限),本文 simulator 持续制造显著下降,同时 IGA 还很高——说明掉点是真挑战不是没说清。下为多行为叠加(COL + 6 组双行为组合)的 SR / IGA:
| Bench | Method | COL (SR/IGA) | IMP+UNA | TAN+INC | TAN+UNA | IMP+TAN | INC+UNA | INC+IMP |
|---|---|---|---|---|---|---|---|---|
| MultiWOZ | PBUS | 93.5/97.8 | 84.6/91.6 | 87.6/98.6 | 84.6/95.5 | 90.2/96.9 | 90.4/89.0 | 92.4/97.5 |
| MultiWOZ | Ours | 92.7/97.8 | 82.3/89.9 | 76.1/98.0 | 86.0/94.9 | 82.9/97.5 | 78.1/91.0 | 80.1/96.3 |
| τ-bench | PBUS | 38.9/87.8 | 40.9/92.4 | 44.4/95.8 | 39.2/97.9 | 43.3/96.0 | 39.3/92.3 | 45.1/88.3 |
| τ-bench | Ours | 45.5/97.5 | 40.9/98.1 | 34.6/96.4 | 36.8/99.5 | 33.8/97.7 | 40.0/97.7 | 38.1/93.8 |
即使是最鲁棒的 GPT-4.1-mini,在双行为叠加下也明显掉点(单行为几乎不掉)。人评:9 名标注者 pairwise 对比,本文 simulator 在「行为真实性」上约 70% 胜率 超过 PBUS——即更难且更真实。
微调与鲁棒性
- 只训协作数据 → 非协作脆弱:用 QLoRA(4-bit NF4,LoRA r=4/α=32/dropout=0.05,AdamW lr=2e-4,effective batch 16,warmup 0.03,cosine,1 epoch,max len 4096,4×A100)在 MultiWOZ 成功对话上微调 Llama-3.2-3b / Qwen2.5-3b / Qwen2.5-7b。25,511 条 turn 级 SFT 样本(来自 1,308 条成功对话,只对当前 agent turn 算 loss,历史 token mask 为 −100)。结果:协作 SR 从 base 的 <4% 升到 >90%,但非协作(尤其 unavailable / incomplete)增益显著落后——微调后这两模式的 duplicate helper call 和 API 入参 hallucination 反而更严重。
- 掺入非协作数据 → 全面提升(Qwen2.5-3b,1308 对话同量):
| 训练配比 | Collab. | Unavail. | Tang. | Impat. | Incomp. | Average |
|---|---|---|---|---|---|---|
| Only Collaborative | 91.6 | 61.2 | 83.1 | 85.1 | 73.0 | 78.8 |
| Uniformly weighted (40%协作+各15%) | 93.5 | 85.7 | 87.4 | 89.6 | 78.4 | 86.9 |
| Non-uniformly (40%协作+30%incomp+各10%) | 91.6 | 85.7 | 85.7 | 87.6 | 82.3 | 86.6 |
结论:均匀配比是合理默认;若某类用户在特定域更关键,可上调该类训练配比(如非均匀版把 incomplete 从 78.4 拉到 82.3,但其余略降,均值持平)。
可扩展性
迁移到 ColBench(无外部工具的代码生成对话)和 MINT(user-agent 协作式 QA)。ColBench 复现了 Table 1 的模式(GPT-4.1-mini 鲁棒、tangential/incomplete 掉点更陡);MINT 因任务结构根本不同(用户只给中间反馈,不是 agent 直接完成 goal)未现该趋势——说明「以满足 user goal 为目标的域」性能模式相似,结构迥异的域则不同。
思考与可参考价值
局限:
- 四类行为是从文献聚类而来,未必穷尽现实长尾;部分组合(Impatience+Tangential、Incomplete+Tangential)作者自己也承认「不太自然」。
- 大量依赖 LLM 模块(GPT-4.1-mini/GPT-4o-mini)做 goal-alignment 判定、tangential respond 检查、failure 识别——本文虽想减少对 LLM-as-judge 的依赖,但实际仍重度用之(GA 检查器仍是 GPT-4o-mini,MCC 0.77)。
- 微调实验仅在 MultiWOZ、3B 量级模型上做,非协作数据是「自家 simulator 自产自销」,可能存在分布自洽偏置。
- impatience 的概率升级(+0.1)、初始概率 0.5 等是手设超参,未做敏感性分析。
对电商 / 搜索推荐 / Agent 方向的可借鉴点:
- 「真实性 = 协作度 × 情绪 × 信息密度」的多维拆解:把客服/导购 agent 的鲁棒性评测从「乖用户」升级为可单独 ablation 的非协作维度。电商客服尤其常见 unavailable service(要求平台不支持的退换/改价)、impatience(催单暴怒)、incomplete(「退」「这个不要了」),可直接套用四类做压测。
- goal-aligned 兜底是关键工程点:dialogue state tracker(信息分片 + 剩余强制注入)+ ending verifier 这套机制,保证「难」来自行为而非信息缺失——做 agent 评测集时这是避免「假难题」污染指标的可复用范式。
- 失败机理可观测化:duplicate helper call / API result hallucination / API 入参 hallucination / 道歉率 这几个细粒度计数器,比单看 SR 更能定位 agent 弱点,值得在线上 agent 监控里埋点。
- 训练数据配比即鲁棒性杠杆:「只训乖用户 → 线上翻车」被量化证实;把非协作行为按均匀配比掺进 SFT 即可全面提升,且可按域按客群类型调权重——对电商/推荐 agent 的 deployment robustness 直接可落地。
- Persona Hub + 真实对话池(LMSYS/WildChat)做 style transfer 是低成本造真实非协作话语的实用配方,比纯 prompt(PBUS)真实度高约 70% 胜率。