MUA-RL: Multi-turn User-interacting Agent Reinforcement Learning for Agentic Tool Use
Meituan
首次把 LLM 模拟用户接进 agent 的 RL rollout 里。GRPO + 真实数据库环境验证 tool call 结果,并配两条 cold-start 数据合成 pipeline(LLM 模拟工具响应 vs. 真实 MCP server)。
核心思路
问题一句话:在 agent 与用户的多轮交互中,用户需求是动态、不确定、随机的——用户会根据 agent 的回复改主意、补信息、提新约束。现有 tool-use 的 RL 方法(Retool / SkyRL / RAGEN 等)训练时只面对预先写死的 query 和静态环境,rollout 里没有真正会变的用户,所以学不到”边对话边纠偏、边调工具”的能力。
关键 idea:MUA-RL 第一次把 LLM 模拟的”用户”直接塞进 RL 的 rollout 循环里。一次 rollout 同时编织四种信号——agent 的文本生成、工具调用、模拟用户的回话、以及真实数据库返回的工具执行结果。reward 只看最终任务是否完成(0/1),不奖励中间格式 / 工具名匹配 / 调用成功率。范式 = 轻量 cold-start(SFT)建立基础工具调用能力 → GRPO 在”用户 + 真实 DB”的动态环境里端到端 self-iteration。
一句话:把”用户模拟器”从评测搬进训练 loop,让 agent 与会变的用户共演化。
整体实现思路
端到端 pipeline 分两阶段:
阶段一 · Cold-start(SFT):用两条数据合成 pipeline 造约 2000 条多轮 tool-using 轨迹(覆盖 9 个场景 = 5 个 LLM 合成场景 + 4 个真实 MCP server 场景),让 base model(Qwen3-8B/14B/32B Non-thinking)先具备”会调陌生工具、会边对话边纠错”的基础能力。
阶段二 · MUA-RL(GRPO):基于 VeRL(HybridFlow)搭多轮用户交互 RL 框架,接入一个真实可运行的数据库环境来验证工具调用结果。每个 query 采 G 个 rollout,rollout 内部是一个完整对话:
- 任务形式化为元组 (T, M, O):T 是工具集空间,M 是消息空间,O = O_db ∪ O_user 是观测空间(数据库观测 + 用户观测)。
- 给定用户首条 query o₁,user,轨迹按 turn 展开:每个 turn 里 agent 自主决定是否调工具、调几个;调工具→真实 DB 返回 o_db,或→发文本消息 m 给模拟用户→模拟用户返回 o_user。
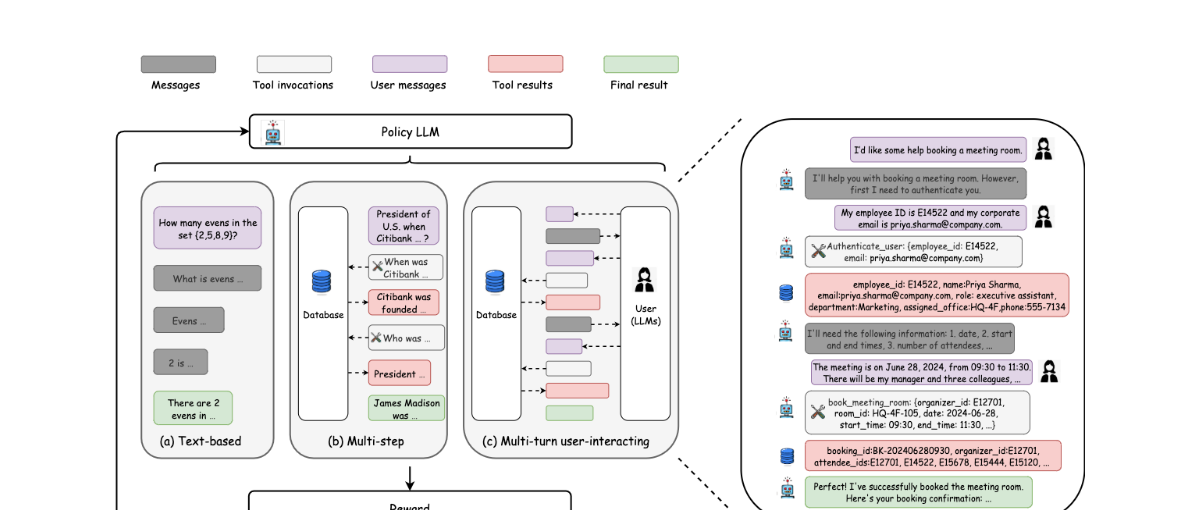
- 三种 rollout 范式对比见下图:(a) 纯文本 rollout(数学题那种,无工具);(b) multi-step rollout(有工具但 query 静态、无真用户,如 Retool/Search-R1);(c) MUA-RL 的 multi-turn user-interacting rollout——文本 + 工具 + 用户消息 + 工具结果四者交织,动态性/随机性/不确定性最高。
子模块实现(可复现细节)
子模块 A · 任务形式化与多轮轨迹
一条多轮轨迹(公式 1):
(o₁,user → t₁ → o₁,db → ... → m₁)        ← turn 1
...
(o_k,user → t_j → o_j,db → ... → t_{j+jk} → o_{j+jk},db → m_k)   ← turn k
t_i ∈ T:第 i 次工具调用;o_i,db:调用 t_i 后数据库返回的观测;o_i,user:用户观测(用户发来的话);m_i ∈ M:agent 发给用户的消息。- 每个 turn 内 agent 可连续调多个工具(t_j … t_{j+jk}),再以一条 m_k 结束本 turn 给用户。
- 这是 RL 要优化的”动作序列”载体。
子模块 B · Cold-start 数据合成(两条 pipeline)
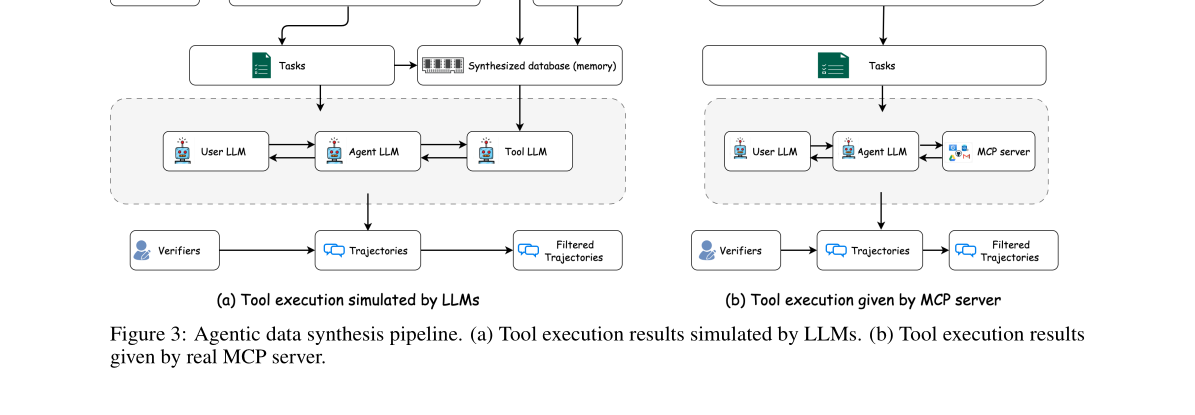
下图为两条 pipeline 的结构(见 fig2):
B1 · 工具响应由 LLM 模拟(5 个合成场景):
- 先选一个 domain,设计最简数据库 schema + 对应工具(受真实业务启发并简化)。
- 工具的描述/参数、domain policy 由 LLM 生成 → 人工校订 + 迭代精修。
- 三个 LLM 协作生成轨迹:一个演 agent、一个演 user、最关键一个演 tool。构造 query 时用 LLM 生成一个符合 schema 的小型合成数据库(充当 memory)喂给 tool LLM;agent 调某工具时把工具名+参数传给 tool LLM,tool LLM 据 memory 产出工具响应。
B2 · 工具响应由真实 MCP server 给(4 个真实场景):流程大幅简化——所有工具由 MCP server 预先暴露、自动执行,无需手设计 schema/工具。只需生成对应 domain 的用户 query,再由 agent LLM ↔ user LLM ↔ MCP server 三方交互产出轨迹。
质量控制:所有 cold-start 数据走 dual-verification = 人工专家标注 + DeepSeek-R1 评估,过滤无效轨迹。最终 ~2000 条,跨 9 场景。
Cold-start 超参:batch size 128,2 epochs,AdamW,初始 lr 5e-6,cosine 衰减。
子模块 C · GRPO 优化器
采用 Group Relative Policy Optimization(无 value/critic,组内相对优势替代)。给定旧策略 π_old、参考策略 π_ref,对每个 query q 从 π_old 采样一组响应 {y₁,…,y_G},最大化:
J_GRPO(θ) = E[ (1/G) Σ_i min( ρ_i·A_i , clip(ρ_i, 1-ε, 1+ε)·A_i ) − β·D_KL(π_θ ‖ π_ref) ]
其中 ρ_i = π_θ(y_i|q) / π_old(y_i|q)
组内优势(公式 3):
A_i = ( r_i − mean({r_j}) ) / std({r_j})
ε:PPO-style 裁剪系数;β:KL 惩罚系数(论文设 β = 0.001)。- 用组内 reward 的均值/标准差做归一化得 advantage,省掉 value function,降训练成本、稳。
子模块 D · Multi-turn user-interacting Rollout(核心)
- rollout 内:模拟用户由 GPT-4o-2024-11-20 扮演(注意是训练期 user simulator);工具结果由真实可运行 DB 环境返回。
- agent rollout temperature = 1.0(鼓励探索)。
- 每个 query rollout 数 = 8;序列长度上限 32768 tokens;单任务交互上限 30 turns(防失控)。
子模块 E · Reward 设计(极简)
r = 1   当且仅当 agent 按 system prompt 成功完成任务
r = 0   其它
刻意不要 format reward / 工具名·参数名匹配 reward / 工具执行成功率 reward。两大好处:
- 对对话路径不变:只要最终结果对,允许任意对话轨迹与工具调用顺序 → 鼓励大胆多样探索。
- 抗 reward hacking:agent 无法靠堆格式/调用语法骗分,只有真正解决任务才得分。
训练数据用 TAU1-Bench 的 115 条 retail + 50 条 airline。论文还特意简化了 TAU1 原 reward:原版若”没在对话里说出某些必需信息”(如告诉用户库存几件)也判 r=0;MUA-RL 去掉了对话内容要求,只要任务完成即 r=1——因为实测发现”对话内容要求”会妨碍模型学正确的工具调用模式。
子模块 F · Loss mask 策略
loss 计算时 mask 掉工具执行结果 token 和用户消息 token——只在 agent 自己生成的 token 上算 loss,避免把”环境/用户产生的内容”当成要拟合的目标。
RL 训练总超参一览
| 项 | 值 |
|---|---|
| backbone | Qwen3-8B / 14B / 32B Non-thinking |
| 算法 | GRPO,β(KL)=0.001 |
| epochs | 25 |
| batch size | 32 |
| rollout 数 / query | 8 |
| 序列长度上限 | 32768 tokens |
| 最大交互 turns | 30 |
| agent rollout 温度 | 1.0 |
| 训练期 user simulator | GPT-4o-2024-11-20 |
| 训练数据 | TAU1-Bench 115 retail + 50 airline |
| 框架 | VeRL (HybridFlow) + 真实 DB 环境 |
实验设置与结果
Benchmarks(4 个多轮 tool-use 集):
- TAU1 / TAU2-Bench:模拟真实用户-agent 多轮交互,需 domain-specific 工具调用 + 遵守 policy。TAU2 比 TAU1 工具集改动、policy/reward 更严,并新增 TAU2 Telecom 双控(dual-control)域——agent 与 user 都能调工具,最难。
- BFCL-V3 Multi Turn:含 Base + Miss Param + Miss Func + Long Context,用 Executable Function Accuracy 评。
- ACEBench Agent:含 Multi-step + Multi-turn 两类。
评测设置:TAU 系列用 GPT-4.1 当 user simulator(与训练期 GPT-4o 不同,验证泛化);每个 test set 跑 4 次取平均;全部 FC(Function Calling)模式;推理 temperature=0.0、non-thinking、确定性保证可复现。TAU2 Telecom 额外引入 TCR(Task Completion Rate)= 满足的验证准则数 / 总准则数,对部分完成给连续度量:
TCR(q) = |{c_i ∈ C_q : satisfied(c_i)}| / |C_q|
主结果 · TAU1 & TAU2(accuracy;Telecom TCR 单列)
| Model | TAU1 Retail | TAU1 Airline | TAU2 Retail | TAU2 Airline | TAU2 Telecom | Telecom TCR |
|---|---|---|---|---|---|---|
| GPT-4o-2024-11-20 | 63.0 | 45.5 | 67.3 | 46.9 | 24.1 | – |
| GPT-4.1 | 66.5 | 42.5 | 70.2 | 53.0 | 38.9 | – |
| DeepSeek-V3-0324 | 70.4 | 42.4 | 64.7 | 37.0 | 32.9 | – |
| Qwen3-235B-A22B (NT) | 65.2 | 32.0 | 64.9 | 36.0 | 24.6 | – |
| Qwen3-8B (NT, base) | 40.0 | 11.0 | 41.0 | 12.5 | 19.1 | 22.9% |
| Qwen3-8B Cold-start | 36.7 | 12.0 | 31.4 | 16.0 | 9.0 | 12.1% |
| MUA-RL-8B | 56.5 | 29.5 | 49.8 | 19.0 | 21.8 | 25.2% |
| Qwen3-14B (NT, base) | 46.9 | 13.0 | 43.1 | 14.8 | 29.9 | 46.6% |
| Qwen3-14B Cold-start | 50.8 | 23.0 | 53.7 | 24.0 | 23.5 | 32.9% |
| MUA-RL-14B | 65.9 | 42.0 | 66.0 | 38.0 | 33.4 | 54.3% |
| Qwen3-32B (NT, base) | 47.6 | 18.5 | 50.2 | 23.5 | 24.8 | 23.7% |
| Qwen3-32B Cold-start | 58.9 | 36.0 | 58.2 | 31.1 | 19.3 | 21.6% |
| MUA-RL-32B | 72.6 | 46.5 | 67.3 | 45.4 | 28.3 | 45.1% |
要点:(1) MUA-RL 在每个 scale 上都明显超 base 与 cold-start。(2) MUA-RL-32B 在 TAU Retail/Airline 上超 Qwen3-235B-A22B、DeepSeek-V3-0324、GPT-4o,体量小一个数量级。(3) Cold-start 在 Telecom 域反而掉点(8B 19.1→9.0、32B 24.8→19.3)——SFT 引入了 domain bias 难泛化到差异大的新域;而 RL 能纠偏 SFT 引入的偏置,MUA-RL-14B Telecom 反超 GPT-4o/DeepSeek-V3。(4) TCR 显示即便没完整完成,MUA-RL 的部分完成能力也更强(14B 32.9%→54.3%)。
主结果 · BFCL-V3 Multi Turn & ACEBench Agent
| Model | BFCL Base | Miss Func | Miss Param | Long Ctx | BFCL Overall | ACE Multi-Turn | ACE Multi-Step | ACE Overall |
|---|---|---|---|---|---|---|---|---|
| GPT-4.1 | 48.0 | 34.0 | 35.0 | 45.5 | 40.5 | 83.3 | 90.0 | 86.7 |
| DeepSeek-V3-0324 | 41.0 | 21.0 | 23.0 | 34.5 | 29.8 | 73.3 | 75.0 | 74.2 |
| Qwen3-235B-A22B (NT) | 42.5 | 23.5 | 28.5 | 25.5 | 30.0 | 63.3 | 80.0 | 71.7 |
| MUA-RL-8B | 21.0 | 11.5 | 15.0 | 11.0 | 14.6 | 46.7 | 60.0 | 53.3 |
| MUA-RL-14B | 40.5 | 14.0 | 25.0 | 21.5 | 25.3 | 56.7 | 100.0 | 78.3 |
| MUA-RL-32B | 42.0 | 20.0 | 30.0 | 21.5 | 28.4 | 70.0 | 95.0 | 82.5 |
MUA-RL-32B 的 BFCL Overall 28.4 逼近 DeepSeek-V3(29.8);ACEBench 82.5 仅次于 GPT-4.1(86.7),证明跨 benchmark 泛化。
消融(MUA-RL-32B,去阶段)
| Model | TAU2 Retail | TAU2 Airline | TAU2 Telecom | BFCL Overall |
|---|---|---|---|---|
| Qwen3-32B (NT) | 50.2 | 23.5 | 24.8 | 19.6 |
| + MUA-RL w/o RL(只 cold-start) | 58.2 | 31.1 | 19.3 | 26.0 |
| + MUA-RL w/o cold-start(直接 RL) | 61.6 | 41.0 | 28.1 | 19.3 |
| MUA-RL-32B(全 pipeline) | 67.3 | 45.4 | 28.3 | 28.4 |
结论:去掉任一阶段都明显掉点。w/o cold-start 在 TAU2 上比 w/o RL 强,但在 BFCL 上更弱;只有 cold-start + RL 全 pipeline 在所有 benchmark 上都最好——两阶段缺一不可。
训练动态分析(Figure 5)
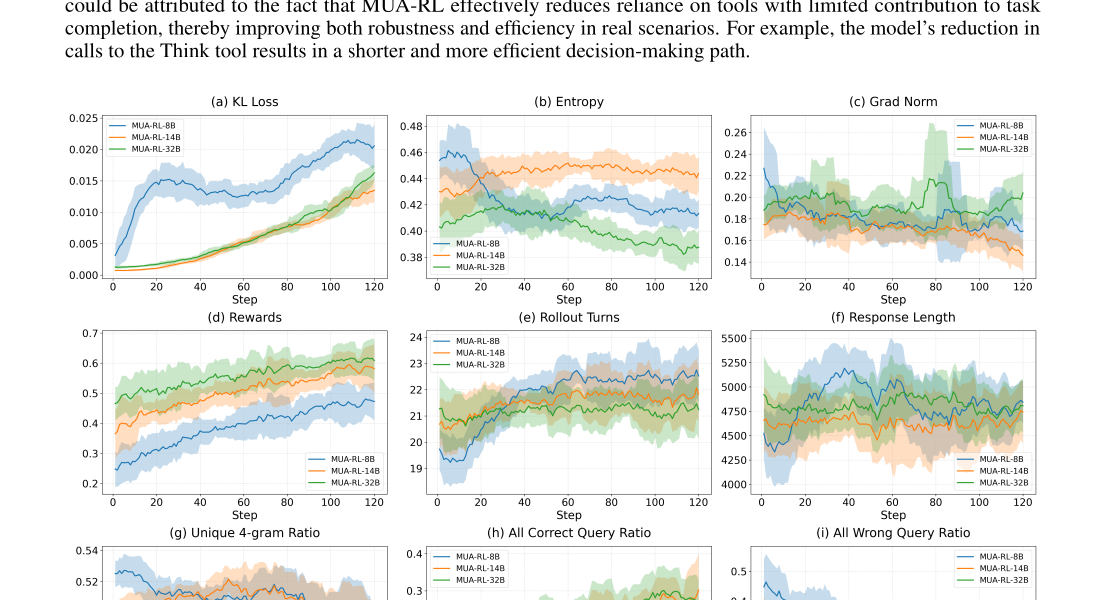
关键观察:(1) rollout turns 稳定在 21-23、response length 几乎不变——性能提升不是靠”输出更长/test-time scaling”,而是靠更结构化的多轮交互(与 GLM-4.5 观察一致)。(2) All Correct↑ / All Wrong↓:从偶尔做对变成稳定做对,并压制彻底失败案例。(3) 通用工具(Calculate / Think / Transfer-to-Human)调用频率全程下降——RL 减少了对低贡献工具的依赖,决策路径更短更高效。(4) 8B 因容量小,KL/entropy 波动大;大模型平滑。
思考与可参考价值
局限:
- 训练期用户由通用 LLM(GPT-4o)直接扮演,用户行为缺乏稳定 persona/goal,存在 goal drift(后续 UGST 等正是补这个);工业级长尾用户行为覆盖有限。
- 评测仍集中在 tool-use 单一任务族;reward 是粗粒度 0/1,无 turn-level credit assignment。
- 训练 simulator(GPT-4o)与评测 simulator(GPT-4.1)不同虽证明了泛化,但也意味着结果对 simulator 选型敏感,复现需注意。
- 绝对分数仍不高(TAU2 Telecom ~28、BFCL ~28),说明动态多轮 tool-use 远未解决。
对电商 / 搜推 / Agent 的可借鉴点:
- 把”用户模拟器”升格为训练信号源:和 reward / environment 并列。电商客服 / 导购 agent 训练时,用一个会改主意、会补需求、会砍价的 user simulator 做 rollout 环境,比静态 query 集更贴近线上多轮转化场景。
- 极简 outcome-only reward + loss mask 是低成本可复制范式:不用费力设计 format/工具匹配 reward,只在 agent 自生成 token 上算 loss、mask 掉环境与用户 token——直接抗 reward hacking,适合工具/接口频繁变的电商后台。
- 真实 DB/MCP 环境闭环验证:工具调用结果由真实库返回而非 LLM 幻觉,对”下单/改地址/查库存”这类有副作用的电商动作至关重要;两条数据合成 pipeline(LLM 模拟 vs 真实 MCP)给冷启动提供可直接套用的模板。
- RL 纠 SFT 偏置的现象值得注意:cold-start 在 OOD 域(Telecom)掉点、RL 反超——提示工业落地里”先 SFT 灌业务知识、再 RL 泛化”比纯 SFT 更稳,尤其面对新品类/新政策。
- 性能靠”更结构化交互”而非更长输出:对成本敏感的线上 agent 友好——可在不增加 token 开销的前提下提升任务完成率。