LLMs as Scalable, General-Purpose Simulators For Evolving Digital Agent Training
UCLA
把 simulator 从对话域推到 GUI / digital world 域:LLM 既模拟用户,也模拟 UI 状态、应用响应、网页变化,配合 guided rollout 与 trajectory wrapper 给 GUI agent 生成多样训练轨迹。
核心思路
一句话问题:训练 digital agent(web / mobile / computer use)需要大规模、多样的 UI 交互轨迹,但真实环境采集极贵——Xie et al.(OSWorld) 报告设计 360+ computer-use 任务就花了 1800+ 人时,且并行部署真实 UI 环境受网络不稳定、资源开销、缺乏原生分布式支持等基础设施瓶颈限制。
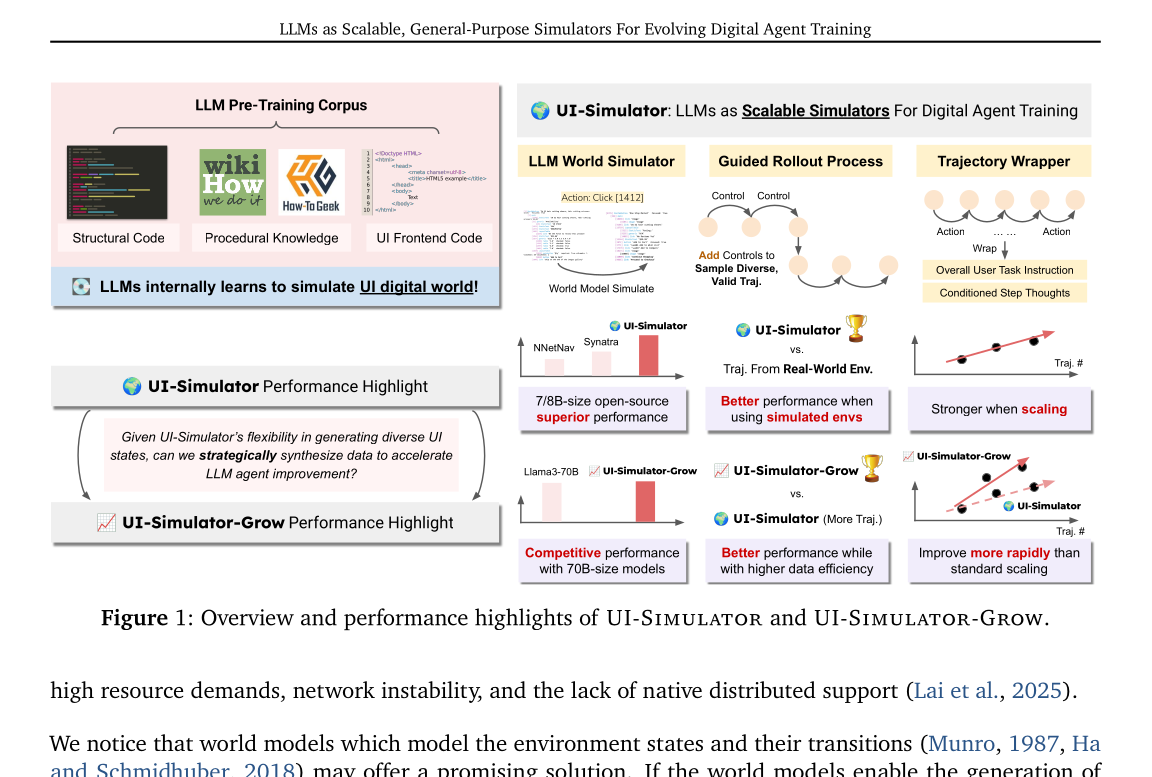
关键 idea:不去搭真实环境,而是把 LLM 当成「数字世界模拟器」(digital world simulator)——LLM 预训练吃过大量前端代码(HTML/a11y tree)和操作性知识,天然能在给定「当前 UI 状态 + 动作」时预测「下一个 UI 状态」。论文提出 UI-Simulator 这套轨迹合成范式:LLM 既模拟 UI 状态与状态转移,又作为 teacher agent 在模拟世界里 rollout,最后由 trajectory wrapper 把无指令的探索轨迹整理成「用户指令 + ground-truth 动作 + 分步推理」的训练样本。再叠加 UI-Simulator-Grow 这个 targeted scaling 策略,用 teacher-forcing loss 选「中等难度」任务做定向合成,使 8B 模型用更少数据追平 70B。
核心论断是 environment diversity 是训出鲁棒 agent 的首要因素(呼应 Cobbe et al. 的 procgen 与 Kimi-K2);而 LLM 模拟器能无约束地造出真实环境造不出来的多样 UI(如未登录页、搜索无结果页、各种用户配置页)。
整体实现思路
端到端 pipeline 分四段,全程无需对 simulator 做任何额外微调,只用 few-shot CoT 提示一个现成 LLM(teacher = GPT-4o-mini,比 baseline 用的 GPT-4o 还弱):
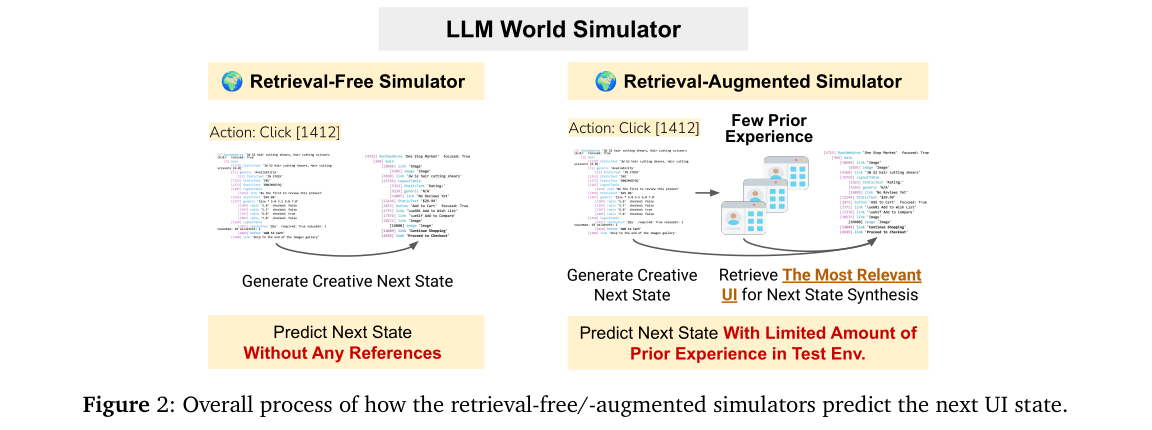
- LLM World Simulator(§3):给定先前 UI 状态摘要 + 下一个动作,分层生成未来 UI 状态(a11y tree,含文本内容、坐标 bbox、动态属性如 focus)。分 retrieval-free(纯靠 LLM 内部知识)和 retrieval-augmented(检索测试环境少量先验经验来 grounding)两种。
- Guided Rollout(§4):teacher agent 在模拟世界里做 instruction-free(无预设目标) 的 step-wise rollout——每步先由 teacher 提一个 task control(子目标),再生成 thought + action + step summary;模拟器据 action 转移到下一状态,直到 teacher 判定一个语义连贯的任务完成。
- Trajectory Wrapper(§4.3):把无指令 rollout 反向整理成可训练样本——task summarizer 反推整条轨迹的 user instruction
G,再让 teacher 把每步 thought 重写得与G对齐,必要处插入 reasoning,最后按规则过滤低质轨迹。 - UI-Simulator-Grow(§5):迭代式 targeted scaling——用 teacher-forcing loss 在动态验证集上挑 25%–75% 分位(不太易也不太难)的任务,做 lightweight 任务改写合成 variant,配合 replay 做 continual learning,比盲目堆量涨得更快。
下图是总体框架与两个性能 highlight:左侧 UI-Simulator 用 7/8B 开源模型在模拟环境上训练即超过 Synatra/NNetNav;右侧 UI-Simulator-Grow 用越多 traj 越能逼近 70B。
子模块实现(可复现细节)
1. 形式化与观测模型(§3.1)
- 记 为 时刻完整 UI 状态, 为 agent 可见观测, 为动作。每个元素 关联一个 bbox:,表示其在页面上的位置。
- 状态转移:, 要么是 LLM 模拟器 ,要么是 rule-based 转移函数(hybrid 设计)。
- 视口 ;观测由「bbox 与视口相交」的元素集合给出:。即 UI 状态本身是完整页面,agent 只看到视口内可见元素。
2. Retrieval-Free 多步模拟(§3.2)
把模型自由生成的 UI 转移拆成三步 CoT(关键设计:单步生成会塌缩成同质内容,多步才能逼出丰富多样状态):
- Step 1 预测概览:conditioned on 当前状态 + 选中动作,生成高层概览。例:购物站输入「sneakers」回车 → 概览「一个关键词 sneakers 的搜索结果页」。4 个 in-context 示例。
- Step 2 自然语言富草稿:基于概览,生成无格式约束的自然语言内容(element 的 tag、内容描述,但不含坐标),刻意 unstructured 以鼓励表达力与丰富度。1 个示例。
- Step 3 转结构化:把 LLM 当 style-transfer 模型,将草稿转成定义良好的结构化格式(a11y tree),并自动给每个元素分配坐标,完成 。1 个示例。
Rule-based 转移(Appendix B):确定性动作不走 LLM:
Type:直接把输入内容 append 进目标元素的content_description。Scroll: 状态不变,只更新滚动偏移 ,窗口尺寸取 ,scroll[down]对应 ;视口 ,据新视口重算 。New_tab / Navigate_back / forward:维护显式 browsing stack 追踪 session 历史,确定性切换 tab 状态。
3. Retrieval-Augmented 模拟(§3.3)
针对「测试环境有少量先验经验」的场景,让模拟生成更贴近目标域:
- 离线检索库 ,含动作前后观测、对应状态、动作历史。
- 用当前 查 ,检回最相关的 ,转移建模为 ——与 retrieval-free 的唯一区别就是把检索状态 喂进 prompt。
- 三阶段 hybrid 检索:① BM25 粗筛(query=动作历史)→ ②
GPT-4o作语义检索器(query=动作历史)进一步缩小 → ③ 用「状态+动作历史」复合 key 再做 BM25 选最终转移。 - 检索库规模很小:WebArena 1647 条转移、AndroidWorld 683 条(仅约 OS-Genesis 测试环境经验的 25% / 10%)。
4. Step-Wise Guided Rollout(§4.2)
无指引的 LLM rollout 会因模型偏置反复采同一两个元素,导致任务同质。解法:
- 首步 task control:,由 teacher 基于初始状态提高层任务(如「搜索某商品」「进我的账户页」)。prompt 要求任务原子、不嵌套、不含 “do A then do B”(Table 9)。
- 后续 control 迭代更新:定义布尔 由 teacher 判定当前 control 是否完成;更新规则 if 。完成「进账户页」后在新页提「查订单历史 / 改地址」等子目标,从而把复杂任务由有意义子目标拼出。
- Thought & Action 生成:,历史更新 (
;为拼接)。teacher 可自主输出STOP终止,避免无限 rollout。
5. Trajectory Wrapper(§4.3)
- 反推指令:task summarizer 把动作序列凝练为做了什么,再转成整条轨迹的 user instruction
G(Table 13)。 - Thought 重写:teacher 把原本 task-control 导向的 thought 重写得与
G对齐,且保证「每个动作出现在其对应 rewritten thought 里」(Table 14)。 - 插入 reasoning:对信息查询/分析类任务(如「告诉我订单历史里最近一笔取消的订单」)插入中间 reasoning(Table 15)。
- 质量过滤:① 动作必须命中有效元素且导致有意义状态变化;② 每步 reasoning 里提到的动作要与实际动作一致。
6. UI-Simulator-Grow targeted scaling(§5)
- 目标任务选择:对验证集每条任务,逐步把 teacher 预测当 ground truth,算它对 student 预测的 cross-entropy(teacher-forcing loss),全步平均后排序,取 25%–75% 分位——太易没学习信号、太难学不动。
- 动态验证集:首轮独立合成一批;后续轮验证集整个来自下一轮新合成数据的一个 split,防过拟合到早期迭代。
- 合成 variant:lightweight 任务改写——只改 content-specific 元素(如「search running shoes」→「search slippers」),保持动作类型与流程不变,UI 状态与动作随之结构性微调(Table 10、20)。
- Continual learning(replay):仿 Dynosaur,用 Sentence-Transformer(RoBERTa-large)把上一轮 条指令编码成 ,算 ,取行和 top 的代表性任务做 replay。
7. 关键超参与数据规模(Appendix C/D)
- 模拟解码温度 0.5;teacher rollout 动作生成温度 0.5;下游推理温度 0.6、max output 1024 tokens。
- 训练:WebArena 用
Llama-3-8B-Instruct,AndroidWorld 用Qwen-2.5-7B-Instruct(因其 context 超 8192,Llama-3-8B 的 8192 不够);batch size 48、lr 、2 epochs、4×A6000(48GB) + Liger-Kernel。 - 数据量:web 2K 轨迹(平均 3.3 步),Android 1.3K 轨迹(平均 5 步)。各域 step 数与每次提的 task control 数(Table 5):Shopping 800/5、Gitlab 1500/8、Map 1500/3、Reddit 1300/6、Shopping Admin 1500/8、Android 6500/5——map 简单 control 少、Gitlab/admin 复杂 control 多。
- 成本:retrieval-free 每条 web 轨迹 ~0.05,Android 翻倍。
下图对比两种模拟器:左 retrieval-free 纯靠 LLM 内部知识生成下一状态;右 retrieval-augmented 先检索测试环境里最相关的 UI 再 grounding 生成。
实验设置与结果
Benchmark:WebArena(812 个真实 web 导航任务,用原始评测设置而非 BrowserGym/lite 版)、AndroidWorld(116 个 mobile 任务)。指标:success rate (SR)。
变体命名:UI-Simulator-F(retrieval-free)、UI-Simulator-R(retrieval-augmented)、UI-Simulator-Grow-R(targeted scaling)。
主结果(Table 1,SR%)
| 模型 | Teacher | 在真实环境训练? | WebArena | AndroidWorld |
|---|---|---|---|---|
| Llama-3-8B-Instruct(base) | - | ✗ | 2.34 | - |
| Qwen-2.5-7B-Instruct(base) | - | ✗ | 3.94 | 0.0 |
| Llama-3-70B-Instruct | - | ✗ | 7.02 | - |
| Qwen-1.5-72B-Instruct | - | ✗ | 7.14 | - |
| Gemini Pro | - | ✗ | 7.12 | - |
| GPT-4o | - | ✗ | 13.10 | 11.7 |
| NNetNav | Llama-3.1-70B | ✓ | 4.80 | - |
| Synatra | GPT-4-turbo | ✓ | 6.28 | - |
| OS-Genesis | GPT-4o | ✓ | 6.16 | 9.1 |
| UI-Simulator-F | GPT-4o-mini | ✗ | 6.28 | 8.6 |
| UI-Simulator-R | GPT-4o-mini | ✓(<<) | 6.40 | 12.9 |
| UI-Simulator-Grow-R | GPT-4o-mini | ✓(<<) | 7.14 | 13.4 |
<< 表示对真实测试环境暴露远少于 baseline。要点:
UI-Simulator-F完全不碰真实环境,AndroidWorld 把 base 从 0% 提到 8.6%,WebArena 上还超过「直接在 WebArena 测试环境合成」的 OS-Genesis。UI-Simulator-R用 8B 模型在 WebArena 上追平 Gemini-Pro、在 AndroidWorld 上追平 GPT-4o;用更弱的GPT-4o-miniteacher 反超用GPT-4oteacher 的 OS-Genesis(WebArena +0.9、AndroidWorld +3.8)、超 NNetNav(WebArena +2.2)。UI-Simulator-Grow-R7B/8B 即追平 Qwen-1.5-72B / 超 Llama-3-70B。
消融(Table 2,WA / AW SR%)
| 设置 | WebArena | AndroidWorld |
|---|---|---|
| UI-Simulator-F | 6.28 | 8.6 |
| ├ Perturbed Env.(打乱布局) | 5.54 | 8.7 |
| └ Synthesize in Real Env. | 4.31 | 4.7 |
| UI-Simulator-R | 6.40 | 12.9 |
| ├ Synthesize in Real Env. | 4.31 | 9.1 |
| ├ w/o Step-Wise Task Control | 1.72 | 5.2 |
| └ w/o Multi-Step Simulation | 4.06 | 9.1 |
| OS-Genesis | 6.16 | 9.1 |
| ├ Perturbed Env. | 4.43 | 8.7 |
| └ Same # of Experience | 1.48 | 5.2 |
结论:
- 鲁棒性:随机打乱布局后,
UI-Simulator-F掉得最少(WebArena 6.28→5.54),OS-Genesis 掉更多(6.16→4.43)——模拟器造的多样布局让 agent 更抗扰动。 - 模拟 > 真实环境:同等轨迹量下,在真实测试环境合成反而更差(WebArena 4.31、AW 4.7/9.1)。原因是真实环境给不出有用转移:信息查询任务里的搜索若无匹配会返回「Search not found」、未登录拿不到账户/设置页、账号少导致设置页同质——这些模拟器都能无约束造出来。
- 去掉 step-wise task control:WebArena 暴跌到 1.72、AW 到 5.2(约 -4.7 / -7.7)。任务多样性的量化(RoBERTa-large 嵌入 + PCA ≥90% 方差有效维度):无 control 118 维 → 加 control 153 维。
- 去掉 multi-step simulation(退化为单步):WebArena 6.40→4.06、AW 12.9→9.1(约 -2.4 / -3.8),单步生成同质化伤多样性。
- 同等测试经验下
UI-Simulator-R约是 OS-Genesis 的 4×(WebArena)/ 2.5×(AndroidWorld)。
Grow vs 标准 scaling(Figure 3)
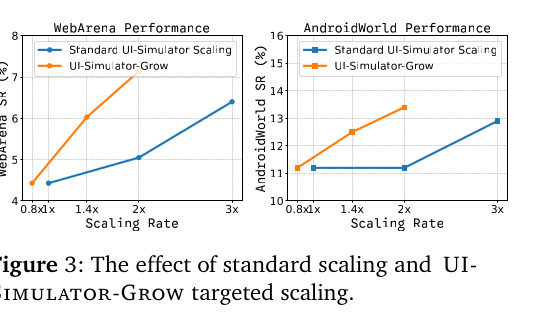
标准 scaling 把 UI-Simulator-R 训练集三等分逐步加;Grow 首轮同初始 split,后续主要加 target task 的合成 variant。结果 Grow 涨势更陡,第 3 轮追平 Qwen-1.5-72B、超 Llama-3-70B,且只用原始 66% 的轨迹。按 5 大任务类别(Search/Info Query、Account、Post/Comment、Repo、Subscribe)看,Grow 在最后迭代能解掉标准 scaling 解不了的 code repository 任务。
人评(Appendix E)
3 名 CS 硕士+标注者,各评 40 条轨迹,8 维度(任务真实性、状态合理性、动作有效性、思路一致性、任务完成、轨迹一致性、无关步数、主题抽象);pairwise 一致性 0.876/0.890/0.976。多数维度满意率 ≥90%。失败模式(Appendix F):-F 会把无关上下文(如当前论坛的 deeplearning 主题)误融进新页;-R 有时过度依赖检索参考状态而忽略当前 query。
思考与可参考价值
局限:
- LLM 模拟 UI 仍有 hallucination:retrieval-free 会串无关上下文、retrieval-augmented 会过拟合检索参考(论文自己列了两个 failure case)——会引入训练噪声。
- 验证仍限于 WebArena + AndroidWorld 两个 benchmark,GUI 跨 app 多样性远超此;与真实 sandbox(Android Emulator)的等价性缺更强对照。
- 当前是纯文本 a11y tree 层面的模拟;作者展望(受 NeuralOS 启发)走向 pixel 级以缩小 sim-to-real gap,但还没做。
- targeted scaling 的 25%–75% 分位是经验阈值,loss 信号依赖 teacher,teacher 弱时选择质量存疑。
对电商/搜索推荐/Agent 方向的可借鉴点:
- 「LLM 即世界模拟器」省掉真实沙箱:电商场景搭真实可交互环境(库存、订单、支付态)成本极高,且很多状态(无结果搜索、未登录账户页、极端用户配置)真实环境根本采不到——这恰是模拟器的增量价值。可借此为电商导购/客服 agent 批量造「真实环境造不出的长尾交互轨迹」。
- 多步生成 > 单步:把「概览 → 富草稿 → 结构化」拆开,是逼 LLM 产出多样内容的有效技巧(消融证明单步会塌缩同质)。做合成数据时值得直接照搬这个分步范式。
- step-wise task control 防同质:无指引 rollout 会因模型偏置反复采同元素;用 teacher 提原子子目标 +
Done判定迭代推进,是控制合成轨迹多样性的实用机制(有效维度 118→153 的量化很有说服力)。推荐系统做 user-simulator 时同样适用——可避免模拟用户行为塌缩。 - instruction-free rollout + 反推指令(wrapper):先自由探索再反推 user instruction + 重写 thought 对齐,比「先定指令再 rollout」更灵活、覆盖任务类型更广。对「冷启动没有标注 query→行为」的电商/搜索场景是可落地的数据构造路径。
- targeted scaling 用 teacher-forcing loss 选中等难度任务:用 25%–75% loss 分位筛「可学但不 trivial」的任务做定向合成 + replay continual learning,使小模型用 66% 数据追平大模型——这套 data-efficient 主动合成思路可直接迁到推荐/Agent 的 RL/SFT 数据迭代循环里。
- 鲁棒性来自环境多样性:模拟器造的多样布局让 agent 抗 UI 扰动。对线上频繁改版的电商/搜索前端,用合成的多样布局训练能提升 agent 泛化,值得作为「抗版本漂移」的数据侧手段。