Goal Alignment in LLM-Based User Simulators for Conversational AI (UGST)
UIUC
提出 User Goal State Tracking (UGST):把用户 goal 显式拆成 Profile/Policy、Task Objective、Requirements/Preferences 三块结构化跟踪,再用 inference-time steering → SFT → GRPO 三阶段把 simulator 训得不 drift。
核心思路
一句话问题:用 LLM 当 user simulator 去陪练/评测对话 agent 时,simulator 在多轮里会”忘记或扭曲自己的用户目标”(goal misalignment),把脏的偏好信号回传给 agent,污染 RL 训练和评测。
关键 idea:把”用户目标”从一段自然语言 prompt,升级成一个可逐轮跟踪的结构化状态机 —— User Goal State Tracking (UGST)。借鉴对话状态跟踪(DST)的思想,把 goal 拆成 5 类 modular sub-component(user profile / user policy / task objective / requirement / preference),每个 sub-component 带一个随轮次更新的状态标签。有了这个结构化状态,就能:① 推理时把”目标进度”喂回 simulator 做 steering;② 用 70B 模型蒸出带 reasoning 的轨迹做 SFT;③ 把每个 sub-component 的对齐与否变成可计算的 reward 项做 GRPO。最终让 8B 小模型的目标对齐能力追平甚至超过 70B 模型。
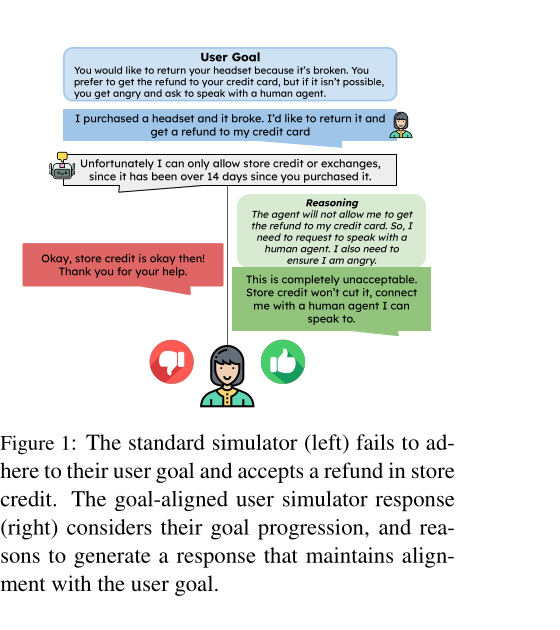
论文用一个退货例子说明 drift 问题:用户目标是”退坏掉的耳机、要求退到信用卡,否则就生气要求转人工”。普通 simulator(左)被 agent 一句”只能退店铺积分”就妥协接受了,违背了目标;UGST simulator(右)先 reason 出”agent 拒绝退信用卡 → 我应该要求转人工并且表现得生气”,再生成对齐目标的回复。
整体实现思路
端到端 pipeline 分两层:UGST 跟踪框架(评测/监督的基础设施)+ 三阶段训练方法(把对齐能力装进 simulator)。
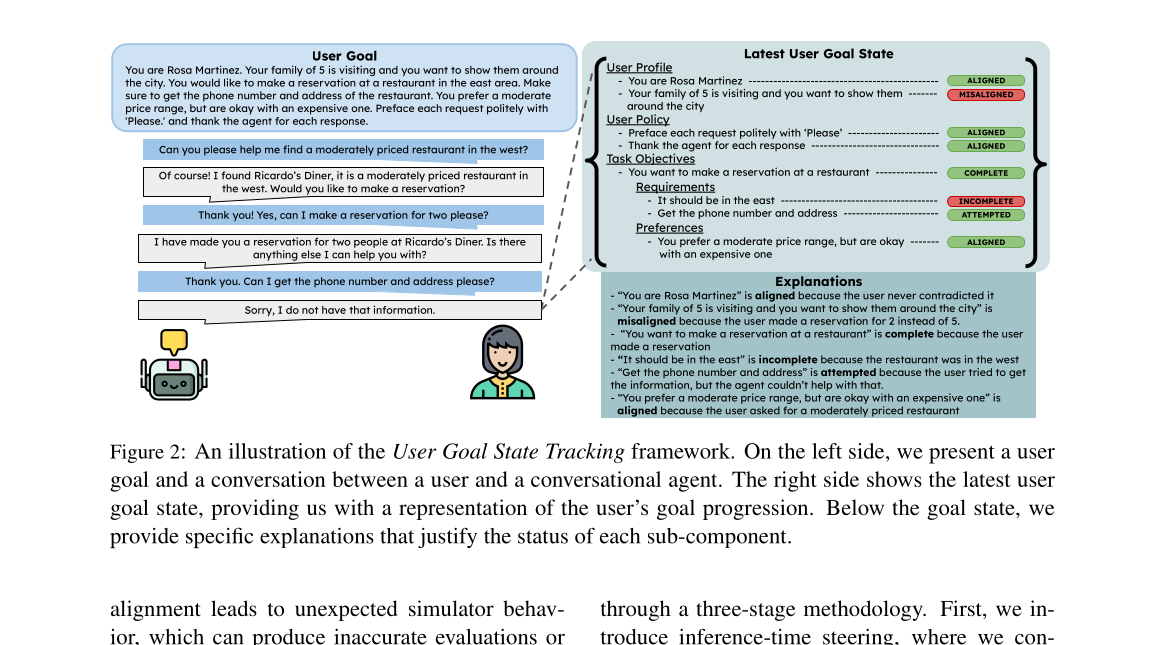
UGST 框架本身(见下图):给定自然语言 user goal,先由 LLM 把它分解 + 分类成 5 类 sub-component,得到初始状态 ;然后在 user-agent 对话每走完一轮 ,用一个 LLM judge 逐 sub-component 独立更新状态,得到 ;对话结束时的终态 即整段对话的目标进度快照,用于打分。
三阶段训练方法(逐级增强、可叠加):
- Stage 1 — Inference-time Steering:在 simulator 生成每一轮回复前,把上一轮的 goal state 一起塞进指令里,显式提醒它”已完成哪些、还剩哪些、要对齐哪些”。无需训练,即插即用,最高 +5.4%。
- Stage 2 — Cold-Start SFT:用 Llama-3.3-70B + inference-time steering 生成带显式 reasoning trace 的对话数据(reasoning 三段式:反思当前 goal state → 分析剩余 objective/requirement/preference 及如何在长度限内完成 → 如何保持 profile/policy 对齐),再 SFT 蒸馏到 7B/8B 小模型,让它不再依赖外部 steering 也能自带目标跟踪。
- Stage 3 — GRPO with UGST Rewards:把 UGST 对 5 类 sub-component 的对齐判定变成 5 项 indicator reward,用 GRPO 进一步打磨小模型的目标对齐策略,最高 +14.1%。
评测时 agent 固定用 GPT-4o-mini(带 domain function call + policy 系统提示),simulator 与 agent 对话至多 10 个 user-agent 回合。
子模块实现(可复现细节)
1. User Goal State:结构与状态语义
把 user goal 拆成 5 类 sub-component,不同类别有不同的状态集合与默认初值:
| 类别 | 含义 | 可取状态 | 初值 | 计为”成功”的状态 |
|---|---|---|---|---|
| User Profile | persona/背景/上下文(“你是 Rosa,一家 5 口要旅游”) | ALIGNED / MISALIGNED | ALIGNED | ALIGNED |
| User Policy | 行为约束(“每次请求前礼貌地说 Please”) | ALIGNED / MISALIGNED | ALIGNED | ALIGNED |
| Task Objective | 必须完成的任务(“订一家餐厅”) | INCOMPLETE / ATTEMPTED / COMPLETE | INCOMPLETE | ATTEMPTED 或 COMPLETE |
| Requirement | 任务的硬性条件(“在 east 区”、“拿电话和地址”) | INCOMPLETE / ATTEMPTED / COMPLETE | INCOMPLETE | ATTEMPTED 或 COMPLETE |
| Preference | 软偏好(“偏好 moderate,但 expensive 也行”) | MISALIGNED / ALIGNED | MISALIGNED | ALIGNED |
状态转移规则(不可逆/单向语义是关键):
- Profile / Policy:从 ALIGNED 出发,一旦出现任何违背就不可逆地切到 MISALIGNED。
- Preference:从 MISALIGNED 出发,用户一旦表达出该偏好就切 ALIGNED。
- Task Objective / Requirement:INCOMPLETE → ATTEMPTED → COMPLETE 递进。ATTEMPTED 是本文相对已有框架新增的状态:用户已充分尝试,但因 agent 侧失败/系统约束等”非用户可控”因素而无法推进时记 ATTEMPTED,从而不冤枉用户,给出更公平的能力刻画。
2. 状态生成与跟踪的 LLM prompt
- 分解 + 分类(Appendix C,生成 ):prompt 要求 LLM 把 user goal 切成 sub-component,尽量保留原文措辞、不遗漏任何部分、允许空类,输出严格 JSON(
user_profile / user_policy / task_objectives[{task_objective, requirements[], preferences[]}])。论文比较了 DeepSeek-V3 / Llama-3.3-70B / GPT-4o-mini / GPT-4o,最终选 GPT-4o 做全部 goal state 生成。 - 逐轮状态更新(Appendix D,):每个 sub-component 单独一次 LLM 调用,judge 输入 = {sub-component 描述, 对话历史
history[:-2], 最新一轮history[-2:-1], 该类别的评判准则},输出{status, reasoning}JSON。Profile 的判定准则明确”除非明显矛盾或明显错过该展示的时机,否则倾向 ALIGNED”——降低误判。评测阶段用 Qwen-2.5-72B-Instruct 当 judge。
3. Stage 1 形式化
常规 simulator:,只看对话历史 ,目标全靠 system prompt 里那段静态文字 + 模型自己从历史里推进度。
Inference-time steering:在历史之外再喂上一轮 goal state:
其中 是 轮后的完整 user goal state(含每个 sub-component 的当前状态)。论文额外做了一个消融对照:只喂”原始 user goal 文本”(提醒目标但无进度跟踪)vs 喂”完整 goal state”(含进度),证明带进度的 state 普遍更强(见后文 Table 7 行)。
4. Stage 2 — Cold-Start SFT
- 数据生成器:Llama-3.3-70B-Instruct(Stage 1 里最强)+ inference-time steering,对每轮回复生成”reasoning trace + response”。reasoning 三段式如上。
- 训练目标:标准 SFT 自回归 NLL
这里 = “reasoning trace + 回复”拼接, = 对话历史。
- 训练后推理:回到 的常规形式——不再需要外部 goal state,目标跟踪已内化成 reasoning 模式。
- 超参:batch size 32,lr ,4 epochs。
- 训练数据:1000 条对话 = 500 条 τ-Bench Retail 训练 goal + 500 条用 MultiWOZ pipeline 生成的 goal。被训模型:Qwen-2.5-7B-Instruct、Llama-3.1-8B-Instruct。
5. Stage 3 — GRPO with UGST Rewards
每轮回复 后,UGST 在 5 个维度判对齐:(1) profile 对齐 (2) policy 对齐 (3) task objective 尝试/完成 (4) requirement 尝试/完成 (5) preference 对齐。定义 indicator (满足条件 为 1),复合 reward:
- 权重全部相等 。reward 不含 naturalness/coherence(作者在 Limitation 里坦承这是简化)。
- 超参:lr ,batch size 16,8 rollouts,350 training steps。
- GRPO 训练样本:约 5000 条,由 cold-start SFT 数据里每段对话截取 ≤2048 token 的子段构造。
6. MultiWOZ Challenge 数据集构造(Appendix B)
原版 MultiWOZ goal 太偏 objective/requirement,Llama-3.1-8B 已能 >95% 成功,区分度不够。于是自建 150 条更难的 goal:
- Step 1 任务目标生成:遍历 attraction/hotel/restaurant/train 域实体,随机抽 requirement/preference 键(用其 value 当条件,如 area=east、pricerange=moderate)+ 随机抽 request 键(用户想问的信息,如 address、phone),喂 GPT-4o-mini 生成自然语言目标。额外造两种难例:Impossible(给 requirement 键随机赋值 → 数据库里不存在的实体)、Conditional(找到 A 后若满足某条件则改去找 B)。
- Step 2 profile/policy 生成:GPT-4o-mini 自动生成约 50 个 profile + 50 个 policy,再人工标注校验质量。
- Step 3 goal 组装:随机组合 1 个 profile + 1 个 policy + 多个 task objective,再次人工校验。
实验设置与结果
评测协议:simulator 与 GPT-4o-mini agent 对话至多 10 个 user-agent 回合 → GPT-4o 生成初始 goal state → Qwen-2.5-72B judge 逐轮跟踪 → 取终态 算各类别成功率,再取 5 类平均。
数据集:τ-Bench Airline(50 goal,训练期完全未见,测 out-of-domain)、τ-Bench Retail(115 goal)、MultiWOZ Challenge(150 goal,自建)。
Baseline:Qwen-2.5-7B/72B、Llama-3.1-8B、Llama-3.3-70B、Gemma-3-27B 的 prompt-based 形态。
指标:Prof./Pol./T.O./Req./Pref. 各类别成功率(%)+ Avg。Prof./Pol./Pref. 以 ALIGNED 为成功;T.O./Req. 以 ATTEMPTED 或 COMPLETE 为成功。
主结果(Avg 成功率,%)
τ-Bench Airline(OOD):
| 方法 / 模型 | Qwen-7B | Llama-8B | Llama-3.3-70B |
|---|---|---|---|
| Prompt-Based | 82.7 | 81.8 | 90.6 |
| Inference-Time Steering | 84.1 | 87.2 | 90.6 |
| Cold-Start SFT | 89.7 | 87.4 | — |
| GRPO + UGST | 91.5 | 91.2 | — |
MultiWOZ Challenge(自建难集,drift 最明显):
| 方法 / 模型 | Qwen-7B | Llama-8B | Llama-3.3-70B |
|---|---|---|---|
| Prompt-Based | 61.3 | 72.9 | 83.3 |
| Inference-Time Steering | 63.7 | 71.6 | 84.7 |
| Cold-Start SFT | 72.3 | 73.7 | — |
| GRPO + UGST | 75.4 | 80.0 | — |
关键读数:
- baseline LLM 普遍有 10–40% 的目标对齐失败率;最弱环节始终是 User Policy(Qwen-7B 在 MultiWOZ 上仅 18.0%)。
- 三阶段单调递增:steering 最高 +5.4%,SFT 绝对 +11.0%,GRPO 最高 +14.1%。
- 小模型反超大模型:GRPO 后的 Llama-8B 在 Airline 达 91.2,超过 prompt-based Llama-3.3-70B(90.6);在 MultiWOZ 达 80.0,逼近 83.3。
- 更大不一定更好:Gemma-3-27B 的 profile 分数常高于 Llama-3.3-70B,说明必须按 sub-component 拆开看,不能只看 Avg。
Drift 失败模式频次(52 段对话人工分析)
| 失败模式 | 频次 | 例子 |
|---|---|---|
| Confusion(混淆/遗忘目标) | 33% | 让”退 A 换 B”被执行成”两件都退” |
| Contradiction(违背约束/上下文) | 23% | 声明没有信用卡信息却幻觉出一个 |
| Wrongful termination(过早终止/不停) | 21% | 没收到 agent 回复就 TERMINATE,或一直不结束 |
| Poor Length Management(长度管理差) | 12% | 多次订票任务没订完就用光轮数 |
| Misprioritization(优先级失衡) | 11% | 死磕一个做不成的子目标,或完成一个就提前收工 |
辅助分析(Table 4/5/6)
- UGST judge 可靠性(Table 4,30 段对话 / 300 个 goal state,10 名研究生标注):人机一致率 Avg 85.7%(Prof. 91.7 / Pol. 72.7 / T.O. 91.1 / Req. 81.3 / Pref. 88.7)。
- goal state 生成质量(Table 5,GPT-4o):P 98.04 / R 95.60 / F1 96.63 / 分类 Acc 91.97。
- 副作用检查(Table 6):BERTScore(utterance↔goal 语义相似度)逐阶段升至最高;naturalness/coherence(Qwen-72B 1–5 打分)几乎不掉;多样性 MTLD/HDD 反而显著上升(HDD 从 ~0.4–0.5 升到 0.79–0.81)——对齐改进没有牺牲自然度,还更多样。
关键消融(Table 7)
只喂”原始 user goal 文本” vs 喂”完整 goal state”:两者都比纯 prompt 好,但带进度的完整 goal state 普遍更强(如 Airline 上 Qwen-7B:goal 82.4 vs goal-state 84.1)。证明 UGST 的价值不在”再提醒一遍目标”,而在”显式表征进度”。
思考与可参考价值
局限:
- UGST judge 依赖 Qwen-2.5-72B,逐 sub-component 逐轮各一次 LLM 调用,算力贵、难规模化;作者建议蒸一个小专用 UGST 模型。
- 整套评测/监督高度依赖 LLM(GPT-4o 建 state、Qwen-72B 跟踪),仍有幻觉/偏置风险(虽有 85.7% 人机一致背书)。
- GRPO reward 5 项等权、不含 naturalness/coherence,是手工简化;最优 reward 形态待探索。
- goal 的 sub-component 切分粒度仍靠人工模板 + 人工校验,跨域迁移要重切。
- 评测集中在对话域,未覆盖纯工具/GUI agent。
对电商 / 搜索推荐 / Agent 的可借鉴点:
- “先训好 simulator,再用 simulator 训 agent” 是干净的两阶段范式。做电商客服/导购 agent 的 RL 陪练时,若 user simulator 自己会 drift(把”退 A 换 B”模拟成”全退”),回传 reward 就是脏的——UGST 给出了一套可量化、可监督、可当 reward 的目标对齐基础设施,可直接嵌进任意 RL/评测流水线做”陪练质检”。
- 把模糊的 persona/preference 显式状态机化:电商场景的”用户偏好(预算/品牌/时效)“恰好天然映射到 UGST 的 preference/requirement,配合不可逆状态转移 + ATTEMPTED 状态(区分”用户没尽力”与”系统没满足”),能更公平地刻画 agent 真实能力,避免把环境失败算到用户头上污染 reward。
- ATTEMPTED 这一中间状态对推荐/搜索评测有借鉴:很多”未成交”是供给侧缺货/无结果导致,而非用户意图没表达;引入”尝试但受外部阻断”的标签能让离线评测更贴近真实归因。
- 8B 追平 70B:在 simulator/judge 这类高频调用组件上,用结构化监督 + GRPO 把小模型打磨到大模型水平,能大幅降推理成本,对要跑海量陪练对话的电商/Agent 训练流水线很实用。
- 对齐改进不伤多样性(HDD 反升)这一发现,缓解了”约束越强、用户越死板”的常见担忧,对需要覆盖长尾用户行为的推荐/搜索 simulator 是正向信号。