Do Generative Recommenders Deepen the Information Cocoon? A Closed-Loop Simulation with LLM-powered User Simulators
Shandong University × Renmin University of China
用 LLM 当用户搭闭环仿真台 RecLoop(双记忆 + 周期反思 agent,推荐器每轮重训,跑 15 轮),系统量化生成式推荐 vs 传统 ID 序列推荐的信息茧房。结论:生成式更抗曝光层茧房(用户间 Jaccard 0.064 vs SASRec 0.223),但茧房转移进了 code 空间、集中在粗层(首 token 熵降 49.6%);并首创 Code-Space 结构性茧房指标。
核心思路
信息茧房是反馈回路(曝光→点击→重训)反复累积的长期现象,静态离线评测把用户偏好和曝光分布当固定的、根本测不出。传统 ID 序列推荐的茧房已研究透;但生成式推荐把「打分选 item」换成「自回归生成多层离散 code 序列」,它对茧房的影响是个先验无法判断的经验问题。
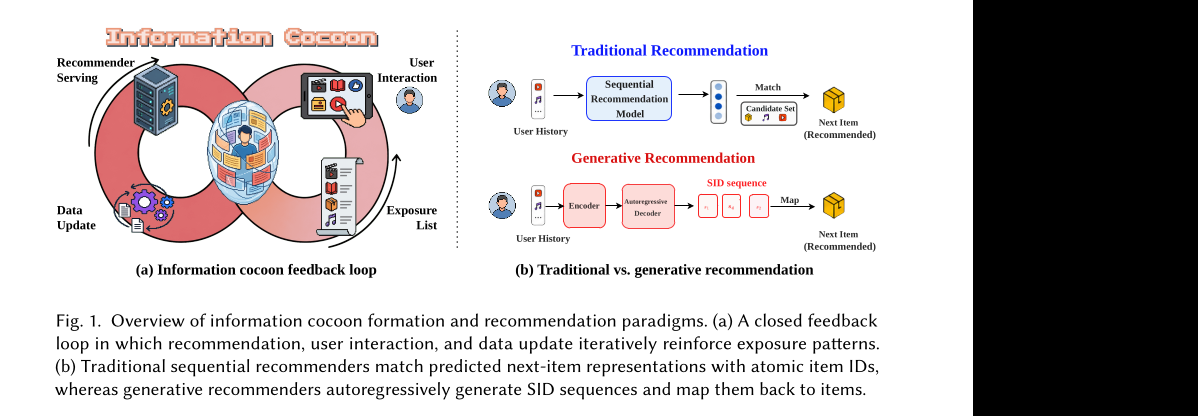
关键 idea:搭一个用 LLM 当用户的闭环仿真台 RecLoop,让推荐器反复「推荐→反馈→重训」15 轮,量化生成式 vs 传统 ID 推荐的茧房;并首创 Code-Space 结构性茧房指标,把茧房从「用户看到什么」重新定义为「生成式模型内部 code 空间塌缩到哪」——这是传统系统不存在的视角。结论:生成式更抗曝光层茧房,但茧房转移进了 code 空间、且集中在粗层。
整体实现思路
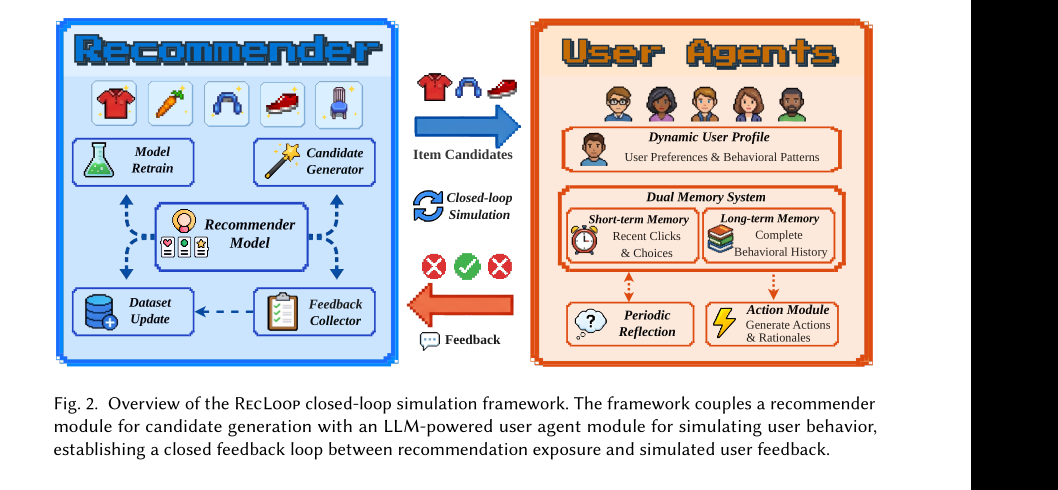
闭环每一轮 t:
S_u^t (累积历史) ──[推荐器 f_θ^t]──> 曝光列表 E_u^t (top-K=5)
                                          │
                         [LLM user agent 按 P^t/M^t 选 1 个 i_u^t (或 null)]
                                          │
            S_u^{t+1} = S_u^t ⊕ i_u^t  (选中项并入历史 + 训练集)
                                          │
  所有用户过完 → 新交互并入训练集 → [重训 f_θ^{t+1}] → 进入 t+1,共 T=15 轮
初始化用真实历史(最早 ≤50 条)warm start。每轮推荐都条件于此前所有仿真决策,茧房才能逐轮累积显现。
子模块实现(可复现细节)
1. LLM 用户模拟器(四部件,全程 prompt 驱动,零训练)
底座 Qwen3-8B,temperature=0(确定性反馈、可复现),vLLM 本地部署,不做任何 SFT/RL:
- 动态画像:
base profile(离线用 Prompt A 从真实购买/评论史合成第一人称心理画像,200-300 词,data-driven 禁臆测) +stage-wise profile P^t(初始化 = base,每 Δ=5 轮经反思更新,两次反思间固定)。 - 双记忆:短期
M^t=最近 W=5 轮滑窗(选择+理由),喂决策;长期=完整轨迹S^t,喂反思。 - 周期反思(每 Δ=5 轮):用 Prompt D 读完整轨迹 → 产出 JSON 行为摘要(preference_patterns / key_decision_factors / behavioral_trends / insights / summary) → 更新 P^t,保留 base 作锚。省算力 + 抗离群交互。
- Action:单次 LLM 调用,四层 prompt——context(P^t 作 system role) / memory(M^t) / perception(候选结构化描述) / constraint(枚举合法 item ID 防幻觉);输出
{reason, selected_item_id 或 null}。
2. 被测推荐器(2 范式 × 2 模型)
- 传统 ID 序列:SASRec、Mamba4Rec(连续 embedding + 内积打分)。
- 生成式:TIGER(RQ-VAE 切 Semantic ID + Transformer 自回归)、OneRec(LLM-based,用 MiniOneRec 代码库,只 SFT 不 RL——为把茧房差异干净归因到架构而非训练法;含 0.5B/1.5B/3B 三档)。
- 每轮用更新后的序列重训(沿用各自原超参)。
3. 双层茧房指标
曝光层(模型无关,每轮算):
- 品类熵
E_{t,l} = −(1/|U|)∑_u ∑_c p_{t,u}(c) log p_{t,u}(c)(熵降=单用户曝光变窄) - 用户间 Jaccard
J̄_t = avg_{u<v} |E_u∩E_v|/|E_u∪E_v|(越大=同质化) - 覆盖 Cov / CatCov(系统触达的 item / 品类占比)
- Gini 系数(曝光是否集中到少数头部 item)
Code 层(生成式特有,首创):
- 逐层 code 熵
H_{t,n} = −(1/|U|)∑_u ∑_{c∈V_n} p_{t,u,n}(c) log p_{t,u,n}(c),归一化Ĥ=H/log|V_n| - top-κ 集中度(少数 code 是否垄断该层生成分布)
- 相对熵降
δ_n = (H_{1,n}−H_{T,n})/H_{1,n}——茧房在各 code 层的分布指纹
实验设置与结果
数据:两 Amazon 数据集——Office Products(4,905 用户 / 2,420 item / 5K agent)、Toys & Games(19,412 用户 / 11,924 item / 20K agent),含 4 级品类树。协议:T=15 轮,top-K=5,每轮重训,W=5、Δ=5;用户 agent=Qwen3-8B temp=0;硬件 A800 80GB。
RQ1 曝光层:生成式更抗 ——Office 末轮用户间 Jaccard:
| 模型 | 范式 | Office 末轮 Jaccard ↓ |
|---|---|---|
| SASRec | 传统 ID | 0.223 |
| Mamba4Rec | 传统 ID | 0.138 |
| TIGER | 生成式 | 0.108 |
| OneRec | 生成式 | 0.064 |
但 Gini 对所有模型都涨(Office 0.966~0.993)——头部 item 集中是范式无关的,生成式也救不了。
RQ2 code 空间:结构性茧房集中在粗层 ——TIGER 在 Office:δ Layer0=53.6% / Layer1=40.4% / Layer2=13.4%;首 token 归一化熵 0.895→0.451(-49.6%),top-10 粗 code 累计概率 27%→86.6%。粗层(早 token=路由决策)塌得最狠,细层保留局部多样性。
RQ3 tokenization:CID(协作信号)比 SID(语义)更易塌缩、削弱细层缓冲(TIGER 明显),但 Toys 上出现反转 → dataset-dependent。
RQ4 model scale:OneRec-3B 末轮各层熵 6.672/7.218/7.119 远高于 0.5B 的 5.303/5.238/4.873;最细层活跃 code 数 3B=233 vs 0.5B=70 → 大模型保留更广 code 空间、更抗结构茧房。
思考与可参考价值
局限:① 用户是 LLM 不是真人,且作者自承未对真实交互分布做校准,茧房绝对值不可解读为真实严重程度;② 每配置只跑一条轨迹、无多 seed / 置信区间;③ 仅 2 个 Amazon 数据集、每范式 2 模型、scale 仅到 3B、无 diversity-aware baseline;④ 纯诊断、未给缓解方法。
对电商 / 搜推的可借鉴点:
- OneRec 是字节自家生成式推荐,本文证明它抗同质化但有 code 空间结构茧房、且 3B 明显比 0.5B 更抗——「逐层 code 熵 + 首 token top-κ 集中度」可直接搬来当线上多样性监控指标,比品类熵更早预警塌缩。
- tokenizer 选型多了茧房维度:CID 涨精度但把热度偏置带进 code 空间、削弱细层缓冲——做 Semantic ID 时别只用 next-item 精度调 tokenizer,要并行看 code 熵。
- RecLoop 的「确定性反馈 + 约束层防幻觉 + 周期反思」三件套可直接补强 push / 推荐 simulator 的长期演化能力(与 OneRetrieval 的「可编辑 SID」、UserGPT 的「simulator-as-trainer」可串成一条线读)。