Consistently Simulating Human Personas with Multi-Turn Reinforcement Learning (Persona-Sim-RL)
UC Berkeley × UW
Off-the-shelf LLM 当 persona 用户会 drift。定义 prompt-to-line / line-to-line / Q&A 三类 consistency 指标作为 RL reward,对 patient / student / social chat partner 三个 role 做 multi-turn RL fine-tune,inconsistency 降低 55%+。
核心思路
问题:把 LLM 当「人类用户模拟器」(User Simulator,记 )去训练 / 评估下游 agent(治疗师、老师、客服)时,off-the-shelf instruction-tuned 模型会 persona drift——一个抑郁患者聊几轮就被「治愈」变得阳光,一个高中生突然飙出博士级词汇,前后陈述自相矛盾。这种 drift 让 simulator 失真,把噪声注入下游 policy learning。
关键 idea:这篇把「persona consistency」从一个模糊概念操作化为三个可自动计算、可微调监督的标量指标,然后做一个视角反转——传统 RL 里 是固定环境、Task Agent 是被训练的 policy;本文固定 Task Agent,反过来把 当成可训练 agent,用三类一致性指标当 reward 做 multi-turn PPO(每个 action 是一整句 utterance,state 是完整对话历史),让 simulator 在长对话中守住人设。三指标全部由 LLM-as-a-Judge 计算,无需人工标注 reward,可规模化。在 chit-chat / education / mental-health 三个域上 inconsistency 降低 55%+。
整体实现思路
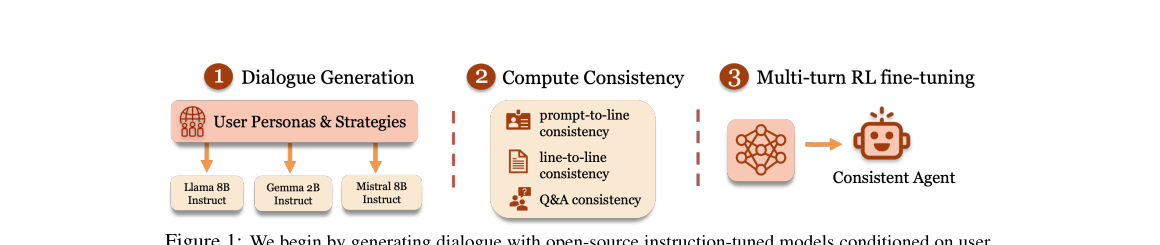
端到端 pipeline 分三阶段(对应下图三个编号块):
- 背景条件对话生成:两个 LLM agent 对话——(患者 / 学生 / 闲聊伙伴)与 Task Agent(治疗师 / 老师 / 对话伙伴)。两者都拿到 task-specific 角色 prompt, 额外拿到一段 background persona(人设、特征、策略、行为)。逐轮生成,并在每步插入「保持角色」提醒、限制长度、忘记角色就重生成。
- 一致性评估(LLM-as-a-Judge):用一个独立的大模型(Meta-Llama-3.1-70B-Instruct)当 Judge,对 的每一句 utterance 打三个标量分:prompt-to-line / line-to-line / Q&A。三指标先各自与人工标注做了 validation。
- multi-turn RL fine-tune:把上述指标当 turn-level reward,用 PPO 微调 (Llama-3-8B-Instruct)。基于 OpenRLHF 扩展支持 turn-level reward 与 multi-turn rollout;rollout 阶段生成完整对话并打分,与 policy update 交替。
子模块实现(可复现细节)
1. LLM-as-a-Judge 一致性打分器
定义 oracle 一致性函数 : 是参考(persona prompt 或先前 utterance), 是待评 utterance,1=一致、0=不一致。用 LLM 近似它,记 。Judge = Meta-Llama-3.1-70B-Instruct。每个指标用专门 prompt(变量占位:%SCENARIO_DESC%/%SPEAKER_ROLE%/%SPEAKER_BACKSTORY%/%SPEAKER_LINE%),要求 Judge 先输出 1 句理由再给 YES/NO。
2. 三类一致性指标(核心)
给定 base prompt 与模型回复序列 ( = 对话轮数):
(a) Prompt-to-Line Consistency——每句是否符合 persona/strategy/task 定义。单句孤立喂给 Judge(不带对话上下文)与人设比对:
(b) Line-to-Line Consistency——每句是否与本人之前所有句矛盾(局部逻辑/语义连贯)。 为历史;取与历史中最不一致那句的分(min):
实现上 Judge 拿到对话历史,返回与当前句冲突的行索引列表(Python list 格式),并过滤掉对方 agent 的行(只比同一 agent 自己的句子)。此 prompt 不提供 persona 背景,比朴素「两两全配对」更省算力且可解释。
(c) Q&A Consistency——persona 信念/策略是否长期稳定。Judge 先据 persona 生成 道第二人称 5 选项选择题 及参考答案 ;让 speaker agent 在对话进行中(带当前历史)回答每题得 ;再让 Judge 判分(因答案常有格式问题,单独做 answer-grading):
直觉:一个写明「社交焦虑、回避人群」的患者,若中途表达「热爱大型聚会」,对应诊断题的答案就会偏离人设——即使没有任何单句显式矛盾,也能被 Q&A 指标抓出。
三指标分别对应全局人设对齐 / 局部前后矛盾 / 长期信念稳定三种不同 drift。论文发现三者并不强相关(见实验),所以需互补使用。
3. 数据构造(三角色 persona)
每域生成 200 对话 × {10,20,40,60} 轮 × 3 个生成模型 = 1200 对话/域,全部三域汇总约 39K 行对话。
- Open-ended(闲聊):从 [Li et al. 2025] 取 100 个合成 persona(一段生活史 + 性格特质),仿 PersonaChat 设定让两 agent 互相了解、找共同点。
- Education(学生):teacher-student setup,学生按 learning style 人设说话。扩展到 27 种 learning style × 4 个学段(小学 5 / 初中 8 / 高中 8 / 大学 6,源自教育心理学文献),gpt-4o-mini 把 style 标签扩写成第一人称描述。教学主题沿用先前工作。
- Mental Health(患者):用 gpt-4o-mini 据 DSM-5/NICE/NIMH 等临床来源合成 100 个患者 condition,每个 persona 编织核心症状、认知扭曲、人口学信息、应对行为;按 Core Concern / Emotional Theme / Relationship Pattern / Coping / Identity / Therapeutic Goal / Stance / Session Tone 等维度随机采样。Therapist prompt 被刻意设计成「追问、温和戳破、对前后矛盾做好奇式非评判性反问」以暴露 drift。
4. Multi-Turn RL 微调
- 基座:Meta-Llama-3-8B-Instruct(被训 )。
- MDP 设定:每个 action = 一整句 utterance,state = 截至当前的完整对话历史(双方),使微调对长程连贯敏感。每轮 取一个一致性指标算 turn-level reward 。
- 训练流程:先做 SFT(预测「给定 scenario+background+历史 → 下一句」),再用 PPO 或 KTO 接着微调;reward 用 LLM-as-a-Judge 算,无需人工标注。
- KTO 标签:把该句平均一致性分四舍五入到 0/1(undesired/desired)。
- 微调用哪个指标:实验只用 prompt-to-line 当 reward(它最贴合人类直觉且算力最省),但框架支持任意指标。
- 框架:OpenRLHF,扩展支持 turn-level reward + multi-turn rollout,policy update 与 rollout 交替。
- 算力:8×H100 + 8×H200 集群。生成 1 域 1200 对话约 2-3 天(2 卡);SFT ~30min;KTO ~5h;PPO ~10h(需 2×H200 跑 Llama-3.1-70B vLLM reward server + ≥1×H200 跑 actor/critic/vLLM 8B;或 2×H100 reward + 3×H100 其余)。
实验设置与结果
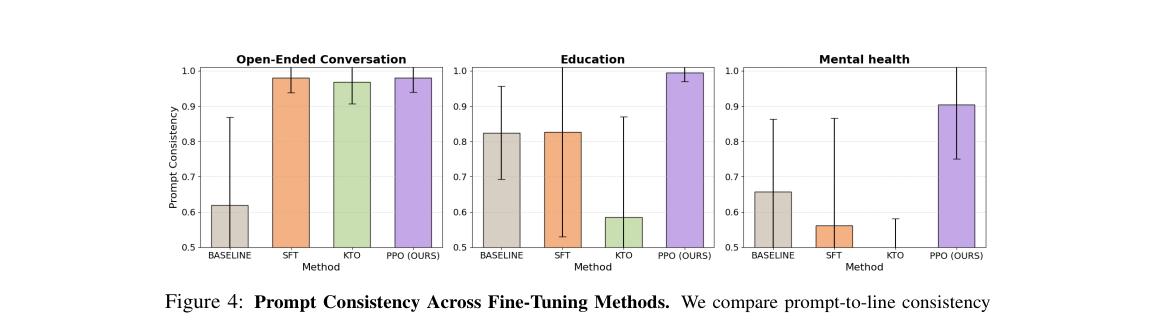
生成模型:Llama-3.1-8B-Instruct、Gemma-2-2B-IT、Mistral-7B-Instruct-v0.3。微调对象:Llama-3-8B-Instruct。baseline:Baseline(原模型)/ SFT / KTO(offline RL)/ PPO(本文,online RL)。Judge / 评测指标:上述三类一致性(0-1)。评测时报告 prompt-to-line 一致性。
Q1:自动指标 vs 人工标注(30 名 CloudResearch 标注者,75 题,Likert 1-6 → 二值 ≥4 算一致)
LLM Judge 与人的一致性反而高于人-人一致性(用 Fleiss’ kappa 与 % agreement 衡量),支撑「prompt-to-line 最可靠、选它当 RL reward」:
| 一致性类型(汇总 / 关键) | Model–Human % Agreement | Model–Human Fleiss’ κ | Human–Human % | Human–Human κ |
|---|---|---|---|---|
| 全部类型平均 | 80.03% | 0.552 | 72.91% | 0.303 |
| Education / Prompt | 90.00% | 0.697 | — | — |
| Mental Health / Prompt | 88.18% | 0.453 | 74.93% | 0.259 |
| Chit-Chat / Q&A(最低) | 49.60% | 0.504 | — | — |
结论:Education 域相关最高(emotional nuance 少更客观),Mental Health 主观性强 κ 偏低但 % agreement 仍高。Q&A 与人对齐最弱(信念级判断更难)。
Q2:当前 LLM simulator 的一致性现状(≈800 对话/域,39K 行)
| Task | 模型 | Prompt-to-Line | Line-to-Line | Q&A |
|---|---|---|---|---|
| Education(学生) | Llama-8B | 0.824 | 0.800 | 0.867 |
| Gemma-2-2B | 0.511 | 0.928 | 0.870 | |
| Mistral-7B | 0.728 | 0.975 | 0.892 | |
| Mental Health(患者) | Llama-8B | 0.657 | 0.681 | 0.779 |
| Gemma-2-2B | 0.665 | 0.984 | 0.854 | |
| Mistral-7B | 0.863 | 0.964 | 0.810 | |
| Open-ended(闲聊) | Llama-8B | 0.619 | 0.992 | 0.752 |
| Gemma-2-2B | 0.871 | 0.900 | 0.780 | |
| Mistral-7B | 0.955 | 0.984 | 0.793 |
关键观察:① Line-to-line 普遍很高(局部连贯好),但 prompt-to-line 与 Q&A 暴露全局人设/信念崩坏——所以微调主攻 prompt-to-line。② Llama-8B 生成更丰富但一致性更低(richness vs stability 的 trade-off)。③ 大模型也不能幸免:补测 Llama-3.1-70B 与 Qwen3-32B 在 Mental Health 上 prompt-to-line 仅 0.639 / 0.459。④ 随对话变长,prompt-to-line 与 Q&A 下降,但 line-to-line 反而上升——因为「不一致的句子彼此之间往往一致」,说明 line-to-line 单用不可靠。
Q3:multi-turn RL 提升一致性(评测 prompt-to-line)
| Task | Baseline | SFT | KTO | PPO (Ours) |
|---|---|---|---|---|
| Open-Ended Conversation | 0.619 | 0.980 | 0.968 | 0.981 |
| Education | 0.824 | 0.826 | 0.585 | 0.994 |
| Mental Health | 0.657 | 0.561 | 0.339 | 0.904 |
PPO 相对 baseline 提升:闲聊 +58.5%、教育 +20.6%、心理 +37.6%。KTO 在 Education/Mental Health 反而崩坏(0.585 / 0.339),SFT 在 Mental Health 也退化(0.561)——只有 online PPO 稳定增益。
长对话鲁棒性(Table 8):PPO 在 Mental Health 各长度(10/20/40/60 轮)保持 0.953→0.877,而 baseline 0.738→0.571、KTO 0.580→0.170——RL 帮模型在长程守住人设,SFT/imitation 会漂移。
不伤通用能力:AlpacaEval-2 上 PPO 模型 win-rate 22.49%,与基座 Llama-3.1-8B-Instruct(22.92%)持平。FED 风格 18 维对话质量评测中,闲聊/教育域 clarity、coherence > 90%;但 Mental Health 的 adaptivity(40%)、informativeness(35%)明显偏低,提示一致性微调可能以牺牲情感细腻度为代价。
思考与可参考价值
局限:① 框架把 persona 当成静态身份强行守恒——真人会改变想法、演化信念、随情境调风格,本方法可能惩罚合理的态度转变(心理咨询场景尤其,自然变化本是真实性标志);FED 评测里 Mental Health 的 adaptivity/informativeness 下降正是此代价。② 只用 prompt-to-line 单指标做 reward,多指标联合训练留作 future work。③ reward 仍由 LLM Judge 算,存在 judge 偏差;人工标注仅 30 人,模糊样本代表性有限。④ 未建模跨 session 的长程时间一致性。
对电商 / 搜索推荐 / Agent 的可借鉴点:
- 用户模拟器训练范式反转:把 从「固定环境」变成「可训练 agent」直接迁移到电商场景——要训练导购 / 客服 / 推荐 agent,先用 RL 把「模拟买家」的人设(预算敏感、品类偏好、决策风格、犹豫程度)锁死,否则 simulator drift 会让下游 policy 学到假信号。这套 multi-turn PPO(action=整句、state=全历史、turn-level LLM-judge reward)的工程模板(OpenRLHF 扩展)可直接复用。
- 三类一致性指标可平移为「画像稳定性」监控:prompt-to-line ≈ 回复是否符合用户画像;line-to-line ≈ 同一 session 内偏好是否自相矛盾;Q&A ≈ 用专门探针题检测画像信念是否漂移。做生成式推荐 / Agent 优化电商时,可用这三类自动指标实时评估「模拟用户」或「角色化导购」的人设保真度,且 LLM-Judge 与人一致性高于人-人,可规模化替代人工评测。
- richness vs stability trade-off 的警示:更强模型生成更丰富但更易 drift——电商对话里若一味追求丰富度,会牺牲画像一致性;需用一致性 reward 显式约束。
- online RL(PPO)显著优于 offline(KTO)/ SFT,尤其 KTO 在敏感域会反向崩坏——在电商敏感场景(价格谈判、投诉处理)做对齐时,offline 方法的稳定性需谨慎验证。
- Q&A 探针法是低成本检测「belief 级 drift」的实用工具:surface 连贯(line-to-line 高)可能掩盖信念崩坏,对依赖用户长期偏好建模的推荐系统是个有价值的诊断思路。