SSRLive: Live Streaming Recommendation with Dynamic Semantic ID
Taobao & Tmall Group of Alibaba
淘宝直播的工业落地:把生成式推荐搬进直播预排序,针对直播两大特性做了两处关键改造——(1) 用「动态 SID」补「静态 SID」,静态 SID 编码主播历史多模态、动态 SID 用 EMA 更新的 RQ-KMeans 码本实时反映直播间当下内容/热度;(2) 用「生成+判别」混合架构,encoder-decoder 生成 SID 的同时,用 task query 从 SID 抽任务特定表征并显式融合 user-streamer 交互(点赞/下单)cross feature 做多任务预测。在线 A/B:观看时长 +3.38%、GMV +0.72%、涨粉 +3.12%,已全量部署服务数亿用户。
核心思路
把生成式推荐(SID + Transformer)落到直播预排序场景,解决直播特有的两个痛点:
- 静态 SID 与直播的实时性错配:短视频那套静态、不变的 SID 无法反映「直播间内容/热度随时间快速变化」。→ 提出动态 SID(Dynamic SID),用 EMA 更新的 RQ-KMeans 码本把直播间当下实时状态量化成码,和编码主播历史的静态 SID 互补。
- 纯生成式管线不显式建模 user–streamer 交互:点赞、下单这些交互对刻画用户对主播/商品的意图至关重要,但生成式检索(把 SID 当 next-token 生成)用不上。→ 提出生成+判别混合架构:SID 不直接拿去生成检索,而是当辅助信息喂给判别模块,用 task query 抽任务特定表征 + 显式融合 cross feature 做多任务预测。
范式区分:与 OneRec/TIGER 那种「把推荐重构成 SID 的 next-token 生成」不同,SSRLive 把 SID 当判别式排序的语义增强特征,兼顾生成式的高 FLOPs/可扩展性与判别式对交互信号的建模能力。定位在预排序(retrieval 与 ranking 之间)——用户侧双塔编码后接轻量交互网络。
整体实现思路
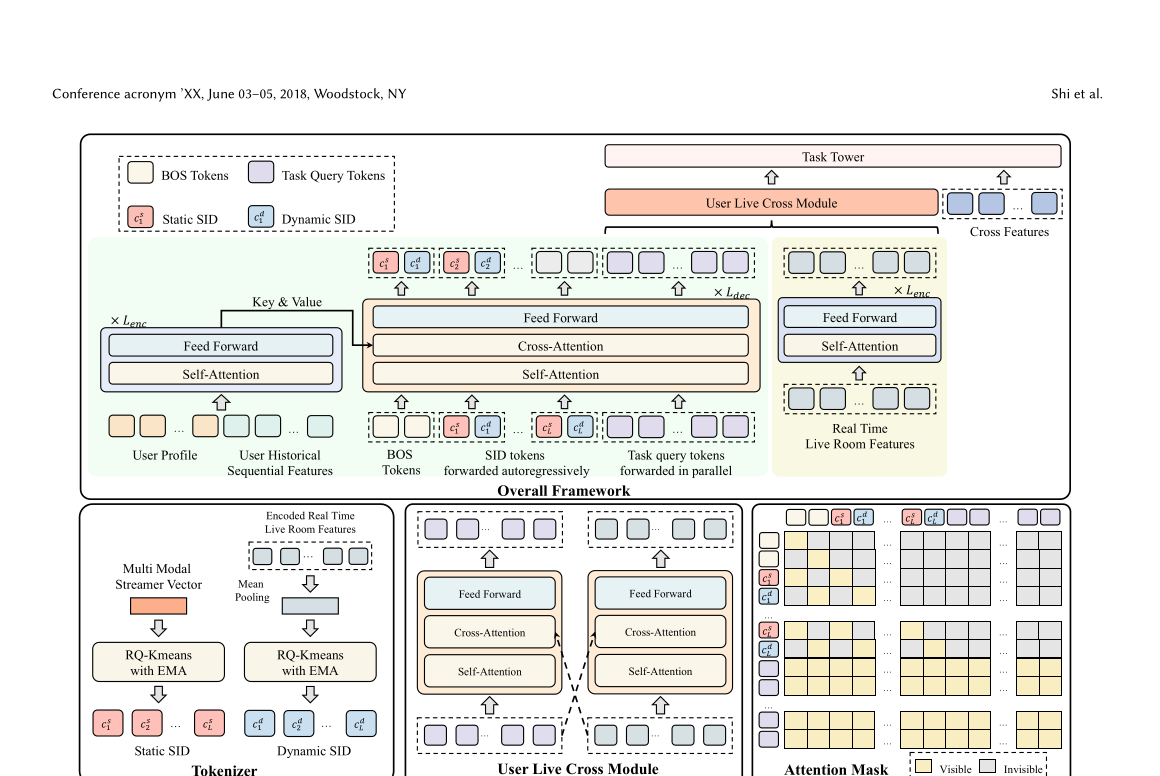
端到端 pipeline:
[Tokenization] 主播历史多模态段 → Transformer 编码 + Swing 对比学习(注入协同) → 主播向量 h_s
                                → RQ-KMeans(L 级码本) → 静态 SID C_s=[c_s1..c_sL]
               直播间实时特征 E_fv → MLP/Transformer 编码 → 实时向量 h_v
                                → RQ-KMeans(L 级,EMA 更新码本) → 动态 SID C_d=[c_d1..c_dL]
[生成模块] User Encoder:用户 profile + 历史序列 → Transformer encoder → HEnc
           SID Decoder:[BOS_s,BOS_d] + 交错的 SID token + 每任务 Q 个 learnable query
                        → Transformer decoder(HEnc 作 K/V)→ HDec
                        - 前 2L 个 hidden state 预测静态+动态 SID(NTP 交叉熵)
                        - 后 T×Q 个 hidden state = 任务特定表征 H_u
[判别模块] User–Live Cross Module:H_u 与直播间表征 H_v 做 cross-attention → Ĥ_u, Ĥ_v
           拼接 [Ĥ_u,t ; Ĥ_v,t ; c_u,v(cross features)] → MLP_t → 多任务预测 ŷ_t
[推理] Beam Fusion:静态/动态 SID 各维护独立 beam(各 B 条),按归一化概率加权融合 H_u
       线上 Fusion Score:ŷ_Fuse = Π_t ŷ_t^{α_t}
子模块实现(可复现细节)
模块 A — 静态 SID(Static SID)
编码主播不随当前直播内容变化的稳定特征。
- 输入:最近 M 天历史直播间片段,每天采 N_seg 段,共 M×N_seg 段;每段过 fine-tuned 多模态模型得
e_seg∈R^d(训练中冻结),拼成E_seg∈R^{(M·N_seg)×d}。 - 主播向量:
h_s = Mean(TrmEnc(E_seg))∈R^d。 - 注入协同信号:h_s 多模态语义强但协同信号弱,用 Swing 算法挖正样本主播对做主播级对比学习:
L_SCL = exp(sim(h_s,h_s+)) / Σ_{Neg} exp(sim(h_s,h_s−))(in-batch 负样本)。 - 量化:
C_s = RQ-KMeans_L(h_s) = [c_s1,...,c_sL]。案例研究(Fig.5)显示同前缀静态 SID 对应同品类(如 (613,*,*)=女鞋、(111,*,*)=男装)。
模块 B — 动态 SID(Dynamic SID)+ EMA 码本
反映直播间当下实时内容/热度。
- 输入:实时特征(当前观看人数、瞬时段级内容)
E_fv∈R^{N_fv×d},flatten→MLP→reshape 成Ê_fv∈R^{(T×Q)×d}(T=任务数, Q=每任务 query 数,供下游多任务用)。 - 实时向量:
H_v = TrmEnc(Ê_fv), h_v = Mean(H_v)∈R^d;编码器参数从预训练直播推荐模型 warm-start。 - 量化:
C_d = RQ-KMeans_L(h_v) = [c_d1,...,c_dL]。 - EMA 码本更新(关键,应对实时漂移):对分配到码 e_c 的当前 batch 向量做指数滑动平均——
N_c^(t)=γN_c^(t-1)+(1-γ)B;m_c^(t)=γm_c^(t-1)+(1-γ)Σh_v^b;e_c^(t)=m_c^(t)/N_c^(t),γ=0.99。静态 SID 的码本更新频率低、相对稳定(仅底层向量刷新时才 EMA)。案例(Table 3):同主播不同时刻动态 SID 随热度变化(如 (111,1559,*) vs (111,1194,*) 对应 5/30min 内不同观看量与时长)。
模块 C — SID Decoder(生成模块)与 attention mask
- decoder 输入(Eq.10):
[BOS_s, BOS_d]两个 BOS + 交错的 SID token[c_s1,c_d1],...,[c_sL,c_dL]+ T×Q 个 learnable query。交错排列让静态/动态 SID 每级同时生成,避免朴素拼接的双倍生成时间。 - decoder:加位置编码后过
L_dec层 Transformer decoder,用 user encoder 输出 HEnc 作 K/V(cross-attention)。 - attention mask 设计:所有 task query 在单次前向内并行、相互可见,且都能 attend 到前面所有 SID token;SID 位置上静态只 attend 静态、动态只 attend 动态(保持两类信息分离)。
模块 D — 判别模块(task query + cross module + 多任务)
- User Encoder:用户 profile
E_fu+ 历史序列E_fh拼接加位置编码 →L_enc层 Transformer encoder → HEnc。 - task query 抽取:取 HDec 末 T×Q 个 hidden state 作
H_u∈R^{(T×Q)×d},是从 SID + 用户特征抽出的任务相关信息。 - User–Live Cross Module(Eq.13):
Ĥ_v = FFN(CrossAttn(SelfAttn(H_v), H_u, H_u)) + SelfAttn(H_v),对称得 Ĥ_u,把直播间表征与用户表征做交叉。 - 多任务预测(Eq.14):
h_t = Concat(Flatten(Ĥ_u,t), Flatten(Ĥ_v,t), c_u,v),ŷ_t = MLP_t(h_t);c_u,v 是 user–streamer 交互 cross feature(点赞/下单)。 - 训练目标(Eq.17):
L_Total = L_MTL + λ_NTP·L_NTP + λ_Reg·‖Θ‖²,其中 L_NTP 是静态+动态 SID 的 next-token 交叉熵(teacher forcing),L_MTL 是加权多任务 loss。 - 推理 Beam Fusion:静态/动态 SID 各维护独立 beam(各 B 条候选),每条按归一化概率
p̂_b,融合H_u^Fuse = Σ_b (p̂_b^s + p̂_b^d)/2 · H_u,b。
实验设置与结果
数据:淘宝直播 1 周 ~1B(10 亿)user–streamer 交互记录(含观看时长、是否下单、是否互动)。预排序阶段评测,指标 AUC/GAUC,任务含 watch30/watch200(观看是否 >30s/>200s)、order。配置:静态/动态 SID 各 3 级、每级 2048 码本;每任务 query Q=2;beam size 10;lr 1e-3、weight decay 1e-2、AdamW。
离线主结果(表1,AUC/GAUC)
| Model | Watch30 AUC | Watch30 GAUC | Watch200 AUC | Watch200 GAUC | Order AUC | Order GAUC |
|---|---|---|---|---|---|---|
| DLRM (线上基线) | 0.7610 | 0.6892 | 0.8229 | 0.7288 | 0.8312 | 0.6727 |
| SASRec | 0.7581 | 0.6781 | 0.8154 | 0.7105 | 0.8205 | 0.6689 |
| ReaRec | 0.7594 | 0.6806 | 0.8167 | 0.7145 | 0.8216 | 0.6689 |
| HSTU | 0.7613 | 0.6823 | 0.8192 | 0.7156 | 0.8249 | 0.6710 |
| SSRLive | 0.7692 | 0.6956 | 0.8255 | 0.7281 | 0.8358 | 0.6946 |
DLRM 是很强的生产基线(多数情况超过 SASRec/ReaRec/HSTU),SSRLive 仍稳定超越;更强 backbone(HSTU>ReaRec>SASRec)一致更好,凸显骨干架构的重要性。
消融(表2)
| 变体 | Watch30 AUC | Watch200 AUC | Order AUC |
|---|---|---|---|
| SSRLive | 0.7692 | 0.8255 | 0.8358 |
| w/o SID | 0.7602 | 0.8179 | 0.8245 |
| w/o Dynamic SID | 0.7637 | 0.8214 | 0.8280 |
| w/o Task Queries | 0.7676 | 0.8246 | 0.8344 |
| w/o Cross Features | 0.7593 | 0.8149 | 0.8269 |
| w/o User-Live Cross Module | 0.7675 | 0.8248 | 0.8341 |
- 去 SID 掉最多;去 Dynamic SID 也掉(但优于去全部 SID → 静态 SID 也有效);cross feature 与 cross module 都重要——证实纯生成式 SID 不够,必须显式建交互。task query 数 Q 越大越好(Q=0/2/5,Q=5 最佳,正文用 Q=2 折中)。
在线 A/B(表4,vs DLRM,全部显著)
| Watch Time | Watch Count | GMV | Order Count | Follower Count | Interaction Count |
|---|---|---|---|---|---|
| +3.38% | +1.89% | +0.72% | +2.36% | +3.12% | +2.92% |
效率(表6)与 scaling
| Model | #Param(Dense) | FLOPs | Latency | Latency(Partial Run) |
|---|---|---|---|---|
| DLRM | 3M | 0.9T | 100% | 100% |
| SSRLive | 0.04B | 15T | 104.41% | 101.33% |
SSRLive 用 ~13× 参数、~17× FLOPs(把 DLRM 低 FLOPs/MFU 的算力利用短板补上),但靠 Partial Run(在候选数据准备完成前提前算生成模块)+ Async Live Encoder(直播编码与用户无关、异步算好被数万请求复用),端到端延迟仅 +1.33%。Scaling(Fig.4):0.2B 模型在数据量小时不如 0.04B,但随数据增大反超——大模型收敛慢但天花板更高。
思考与可参考价值
局限
- 无公开数据集:全部在淘宝直播私有数据上验证(作者也提到目前没有同时含直播间实时特征+主播历史多模态段的公开集),方法排名的普适性无法外部复现。
- 只做预排序单阶段:未打通召回→排序全链路,动态 SID 对完整生成式推荐管线(如 OneRec 式端到端)的收益未验证。
- 在线增益中等:GMV +0.72% 属工业小量级;动态 SID 的 EMA 码本在极端漂移下的稳定性、码本坍塌风险未深入分析(可参考同标签的 [[decoupled-residual-quantization-for-robust-semantic-ids-in-r]] 的 O_π/K_eff 诊断)。
- 静态/动态 SID 都用 RQ-KMeans,未讨论碰撞问题(可对照 [[how-reliable-are-semantic-id-tokenizer-comparisons-in-genera]]:SID 碰撞会让离散匹配指标虚高——SSRLive 把 SID 当特征而非检索 key,一定程度规避,但值得注意)。
对电商 / 搜推 / Agent 方向的可借鉴点
- 「动态 SID」是把生成式推荐用于快变内容的关键补丁:任何内容/热度快速变化的场景(直播、实时活动、闪购、热点内容),静态语义 ID 都不够——用 EMA 更新码本的动态 SID 反映「此刻状态」,是低成本让 SID 跟上实时性的通用做法。
- 「生成+判别」混合优于纯生成式:把 SID 当判别式排序的语义增强特征(而非 next-token 生成的检索目标),既拿到生成式高 FLOPs/可扩展的红利,又能显式融合点赞/下单等交互 cross feature——这对电商「用户对主播/商品双重意图」建模比纯生成式检索更合适,也更容易嵌入现有排序系统。
- task query 抽取任务特定表征:给每个任务一组 learnable query 从共享 SID/用户表征里抽任务相关信息(t-SNE 显示不同任务 query 聚成不同簇不塌缩),是多任务排序里解耦任务表征的轻量做法,可迁移到电商多目标(点击/转化/时长)排序。
- 工程落地范式:Partial Run(提前算与候选无关的生成部分)+ Async Live Encoder(把与用户无关、可复用的重编码异步化、跨请求共享)把 17× FLOPs 的延迟压到 +1.33%——这套「拆解可提前/可复用计算」的思路对任何想上大模型排序但受延迟约束的电商系统都直接适用。