SIDInspector: A Mapping-First Diagnostic Resource for Semantic-ID Tokenizers
Huawei Technologies
华为的「资源型/工具型」论文(非新 tokenizer、非新 benchmark):SID tokenizer 越来越被当成可复用的独立产物(导出的 item→code 映射就是生成器要用的地址空间),但覆盖缺口、full-code 混叠、行为弱前缀、尾部压缩、前缀扇出这些问题往往训完生成器才发现。SIDInspector 定义一套「adapter 契约 → 校验门 → D1–D5 探针 → 报告」的 mapping-first 诊断接口,在下游训练前就把 tokenizer 产物 profile 出来。核心发现:「可寻址性(addressability)」与「行为前缀对齐(behavioral prefix alignment)」会分道扬镳——ReSID 导出零混叠、但最强的前缀-共现对齐反而来自一个确定性的类目前缀 control(D3 0.447 vs 学到的 0.154 / 0.055–0.080),说明二者必须分开诊断。工具已开源。
核心思路
一篇资源/工具型论文,刻意声明「既不是新 tokenizer,也不是 RecBole 式覆盖 benchmark」。它抓住一个工程现实:SID tokenizer 越来越被当成可复用的独立产物——一旦导出,item→code 映射就成了后续序列生成器必须消费的地址空间。但这些映射几乎不带统一检查接口,于是覆盖缺口 / full-code 混叠 / 行为弱前缀 / 尾部压缩 / 前缀扇出这些问题往往等到下游训完生成器、烧完 GPU 才暴露。
SIDInspector 把 tokenizer 导出当作可检查的产物(artifact),问一个更窄但可复用的问题:给定任何能吐 item 级 code 序列的 tokenizer 产物,在重训生成器之前,能对它的容量利用、混叠、行为对齐、头尾分配、结构成本说些什么?
中心发现(narrow but useful):可寻址性 ≠ 行为前缀对齐(addressability is not behavioral prefix alignment)。一个 tokenizer 可以做到 full-code 零混叠(每个 item 唯一地址),但它的前缀仍然可能不能把行为相关的 item 聚到一起——这两个性质会分道扬镳,必须作为独立的产物属性分开诊断,而不是被一个下游榜单分数掩盖。范式区分:聚合排序指标(NDCG/Recall)是必要的,但它是检查地址空间本身的错误接口;SIDInspector 补的是「产物层」诊断,位于榜单评测之前。
整体实现思路
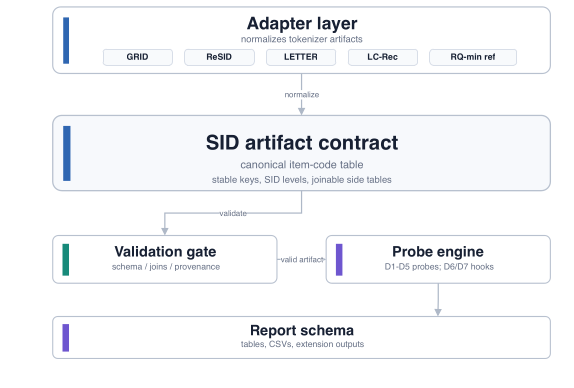
端到端流程(mapping-first,与训练循环解耦):
异构 tokenizer 仓库(checkpoint / item 映射 / codebook / 中间特征文件,可能只有部分)
     ↓ Adapter layer(薄导出层,非重训配方)
规范化 sid_assignments(item_id, method, dataset, sid_0..sid_L)  [+ 可选 metadata/interactions/refresh-pairs/generator_outputs]
     ↓ Validation gate(先校验后出指标)
校验:item 数一致、无缺码、key 唯一、深度一致、join 覆盖、provenance
     ↓ Probe engine(产物通过校验后才跑)
D1 利用率 / D2 混叠 / D3 邻域对齐 / D4 流行度分配 / D5 结构成本  [+ D6 时序漂移 / D7 生成轨迹 钩子]
     ↓
Report schema:表格 / CSV / 扩展输出(可与 Recall@K、NDCG 互补,但在其之前)
子模块实现(可复现细节)
模块 A — Adapter 契约与校验门(validation before metrics)
- 最小 schema:
item_id, method, dataset, sid_0, ..., sid_L → {D1..D5};interactions 追加 D3/D4 切片;成对映射追加 D6;生成轨迹追加 D7。新 tokenizer 只需写一个薄 adapter 吐这张表,不改训练循环。 - 契约三查:每行有稳定 item key、每个 SID level 是离散 token、诊断 item 全集可 join 到 metadata/interaction 切片。
- 校验门:item 数一致、缺码、重复 key、深度一致、provenance——必须先过校验再解读指标(公开 SID 仓库常只放 checkpoint/映射/codebook/中间特征/部分 release,不校验会误读)。变长 tokenizer 可用 padded/masked levels + 实际长度接入。
模块 B — D1–D5 映射级探针(符号:item i 的码序列 z(i)=(z₁..z_L),ℓ 级前缀 pℓ(i),码 c 的别名集 A(c)={i: z(i)=c})
- D1 利用率:逐级使用率、前缀计数、不平衡摘要、死码/低用码指示。
- D2 混叠(aliasing):full SID 落在非单例码桶的 item 比例(+ 前缀同量);是「item-in-alias-set」画像,不是重复码值计数——因果伤害需干预/下游曝光检查才能确证(呼应「碰撞不都有害」的 collision-aware 工作)。
- D3 邻域对齐(neighborhood alignment):前缀邻域能否恢复train-only 的 item 共现邻居。对每用户在有界 train 交互内成对、按共现计数排 top-k 有向邻居,报「邻居共享 pℓ(i) 的比例」(weighted 按边平均、mean 按 item 平均)。metadata 纯度只是辅助上下文,不代表协同质量。
- D4 流行度分配:按流行度分头/中/尾,测 full-code 容量与前缀结构是否对头尾差异化分配(尾部 unique-SID 比例)。
- D5 结构成本:SID 长度、前缀扇出、重复码、trie 式展开压力(服务延迟依赖生成器/解码栈,故长/变长/非对称 SID 需区分「最大深度」与「实际前缀成本」)。
- 扩展:D6 时序漂移(refresh-pair 间映射变化,drift-aware 场景);D7 生成轨迹(非法路径、next-token 熵、重复候选,需生成器输出/beam 轨迹,当前只是接口钩子)。
模块 C — 控制行与机制探针(calibration)
- 控制行校准指标尺度:如**类目前缀 control(Cat-prefix)**是确定性、结构 item-unique 的参照;Pop-balanced、Hash-collide 是压力测试行。
- 机制探针(Table 3):故意激活一个已知机制看探针是否响应——Qualified aliasing(hash 1.19× vs 共现 3.86×)验 D2 能分「共现别名 vs 哈希别名」;Capacity budget(head 1.000 vs tail 0.028)验 D1/D4 分头尾;Variable depth(max-depth 12,010 vs active 7,914)验 D5 分最大深度与实际成本。
实验设置与结果
四条 tokenizer 产物线:GRID/RQ-KMeans、ReSID/GAOQ(这两条做同 item 对比)、LETTER、LC-Rec(测已发布 item-index adapter)。主对比在 23,742 个 Musical item 上。
同 item Musical 诊断画像(表2)
| Artifact | Unique SIDs | D2 混叠 | D3-L1 对齐 | D4 尾部 | D5 各级前缀 |
|---|---|---|---|---|---|
| GRID-style ft | 3,749 | 0.977 | 0.055 | 0.370 | 64/3.4k/3.7k |
| GRID-style cap(扩容 32/1280/1280) | 9,874 | 0.779 | 0.080 | 0.639 | 32/9.3k/9.9k |
| RQ-min ref | 17,247 | 0.440 | 0.065 | 0.883 | 32/2.4k/17.2k |
| ReSID/GAOQ | 23,742 | 0.000 | 0.154 | 1.000 | 32/1.3k/23.7k |
| Cat-prefix control(确定性类目前缀) | 23,742 | 0.000 | 0.447 | 1.000 | 30/83/313/23.7k |
| Hash-collide(压力行) | 256 | 1.000 | 0.004 | 0.032 | 256×4 |
关键读数:GRID-style ft 混叠高达 0.977(3749 个唯一码硬塞 23742 个 item)、尾部容量差;ReSID/GAOQ 导出零混叠(每 item 一码)。但最强的前缀-共现对齐来自非学习的类目前缀 control(D3 0.447),远高于学到的 ReSID(0.154)或任一 GRID 行(0.055–0.080)。→ 学到的/item-unique 的地址照样可能不能把行为相关 item 分到一组。扩容消融:GRID cap 把混叠从 0.977 降到 0.779、唯一码升到 9874,但仍远非 item-unique——容量能解释部分压力,但 D2(混叠)和 D3(行为对齐)是互补的两个诊断,容量/混叠改善未必带来行为对齐的前缀。
D3 是「候选曝光信号」,不是最终排序质量
- 跨库:All_Beauty 20k 上粗类目前缀 control D3-L1 达 0.968、GRID/RQ-KMeans 特征文本行仅 0.081–0.090(D3 测的是「可用粗类目 vs 共现」的对齐度,随数据集而变)。
- 固定 reranker 探针:8 个 Musical 行 + 6 个 All_Beauty 行上,D3 与「train-only 前缀检索下的候选目标召回」强相关(depth-1 Spearman 0.976 / 1.000);K=20 时 D3 与 ranked Recall/NDCG 的 Spearman 在 Musical 达 0.970/0.952、All_Beauty 0.657/0.657。→ D3 暴露的是 reranker/生成器决定最终排序之前的「候选曝光结构」,最终排序质量仍是下游模型问题。
- 已发布 adapter:LETTER 与 LC-Rec Instruments 都过同一校验(9,922 item,9,897 唯一 full SID),D3-L1 分别 0.109 / 0.052——证明工具能吃已发布 tokenizer 映射,不只服务本地对比。
交付物
开源包(github.com/jdding/sidinspector,MIT,tag sidinspector-cikm2026-resource-v0.6):Python 包 + adapter 模板 + metric runner + 样例输入 + 测试 + clean-checkout verifier。支持三种用法:下游研究者当预训练分诊(缺 item/深度不一致/严重混叠/弱协同前缀的产物在烧 GPU 前被标记)、方法作者加 adapter 吐规范表拿 D1–D5 报告、读者跑 clean-check 复现。
思考与可参考价值
局限
- 不测因果伤害:D2 只报映射层混叠画像,明确说「因果伤害要靠干预或下游曝光检查」——所以「混叠高」不直接等于「效果差」(这也是它谨慎的地方)。
- 覆盖有限:只跑了 4 条 tokenizer 线,文献里的变长/漂移/多模态 SID 大多只是「未来 adapter」;D7 生成轨迹还只是接口钩子(没生成器输出就不激活)。
- D3 依赖可用类目/交互信号:跨数据集不可直接比(All_Beauty 的高 D3 只说明那里粗类目恰好更贴共现),是相对诊断信号而非绝对质量分。
- 资源论文性质,无「用了它就涨点」的下游收益证据——价值在流程前移、可比性、省 GPU,而非直接提指标。
对电商 / 搜索推荐 / Agent 方向的可借鉴点
- 「产物层诊断前移」直接可落地:任何要上生成式召回(商品 SID)的团队,都能在训生成器之前用这套 D1–D5 把 tokenizer 导出体检一遍——覆盖缺口、混叠率、尾部容量、前缀是否贴共现——把「训完才发现 tokenizer 有毛病」的返工成本前移,省算力。
- 可寻址性 vs 行为对齐要分开看:这是对整条 SID 路线最有用的告诫——别以为「去了碰撞、每个商品唯一码」就万事大吉,前缀能不能把行为相关商品聚到一起是另一个独立维度(D3)。这一点正好接上本标签的评估诊断链:[[how-reliable-are-semantic-id-tokenizer-comparisons-in-genera]](碰撞让 SID 级指标虚高,本文还引了它)与 [[decoupled-residual-quantization-for-robust-semantic-ids-in-r]](O_π/K_eff 诊断分布 vs 几何)——SIDInspector 相当于把这些散落的诊断收进一个统一接口。
- D3≈候选曝光信号:把「前缀-共现对齐」当作生成式召回候选曝光质量的离线代理(与 Recall/NDCG 高 Spearman),可在没有全量 A/B 时快速筛 tokenizer——和 [[gryphon-a-unified-architecture-for-semantic-id-generation-an]]「beam 定候选、item 分定排序」互补:D3 诊断候选层、Gryphon 修排序层。
- 统一 adapter 契约:给多套内部 tokenizer(不同团队/不同版本)建一个统一的 item→code 校验+profile 接口,是治理「tokenizer 产物散乱、指标口径不一」的工程好实践,值得在内部平台照搬。