Quantizing Intent: Cross-Domain Semantic IDs from Organic Activity for Industrial Ranking
LinkedIn 工业界工作:把「organic feed 行为」跨域蒸馏成用户 Semantic ID 喂给广告 CTR 排序模型,解决广告域交互稀疏/冷启动。核心发现是「行为丰富度原则」——SID 源里编码的行为信号越多,跨域迁移增益越大(profile 文本 +0.036% → 活动微调 LLaMA +0.107% → feed 行为聚合 +0.213%)。方法上提出 RQ-FSQ(残差量化 + 有限标量量化)在 30–280× 压缩下追平 dense embedding AUC,及 HDE 前缀 n-gram 稀疏表模块端到端训练;最冷启动用户 CTR AUC +1.522%。
核心思路
广告 CTR 预测受制于广告域监督极稀疏:大多数用户很少点广告,却在 organic feed(信息流)里产生海量行为证据。本文第一次系统研究跨域用户 Semantic ID——把来自信息流行为的用户表征量化成离散 token 序列,当作广告 CTR 模型的输入特征。关键概念区分:过去 SID 工作几乎都是单域(被量化的 embedding 和推荐目标同域),本文打破这个假设,用跨域的行为 SID 做迁移接口,且不加任何显式域对齐 loss——靠 CTR 目标的梯度自己把跨域 embedding table 重新特化到广告任务。
三个可复现的核心产出:
- 行为丰富度原则(behavioral activity richness):跨域 SID 的下游增益随「源表征里编码的行为信号量」单调上升。
- RQ-FSQ:残差量化(RQ-VAE 保全局几何) + 有限标量量化(FSQ 保逐维细节),在 30–280× 存储压缩下追平甚至略超 dense embedding 的 AUC。
- HDE 模块 + Multi-Source SID:用前缀 n-gram 稀疏 hash 表把任意 K 级 SID 端到端编码进 CTR 模型,无需改主干架构。
整体实现思路
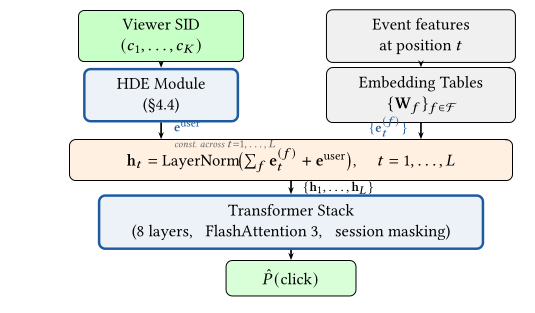
端到端 pipeline(主干 Transformer 完全不动,只改用户侧输入表征):
[离线] 三个跨域用户 embedding 源:
   Profile Qwen (纯文本语义)  / Activity-Tuned LLaMA (活动微调, profile 输入)  / Feed Activity (1 年行为聚合)
        ↓ RQ-KMeans (或对 pre-trained 源用 RQ-FSQ) 量化
   每个源 → K=3 级离散码 (codebook C=1024),可拼成 Multi-Source 9-code SID
        ↓ 缺源用 Activity-Tuned LLaMA backbone 做残差 VAE 插补,级联兜底→padding code 0
[在线/训练] 用户 SID 是 request-level(对某用户跨所有序列位置恒定)
        ↓ HDE 模块:前缀 n-gram 稀疏 hash 表查表 → e_user (端到端 CTR 目标训练)
        ↓ 融合 (Eq.10):每个事件位置 t 上 h_t = LayerNorm(Σ_f e_t^(f) + e_user)
   decoder-only Transformer (8 层, FlashAttention-3, session masking) → P(click)
子模块实现(可复现细节)
模块 A — SID 构造:RQ-KMeans 与 RQ-FSQ
对 dense 用户 embedding v ∈ R^d,残差量化产出 K 元离散 token:SID(v)=(c_1,...,c_K), c_k∈{1,...,C}(论文默认 K=3, C=1024)。两种量化器按「从零训练 vs 对齐已有 pre-trained embedding」选择:
RQ-KMeans(确定性、无变分目标,生产稳定):
- 把 v 分配到 C 个中心里最近的 → 记 c_1;2. 算残差
r_1 = v − μ_{c_1};3. 在后续残差上重复得 c_2,…,c_K。
- 优点:codebook 利用率高、离线分配可复现;从零量化时 k-means 的等方差假设契合。
RQ-FSQ(残差 + 有限标量量化,本文提出,用于 pre-trained 源):两个互补尺度并存——
- FSQ 分支(保逐维细节):对每维独立量化到有限整数字母表
L={−L,...,L}:Ĉ_FSQ = round(tanh(v)·L)(论文 L=16,即 4 bit/维)。 - RQ-VAE 分支(保全局几何):对连续残差跨 K 级量化得
Ĉ_RQ=(c_1,...,c_K),训练目标是标准 VQ-VAE loss:L = ||v − Σ_l e^(l)||² + Σ_l ||sg[r^(l)] − e^(l)||² + β·Σ_l ||r^(l) − sg[e^(l)]||²(β=0.25,sg=stop-gradient)。 - 融合:
e_RQ-FSQ = e_{Ĉ_RQ} + f(Ĉ_FSQ),f 是到模型维的线性投影。RQ-FSQ 用于 Feed Activity 源。 - 直觉:RQ-KMeans 的最近中心分配会丢掉重构信息;RQ-FSQ 加了重构目标保住源几何,故能追平 dense,代价是存储略大于 RQ-KMeans。
模块 B — Multi-Source SID + backbone 插补
把三源拼成结构化 9-code(行为丰富度递增):c_1–c_3 Activity-Tuned LLaMA(backbone,用户覆盖最高)、c_4–c_6 Profile Qwen、c_7–c_9 Feed Activity。全部 request-level、按 user ID 取、只用预测时间戳之前的数据。
- 缺源插补:设 u/v/w 为 Activity-Tuned LLaMA / Profile Qwen / Feed Activity embedding。当 v 缺失但 u 在,用专用残差 VAE 量化器从 u 插补 Profile Qwen 码:
Ĉ_P = RQ-VAE_P(g(u)),g 是 dim(u)→dim(v) 的线性投影,RQ-VAE_P 在同时有 u、v 的用户上以 v 为重构目标训练。选 LLaMA 当 backbone 因为它覆盖率最高且本身活动训练过,是缺源内容的合理估计。 - 级联兜底:当插补 backbone u 也缺,该源全 K 级发 padding code
c_k=0,HDE 把 padding 映射到零 embedding,用户表征干净退化为剩余源之和(不做虚假查表)。
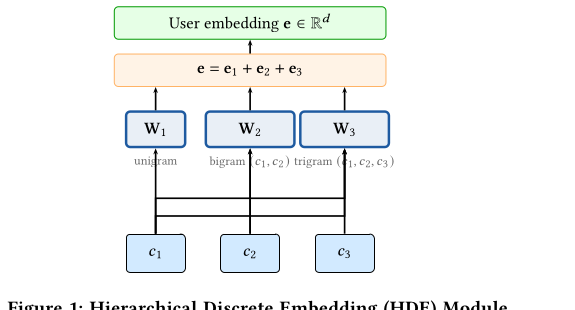
模块 C — Hierarchical Discrete Embedding (HDE)
把任意 K 级 SID s=(c_1,...,c_K)∈{0,...,C}^K(0=padding)编码成 dense 用户 embedding,用前缀 n-gram 稀疏表 + hash 查表,内存被 H_max 上限约束:
- Level 1(前缀 unigram):直接查表
e_1 = W_1[c_1],W_1∈R^{(C+1)×d},W_1[0]=0。 - Level k≥2(前缀 k-gram):多项式 hash
idx_k = [Σ_{j=1}^k (c_j−1)·C^{k−j}] mod H,e_k = W_k[idx_k],W_k∈R^{H×d}。 - 表大小:
H = min(⌊C^K/α⌋, H_max),α 是压缩因子,H_max 卡内存。各级 embedding 相加得e = Σ_k e_k;所有表随机初始化、CTR 目标端到端联合训练。 - Multi-Source:对每个源的 3-code block 独立套 HDE,再相加:
e_user = Σ_{s=1}^{S} HDE(s^(s)),S=3 得 9 次查表。独立分表避免了跨源 hash 碰撞。 - 对比 SIDE [17]:SIDE 用无碰撞的 positional base-C 编码,规模 O(C^K);HDE 选「可控碰撞换有界内存」,工业级不可能上无界表——这是刻意的工程取舍。
模块 D — 集成与训练细节
- 融合:
h_t = LayerNorm(Σ_{f∈F} e_t^(f) + e_user),e_user 跨所有 L 个位置恒定(request-level 广播)。 - 学习率:HDE 表用更高 lr
η_HDE=0.02,Transformer 权重η_TR=4e-4(embedding-heavy 排序系统惯例)。 - 超参:K=3、C=1024、D=64;内部 sweep 显示更小 K 欠拟合、更大 K/C 无额外增益。RQ-FSQ 存储 ≈
(K·⌈log2 C⌉ + D·⌈log2 L⌉)/8 ≈ 36 bytes(K=3,C=1024,D=64,L=16)。 - 服务成本:HDE 只做本地内存查表、用户 SID 离线预算,几乎零额外推理延迟;训练成本基本不变(HDE 表与模型共享同一 SGD step)。主干是 decoder-only Transformer(context-conditioned attention + timestamp RoPE + session masking + FlashAttention,DDP/FSDP2 on H200),本文视其为固定 backbone。
实验设置与结果
数据:某大规模工业广告平台 60 天训练 + 次 1 天评测;所有结果为相对 no-SID baseline 的相对 AUC 增益(绝对值保密)。工业尺度下 +0.1% 离线 AUC 可靠对应可测的线上 CTR 影响。
单源 SID:行为丰富度原则(RQ1–RQ2)
下游 AUC 增益随「源里编码的行为信号量」单调上升——做什么比怎么被描述更能预测广告参与:
| 源 SID | 描述 | ΔAUC |
|---|---|---|
| Profile Qwen | 纯文本语义,无行为信号 | +0.036% |
| Activity-Tuned LLaMA | 活动微调 + profile 提示(隐式行为) | +0.107% |
| Feed Activity | 直接 1 年行为聚合(最富) | +0.213% |
Multi-Source SID(RQ3)
| 组合 | ΔAUC |
|---|---|
| 独立组合(3 源分别索引后相加) | +0.260% |
| 结构化 Multi-Source SID(9-code + LLaMA backbone 插补) | +0.296% |
结构化在相同参数预算下比朴素相加多 +0.036%,来自两点:per-source 前缀表避免跨源 hash 碰撞;backbone 插补保住人群覆盖而非静默清零缺源用户。
RQ-FSQ 跨异构 pre-trained 源(RQ4)
两个源上 RQ-FSQ 都在 30–280× 更小存储下追平/略超 dense float:
| 方法 | Feed Activity 存储 | ΔAUC | LLaMA 存储 | ΔAUC |
|---|---|---|---|---|
| Raw float (dense) | 1× | +0.349% | 1× | +0.264% |
| RQ-KMeans | ~0.004× | +0.213% | ~0.0004× | +0.107% |
| FSQ | ~0.03× | +0.343% | ~0.003× | +0.248% |
| RQ-FSQ (ours) | ~0.03× | +0.351% | ~0.003× | +0.265% |
RQ-KMeans 大幅省存储但丢 AUC(确定性中心分配不优化重构);FSQ 单独恢复大部分差距;RQ-FSQ 两分支互补故追平 dense。存储收益随源维度增大——高维 LLM 编码器尤其受益。
冷启动分层(RQ5)
按 trailing 历史里不同广告曝光数分三段,增益随稀疏度单调放大,Feed Activity SID 是行为冷启动桥梁:
| 用户段 | ΔAUC (Feed Activity SID) |
|---|---|
| Most cold-start(近零广告历史,底部 8%) | +1.522% |
| Infrequent(中间 64%) | +0.874% |
| Frequent(顶部 28%,已有丰富广告信号) | +0.131% |
| Overall | +0.213% |
公开数据复现(MovieLens-100K)
用 all-MiniLM-L6-v2 编码电影文本、用户 = 喜欢电影 embedding 均值(跨域行为聚合的公开类比),RQ-FSQ 从训好的 RQ-KMeans 权重 warm-start,预测 held-out user–movie 评分 ≥4:RQ-FSQ AUC 0.8343(+6.54%)> RQ-KMeans 0.8215 > dense 0.8078 > no-SID 0.7689,验证 RQ-FSQ > RQ-KMeans 的排序在公开基准也成立。
思考与可参考价值
局限
- 纯离线 AUC,无线上 A/B:全文只报相对离线 AUC(绝对值保密),虽称 +0.1% AUC 对应线上 CTR 影响但未直接给线上实验数字,增益幅度(多在 0.03%~0.35%)在工业界属小量级,可信度依赖其内部 AUC-线上映射。
- 三源平台特定:Profile Qwen / Activity-Tuned LLaMA / Feed Activity 都是 LinkedIn 自有资产,复现需自备对应的「文本编码器 / 活动微调用户编码器 / 行为聚合」;HDE 的可控 hash 碰撞对质量的影响只在 pilot 说「无观测代价」,缺量化消融。
- 行为丰富度原则是相关性结论:三个点(+0.036/+0.107/+0.213)确立单调趋势,但源之间还差在模型/维度/训练数据,未能完全隔离「行为量」这一单一变量。
对电商 / 搜推 / Agent 方向的可借鉴点
- 跨域行为→SID 是冷启动利器:电商里「主站浏览/内容侧行为」远比「成交/广告点击」稠密,把前者蒸馏成离散用户 SID 喂给转化/广告模型,最冷启动人群收益最大(本文 +1.522%),这个「用富行为域补贫监督域」的范式可直接迁移到电商冷启动。
- RQ-FSQ 是通用 pre-trained embedding 离散化器:任何需要把 LLM/多模态 dense 向量压成紧凑离散码上线的场景(商品向量、用户向量、图文向量),RQ-FSQ 在 30–280× 压缩下追平 dense,比纯 RQ-KMeans 保真、比 dense float 省存储,高维 LLM 编码器尤其划算。
- 「离散 bottleneck + 端到端微调」= 离散空间的迁移学习:量化剥离源域几何、保留语义簇结构,再让下游目标梯度重新特化 embedding 表——不需要显式域对齐 loss,工程上比 EMCDR/CoNet 类跨域方法轻。
- 前缀 n-gram 稀疏表(HDE):把层级 SID 当组合类别特征,用有界内存 hash 表端到端学,是把「生成式 SID」塞进现有 DLRM/排序系统最低摩擦的方式,无需改主干;「可控碰撞换有界内存」对超大 vocab 上线是务实取舍。
- 隐私角度:离散 K 位低比特码相比 dense 向量暴露更少原始行为分辨率,是隐私更友好的跨域特征载体——对合规敏感的电商用户画像迁移有参考价值。