How Reliable Are Semantic-ID Tokenizer Comparisons in Generative Recommendation?
现有SID基生成推荐评估假设每个SID唯一对应物品,但实际存在大量SID碰撞(多物品共享同一SID),导致SID级指标高估项级性能。本文提出碰撞纠正评估(CCE)和零碰撞重分配(ZCR),纠正指标偏差并提供零碰撞SID分配用于公平比较。
📝 我的备注
加载中…
核心思路
解决SID基生成推荐中因SID碰撞导致的标准评估指标(Hit@K、NDCG@K)无法忠实反映物品级推荐质量的问题。核心思想是提出碰撞纠正的评估指标(ItemHit@K、ItemNDCG@K),将SID匹配的信用按碰撞组大小进行分数化;并设计一种只修改最后一级码字的零碰撞重分配方法(ZCR),在保持前缀结构的前提下以最小重分配成本消除碰撞,从而使不同标记器在统一的零碰撞条件下公平比较。
整体实现思路
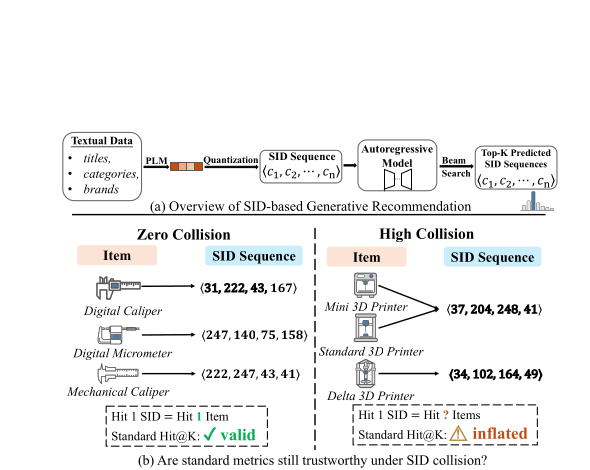
端到端流程:
文本元数据 → 预训练文本编码器(Qwen3-Embedding) → 物品嵌入 (4096d)
    ↓
SID标记器训练 (RK-Means/RQ-VAE/LETTER/QuaSID) → 物品映射为L级离散SID序列 [s1,s2,...,sL] (L=4, V=256)
    ↓
用户交互历史 → 转换为SID序列 → T5自回归生成模型训练 (预测下一个物品的SID序列)
    ↓
推理:波束搜索 (beam width=20) 产生 top-K 候选SID序列
    ↓
评估 (两种方案):
  (a) 原生SID级匹配 → 计算 Hit@K, NDCG@K (存在碰撞偏差)
  (b) 碰撞纠正评估 (CCE):扩展每个SID为其碰撞组,计算 ItemHit@K, ItemNDCG@K (用公式(4)-(7))
    ↓
标记器比较:可结合ZCR后处理
  - 对任意标记器的输出SID应用ZCR (算法1),产生零碰撞SID分配
  - 用零碰撞SID重新训练生成器,在CCE指标下比较各标记器
子模块实现(可复现细节)
碰撞纠正评估 (CCE)
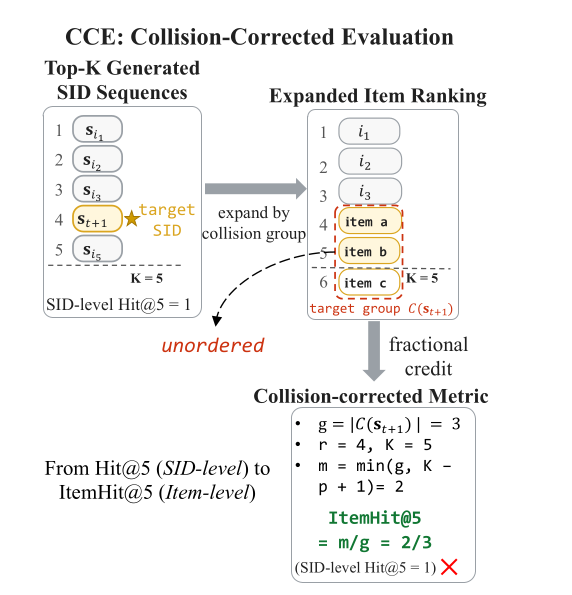
输入:
- 目标物品的SID序列
s_target - 波束搜索返回的top-K SID序列列表
B = [s^(1), s^(2), ..., s^(K)] - 预先构建的SID到物品逆映射表:对每个SID s,碰撞组
C(s) = {i ∈ I | s_i = s},及其大小|C(s)|
输出:
ItemHit@K(分数化命中,取值0~1)ItemNDCG@K(碰撞组内平均折扣累计增益)
关键公式与计算步骤:
- 找目标SID在B中的第一个出现位置
r(如果不存在,则m=0,ItemHit@K=0,ItemNDCG@K=0) - 目标组大小
g = |C(s_target)| - 构造扩展物品排序:将B中各SID的碰撞组按顺序展开,同组内物品无序。目标组在扩展排序中的起始位置:
p = 1 + Σ_{q=1}^{r-1} |C(s^(q))| - 计算落入top-K范围的目标组物品数量:
m = min(g, max{0, K - p + 1}) - 碰撞纠正指标:
(注意p+e为实际扩展位置,e从1到m;无IDCG归一化,因为理想情况是目标物品唯一且排在第1位,IDCG=1/log2(2)=1)ItemHit@K = m / g ItemNDCG@K = (1/g) * Σ_{e=1}^{m} 1/log2(p + e)
维度/超参:仅依赖预计算的碰撞组大小,无额外超参。
数据构造:无需额外训练,直接基于生成器输出的SID序列和原始标记器的SID映射表。
零碰撞重分配 (ZCR)
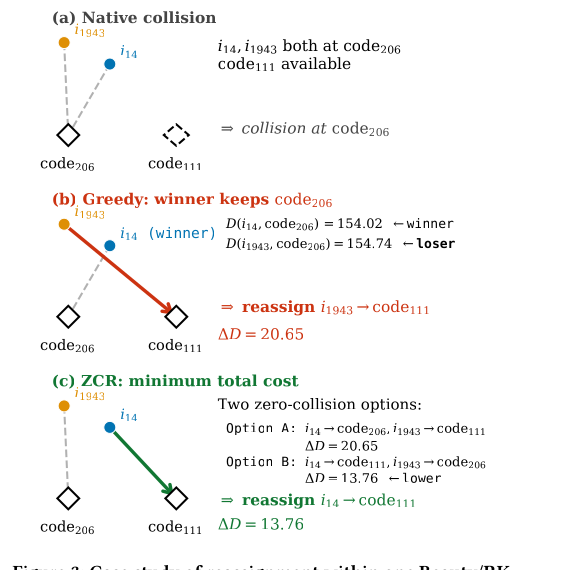
输入:
- 原生SID分配
{s_i}_{i∈I},其中s_i = [s_i^(1), ..., s_i^(L)],L=4,码本大小V=256 - 最后一级的残差向量
r_i^(L-1)(由标记器量化过程产生,维度d=32) - 最后一级码本
E^(L) = {e_c^(L)}_{c=1..V},每个码字维度d
输出:
- 零碰撞SID分配
{ŝ_i}_{i∈I},前L-1级不变,仅最后一级可能修改,满足全局唯一性,且重分配成本最小。
关键公式与算法:
- 距离矩阵:
D[i,c] = ||r_i^(L-1) - e_c^(L)||^2(i从1到N, c从1到V) - 按原生
(L-1)-前缀分组:P(p) = {i | s_i^(1:L-1) = p} - 对于每个前缀组
P(p):- 所需最少改动数量:
ρ_p = |P(p)| - |{s_i^(L) : i∈P(p)}| - 若
ρ_p = 0或|P(p)| > V则跳过(后者不满足容量条件,但实验验证未出现) - 求解带约束的最小成本重分配:
这等价于二分图最小权匹配问题:ρ_p 个物品需要改变其最后一级码字,所有物品的最终码字互不相同。用匈牙利算法求解,复杂度 O(|P(p)|^2 V)。min_{ŝ_i^(L)} Σ_{i∈P(p)} [ D[i, ŝ_i^(L)] - D[i, s_i^(L)] ] s.t. |{i: ŝ_i^(L) ≠ s_i^(L)}| = ρ_p ŝ_i^(L) 互不相同
- 所需最少改动数量:
- 全局零碰撞性:当所有前缀组满足
|P(p)| ≤ V时,修改后的SID全局唯一。实验验证所有标记器-数据集均满足(最大前缀组远小于256)。
实现细节:
- 距离矩阵用FAISS库批量计算。
- 匈牙利算法采用标准实现,可在
scipy.optimize.linear_sum_assignment基础上修改以处理改变数约束。具体地,我们首先固定那些不需要改变的物品的码字,然后构建剩余物品与码字的成本矩阵,再加上强制选择改变ρ_p个的约束,但实际可通过在原成本矩阵上扩充虚拟节点实现。论文未给出详细实现,但提到“Hungarian procedure in O(|P(p)|^2 V)”。 - ZCR总时间复杂度 O(N V d + Σ_p |P(p)|^2 V),N≈数万,可忽略。
SID标记器训练细节
RK-Means(非参数残差K-Means):
- 输入:物品嵌入
x_i(提取的文本嵌入) - 对每个残差层次
l=1..L:- 第1级:在原始嵌入上运行K-Means (
V=256, 20次迭代) → 码本E^(1),分配s_i^(1) - 后续级别
l:计算残差r_i^(l) = r_i^(l-1) - e_{s_i^(l)}^(l),在残差上运行K-Means →s_i^(l)
- 第1级:在原始嵌入上运行K-Means (
- 最终SID序列长度为4。
RQ-VAE系列(RQ-VAE, LETTER, QuaSID):
- 编码器:2层MLP,输出维度
d=32(与码字维度一致)。 - 码本大小
V=256,层级L=4。 - 训练:Adam优化器,学习率
1e-3,批量大小8192,承诺损失权重β=0.25,K-Means初始化码字,最多20Kepochs,早停耐心5,每2K epochs验证。 - RQ-VAE损失:标准VQ-VAE损失(重构 + 承诺损失)。
- LETTER在RQ-VAE基础上加入协同对齐正则项和码字多样性正则项。协同信号来自PPMI+SVD嵌入(256维),计算协同物品对的余弦相似度与SID前缀相似度之间的MSE损失。
- QuaSID增加碰撞类型感知的分离约束,区分三类碰撞(语义相似协同不相似、语义不相似但协同相似、两者均不相似),分别施加不同强度的分离损失。
生成式推荐模型(T5)
- 架构:T5 (4层编码器, 4层解码器),
d_model=128,前馈维度1024,注意力头数6,dropout0.1。 - 输入:用户交互历史的SID序列,每级SID视为一个 token,共4个token,序列长度等于历史长度(最大截断未说明,通常取最近N个交互)。
- 训练:预测下一物品的4个SID token,使用交叉熵损失,batch size未明确(与标记器训练解耦,使用标准生成模型训练协议)。
- 推理:波束搜索宽度
20,生成top-20的SID序列作为候选列表。
数据构造与特征准备
- 文本嵌入:使用
Qwen3-Embedding-8B模型编码物品标题和描述(若标题、描述为空则用其他元数据拼接),输出d_t=4096维向量,L2归一化。 - 协同嵌入(用于部分实验):构建物品共现矩阵的PPMI(窗口大小3,忽略用户序列最后2个物品防止泄漏),截断SVD取前256维,L2归一化。
- 融合:将文本和协同嵌入拼接
[x_i || α·x_i^cf],α=0.5,再通过PCA降维至4096维,保留与文本嵌入相同维度。 - 数据集:Amazon (Scientific, Cell, Beauty) 和 Yelp,5-core过滤,leave-one-out划分(最后交互测试,倒数第二验证,其余训练)。
实验设置与结果
数据集与统计
| 数据集 | 用户数 | 物品数 | 交互数 | 平均长度 | 稀疏度 |
|---|---|---|---|---|---|
| Scientific | 8,317 | 4,344 | 58,492 | 7.03 | 99.84% |
| Cell | 154,778 | 47,593 | 1,109,257 | 7.17 | 99.98% |
| Beauty | 22,363 | 12,101 | 198,502 | 8.88 | 99.93% |
| Yelp | 30,431 | 20,033 | 316,354 | 10.40 | 99.95% |
基线方法
- RK-Means: 残差K-Means量化,4级,码本256。
- RQ-VAE: TIGER中的未修改RQ-VAE,MLP编码器。
- LETTER: 加入协同对齐+码字多样性正则。
- QuaSID: 碰撞类型感知分离约束。
- MQL4GRec: 内置零碰撞的量化语言表示,作为零碰撞参考。
评价定义
- 标准SID级指标:Hit@K、NDCG@K (K=5,10),基于SID序列精确匹配。
- 碰撞纠正指标:ItemHit@K (IH@K) 和 ItemNDCG@K (IN@K),公式(6)(7)。
主要结果
原生碰撞率与指标膨胀 (表1, 表4)
| 数据集 | RK-Means Coll.% | RQ-VAE Coll.% | LETTER Coll.% | QuaSID Coll.% |
|---|---|---|---|---|
| Scientific | 30.52 | 20.42 | 1.24 | 5.41 |
| Cell | 28.52 | 14.04 | 3.39 | 3.25 |
| Beauty | 21.58 | 8.52 | 1.07 | 0.59 |
| Yelp | 15.73 | 9.05 | 8.59 | 6.23 |
膨胀率(Inflation% = (Hit@10 - ItemHit@10)/ItemHit@10 × 100%)最高达103.36%(RK-Means on Scientific)。
碰撞纠正后性能 (表3)
| 数据集 | 标记器 | Native IH@10 | +ZCR IH@10 | 提升% |
|---|---|---|---|---|
| Scientific | RK-Means | 0.0654 | 0.0812 | +24.1% |
| RQ-VAE | 0.0665 | 0.0800 | +20.4% | |
| LETTER | 0.0767 | 0.0791 | +3.1% | |
| QuaSID | 0.0749 | 0.0789 | +5.3% | |
| Cell | RK-Means | 0.0524 | 0.0694 | +32.4% |
| RQ-VAE | 0.0574 | 0.0657 | +14.4% | |
| LETTER | 0.0628 | 0.0660 | +5.0% | |
| QuaSID | 0.0656 | 0.0663 | +1.0% | |
| Beauty | RK-Means | 0.0547 | 0.0662 | +21.1% |
| RQ-VAE | 0.0576 | 0.0608 | +5.6% | |
| LETTER | 0.0610 | 0.0625 | +2.5% | |
| QuaSID | 0.0644 | 0.0645 | +0.2% | |
| Yelp | RK-Means | 0.0313 | 0.0347 | +11.1% |
| RQ-VAE | 0.0340 | 0.0361 | +6.0% | |
| LETTER | 0.0405 | 0.0442 | +9.0% | |
| QuaSID | 0.0369 | 0.0381 | +3.2% |
(完整表包含ItemHit@5和ItemNDCG,此处仅摘录IH@10示例;原文表3提供全部数据)
排序反转:SID级 vs 项级
- Scientific: SID Hit@10排名:RK-Means (0.1330) > RQ-VAE (0.1147) > LETTER (0.0804) > QuaSID (0.0768);Item Hit@10排名:LETTER (0.0767) > QuaSID (0.0749) > RQ-VAE (0.0665) > RK-Means (0.0654)。RK-Means从第一跌至最后。
- Cell、Beauty类似,QuaSID升至第一,RK-Means垫底。
ZCR成本比较 (表5)
| 标记器 | 数据集 | 重分配物品数 | 贪婪总成本 ΔD | ZCR总成本 ΔD | 成本降低% |
|---|---|---|---|---|---|
| RK-Means | Scientific | 875 | 38,864 | 35,674 | 8.21% |
| Cell | 8,519 | 276,488 | 252,486 | 8.68% | |
| Beauty | 1,574 | 63,409 | 55,678 | 12.19% | |
| Yelp | 2,029 | 41,689 | 38,074 | 8.67% | |
| RQ-VAE | Scientific | 3,009 | 20.82 | 16.53 | 20.64% |
| Cell | 3,962 | 32.42 | 26.53 | 18.17% | |
| Beauty | 850 | 5.26 | 3.99 | 24.00% | |
| Yelp | 3,420 | 5.77 | 4.56 | 20.95% | |
| ZCR一致优于贪婪重分配。 |
协同信号融合消融 (图4)
- 在零碰撞设置下,向RK-Means+ZCR加入协同嵌入(RK-Means+ZCR+CF)在所有数据集上进一步提升ItemHit@10,最大提升在Yelp(+63.1%),表明协同信息对文本区分度低的场景尤其有益。
可视化分析 (图5)
通过t-SNE对比Qwen3文本空间和PPMI+SVD协同空间中的碰撞组,发现文本空间中紧密聚集的物品在协同空间中分散,解释了纯语义量化易产生碰撞的原因。
思考与可参考价值
局限
- CCE中信用统一分配(1/g)忽略了组内物品的流行度或上下文相关性差异,可能在某些场景下不够精确。
- ZCR仅改动最后一级码字,依赖前缀组大小不超过码本大小V的条件。当V较小或存在极大多时,需扩充码本或采用多级重分配,但后者会破坏前缀结构。
- 实验仅使用了中等规模公开数据集和单一T5生成架构,结果在更大规模工业数据或不同生成模型上的普适性待验证。
对搜索推荐/Agent方向的可借鉴点
- 评估协议警示:任何基于离散标识符生成的任务(如商品ID、query token)若存在多对一映射,标准精确匹配指标都可能高估真实质量。CCE提供的分数化信用分配思路可推广至此类场景。
- 后处理去碰撞技术:ZCR是一种通用后处理方法,可用于任何产生SID的量化标记器,无需修改训练过程,以最小代价获得零碰撞分配,为不同标记器提供统一比较基准。
- 协同与文本融合线索:文中RK-Means+ZCR+CF简单融合协同信号即超越复杂定制标记器,表明在零碰撞条件下,有效的特征融合可能比精心设计标记器架构更关键。这为工业界快速迭代提供了思路。
- 碰撞率与文本质量关联:Yelp的文本稀疏导致碰撞组规模大,提示在元数据贫乏的领域,应着重引入协同或跨模态信息以避免碰撞。