Gryphon: A Unified Architecture for Semantic-ID Generation and Item-Level Scoring in Industrial Recommendations
Yandex
Yandex 音乐的工业方案:指出生成式检索(GR)的一个结构性错配——beam search 优化的是「SID token 序列的似然」,但推荐质量看的是「item 级相关性」,两者在 (a) beam 误差累积导致序列似然失准、(b) 多 item 碰撞到同一 SID 得相同分 两种情况下发散。Gryphon 在 encoder-decoder GR 上加一个联合训练的 Item-Level Scoring Module (ILSM),复用同一次前向的 encoder 用户表征:beam 只负责生成候选 SID 集合,再把每个 SID 解析成具体 item 用 ILSM 直接重打分——绕开失准的序列分、也能区分同 SID 的不同 item。工业音乐平台 Recall@1000 +3.7%(vs vanilla GR)/+2.5%(vs 去碰撞 GR),item 级重排比同候选的 beam 似然排序还高 +4.2%;线上作为唯一候选源替掉 15+ 召回器 + 整个预排序阶段,收听时长无显著变化 (+0.25%)。
核心思路
生成式检索(GR)把「下一个 item 推荐」重构成对短离散 token 序列(Semantic ID)的自回归生成,用 beam search 出候选。但存在一个结构性错配:beam search 排的是 SID token 序列的累积似然 ℓ_θ(σ|u)=Σ_b log p_θ(s_b|u,s_<b),而推荐质量评的是具体 item 的相关性。这个 gap 在两种失败模式下暴露:
- 序列似然失准(miscalibration):训练用 teacher forcing(喂 ground-truth 前缀),推理却条件在模型自己生成的前缀上,早期 token 错误会累积、把 beam 带进错误子树,让相关 item 落在低分 SID 路径上。
- SID 碰撞:多个 item 映射到同一 SID(碰撞组
C_σ=Φ⁻¹(σ))时,ℓ_θ(Φ(x_i)|u)=ℓ_θ(Φ(x_j)|u)——beam 似然给它们完全相同的分,无法表达组内相关性差异。
两个失败模式同源:生成器给「标识符」打分,推荐器要给「item」排序。Gryphon 的解法:在 encoder-decoder GR 上加一个联合训练的 Item-Level Scoring Module (ILSM),把「item 最终选择」与「beam 似然」解耦——beam 只决定哪些 SID 进候选池,进池后用 ILSM 对解析出的具体 item 直接重打分。范式区分:与「改进 SID 分配 / 去碰撞」的路线不同,Gryphon 不动 SID 生成,而是换掉最终排序信号(item 级分 ← 而非 SID 序列似然)。
整体实现思路
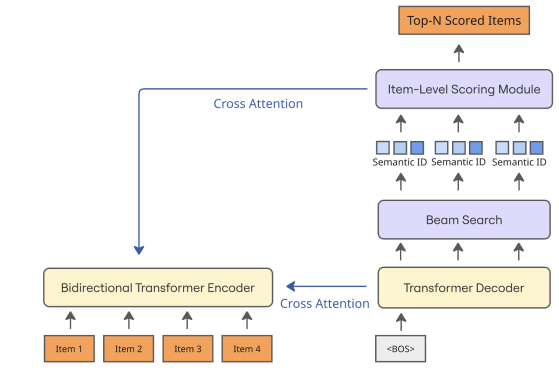
端到端流程(单次 encoder 前向,两个 head 共享):
用户行为序列 → Bidirectional Transformer Encoder(单次前向)→ 用户表征 E_u
     ├──[生成分支] Transformer Decoder(cross-attn 用 E_u)→ beam search(K=2048) → 候选 SID 集合 B_u
     │        每个 SID σ 解析成碰撞组 C_σ → 候选 item 池 I_u = {i | ∃σ∈B_u, i∈C_σ}
     └──[判别分支] ILSM(cross-attn 复用同一 E_u)→ 对 I_u 里每个 item 直接打分 r_φ(u,i)
                → TopN(u) = TopN_{i∈I_u} r_φ(u,i)   (beam 似然被丢弃,不参与最终排序)
     → Top-N 候选交给下游 ranker
子模块实现(可复现细节)
模块 A — 生成式检索(SID 生成)
- 量化器
Φ: X → Π_b {1..M_b},把每个 item 映射成 d-token SID(s_1,...,s_L);本文用 residual K-Means 量化。 - decoder 自回归预测下一 item 的 SID,生成 loss(teacher forcing):
L_gen = −Σ_{t=1}^L log p_θ(s_t⁺ | s_<t⁺, E_u)。 - 推理:decoder beam search 生成 top-K SID 集合 B_u(K=2048);beam 似然只用于决定 B_u 成员资格,不作为最终 item 分——这是刻意解耦。
模块 B — Item-Level Scoring Module (ILSM)
- 每个候选 item i 由 item tower 产出 item-query 嵌入:
e_i = T_item(Φ(i), h_i),h_i 是 item 原生特征(item-ID hash、metadata、内容特征);本文 ILSM 只用 item-id 特征,确保对 GR baseline 无特征优势。 - 打分:
r_φ(u,i) = f_φ(E_u, e_i),其中 f_φ 是轻量 item-to-user cross-attention block + MLP head 输出标量相关分。 - 直接解决 SID 碰撞:同 SID 的 item 靠各自 item 级特征拿到不同分;也**缓解(但不消除)**自回归误差累积——beam 仍决定哪些 SID 进池,但进池后最终选择不再依赖 SID-token 似然的乘积。
模块 C — 联合训练目标
- ILSM 不绑定特定监督信号(可用多目标参与度预测 / ranker 蒸馏 / 长期价值);本文用 next-item prediction + sampled softmax:
p_φ(i_{t+1}=i|E_u) ∝ exp(r_φ(u,i)/τ),τ 为温度。 - 带 in-batch 负样本 B⁻ 与 LogQ 采样纠偏(
−log Q_i项,降低热门 item 偏置)的损失 L_NIP(softmax 交叉熵形式)。 - 总目标:
L = L_gen + λ·L_NIP(λ=1)。两个 loss 共享同一 encoder 状态 E_u,逼用户表征同时支持 SID 级候选生成与 item 级相关性估计。
关键工程取舍
- 与 TIGER「给碰撞 item 追加一个终结 token 去碰撞」相比,Gryphon 认为追加 token 把「解析词表」绑死到目录,动态目录(新 item 持续涌入)下解析层要无限增长/重训——不适合部署;ILSM 用 item 级特征区分碰撞组,天然适配动态目录。
- 参数/延迟:Gryphon 用与 vanilla GR 同样的 codebook(3×32000),把 decoder 的一个 block 换成单层 ILSM,参数量与推理时间差 <1%。beam size K=2048,用户序列长 512,hidden 1024。
实验设置与结果
数据:某大规模音乐推荐平台 1 周真实日志,数千万活跃用户与 item。指标:Recall@k(ground-truth item 落在返回 top-k 的比例);因候选后接生产 ranker,Recall@1000 是候选生成质量的主指标。初始化方差经验估计 ±0.003。
离线主结果(表1)
| Method | SIDs | Recall@10 | Recall@1000 |
|---|---|---|---|
| ARGUS(生产双塔 Transformer 基线) | - | 0.0996 | 0.6582 |
| Vanilla GR | 3×32000 | 0.1961 | 0.8245 |
| Vanilla GR Resolved(追加 token 去碰撞) | 2×1024 | 0.2077 | 0.8343 |
| Gryphon (ours) | 3×32000 | 0.2178 | 0.8552 |
Recall@1000 比 vanilla GR +3.7%、比去碰撞 GR +2.5%;参数量与延迟基本持平。
消融:分数从哪来(表2,同一 K=2048 beam 候选池,三种打分)
| 变体 | 打分方式 | Recall@1000 |
|---|---|---|
| Gryphon w/o ILSM | SID 级(beam 分) | 0.8404 |
| Gryphon w/o ILSM | item 级(beam 分) | 0.8209 |
| Gryphon | item 级(ILSM) | 0.8552 |
关键洞察:① 用 beam 似然做 item 级排序(0.8209)低于 SID 级(0.8404)——量化了碰撞代价:beam 似然无法区分同 SID 的 item;② ILSM 重打分同一候选池升到 0.8552,超过 SID 级 beam 天花板(+4.2% over beam-likelihood ranking of same candidates)。item 级 recall 能越过这个天花板,只可能是把 beam 排在 1000 名外的 SID 里的 item 提了上来——证明限制因素是 beam 似然失准,而非候选召回不足。
在线 A/B(表3,7 天,4% 流量,作为唯一候选源)
| 维度 | 生产栈 | Gryphon |
|---|---|---|
| 候选生成器数量 | 15+ | 1 |
| 初始候选数 | 10,000 | 1,000 |
| 预排序阶段 | 有 | 无 |
| 传给 ranker 的候选 | 3,000 | 1,000 |
| 总收听时长 (TLT) | – | +0.25%(不显著) |
| 活跃用户比 | – | +0.43%* |
| 未听完曲目 | – | −1.3%*(* p<0.001) |
Gryphon 单模型替掉 15+ 异构召回器 + 整个预排序阶段,主参与度指标(TLT)无显著变化,次要质量指标显著向好,把传给 ranker 的候选从 3000 降到 1000(−66.7%)——大幅简化候选生成系统。
思考与可参考价值
局限
- 无显著性检验:离线因计算成本未做多 seed 显著性检验(仅报 ±0.003 方差估计);线上主指标 TLT +0.25% 本身不显著,卖点是「简化系统的同时不掉指标」而非涨指标。
- 仍需下游 ranker:Gryphon 简化了候选生成但没消除生产 ranker;ILSM 本文只用了 next-item + item-id 特征的最简实例化,多目标/蒸馏/长期价值等更强监督留作未来工作。
- beam 仍是召回瓶颈:ILSM 只重排 beam 已召回的 SID 池,无法救回 beam 完全没生成的 SID——它纠的是「排序失准」,不是「召回缺失」。
- 单一音乐平台、单一场景验证,跨品类/跨模态普适性未知。
对电商 / 搜索推荐 / Agent 方向的可借鉴点
- 「生成 SID 做召回、item 级重打分做排序」是 GR 落地的关键解耦:直接呼应本标签的碰撞评估工作 [[how-reliable-are-semantic-id-tokenizer-comparisons-in-genera]]——既然 SID 碰撞会让序列级分虚高/无法区分 item,那就别用序列似然做最终排序,改用复用同一 encoder 表征的轻量 item 打分头。电商生成式召回(商品 SID)可直接照搬这个「beam 定候选集、item 分定排序」的两段式。
- 共享 encoder + 双 head 几乎零成本:把 decoder 一个 block 换成单层 ILSM,参数/延迟 <1% 增量就拿到 +4.2% 的重排收益——对已有 encoder-decoder 生成式召回的系统是低风险增量改造。
- 动态目录友好:不用 TIGER 那种「追加终结 token 去碰撞」(解析词表随目录膨胀、要重训),改用 item 级特征区分碰撞组——对商品持续上新的电商目录更实用。
- 系统简化价值:单个生成式模型替掉 15+ 召回器 + 预排序阶段、候选量 −66.7% 而指标不掉,这种「用一个可扩展生成模型收敛掉一堆异构召回器」的方向,对维护成本高企的工业多路召回系统是很有吸引力的架构演进信号。