Generative Retrieval for E-commerce: Jointly Learning Embedding and Codebook with Same Product Cluster
Alibaba Group (HangZhou)
指出主流生成式检索「先训 embedding、再学 codebook」的两阶段级联有两个结构缺陷:误差累积(一阶段的表征偏差二阶段无法纠正)与交互建模缺失(codebook 只看静态 embedding,看不到 query–product 交互,导致同款商品被分到不一致的 ID)。提出把 embedding 模型与 RQ-VAE codebook 放进同一个目标里联合训练——在量化前的 h_product 与量化后重构的 h_recon 上同时施加 query–product InfoNCE,让检索梯度穿过量化器回流;再用「同款商品簇」(不同卖家/尺码的同一 SKU)的均值表征做 MSE 约束,把同款拉进同一码空间邻域。2000 万淘宝商品 + Qwen2.5-7B 两阶段(Product2Code → Query2Code)实验,Recall@100 从 TIGER 的 26.38 提到 30.71,同款共享 ID 前缀长度 ALSP 从 3.92 提到 4.42/5。
核心思路
问题:生成式检索(GR)把商品编成离散 Semantic ID,再让 LLM 从 query 自回归生成 ID。主流做法(TIGER / LETTER / MERGE / UniSearch)是两阶段级联:Stage-1 训一个商品 embedding 模型,Stage-2 冻结 embedding 后用 RQ-VAE / K-means 学一套 codebook 把 embedding 映射成 ID。这条 pipeline 有两个结构性缺陷:
- 误差累积(error accumulation):Stage-1 学出的表征若有偏,Stage-2 只能在这个有偏空间上量化,没有任何机制纠偏,偏差被量化进 ID 里放大。
- 交互建模缺失(insufficient interaction modeling):codebook 的学习目标只有「重构 embedding」,完全看不到 query→product 的相关性信号,也看不到 product→product 的关系。后果最直观的表现是——同款商品(different sellers offering the same SKU,或同一商品的不同尺码/规格)会被分到语义上不一致的 ID,前缀都对不上,LLM 后续要学的 query→ID 映射因此变得支离破碎。
关键 idea:两件事同时做。
- 联合训练:把 embedding 模型和 codebook 放进同一个 loss里端到端优化,让 query–product 的对比学习梯度穿过量化器回流到 embedding 模型——这样 codebook 的学习不再只依赖静态 embedding,而是被检索目标直接监督。
- 同款簇监督(Same Product Cluster):引入电商平台天然存在的「同款库」结构作为额外监督信号,把同一簇内商品的表征往簇均值拉,使得同款在残差量化的每一级都落进同一个码字,从而共享长前缀。
值得点明的范式区分:这不是又发明一个新 tokenizer 架构,而是改训练拓扑(级联 → 联合)+ 加一个免费的业务先验(同款关系)。作者也顺手提出一个可直接落地的诊断指标 ALSP(同款商品间共享 ID 前缀的平均长度),用来量化「ID 语义一致性」这件此前没被单独测量过的事。
整体实现思路
整个框架分成两大块,Product Identifier Training(联合学 embedding + codebook,产出每个商品的 Semantic ID)和 LLM Training(学 query → Semantic ID 的生成映射)。
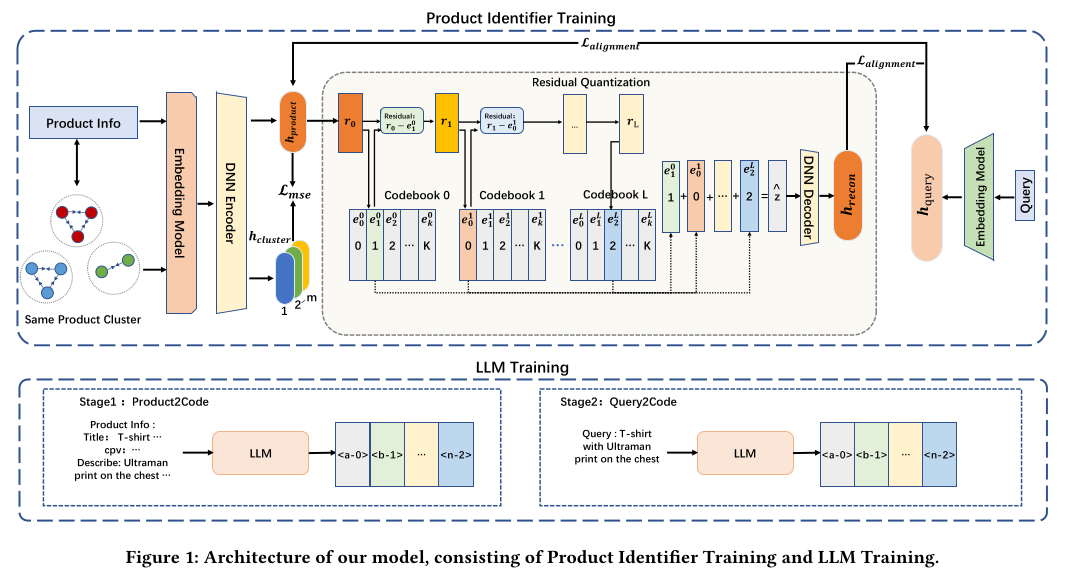
端到端数据流:
商品信息 (title / cpv / description)  ──► Embedding Model (GTE) ──► DNN Encoder ──► h_product ∈ R^768
同款簇 c(p) 采样 m 个商品          ──► 同一 Embedding Model      ──► h_1..h_m ──► mean ──► h_cluster
                                                                       │
                                                       L_mse(h_product, h_cluster)  ← 同款一致性约束
                                                                       │
h_product = r_0 ──► 5 级残差量化 (L=5, K=32, d=768) ──► ID z=[z_1..z_5] & ẑ=Σ e_{z_l}
                                                                       │
                                                       ẑ ──► DNN Decoder ──► h_recon
                                                                       │
query ──► 同一 Embedding Model ──► h_query ──┬── InfoNCE(h_query, h_product)   ← 量化前对齐
                                             └── InfoNCE(h_query, h_recon)     ← 量化后对齐(梯度穿过量化器)

──► 每个商品拿到 ID,如 [<a-1>,<b-0>,<c-6>,<d-2>,<e-9>] ──►
Stage-1: LLM(商品信息) → ID      (让 LLM 先认识新 token 的语义)
Stage-2: LLM(用户 query) → ID    (真正的检索任务)
核心设计意图:图里那两条 L_alignment 箭头(对应正文的 InfoNCE)是整套方法的枢纽——它们把 query 的相关性监督同时打到量化前和量化后,前者训 embedding 模型,后者迫使梯度穿过 codebook 回传。这就是「联合」二字的落点:codebook 不再只是 embedding 的下游附庸,它自己也要对 query 负责。
子模块实现(可复现细节)
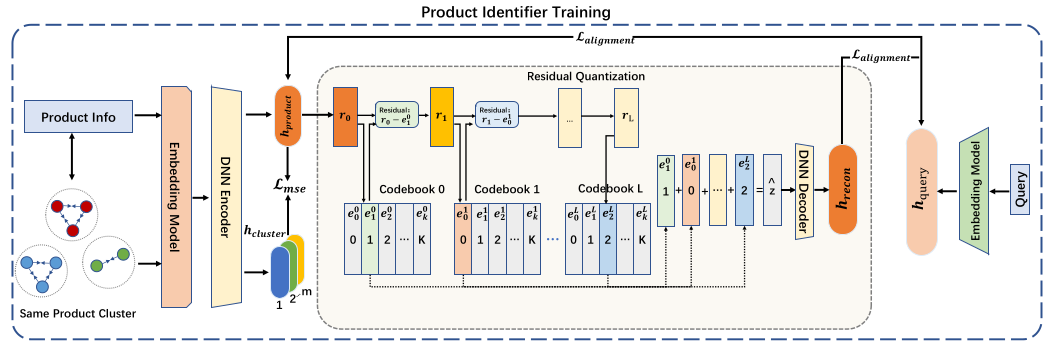
模块 A — Query & Product Encoding(含同款簇约束)
- 输入:商品 的多模态属性文本(title、cpv 属性、description、category),token 序列 ;以及 query 。
- 编码器:query 与 product 共享同一个 embedding model(实现用 GTE / mGTE [Zhang & Zhang 2024],支持长文本),后接一个 DNN Encoder 投影,输出 。
- 同款簇构造:每个商品 属于一个同款簇 ——功能上或视觉上完全相同的一组 item(不同卖家卖的同一 SKU、同商品的不同尺码)。从 里随机采样最多 个商品,用同一 embedding model 抽 ,取均值:
h_{cluster} = \frac{1}{m}\sum_{i=1}^{m} h_i \tag{1}
- 约束:把商品表征往簇中心拉,
\mathcal{L}_{mse} = \mathrm{MSE}(h_{product},\, h_{cluster}) \tag{2}
- 实现要点:随机采样(而非固定取全簇)等价于每个 step 用一个带噪的簇心估计,起到正则作用; 上限 5 也控住了大簇的显存/计算开销。注意这是一个收缩(shrinkage)正则—— 过大会把簇内商品压成一个点,牺牲簇内区分度,论文取 (未做敏感性实验,见后文批判)。
模块 B — Semantic Embedding Residual Quantization(RQ-VAE)
- 输入/输出: → ID 序列 ,。
- 码本配置(可复现关键超参): 层,每层 个码字,码字维度 。即码空间容量 ,对应 2000 万商品。
- 逐级残差量化():
\begin{cases} z_l = \arg\min_k \|\mathbf{r}_{l-1} - \mathbf{e}^l_k\|^2,\quad \mathbf{e}^l_k \in C_l \\ \mathbf{r}_l = \mathbf{r}_{l-1} - \mathbf{e}_{z_l} \end{cases} \tag{3}
其中 是第 级码本, 可学习。
- 量化表征与重构:,送入 DNN Decoder 得 ,重构 loss:
\mathcal{L}_{recon} = \|h_{product} - h_{recon}\|^2 \tag{4}
- 码本承诺 loss(含 stop-gradient):
\begin{cases} \mathcal{L}_{RQ\text{-}VAE} = \mathcal{L}_{recon} + \mathcal{L}_{rq} \\ \mathcal{L}_{rq} = \sum_{l=0}^{L} \left( \|sg[\mathbf{r}_l] - \mathbf{e}^l_{z_l}\|^2 + \mu\,\|\mathbf{r}_l - sg[\mathbf{e}^l_{z_l}]\|^2 \right) \end{cases} \tag{5}
是 stop-gradient;第一项拉码字去贴残差(更新码本),第二项拉残差去贴码字(更新 encoder),(沿用 TIGER 设置)平衡二者强度。
模块 C — Contrastive Learning:让梯度穿过量化器(联合训练的核心)
这是本文与两阶段方法真正的分界点。作者在两个位置施加同一形式的 InfoNCE:
\mathcal{L}_{InfoNCE} = -\log \frac{\exp\big(s(h_{query}, p^{+})/\tau\big)}{\sum_{j=1}^{N}\exp\big(s(h_{query}, p^{i})/\tau\big)} \tag{6}
- 为 query 与 product 表征的 cosine 相似度, 为温度。
- 两个位置分别取 (量化前)与 (量化后重构)。
- 正样本 是 query 的相关商品;负样本可用 hard negative 或 in-batch negative(同 batch 其他实例的商品)。
为什么这两处必须都加:
- 加在 上 → 直接把检索目标监督到 embedding 模型,解决「embedding 只由通用预训练目标决定、与检索任务脱节」。
- 加在 上 → 梯度路径是
h_query ← InfoNCE → h_recon ← Decoder ← ẑ ← codebook ← r_l ← encoder,codebook 与 encoder 被同一个检索损失同时更新。这等价于要求「量化后的表征仍然要能被正确的 query 检索到」,是一个远强于单纯重构的约束——它防止量化把与检索相关的信息压掉,也就从根上消除了两阶段的误差累积。
模块 D — Overall Loss
\mathcal{L}_{model} = \mathcal{L}_{RQ\text{-}VAE} + \alpha\,\mathcal{L}_{InfoNCE} + \beta\,\mathcal{L}_{mse} \tag{7}
- 超参:,,。
- 优化器:AdamW,lr = 1e-4。
- 训练数据:2000 万 Alibaba 内部电商商品。
模块 E — LLM Training:两阶段渐进式(Product2Code → Query2Code)
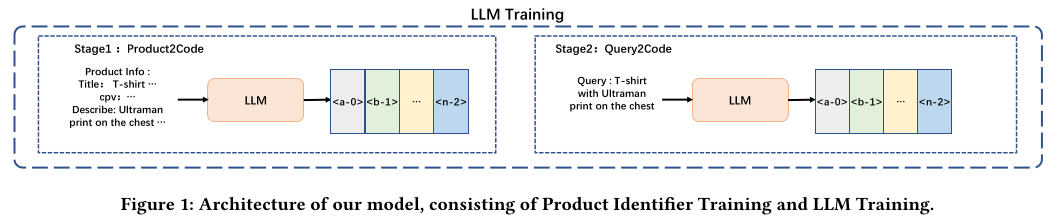
- ID 表示:每个商品拿到形如
[<a-1>,<b-0>,<c-6>,<d-2>]的序列,每个元素是加进词表的新 special token(第 级用字母前缀区分,避免跨级码字混淆)。 - 两阶段渐进的动机:新 special token 对 LLM 完全陌生,直接上 query→ID 会让模型既要学新 token 语义、又要学检索映射,负担过重。
- Stage-1(Product2Code):输入商品信息(title / cpv / description),输出该商品 ID。目的是让 LLM 先把「新 token ↔ 商品语义」这层绑定学扎实。
- Stage-2(Query2Code):输入用户 query,输出商品 ID。真正的检索任务。
- 训练目标(两阶段同形式,标准自回归 CE):
\mathcal{L}_{sft} = -\sum_{t=1}^{T} \log P(y_t \mid y_{<t}, input) \tag{8}
为商品 ID 长度, 是目标 ID 的第 个 token, 在 Stage-1 是商品信息、Stage-2 是用户 query。
- Backbone / 超参:Qwen2.5-7B,lr = 5e-5。
- 数据规模:Stage-1 用 2000 万 product→ID;Stage-2 用 4000 万 query→product ID 映射对。
实验设置与结果
数据
- 训练:Alibaba 内部电商平台 2000 万商品(用于 embedding + codebook 联合训练,以及 LLM Stage-1);4000 万 query→ID 对(LLM Stage-2)。
- 验证 / 测试:各 10,000 条 query,在 regular query 与 implicit-intent query(隐式意图,如「给爱科学的 10 岁小孩的礼物」)之间均匀分布——这个设计是为了专门检验 GR 相对稀疏/稠密检索在复杂意图上的优势。
Baseline
| 类别 | 方法 | 说明 |
|---|---|---|
| 稀疏 | BM25 | TF-IDF 词权重倒排 |
| 稠密 | DPR | 双塔稠密检索,encoder 换成 GTE 以支持长文本(与本文同底座,公平对比) |
| 生成式 | DSI | 用层级 K-means 聚类结果表示文档 ID |
| 生成式 | TIGER | 只对比其 RQ-VAE 组件(即标准两阶段 tokenizer) |
指标
- Recall@K (%):top-K 结果中相关 item 的召回比例。
- ALSP(Average Length of the Shared ID Prefixes):同一同款簇内商品之间共享 ID 前缀的平均长度。 故上限为 5。这个指标直接量化「同款是否被分到语义一致的 ID」,是本文提出的 codebook 质量诊断量。
主结果
| Model | Recall@1 | Recall@10 | Recall@100 | ALSP (max 5) |
|---|---|---|---|---|
| BM25 | 1.23 | 2.66 | 9.80 | — |
| DPR | 3.57 | 7.09 | 24.24 | — |
| DSI | 3.79 | 7.99 | 23.91 | 2.89 |
| TIGER | 4.33 | 8.84 | 26.38 | 3.92 |
| ours | 4.49 | 9.90 | 30.71 | 4.42 |
| ours−cluster(去掉同款约束) | 4.39 | 8.91 | 28.47 | 4.01 |
相对增益换算(论文未列,此处补算便于判断量级):
| 对比 | Recall@1 | Recall@10 | Recall@100 | ALSP |
|---|---|---|---|---|
| ours vs TIGER | +3.7% | +12.0% | +16.4% | +12.8% |
| ours vs ours−cluster(同款约束的净贡献) | +2.3% | +11.1% | +7.9% | +10.2% |
| ours−cluster vs TIGER(纯联合训练的净贡献) | +1.4% | +0.8% | +7.9% | +2.3% |
关键结论
- 对稀疏/稠密的碾压:BM25 R@100 仅 9.80,DPR 24.24,ours 30.71。作者归因于——稀疏靠关键词匹配、稠密受限于正负样本构造且无法调用通用世界知识,两者都处理不好复杂/隐式意图 query(而测试集有一半正是这类)。
- 两阶段的偏差是真实的:DSI 与 TIGER 依赖 item embedding 做聚类/残差量化,会放大 embedding 空间中固有的偏差;且非端到端范式引入信息损失。
ours−cluster vs TIGER这一行隔离出纯联合训练的收益——主要体现在 Recall@100(+7.9%),即联合训练显著改善的是候选覆盖面,对头部精度(R@1 +1.4%)影响有限。 - 同款约束才是主要杠杆:拆解显示 R@10 的 +12.0% 里,绝大部分(+11.1%)来自同款簇约束;ALSP 的 +12.8% 里 +10.2% 来自它。ALSP 从 3.92 → 4.42(满分 5),说明同款商品平均能共享近 4.5/5 级前缀,ID 空间形成了连贯的层级语义结构,从而降低 LLM 后续学 query→ID 映射时的歧义。
- 消融的方向性一致:去掉簇约束后 ALSP 与各项 Recall 同步下降,验证「ID 一致性 ↑ → 检索精度 ↑」这条因果链,而不是两个互不相干的指标各自变好。
思考与可参考价值
批判性看局限
- 4 页短文,实验密度不足: 全部照搬或拍定,没有任何超参敏感性实验。 尤其关键—— 是把商品往簇心收缩的正则, 过大会让簇内商品塌成一点、彻底丧失簇内区分度(同款不同尺码/不同卖家价格带的排序会崩),论文既没扫 也没报告簇内区分度指标。 的选择(5×32)同样无消融。
- 回避了碰撞问题: 码空间装 2000 万商品,装载率约 60%,且同款约束是在主动制造前缀重合,碰撞率只会更高。全文未报告碰撞率、未说明碰撞如何消歧(TIGER 一脉通常加一位去碰撞码),而 ALSP 越高往往意味着碰撞越多——ALSP 与碰撞率是一对需要同时汇报的量,只报前者会让方法看起来偏好。这一点上 SID 碰撞与 item-level 评估 那条线的批评直接适用。
- 推理侧细节缺失:没有 beam width、没有说明是否用 trie/constrained decoding 约束生成到合法 ID 空间、没有延迟与吞吐数据。7B 模型做召回的线上可行性完全没讨论。
- 无线上 A/B、无代码:全部是离线指标,工业价值只能间接推断。
- 数据规模混淆归因:Stage-2 用了 4000 万 query→ID 监督对,这是极重的监督量。方法收益里有多少来自「联合训练 + 同款」、多少来自数据体量,短文没有拆开。
- 绝对数字偏低:Recall@1 = 4.49%。虽然 2000 万候选集下的绝对值低属正常,但也提示 GR 单路目前更适合当召回补充路,而非主路。
- 符号/命名瑕疵:图中标 、正文写 InfoNCE,同一物两名;式 (3)(5) 中 的起止索引在 0-based / 1-based 之间混用;
ours-cluster这个命名(意为「减去 cluster」)极易被误读为「我们的 cluster 版本」。
对电商 / 搜推 / Agent 方向的可借鉴点
- 「同款库」是一个被严重低估的免费监督信号。几乎每个电商平台都维护 SPU / 同款聚合关系(不同卖家的同一 SKU、同商品的多规格),这份数据零成本、覆盖率高、噪声低。把它作为 SID tokenizer 的辅助 loss(簇均值 MSE),是本文性价比最高的一招——实现只有两行,却贡献了大部分增益。同类可迁移的免费结构先验还有:类目树、品牌、店铺、同图(视觉去重簇)。
- ALSP 是可以立刻拿来用的诊断指标。它不需要重训、不需要标注,只要有同款关系表 + 现有 SID,一条 SQL 就能算:统计每个同款簇内两两商品共享 ID 前缀长度的均值。用它来体检现有 SID 系统的语义一致性,比只看 Recall 更能定位「ID 空间是否散乱」这类结构性问题。建议与碰撞率成对汇报,避免优化 ALSP 优化到碰撞爆炸。
- 「量化后表征也要能被 query 检索到」是个通用且廉价的强约束。在 上加 InfoNCE(而不只是重构 MSE),本质是要求量化过程保留任务相关信息而非重构相关信息。任何 emb→codebook 的两阶段管线(包括 SEO 出词的语义码、query 侧 SID、召回向量的 PQ 压缩)都可以直接加这一项,改造成本极低,且能把两阶段变成事实上的联合训练。
- 两阶段渐进式 LLM 训练(Product2Code → Query2Code)值得沿用。给 LLM 引入新 special token 时,先用「内容 → token」把 token 的语义锚定住,再上真正的下游任务,比一步到位稳。这个模式在任何「给 LLM 加新词表」的场景(商品码、类目码、用户码、工具码)都适用。
- 反向提示:联合训练的收益主要在长尾覆盖,不在头部精度。从
ours−cluster vs TIGER看,纯联合训练把 R@100 拉了 7.9% 而 R@1 只有 1.4%。若业务目标是精排前的召回补量,联合训练值得投;若指望它直接提头部命中,预期要放低——头部精度更依赖于 ID 空间的语义一致性(即同款约束这类结构先验)。