Generative Recommender with End-to-End Learnable Item Tokenization (ETEGRec)
Renmin University of China (Gaoling) × Kuaishou Technology
生成式推荐里 item tokenizer(把 item 编成离散 Semantic ID)和 generative recommender(自回归生成 target item 的 SID)历来是「两段式解耦」——tokenizer 预训练完就冻死,对下游推荐目标无感知。ETEGRec 把两者合成一个「双 encoder-decoder」端到端框架,靠两条「面向推荐的对齐损失」把 tokenizer 和 recommender 拧到一起互相增强:(1) Sequence-Item Alignment(SIA)——recommender 编码器的序列状态 z_E 和 target item 协同 embedding z,喂进同一个 tokenizer 应产生相似的码字分布,用对称 KL 对齐;(2) Preference-Semantic Alignment(PSA)——recommender 解码器首个隐状态 h_D(用户偏好)与 RQ-VAE 重构的 target 语义 z̃,用 InfoNCE 对齐。为稳住训练用「交替优化」(每 cycle 先训 1 epoch tokenizer 再冻结训 recommender)。三个 Amazon2023 数据集上全面超过 TIGER/LETTER。这篇正是 UniGRec 里那个第二名 baseline「ETEG-Rec」的原始论文。
核心思路
问题:生成式推荐(TIGER 一脉)= item tokenizer(把 item 语义 embedding 用 RQ-VAE 量化成 L 级离散 Semantic ID)+ generative recommender(T5 式 encoder-decoder,看历史 SID 序列自回归生成下一个 item 的 SID)。但几乎所有工作都把 tokenization 当预处理:tokenizer 先单独训好、导出 item→SID 映射,然后冻死,再训 recommender。这带来两个损失——① tokenizer 对下游推荐目标完全无感知,学出来的 ID 未必是 recommender 最想要的;② recommender 也无法反过来去精炼 tokenizer 里隐含的先验知识。
关键 idea:把 tokenizer 和 recommender 合成一个可联合优化的框架,让两者互相增强(mutual enhancement)。障碍是 RQ-VAE 的 argmax 选码字不可微、且两个部件的训练目标异质、直接联合训不稳。ETEGRec 的解法不是打通梯度(那是后续 UniGRec 的软标识符路线),而是用两条「面向推荐的对齐损失」把两个部件在表征层面拴在一起,再用交替优化稳住训练。这是「alternating + 辅助对齐 loss」范式里做得相当完整的一篇(也是 UniGRec 论文里那个仅次于自己的第二名 baseline「ETEG-Rec」)。
整体实现思路
端到端 pipeline(双 encoder-decoder 架构,见下图):
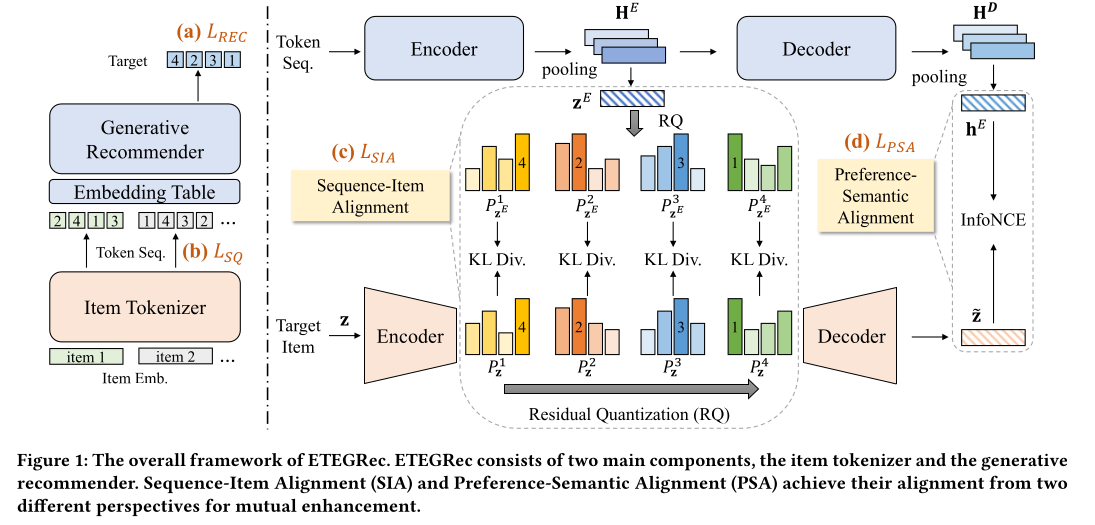
- 输入:每个 item 的协同语义 embedding
z ∈ R^{d_s}(用训好的 SASRec 抽 256 维协同 emb,不是文本 emb)。 - Tokenizer(RQ-VAE):把
z量化成 L 级 token[c_1..c_L],同时得到重构z̃。 - Recommender(T5 式):历史序列的 token 序列
X过编码器得H^E,解码器自回归生成 target item 的 tokenY。 - 两条对齐损失把 tokenizer 和 recommender 的中间表征拴住(SIA 在编码器侧、PSA 在解码器侧)。
- 交替优化:一个 cycle 内先只训 tokenizer 1 epoch、再冻结 tokenizer 训 recommender C−1 epoch,循环到收敛后永久冻结 tokenizer 再把 recommender 训到底。
- 输出:beam search 生成 target item 的 SID。推理复杂度与 TIGER 完全一致(token 可预先缓存)。
子模块实现(可复现细节)
模块 A — Item Tokenizer(RQ-VAE)
- 输入/输出:输入协同语义 emb
z(SASRec 出的 256 维),输出 L 级 token[c_1..c_L]+ 重构z̃。 - 量化流程:MLP 编码器
r = Encoder_T(z);逐级残差量化,第 l 级v_1=r,c_l = argmax_k P(k|v_l),残差更新v_l = v_{l-1} − e_{c_{l-1}}^{l-1};分配概率P(k|v_l) = softmax(−‖v_l − e_k^l‖²)(对 K 个码字)。聚合r̃ = Σ_l e_{c_l}^l,MLP 解码器重构z̃ = Decoder_T(r̃)。 - loss:语义量化损失
L_SQ = L_RECON + L_RQ,其中L_RECON = ‖z − z̃‖²,L_RQ = Σ_l ‖sg[v_l] − e_{c_l}^l‖² + β‖v_l − sg[e_{c_l}^l]‖²(β=0.25,sg=stop-gradient)。 - 维度/超参:L=3 层码本,每层 K=256 码字、码字维 128;编解码器各 3 层 MLP;额外追加一个 token 保证 item ID 唯一(同 TIGER)。
模块 B — Generative Recommender(T5 式 encoder-decoder)
- 输入/输出:历史 token 序列
X=[c_1^1..c_L^{t}]→ 编码H^E = Encoder_R(E_X);解码器输入加[BOS],H^D = Decoder_R(H^E, Ỹ),逐 token 生成 target。 - loss:
L_REC = −Σ_j log P(Y_j | X, Y_{<j})(seq2seq NLL)。 - 维度/超参:T5 6 层 encoder + 6 层 decoder;hidden 128、FFN 512、4 头每头 64 维;beam size 20。
模块 C — Sequence-Item Alignment(SIA,编码器侧对齐)
- 假设:编码器序列状态
H^E(编码整段历史)应与 target item 的协同 embz高度相关——把两者分别喂进同一个 tokenizer 应产生相似的码字分布。 - 做法:先
z_E = MLP(mean_pool(H^E));对z(target 协同 emb)和z_E(序列状态)各用 tokenizer 出每级码字分布P_z^l与P_{z_E}^l;用对称 KL 对齐:L_SIA = −Σ_l [ D_KL(P_z^l ‖ P_{z_E}^l) + D_KL(P_{z_E}^l ‖ P_z^l) ] - 额外好处:缓解「decoder 绕过 encoder(seldom use encoder info)」导致编码器训不好的问题,增强序列表征。
模块 D — Preference-Semantic Alignment(PSA,解码器侧对齐)
- 假设:解码器首个隐状态
h_D(H^D第一列,反映序列用户偏好)应与 RQ-VAE 重构的 target 语义z̃(编码 target 协同语义)关联。用重构z̃(而非原始 z)是关键——这样对齐 loss 自然把 tokenizer 也拉进优化。 - 做法:InfoNCE + in-batch 负样本,双向对齐
h_D(过 MLP)与z̃:L_PSA = −[ log softmax_sim(z̃, h_D) + log softmax_sim(h_D, z̃) ],s(·,·)=余弦相似度、温度 τ。 - 定位:可视为
L_REC的增强——L_REC用 target 的 token,PSA 用重构协同 emb,把 tokenizer 卷进训练。
模块 E — Alternating Optimization(交替优化,稳训练的关键)
- 动机:直接把所有 loss 一起联合训会不稳(tokenizer 频繁更新会扰乱 recommender)。
- 两组目标:训 tokenizer 时冻 recommender,
L_IT = L_SQ + μL_SIA + λL_PSA;训 recommender 时冻 tokenizer,L_GR = L_REC + μL_SIA + λL_PSA。 - 调度:分 cycle,每 cycle 第 1 epoch 训 tokenizer、其余 C−1 epoch 冻 tokenizer 训 recommender;重复到 tokenizer 收敛后永久冻结、再把 recommender 训到底。C 在 {2,4} 里调;tokenizer lr∈{5e-4,1e-4,5e-5}、recommender lr∈{5e-3,3e-3,1e-3};μ,λ∈{5e-3..1e-4}。
- 复杂度:训练
O(NLKd + N²d + Nd² + Md),与 TIGER/LETTER 同量级;推理与 TIGER 完全一致(token 可缓存)。
实验设置与结果
- 数据:Amazon 2023 的 Instrument / Scientific / Game 三个子集,5-core 过滤,序列截断 50,leave-one-out 划分。
- Baseline:传统序列(Caser/GRU4Rec/HGN/SASRec/BERT4Rec/FMLP-Rec/FDSA/S³Rec)+ 生成式(SID/CID/TIGER/TIGER-SAS/LETTER)。
- 指标:Recall@5/10、NDCG@5/10,全量排序(不采样负例),beam=20。
主结果(Recall@10 / NDCG@10,节选,ETEGRec 全部 SOTA 且 p<0.01 显著):
| 数据集 | 指标 | TIGER | LETTER(次优) | ETEGRec |
|---|---|---|---|---|
| Instrument | Recall@10 | 0.0574 | 0.0581 | 0.0624 |
| Instrument | NDCG@10 | 0.0308 | 0.0310 | 0.0331 |
| Scientific | Recall@10 | 0.0431 | 0.0433 | 0.0455 |
| Game | Recall@10 | 0.0895 | 0.0901 | 0.0947 |
| Game | NDCG@10 | 0.0471 | 0.0475 | 0.0507 |
→ 相对 LETTER(第二名)Recall@10 提升约 +5~7%,相对 TIGER 更大。
消融(Recall@10):
| 变体 | Instrument | Scientific | Game | 说明 |
|---|---|---|---|---|
| ETEGRec(全) | 0.0624 | 0.0455 | 0.0947 | — |
| w/o L_SIA | 0.0614 | 0.0446 | 0.0917 | 去序列-item 对齐,掉点 |
| w/o L_PSA | 0.0609 | 0.0422 | 0.0933 | 去偏好-语义对齐,掉点 |
| w/o 两个对齐 | 0.0601 | 0.0422 | 0.0894 | 两个都去更差 |
| w/o AT(交替训练) | 0.0529 | 0.0375 | 0.0810 | 掉最多,直接联合训不稳 |
| w/o ETE(用最终 token 重训) | 0.0600 | 0.0431 | 0.0899 | 增益不只来自好 ID,还来自集成 |
关键结论:① 交替优化(AT)是最关键的稳定器——去掉它掉点最大(Instrument 0.0624→0.0529),说明频繁更新 tokenizer 会扰乱 recommender;② w/o ETE(拿 ETEGRec 最终 token 去重新训一个纯 recommender)仍不如全量——证明增益不只来自更好的 item ID,也来自端到端集成本身(tokenizer 先验被 recommender 精炼);③ 两条对齐损失各自有效、组合最好;④ 泛化性:在 unseen 新用户上也超过 TIGER/LETTER。
思考与可参考价值
局限:① 相对第二名 LETTER 的领先是个位数百分比(Recall@10 +5~7%),且大头增益其实来自「交替训练稳住 + 集成」而非某个单点巧思;② 只在万级 item 的 Amazon 子集验证,没碰生成式推荐真正该证明的百万级 item 扩展性(Kuaishou 作为工业方却未给线上/大规模结果);③ tokenizer 输入用的是 SASRec 协同 emb,协同先验的质量强绑定这个外部老师;④ 本质仍是「alternating + argmax 不可微」,tokenizer 与 recommender 没有真正的梯度直连——这正是后续 UniGRec 用「软标识符」要补的点(把 argmax 换成温度 softmax 打通梯度,实现真·端到端;ETEGRec 在 UniGRec 里作为第二名 baseline 出现)。
对电商 / 搜推 / Agent 方向的可借鉴点:
- 「面向下游目标对齐 tokenizer」这个范式直接可用:如果你在跑生成式召回(商品 SID),与其把 tokenizer 冻死,不如加一条「让 tokenizer 的码字分布贴近 recommender 编码的序列/target 表征」的对齐 loss(SIA 那套对称 KL),低成本地让 ID 更贴推荐目标。
- 交替优化 > 硬联合这个工程经验很有参考价值——两个异质部件(tokenizer/recommender、或检索器/生成器)联合训不稳时,cycle 内交替冻结比一锅端联合更稳,消融里这是最大杠杆。
- PSA 用「重构 emb」而非「原始 emb」对齐是个精巧设计——想把某个「被冻的上游模块」卷进端到端训练时,对齐它的输出/重构而非输入,能自然让梯度流回上游。这个技巧可迁移到任何「上游特征提取器 + 下游任务头」的联合优化。
- w/o ETE 消融的方法论值得学:想证明「增益来自集成而非只是更好的中间产物」,就把中间产物(这里是最终 token)拆出来单独重训下游,对比差距——这是区分「表征质量」与「联合优化」贡献的干净实验设计。