Beyond Semantic IDs: Encoding Business-Value Ranking into Document Identifiers for Generative Retrieval
Taobao & Tmall Group of Alibaba (阿里淘天)
现有生成式检索的 DocID/Semantic ID 纯粹从语义 embedding 量化而来,存在两个硬伤:(1) 碰撞——多个 item 映射到同一 DocID,300M 大库尤其严重;(2) 目标错位——DocID 的编码目标是「语义重建」,而系统真正优化的是「业务转化」,同一语义簇里转化率差几个数量级的 item 却拿到相邻甚至相同的 ID。CRID 的做法极简:把 DocID 拆成「语义簇前缀 + 簇内业务价值序号」两段,最后一级 codebook 不再做语义量化,而是让簇内 item 按 30 天转化数排序、用序号(ordinal rank)当最后一个 token。这一处改动同时解决碰撞(每个 rank 唯一对应一个 item,构造上无碰撞)和目标错位(DocID 结构直接对齐业务指标),且新品增量更新只需簇内重排、无需重训码本。更关键的是论文给了一套「个性化偏好 vs 统计先验」的增益分解分析框架,解释了为什么序号编码有效、以及语义簇大小如何在两者间权衡——这套框架直接指导了生产 codebook 选型。淘宝 300M 大库上 top-K Hitrate 全面超越最强 EBR,全流量部署 +1.06% GMV。
核心思路
一句话问题:生成式检索(Generative Retrieval, GR)把「检索」变成「自回归生成 DocID」,DocID 设计直接决定检索质量。但现有 DocID(就是 Semantic ID)纯粹从语义 embedding 量化出来,有两个绕不过去的硬伤:
- 碰撞(collision):RQ-KMeans / RQ-VAE 这类离散化方法,多个 item 会被分到同一个 DocID。在淘宝 300M item 的大库里尤其严重——一个 DocID 对应一堆 item,生成到这个 ID 也没法区分是哪个。
- 目标错位(objective mismatch):DocID 的编码目标是语义重建(把 embedding 尽量无损地压成离散码),而系统真正要优化的是业务转化(GMV / 转化率)。同一个语义簇里,两个 item 的转化率可能差几个数量级,但纯语义量化会给它们相邻甚至相同的 DocID。业务信号在 EBR(embedding-based retrieval,向量召回)里靠 CTR/CVR 特征天然吸收了,但在 DocID 里完全缺失。
作者的关键论断:在容量受限(0.5B 模型、延迟约束)下,瓶颈不是模型容量,而是这个目标错位。
关键 idea(CRID = Cluster-Ranked Identifier):把 DocID 拆成两段——语义簇前缀(semantic cluster prefix)+ 簇内业务价值序号(business-value rank)。前 L-1 级还是老老实实做语义聚类(抓 query 级的粗粒度相关性),最后一级 codebook 不再做语义量化,而是让簇内所有 item 按某个业务价值统计量(默认 30 天转化数)从高到低排序,把这个「序号」当作最后一个 DocID token。
一个「刻意做得很简单」的改动,同时拿下两件事:
- 构造上无碰撞:簇内每个 rank 唯一对应一个 item(rank 0 就是这个簇里转化最高的那个),一对一映射。
- 目标对齐:DocID 的最后一级结构直接就是业务指标的排序,GR 模型学的是「生成高价值 item」而不是「生成某个语义类别」。
而且序号是有序的(ordinal),不是无序的类别桶——这让自回归模型能对「相对 item 质量」做泛化(rank 5 比 rank 50 好),而不是死记硬背离散类别标签。这一点是 CRID 和 GR4AD / UniVA 那类「把业务属性 hash/bin 成无序桶」方法的本质区别。
整体实现思路
问题形式化:给定 query 和用户历史行为序列 ,GR 把检索建模成自回归生成。每个 item 分配一个 DocID , 是码本级数。GR 模型(参数 )自回归生成:
推理时用受约束的 beam search(constrained beam search)沿 codebook trie 解码出一个排序的候选 DocID 列表。
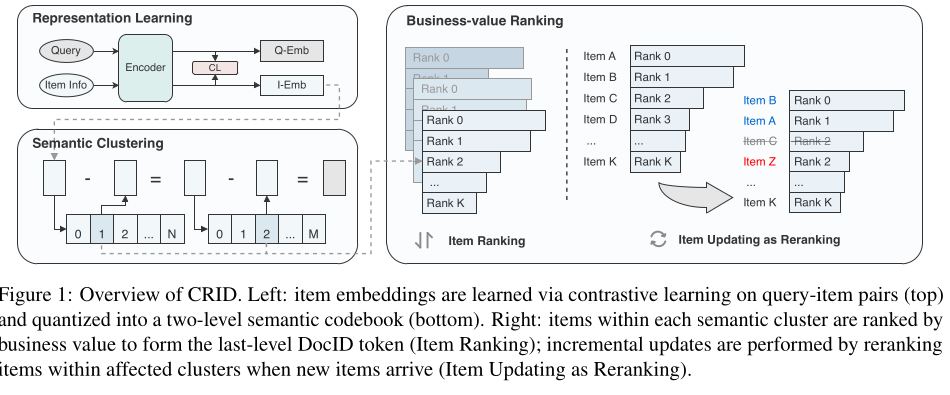
CRID 的核心分解:把 DocID 拆成语义簇前缀 和簇内业务价值序号 。对候选 item ,生成概率因式分解为:
第一项是语义簇选择(粗粒度语义召回),第二项是簇内排序(业务价值细分)。这个分解不只是记号——它对应了后面 §分析 里两个增益机制的严格拆分。
端到端 pipeline:
- 表征学习:query-item 对比学习 → 256 维 item embedding;
- 语义聚类:RQ-KMeans 把 embedding 量化成前 L-1 级语义码(论文主实验用 8192×8192 两级);
- 业务价值排序:每个语义簇内 item 按 30 天转化数排序,序号当第 L 级 token;
- GR 训练:DocID memorization(记住 item→DocID 映射)+ SFT(+ 生产版加 DPO);
- 推理:动态 beam size 的受约束解码,召回 ~1300 item 进精排;
- 增量更新:新品按 embedding 距离归入最近语义簇,每天按更新后的业务统计做簇内重排,不重训码本。
子模块实现(可复现细节)
模块 A — 表征学习(Representation Learning)
- 输入/输出:query-item 对 → 256 维共享编码器 item embedding。
- 数据构造:从淘宝搜索场景收集约 100M query-item 对,用相关性模型过滤。
- 训练:对比学习(CPC 式,Oord et al. 2018),in-batch negatives,128 GPU、每 GPU batch size 256。
- 关键点:因为搜索场景里 query 提供了强语义锚点,天然约束了检索空间,所以语义簇只需抓 query 级粗粒度即可,细粒度区分完全交给业务价值序号。这是 CRID「为什么在搜索里 work」的前提之一。
模块 B — 语义聚类(Semantic Clustering)
- 输入/输出:256 维 embedding → 前 L-1 级离散语义码。
- 方法:CRID 与离散化方案完全解耦,主实验直接用标准 RQ-KMeans(不需要特殊设计)。采样 100M 样本,跑 hierarchical mini-batch KMeans,batch size 4M,3 epoch。
- 配置:主实验 8192 × 8192 两级;生产部署 32768 × 8192(第一级词表更大 → 平均簇更小 → 利好 top-K,见 §分析)。
- 为什么只用三级码本:额外量化级会累积离散化误差,所以刻意限制在 3 级(2 级语义 + 1 级业务序号)。
模块 C — 业务价值排序(Business-Value Ranking,本文核心)
- 输入/输出:一个语义簇内的 item 集合 → 每个 item 一个序号 rank,作为最后一级 DocID token。
- 排序信号:默认 30 天累积转化数(conversion count);论文验证也可用点击数(click)或内部业务模型预测的质量分(score)。
- 码本结构:所有语义簇共享同一个 rank codebook(rank 0 / rank 1 / …),即「rank 5」这个 token 在所有簇里是同一个 vocab id。这让模型学的是跨簇通用的「相对质量」概念。
- 两个关键性质:
- 构造上无碰撞:簇内每个 rank 唯一对应一个 item,消除碰撞;
- 增量更新:新品按 embedding 距离归入最近簇,按更新后的业务统计簇内重排,每天调度一次,不重训码本。
- 和无序桶方法的本质区别:GR4AD(把业务属性 hash)、UniVA(classify-then-bin 分桶)虽然也在最后一级编业务信号,但它们是无序类别桶,既不能保证无碰撞、属性定义变了还得重建;CRID 用单一业务统计量的序号,保留了 item 间的数值序,让自回归模型能泛化「相对质量」。
模块 D — 训练 pipeline
- 两阶段:① DocID memorization——从 item 特征预测 DocID 序列,warm up 新增的 DocID 词表;② SFT——从 (query, history) 生成 target item 的 DocID。
- 消融用小规模:40M 样本子集(论文说这个规模已基本收敛,能反映方法间相对差异,继续加数据无 ranking inversion)。
- 生产版:SFT 用 150M+ 样本,再加一个 DPO 阶段(1M query × 平均 10 个 response pair)。DPO 带来约 +0.5pp 的 offline in-search HR@1000。
- backbone 全程 Qwen2.5-0.5B(受在线延迟约束)。
模块 E — 动态 Beam Size 校准(部署关键工程)
- 问题:三级码本,不同解码阶段的候选概率分布形状不同——早期阶段概率集中在少数候选,后期阶段摊到长尾。用统一 beam size 会在早期浪费、后期不够。
- 方法:在 MaxLen=3 曲线的 rank 1000 处定一个概率 cutoff,看 MaxLen=1 / MaxLen=2 曲线跌破这个 cutoff 的 rank(约 78 和 318),作为各阶段需要的有效 beam 宽度。
- 落地 beam size:校准出 ~80 / ~320 / 1000,生产上取整加安全余量 → 100 / 400 / 1500(三个解码阶段)。最后一级去掉 trie 约束(省 prefix-tree 内存),beam 上限 10000。
- 效果:召回 ~1300 item 进精排,满足与现有召回通道相同的延迟要求。
实验设置与结果
- 数据:淘宝电商搜索 300M item 大库,backbone Qwen2.5-0.5B。
- 指标:item 级 Hitrate@K(HR@K)——ground-truth item 是否出现在 top-K。区分 top-K Hitrate(HR@20)和 deep-K Hitrate(HR@1000)。评测样本含 in-search(搜索内转化)和 out-of-search(同品类但搜索外转化)两类。
主结果:CRID vs 各种第三级 codebook 策略
所有方法共享前两级 8192×8192 语义聚类,只换第三级策略:
| 第三级策略 | 无碰撞 | in HR@20 | in HR@100 | in HR@500 | in HR@1000 |
|---|---|---|---|---|---|
| 8192³(纯 RQ-KMeans) | N | 16.68% | 33.73% | 55.01% | 63.83% |
| w/ OPQ | N | 20.86% | 39.02% | 59.86% | 67.54% |
| w/ SK(Sinkhorn 均衡) | N | 24.45% | 44.00% | 63.16% | 69.90% |
| w/ Tiger(单调递增随机 ID) | Y | 37.48% | 51.83% | 66.44% | 73.15% |
| w/ FORGE(最多 5 item/DocID) | N | 37.28% | 51.60% | 66.29% | 72.50% |
| w/ CRID | Y | 41.20% | 59.02% | 76.22% | 82.25% |
CRID 全面最优。相比最强 baseline,in-search HR@20 +3.72pp、HR@1000 +9.10pp。
关键消融
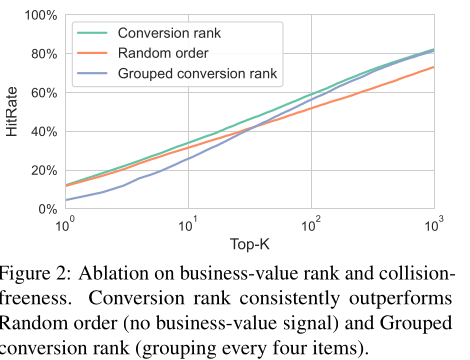
① 业务价值 + 无碰撞是互补的(Fig.2):把 Conversion rank 换成 Random order(无业务信号)或 Grouped rank(每 4 个 item 合成一个 DocID 模拟轻度碰撞)。结论——Random order 主要伤 deep-K(业务价值主要贡献 deep-K Hitrate),Grouped 主要伤 top-K(无碰撞对 top-K 更关键)。两个性质缺一不可。
② 对业务价值定义鲁棒:Conversion rank / Click rank / Score rank 三种信号下 Hitrate 差异很小,尽管它们两两 Spearman ρ 只有 0.6~0.7(中等相关)。说明 GR 模型对具体用哪个业务信号排序不敏感——只要是个合理的业务序就行。
| 排序信号 | HR@20 | HR@100 | HR@500 | HR@1000 |
|---|---|---|---|---|
| Conv.-rank | 41.20% | 59.02% | 76.22% | 82.25% |
| Click-rank | 40.80% | 58.30% | 75.73% | 81.81% |
| Score-rank | 41.15% | 59.34% | 76.21% | 81.82% |
③ 增量更新(训练截止 10 天后评测):
| 策略 | 池覆盖率 | 平均 item/CRID | HR@20 | HR@1000 |
|---|---|---|---|---|
| No update(冻结码本) | 65.08% | 1.00 | 37.86% | 77.52% |
| Insert only(新品塞最近 rank 位) | 99.15% | 6.31 | 29.13% | 70.44% |
| Full rerank(簇内全重排) | 99.37% | 1.00 | 39.12% | 80.05% |
Insert only 虽然覆盖率高但平均 6.31 item/DocID,等于把碰撞又引回来了,Hitrate 大跌;Full rerank 保持无碰撞(1.00)且覆盖率最高、Hitrate 最好,甚至超过 No update(因为冻结码本会随 item 下架而 DocID 路径失效,可召回集缩水)。这验证了「簇内重排」增量方案的必要性。
增益分解分析框架(论文最有价值的部分)
作者把 CRID 的增益归因到两个互补机制:个性化偏好泛化(利用用户历史序列模式)和统计先验泛化(从语料级业务价值统计泛化)。用两个维度分层验证:
Prefix N-gram Hitrate(Fig.4):CRID 和 FORGE 的 1-gram、2-gram(前两级语义)几乎重合,差距完全出现在 3-gram(全路径)级别——CRID 82% vs FORGE 72%(K=1000)。说明在容量受限下,统计先验泛化缓解了最后一级瓶颈,收益大于做更精细的语义区分。
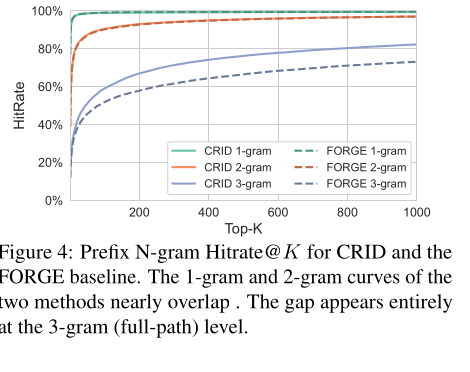
分析方法:把每组 Hitrate 曲线拟合成 log K 上的 logistic CDF(多数组 R²>0.99),求导得到「命中密度」PDF,用均值 μ(K)(越小越好,代表最优召回深度/sweet spot)和 σ(log K)(离散度)刻画。结果:CRID 对 top-ranked item(rank 0–10)的 μ(K) 远低于 FORGE,且 σ(log K) 全面更小——业务价值排序把命中集中到更浅的召回深度、且更集中。而且 CRID 的 μ(K) 沿 rank 轴单调递增(rank 越高召回越浅),FORGE 没有这种结构——序号编码建立了一个有序的检索结构。
语义簇大小的权衡(Fig.5,直接指导生产选型):直觉是「大簇 → 更多 item 可排 → 统计先验更强 → 更好」,但实际有一个**组合漂移(composition shift)**在对冲:
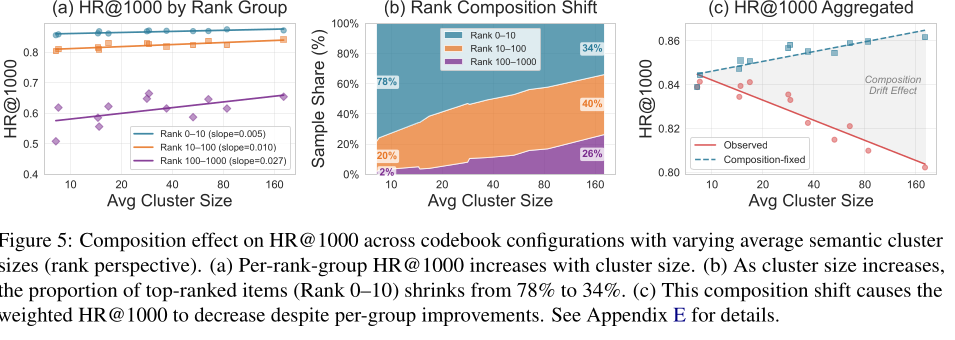
- 从 rank 视角:簇越大,每个 rank 组的 HR@1000 都升(更多 item 可排,统计先验更强);
- 但簇越大,top-ranked item(rank 0–10)的样本占比从 78% 掉到 34%(被稀释),加权后整体 HR@1000 反而降;
- 两个视角的力互相对冲(小簇利 top-ranked 占比但弱化每组先验;也利每组 prefix Hitrate 但推样本向弱 prefix 组),不存在普适最优簇大小。
- 实操指导:生产按「目标 HR@1000 最优」选出 32768 × 8192 码本(第一级更大 → 平均簇更小 → 利 top-K;rank range 8192 给未来扩池留 headroom)。这套分析框架真正落地指导了生产 codebook 选型,不是纸上分析。
线上部署
GR 模型作为额外召回通道与现有 EBR 并行,统一召回+粗排。1% 流量 A/B 跑 30 天:+0.18% IPV、+0.54% 订单数、+1.06% GMV,已推全量。offline 对比最强个性化 EBR:in-search top-K 大涨(HR@20 +13.26%)但 deep-K 略降;out-of-search 全程一致正向(HR@20 +8.00%、HR@1000 +2.66%),说明 CRID 提供了超出现有召回链路的互补召回,泛化优于 EBR。
思考与可参考价值
局限(论文自己列的 + 我补充的)
- 只在淘宝搜索验证:CRID 强依赖「query 提供强语义锚点」这个前提。推荐场景 query 语义弱、簇内区分更依赖个性化,CRID 是否还 work 未验证——这是最大的开放问题。论文自己也把「推荐场景有效性」列为 future work。
- 冷启动偏置:业务价值序号依赖历史统计,新品统计不足会拿到次优 rank,降低被召回概率,形成「越没曝光越排后、越排后越没曝光」的马太效应,直到统计积累够。对上新频繁的电商是真实痛点。
- 单一业务信号:目前只用一个业务统计量排序,如何把 CVR/CTR/预测分融合成统一序号是开放方向(Table 3 只是分别验证,没做融合)。
- 只在 0.5B 模型上验证:CRID 的动机是「容量受限下目标错位是瓶颈」。模型放大后 capacity-corpus 平衡会变,CRID 的相对收益可能被稀释——大模型下是否还需要这个 trick 未知。
- out-of-search 涨、in-search deep-K 略降:说明 CRID 的收益结构是「用 deep-K 换 top-K + 互补召回」,不是纯增量,配精排时要注意召回集特性。
对电商 / 搜推的可借鉴点
- 「DocID 目标错位」这个 framing 值得内化:任何做生成式召回/检索的团队都该问一句——你的 Semantic ID 编的是语义重建目标,但你线上优化的是转化,这两者对齐了吗?CRID 的答案是把最后一级 codebook 从「语义量化」换成「业务价值序号」,这个改动极简但直击要害,几乎是零成本可试的(前几级语义码本完全不动,只改最后一级)。
- ordinal rank > 无序桶:如果要把业务信号编进 DocID,用有序序号而不是 hash/bin 成无序类别桶。有序性让自回归模型能对「相对质量」泛化(这也是 CRID 打败 GR4AD/UniVA 的关键)。对我们做生成式召回,这意味着码本设计时该优先考虑「能否保留数值序」。
- 无碰撞 + 增量重排的工程范式:簇内序号天然无碰撞;新品「归最近簇 + 簇内重排、不重训码本」是一个可以直接抄的增量更新方案,解决了 Semantic ID 类方法上新就得重建码本的老大难。注意 Insert-only(塞最近 rank 位)会重新引入碰撞,必须做 Full rerank。
- 增益分解分析框架可迁移:「把 Hitrate 曲线拟合成 logistic CDF、求导得命中密度、用 μ(K)/σ 刻画召回深度分布」是一套通用的召回诊断工具,可以用来分析任何分层 DocID 方案「收益来自个性化还是统计先验」、以及 codebook 配置怎么选——这比只看一个 HR@K 数字信息量大得多。
- 语义簇大小无普适最优、需按目标指标反推:如果你也在调 codebook 配置,别盲目信「大簇更好」——存在组合漂移对冲。按你真正关心的指标(top-K 还是 deep-K)用这套框架反推簇大小。生产选 32768×8192(大第一级=小平均簇)是为了利 top-K,这个取舍逻辑可直接参考。
- business-value 信号鲁棒是个好消息:Table 3 说明不必纠结用 CVR 还是 CTR 还是预测分,GR 对具体信号不敏感,工程上选最稳、最好统计的那个即可。