ChronoID: Infusing Explicit Temporal Signals into Semantic IDs for Generative Recommendation
University of Rochester × Meta MRS × MBZUAI
现有生成式推荐的 Semantic ID 是「时间无关」的——同一个 item 无论在什么时间点被交互,都量化成同一个 SID,时间只在 session 构造、序列 position 上隐式起作用,从未进入「语义抽象层(tokenization)」。ChronoID 把时间当成一等公民直接注入 SID 学习:先把 interaction 的时间戳编码成时间 embedding,再和 item 文本 embedding 融合、量化成离散 SID 喂给 LLM 做 SFT。论文系统性地把「时间入 SID」的设计空间拆成三个正交维度——(1) 时间编码用绝对时间戳 vs 相对时间间隔;(2) 融合顺序 early(先融合再量化)vs late(先各自量化再拼 ID);(3) 量化器结构 residual(RQ-VAE 层级)vs parallel(多独立码本)——并配一个「时间显式、无未来信息泄漏」的新 benchmark,回答 what/how/where 三个问题:相对时间 > 绝对时间、parallel 量化 + 相对时间是最优组合,在 Amazon Industrial 上 HR@3 相对 MiniOneRec 提升 36.1%。
核心思路
问题:生成式推荐(OneRec / MiniOneRec / TIGER 这一支)把推荐重构成「在离散 Semantic ID(SID) 词表上做序列生成」。但 SID 是用 RQ-VAE 对 item 的文本 embedding 做向量量化得到的——完全 time-agnostic。时间信号只在两个地方隐式出现:① session 构造 / 采样启发式;② 序列顺序 + 相对位置编码。结果是:同一个 item 在完全不同的时间语境下(比如夏天买防晒 vs 冬天买防晒)被映射到同一个 SID,隐含假设「item 语义与用户意图是时间平稳的」,这与真实电商里不断演化的交互节奏不符。
关键 idea:把时间当成学习 SID 的一等公民,让它直接进入 tokenization 层。ChronoID 不是提一个单一模型,而是提一个统一框架 + 设计空间——沿三个正交维度(时间编码 / 融合顺序 / 量化结构)系统性地探清「时间到底该在语义抽象的哪一步、以什么形式进入」,并配一个杜绝未来信息泄漏的时间显式 benchmark 来公平回答这个问题。
整体实现思路
端到端 pipeline 分两大阶段(沿用 MiniOneRec 范式):
- 码本训练(离线):对每个 (user, item, timestamp) 交互,① 用预训练 LLM 抽 item 文本 embedding
e_text ∈ R^2560(Qwen3-Embedding-4B);② 把时间戳用 sinusoidal 编码成e_time ∈ R^768;③ 按某种「融合策略 + 量化器」把两者压成一个离散 SID(如 3 个 codebook token)。码本在时间截断点之前的数据上训练。 - SFT + 推理:把用户历史交互序列翻译成 SID 序列,喂给 LLM 自回归地预测下一个 item 的 target SID(leave-one-out,next-item generation)。
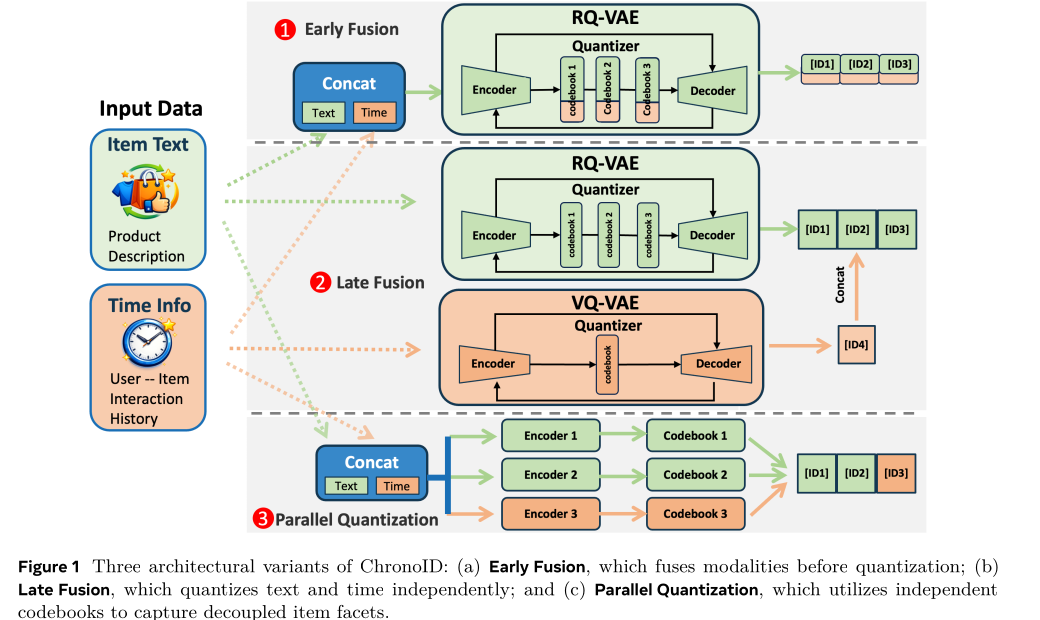
框架的三个设计维度正是「② 时间怎么编码、③ 怎么融合、怎么量化」这一步的三个正交选择:
子模块实现(可复现细节)
维度 I — 时间编码(Time Embedding)
时间戳先经典 sinusoidal 位置编码成 d=768 维向量,h_t[2i]=sin(t/10000^{2i/d}), h_t[2i+1]=cos(t/10000^{2i/d})。输入选什么时间是关键分歧:
- Choice 1 · 绝对时间
t_{u,i}:直接用 UNIX 时间戳。捕捉全局季节性/趋势;sinusoidal 的内积天然反映两事件时间跨度。 - Choice 2 · 相对时间
Δt_{u,i} = t_{u,i} − t_{u,i-1}(本文力荐):用户相邻两次交互的时间间隔(首次交互Δt_{u,1}=t_{u,1})。理由:时间 embedding 后续会被量化成离散 SID 再喂给生成模型,中间不再有两个 sinusoidal embedding 的显式内积,绝对时间那套「内积=时间跨度」的性质失效;而且绝对时间戳单调递增、永不重复,天然有 distribution shift(训练见过的时间戳测试时不再出现)。相对时间间隔可复现、可泛化,直接把「交互节奏」(浏览→下单的 gap、即时复购 vs 周期性更换)编码进 SID。
| i | UNIX 时间戳 t_{u,i} | 绝对时间 | 相对时间 Δt_{u,i} |
|---|---|---|---|
| 1 | 100 | 100 | 100 |
| 2 | 115 | 115 | 15 |
| 3 | 120 | 120 | 5 |
维度 II — 融合顺序(Fusion Strategy)
item 文本 embedding h_item 与时间 embedding h_t 在「量化前」还是「量化后」结合:
- Early Fusion(fuse-then-quantize):先拼接
h = [h_item ‖ h_t],整体过一个量化器Q,SID = Q(h)。 - Late Fusion(quantize-then-fuse):文本、时间各过一个独立量化器,
ID_item = Q_item(h_item)、ID_time = Q_time(h_t),再在 ID 级拼接SID = [ID_item ‖ ID_time]。论文分析:文本语义与时间信号处于高度异质的特征空间,early fusion 强行把两个分布塞进一个码本容易 collapse,late fusion 让两个模态各自保留信息 → 表格里 late 系统性优于 early。
⚠️ 论文内部有个小张力:RQ3(表 1)结论是「late > early」,但全局最优组合却是 Parallel Quantization + 相对时间,而 parallel 量化的输入恰恰是 early-fused 的
h=[h_item‖h_t](见下);结论段又写成「relative time + early fusion + parallel quantization」。复现时以表 1 数字为准:最优行是 Parallel Quantization / Relative Time。
维度 III — 量化器结构(Quantization Mechanism)
- Residual 量化(RQ-VAE):K 个码本
{C_1..C_K}串行学习,第 k 层量化前 k−1 层的残差:ĥ = Σ_k c_{k,z_k},z_k = argmin_j ‖r_{k-1} − c_{k,j}‖²。K=1 时退化成 VQ-VAE。适合层级 coarse-to-fine 语义。 - Parallel 量化(TokenRec 那一支):K 个独立编码器+码本并行量化同一输入,
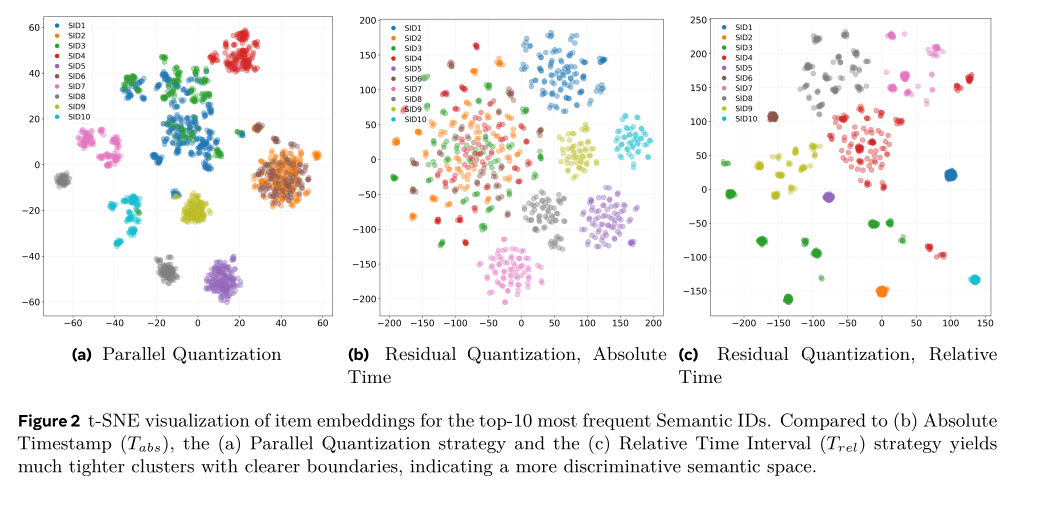
z_k = argmin_j ‖h − c_{k,j}‖²,SID=(z_1..z_K)。不同码本捕捉 item 的解耦 facet。ChronoID 里 parallel 量化的输入是 early-fusedh=[h_item‖h_t]。论文观点:时间与文本是并列的异质 facet 而非层级关系,residual 的「后层建模前层残差」的刚性约束会让后面的码本去拟合前一模态漏下的噪声;parallel 天然解耦、避免误差传播,量化出的 SID 对两个模态都更有信息量。t-SNE 也印证:parallel / 相对时间的簇更紧、边界更清。
时间显式 Benchmark(防未来泄漏)
现有生成式推荐 benchmark 都是「时间隐式」的。本文在 Amazon Industrial / Office(B2C)+ Mercari(C2C)上,用一个全局固定时间截断(如 2018-01-01)严格切分,防 look-ahead bias,三个阶段都遵守:① 码本训练只用截断前的交互学 item 表征;② SFT 训练每个 (历史序列, target item) 的 target 时间戳严格早于截断;③ SFT 测试 target 全在截断当天或之后。因此一个交互全在截断前的用户只进训练集,首次交互在截断后的用户只进测试集——天然支持 cold-start / 新品 与 continual SID 演化 的研究。量化器输入是 x_i=[e_text^{(i)} ‖ e_time^{(i)}] ∈ R^{3328}(2560+768)。
实验设置与结果
- 数据:Amazon Industrial(时间切分后 39,636 items)、Amazon Office(436,775 items)、Mercari。
- Baselines:SASRec、ActionPiece、HSTU、MiniOneRec、TokenRec。
- 指标:leave-one-out 下的 HR@K / NDCG@K(K=3/5/10)。
- 关键超参:文本 emb 2560 维、时间 emb 768 维、codebook 数 M=3、每码本 256 codes、code 维 42;码本训练 10,000 epoch、lr 3e-4;SFT 10 epoch、AdamW。
RQ1 主结果(HR@3 / NDCG@3,节选):
| Dataset | 方法 | 配置 | HR@3 | NDCG@3 |
|---|---|---|---|---|
| Industrial | MiniOneRec | Text+Random Abs | 9.26 | 8.44 |
| Industrial | ChronoID | Parallel, Relative | 12.60 | 11.15 |
| Office | MiniOneRec | Text+Random Abs | 6.01 | 4.89 |
| Office | ChronoID | Parallel, Relative | 8.42 | 7.08 |
| Mercari | MiniOneRec | Text+Random Abs | 1.61 | 1.08 |
| Mercari | ChronoID | Parallel, Relative | 3.28 | 2.59 |
→ 相对 MiniOneRec:Industrial HR@3 +36.1%(12.60 vs 9.26)、Office +40.1%(8.42 vs 6.01)。
消融结论:
- RQ2 时间编码:相对时间在所有架构/数据上稳定优于绝对时间,最大 early+residual/Industrial 上 HR@3 +42.7%;t-SNE 显示相对时间簇更紧。
- RQ3 融合:late > early;但更复杂的 early 融合(MLP、Cross-Attention)相比朴素 concat 只有边际差异(表 2:10.62 vs 10.53 vs 10.72)——简单拼接就够。
- RQ4 量化:parallel + 相对时间是全局最优。
- C.1 增益来源:把 3-digit 文本-only SID 扩到 4-digit(纯扩容量、降碰撞)HR@3 反而 8.64→8.02,而 3-digit+时间达 12.60 → 增益来自时间语义而非 ID 空间扩容。
- C.2 时间信号必要性:移除时间 digit HR@3 10.43→9.47;用零向量替换更糟 9.04(零填充成了 OOD 噪声)。
- C.3 高层日历特征:额外拼「周末/季节/节日」7 维 binary 指示器,增益边际甚至偶尔下降——atomic 时间戳已足够让模型内化高层模式(相对时间可反推绝对时间,高层语义是其确定性函数)。
- 超参:时间 emb 维度 768 最佳(512 容量不足、1280 抢占文本语义);码本数 3 最佳(2 碰撞多、≥4 后层在量化残差噪声,残差 ℓ1 norm 从第 3 层 0.36 骤降到第 5 层 0.03,即”语义饱和”)。
思考与可参考价值
局限:① 论文自身在「early vs late vs parallel」的最优组合表述上前后不完全一致(结论段 vs 表 1),复现须以表 1 为准。② parallel 量化用的其实是 early-fused 输入,「late fusion 更好」与「最优是 parallel(early-fused)」两条结论并存,二者的边界没讲透。③ 只在离线学术 benchmark(Amazon/Mercari)验证,没有工业在线 A/B;截断点选得较早(2018)导致 SFT 样本量大幅缩水。④ 只用了单一 sinusoidal 时间编码,没和可学习时间编码 / Time2Vec 等对比。
对电商 / 搜推 / Agent 方向的可借鉴点:
- 时间进 tokenization 层这个视角对做生成式推荐 / 生成式检索的团队直接可用:如果你已经在跑 RQ-VAE 出 SID,把相对时间间隔编码后按 late/parallel 拼进 SID,是一个低成本、可能高收益的增量改造点(作者在 MiniOneRec 上的相对提升 36–40%)。
- 相对时间间隔 > 绝对时间戳 的结论对任何长序列离散化场景(含 Agent 行为序列 tokenize)都有参考价值——绝对时间戳的单调递增会带来 distribution shift,间隔量更可复现、可泛化。
- parallel 码本解耦异质模态 的思路可迁移到「文本+图像+时间+价格」等多模态 SID 场景:当模态间是并列而非层级关系时,别硬塞进 RQ-VAE 的残差层级。
- 时间严格切分的 benchmark 协议(码本训练/SFT/测试三段全部防未来泄漏)值得直接借用来做冷启/新品离线评估,比常见的随机 leave-one-out 更贴近生产约束。