BARGE: Bridging the Structural Gap — Adapting Autoregressive Generation for Recommendation
Tencent (腾讯 PCG) × 深圳大学 × 中山大学
指出把 item 编成 L 级层级 Semantic ID、再拍平成 token 序列自回归生成,与推荐任务之间存在两个结构性 gap:(P1) 编码侧 item 边界消失——拍平后 encoder 分不清哪些 token 属于同一个 item;(P2) 解码侧语义漂移——层级码本是棵树,任一层选错就跳进错误子树、目标叶子再也够不到(TIGER 上 c3 前缀正确时 77% 准、前缀错时暴跌到 0.6%,128× gap)。提出 BARGE 三个轻量正交模块:ICA 补 P1,HPR(同通道路径重排)+ DPD(跨通道正交双路解码 OR 融合)补 P2。参数不增、Beauty R@10 +19.6%、腾讯 A/B CTR +0.60%。
核心思路
生成式推荐(GR,TIGER 一脉)把每个 item 编成 L 级层级 Semantic ID (c_1,…,c_L)、把用户历史拍平成 token 序列、自回归逐 token 生成下一个 item 的 SID。这套 formulation 是从 NLP 借来的——但 NLP 里每个 token 有独立词义,而层级语义码字 c_l 只有拼上前缀 c_<l 才有意义。这个 mismatch 造成两个结构性 gap:
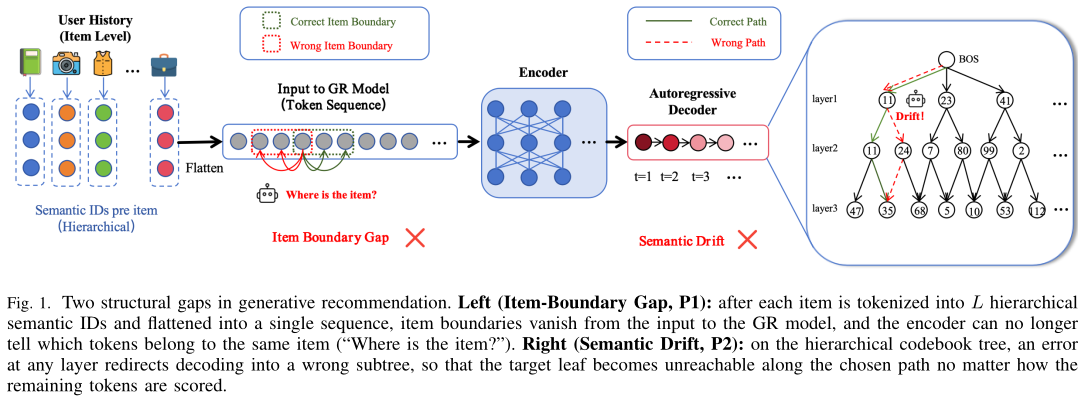
- P1 · Item-Boundary Gap(编码侧):每个 item 被拆成 L 个 token 后拍平成一条无差别序列,self-attention 对所有 token 一视同仁,item 边界只能靠位置信号隐式恢复——encoder 根本不知道「哪些 token 属于同一个 item」(图左的 “Where is the item?”)。
- P2 · Semantic Drift(解码侧):层级码本是一棵树,某层选的码字约束了之后所有层,任一层错就把搜索重定向进错误子树、目标叶子沿这条路径再也够不到(图右)。而标准 beam search 只按局部归一化概率选码字,对这种累积漂移毫无感知。
作者用 TIGER 把 P2 量化得触目惊心:在 c3 层,前缀正确时 per-layer 准确率 77.0%,前缀错时暴跌到 0.6%(128× gap);AR 模式下 c3 目标概率从 teacher-forcing 的 0.787 塌到 0.015(52× 掉落)。
关键 idea:P2 这个漂移可以从两个正交角度分别攻击——① intra-path(同通道内):在单条量化通道里做路径级重排,用全局一致性纠偏;② cross-channel(跨通道):再开一条结构正交的量化通道,一条通道漏掉的 item 用另一条 OR 式捞回。于是 BARGE = 三个互相正交的轻量模块:ICA 补 P1,HPR(同通道路径重排)与 DPD(跨通道双路解码)联合补 P2。三者作用在不相交的错误源上,增益近似可加。
整体实现思路
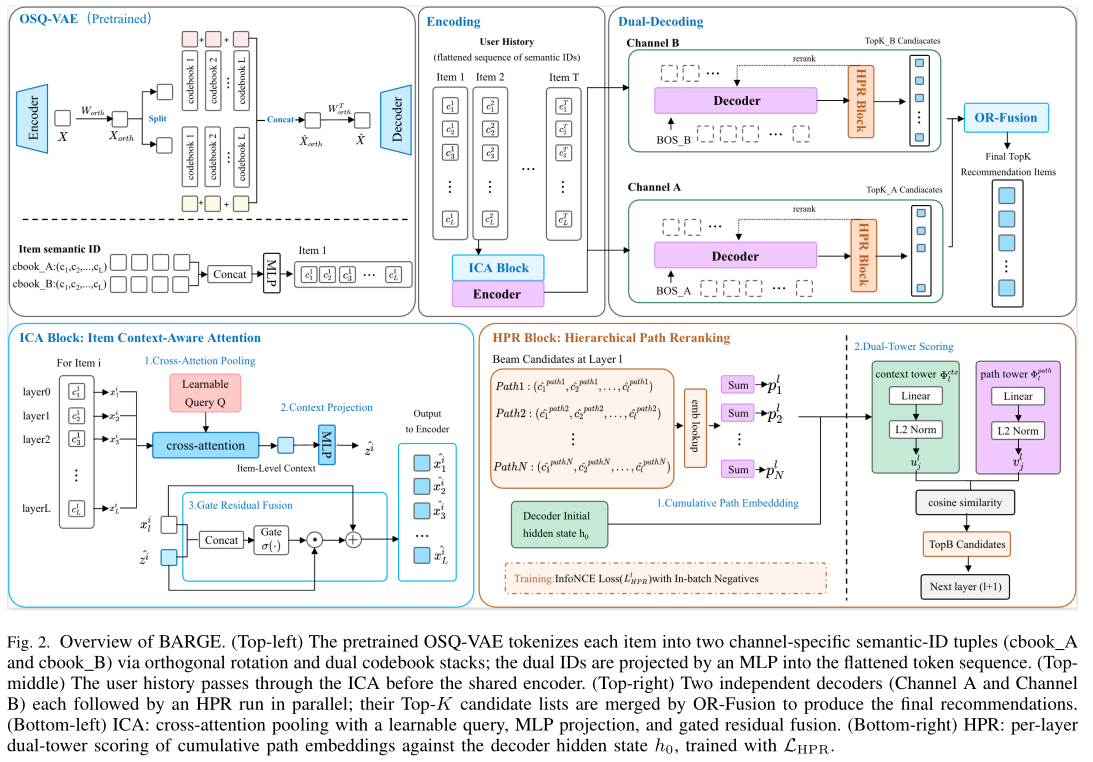
item 嵌入 z
  │ OSQ-VAE(预训练,冻结):正交旋转 R 拆两半 → 两套 channel-specific SID (cbook_A, cbook_B)
  ▼
用户历史(两套 SID 拍平成 token 序列)
  │ ICA Block:item 内 token 池化成 item 级上下文 → 门控注回每个 token(补 P1)
  ▼
共享 Encoder → 编码历史 H
  │ 两个独立解码塔并行(共享 encoder 输出)
  ├─ Channel A: Decoder_A → HPR_A(逐层路径重排)→ TopK_A 候选
  └─ Channel B: Decoder_B → HPR_B(逐层路径重排)→ TopK_B 候选
  ▼
OR-Fusion(item-id 空间):s(v)=f(s^A(v), s^B(v)),只要一通道排得高就召回
  ▼
Final TopK 推荐
Backbone:共享 encoder(2 层 4 头,d=128,attn=512,FFN=1024)+ 两个 DPD 解码塔;SID 深度 L=4、层级递减码本 (512,256,128,64)(PLUM 式,容量集中在粗粒度首层,四层全学习、不加随机去碰撞码)。
子模块实现(可复现细节)
模块 A — ICA(Item Context-Aware Attention,补 P1,放在 encoder 前)
思路:aggregate-then-fuse——先把每个 item 内的 L 个 token 池化成一个 item 级上下文,再门控注回每个 token,让 encoder 重新「看见」item 边界。
- ① 跨注意力池化:对 item
v_i的 L 个 token 嵌入X^(i)∈R^{L×d},用可学习 queryq∈R^d做 cross-attention(q 作 query、item 的 token 作 key/value):
z^(i) = LayerNorm( CrossAttn(q, X^(i), X^(i)) ) ∈ R^d
用 cross-attn 而非平均池化,是让 q 能自适应加权不同层(不同粒度)的贡献。
-
② 上下文投影:
ẑ^(i) = W_2·GELU(W_1·z^(i)+b_1)+b_2,W_1∈R^{d_f×d}, W_2∈R^{d×d_f}。 -
③ 门控残差融合:对每个 token
l,
g_l^(i) = σ( W_g·[x_l^(i) ‖ ẑ^(i)] + b_g ) ∈ R^d
x̂_l^(i) = x_l^(i) + g_l^(i) ⊙ ẑ^(i)
恒等保持性质:因 g_l∈[0,1]^d,有 ‖x̂_l−x_l‖ ≤ ‖ẑ‖,门≈0 时退化为原 encoder(ICA 是增强而非覆盖)。实测门稳定在 0.35–0.38(跨四层一致),说明网络学到了「适度且层一致」的注入强度。
模块 B — HPR(Hierarchical Path Reranking,补 P2 · intra-path)
key insight:decoder 在生成任何 token 之前、对全 encoder 输出做 cross-attn 得到的初始隐状态 h_0,是用户历史偏好的整体锚点,天然适合判断「候选路径是否符合用户意图」。
- 累积路径嵌入(路径级而非 token 级):
p^(l) = Σ_{j=1}^{l} e_{c_j}(码字嵌入求和),捕捉部分路径的语义轨迹。 - 逐层双塔打分(每层独立一个 scorer):
r_l(h_0, p^(l)) = cos( φ_l^ctx(h_0), φ_l^path(p^(l)) ) · e^{τ_l}
φ_l^ctx, φ_l^path 是层特定线性投影 + L2 归一,τ_l 可学习 log 温度。双塔让 context 投影每样本只算一次、可高效给多候选打分。
- 训练:对称 InfoNCE(正对 =
h_0与 GT 累积路径p^(l)):
L_HPR^(l) = ½( L_c2p^(l) + L_p2c^(l) )   # context→path 与 path→context 双向 CE
L_HPR = (1/L) Σ_l L_HPR^(l)
负样本三种:in-batch + prefix-aware(从 NTP 分布抽高概率非 GT 前缀,模拟推理时的漂移模式)+ 业务级(曝光未点 item)。
- 推理(不扩 beam 宽度):beam 扩展出
B×|C_l|个候选后,先按生成 log-prob 取 top-N 建打分池(B < N ≪ B×|C_l|,N=400),再融合重排:
score(c,l) = log p(c|c_<l, s_u) + λ · log softmax( r_l(h_0, p^(l)) )
λ=0.25(λ=0 退化为原 beam search)。出 beam 宽度不变,只加轻量双塔打分。
- 可验证条件(式18):设 vanilla / HPR 的逐层 miss 事件为
ε_l^van, ε_l^HPR,则无需任何假设成立:
ε_l^van − ε_l^HPR = Pr[Rescue_l] − Pr[Damage_l]
即 HPR 在层 l 净有益 ⟺ 救回的 GT 码字(Rescue)多于挤掉的 GT 码字(Damage)。这把「HPR 何时有用」变成可测量问题。λ 的倒 U 形状正是式18 的预测:λ 太小 Damage≈0 但 Rescue 也小、λ 太大 reranker 压过 likelihood 反而放大 Damage。
模块 C — DPD(Dual-Path Decoding,补 P2 · cross-channel)
单条 RQ-VAE 把 item 投到单一量化轴,任何该轴没抓住的语义面就被永久锁在对应子树外。DPD 用三件套破这个:
-
OSQ-VAE(Orthogonal Split-and-Quantize)tokenizer:对预训练 item 嵌入
z∈R^D,先做可学习正交旋转z̃=Rz,R 用 Householder 反射参数化,使R^T R=I_D构造成立、全程无需辅助 loss。再坐标对齐拆两半z̃ = z̃^A ‖ z̃^B ∈ R^{D/2},各半独立 L 级残差码本量化出两套 SIDs^(c)=(c_1^c,…,c_L^c)。因 R 正交 + 坐标对齐拆分,两通道支撑子空间硬保证S_A ⊥ S_B且S_A ⊕ S_B = R^D。训练 loss(双通道独立):
L_OSQ = ‖z−ẑ‖² + Σ_c ‖sg[z̃^c]−ẑ̃^c‖² + β Σ_c ‖z̃^c−sg[ẑ̃^c]‖²,其中ẑ = R^T[ẑ̃^A‖ẑ̃^B]是旋转回来的重构,sg 是 stop-gradient。 -
Dual-Decoder:用户历史经共享 ICA-encoder 编码一次,两个解码塔
Dec^A, Dec^B在共享输出上并行,各有独立 input proj / 层输出头(绑到各自码本)/ 各自 HPR。两阶段训练:先离线预训 OSQ-VAE 产两套 SID 并冻结,再在固定 SID 上训双解码器。总 loss:L_total = Σ_{c∈{A,B}} (L_NTP^c + L_HPR^c)。 -
推理 OR 融合:两塔各跑宽度 B 的 beam、映射回 item-id 空间、OR 融合
s(v)=f(s^A(v), s^B(v)),默认 LSE 软 ORf=log(exp s^A+exp s^B)。语义 = 只要至少一条通道排得高就召回,两条都漏才拒绝。不扩候选预算(每塔仍是宽度 B,合并列表截到同一 K)。 -
可验证条件(式19):设
E^A, E^B为两通道各自 miss GT 的事件,κ = Pr[E^B|E^A](A 已 miss 时 B 的条件 miss 率),则 OR 融合相对单通道 A 的增益无需独立性假设:
Pr[E^A] − Pr[E^A ∩ E^B] = (1−κ) · Pr[E^A]
把 DPD 的设计问题变成「κ 在实践中多小」——正交旋转 R 正是把 κ 压下去的机制。实测 Jaccard 仅 0.18/0.17,κ<1 得证。
实验设置与结果
数据:Amazon Beauty / Sports(5-core, leave-one-out)+ 腾讯商业媒体平台(百万用户、亿级交互、11 天,前 10 训后 1 评)。指标 Recall@K / NDCG@K(K=5/10),全 item 集算。统一管线:Qwen3-Embedding 取 item 嵌入 → 各 tokenizer → 统一 T5 从零训(2 层 enc/dec,beam=20),使 tokenizer/模块成为唯一变量。
主结果(Amazon,Table II 摘录)
| 方法 | Beauty R@10 | Beauty N@10 | Sports R@10 | Sports N@10 |
|---|---|---|---|---|
| TIGER | 0.0648 | 0.0384 | 0.0400 | 0.0225 |
| COBRA | 0.0725 | 0.0456 | 0.0434 | 0.0257 |
| ActionPiece | 0.0775 | 0.0424 | 0.0500 | 0.0264 |
| APAO-pointwise | 0.0795 | 0.0453 | 0.0444 | 0.0237 |
| BARGE-base | 0.0896 | 0.0515 | 0.0513 | 0.0285 |
| BARGE (full) | 0.0927 | 0.0547 | 0.0544 | 0.0308 |
BARGE 每个指标每个数据集都第一,Beauty R@10 较最强 baseline +19.6%、Sports R@10/N@10 +8.8%/+16.7%。BARGE-base(把 4 层学习码本换回 TIGER 3 层+随机码,隔离三模块贡献)已超所有既往生成式 baseline,说明结构模块与码本设计是互补的两条杠杆。
腾讯离线(Table III)+ 效率(Table IV)
| 方法 | Hit@5 | Hit@10 | Hit@50 |
|---|---|---|---|
| OneRec | 0.5459 | 0.6132 | 0.7348 |
| BARGE | 0.6015 | 0.6510 | 0.7520 |
效率:BARGE 参数 19.91M 反而略少于 TIGER 22.71M(用 2 层 encoder 省下的抵掉三模块开销),训练 24 vs 22 s/epoch——加了三模块不涨模型大小、不涨 wall-clock。
消融(Table V)
- 组件:三个单模块各自都超 TIGER,单模块最强 DPD > HPR > ICA;full BARGE 再超所有单模块,印证三模块作用于不相交错误源。
- OR 融合函数:LSE 最优,三种 OR 式(LSE/Max/RRF)均胜 AND 式 Mean(印证「至少一通道排高就召回」的设计原则);LSE 稳胜 Max(Max 的硬 argmax 对通道间尺度差敏感)。
- 旋转:把学习的 R 换成随机正交矩阵一致掉点(证明增益来自任务感知的正交分解,而非任意正交拆分)。R 诊断:
‖R−I‖_F/√D≈1.2–1.4(远离恒等)、重构 loss 比 R:=I 降 0.04–0.05。
漂移与互补性(Table VI / VIII)
| 层/模式 | 目标概率 | 说明 |
|---|---|---|
| c3 (TF) | 0.787 | teacher forcing |
| c3 (AR) | 0.015 | 自回归,52× 掉落 |
| c3 (AR, 前缀对) | 0.738 | per-layer 准 77.0% |
| c3 (AR, 前缀错) | 0.006 | per-layer 准 0.6%(128× gap) |
DPD 两通道互补性:top-K 池 Jaccard 仅 0.18(Beauty)/0.17(Sports),15%(Beauty)/24%(Sports) 的 OR 命中由单通道独家贡献,κ<1 直接兑现式19。超参:λ 呈倒 U(选 0.25),Top-N 约 400 后饱和。
在线 A/B(腾讯商业媒体平台,6% 流量)
CTR +0.60%、点击 UV +1.34%、总阅读时长 +1.70%,均统计显著。
思考与可参考价值
局限
- 结构复杂度上升:双解码器 + 逐层双塔 + OSQ-VAE 两阶段训练,虽参数不增但实现/调参成本高于单塔 GR。
- DPD 只拆两通道、OR 只做二路:多通道能否续增收益、κ 会不会饱和未探。
- 在线增幅偏小(CTR +0.60%),且腾讯是媒体/内容场景,电商/短视频等品类未验证。
- 公开实验规模有限:Beauty/Sports 中等规模 + 单一小 Transformer(2 层 128 维),大模型/大码本下漂移幅度与三模块相对收益是否保持未知。
- HPR 负样本依赖线上日志(prefix-aware/业务级),学术复现只能退化到 in-batch 负样本。
- 超参偏经验:λ 倒 U、Top-N 饱和点跨数据集是否稳未系统扫。
可直接借鉴(电商 / 搜推)
- 「item 拍平成 token 后 encoder 丢了 item 边界」是所有 Semantic ID 生成式召回/推荐的通病——ICA 这种「item 内 token 先池化成 item 级上下文、再门控注回每个 token」是低成本补丁,可直接加在任何 GR encoder 前,且恒等保持性质保证不伤原表示。
- 层级 SID 解码的语义漂移(一层错满盘输)在商品码、query token、类目码上同样存在——HPR 的「用历史锚点
h_0做路径级全局一致性重排、不扩 beam」是通用纠偏范式,比单纯加大 beam(延迟线性涨、显存 B×L 涨)划算得多。 - DPD 的「正交旋转拆两条互补量化通道 + OR 融合」提供了「一条通道漏了另一条救」的结构保证,比堆一个大码本更能覆盖异质 item,对长尾/冷启动商品尤有价值;且式19 给了「先测 κ 再决定要不要上第二通道」的量化判据,不用盲目加通道。
- 「三模块作用在不相交错误源、增益可加」的设计哲学:先把失败模式拆正交,再各给一个轻量模块,比一个大模型端到端更可解释、可调、可增量上线。
- 「BARGE-base 已超 baseline」提示 tokenizer/码本设计与结构模块是互补的两条杠杆——别只卷 tokenizer 架构,encoder/decoder 侧的结构补丁同样有杠杆。