SimPO: Simple Preference Optimization with a Reference-Free Reward
University of Virginia × Princeton PLI
把 DPO 的 implicit reward 重新设计为「序列平均 log-likelihood × β」,整段抛掉 reference model;同时在 Bradley-Terry 目标里加一个 target margin γ,强迫胜者 reward 比败者高出至少 γ。核心洞察:DPO 训练用的 reward 跟推理时的 generation metric (avg log-prob) 根本不对齐——SimPO 让两者完全一致,所以更稳更强。虽然原论文聚焦 chat 对齐,但对生成式推荐场景天然契合:去 ref-model 节省的显存在百万级 item vocab 下放大一个数量级;length-norm 直接化解长 session 推荐的 length-bias 病。
核心思路
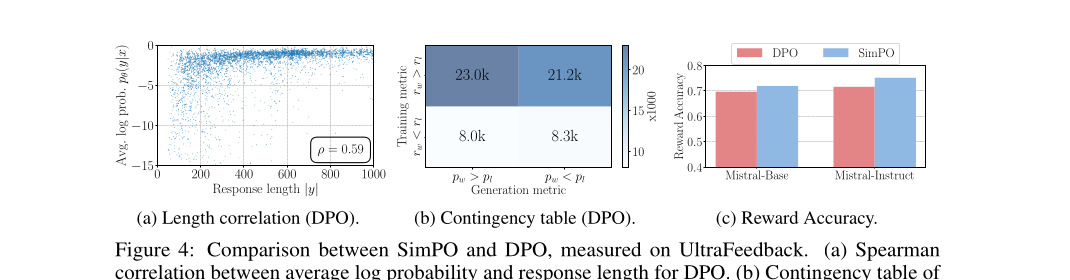
一句话问题:DPO 在训练时用的「隐式 reward」是 β·log(π_θ/π_ref),但模型推理时挑序列用的是「平均 token log-likelihood」(1/|y|)·log π_θ(y|x)(beam search、multiple-choice、argmax 解码都是这个量)。训练优化的目标和推理实际依赖的指标根本不是同一个量,作者实测在 DPO 训完的模型上,UltraFeedback 训练集里满足 r(x,y_w)>r(x,y_l) 的 pair 中几乎一半同时满足 p_θ(y_w)<p_θ(y_l)(reward 排序与 likelihood 排序矛盾),reward accuracy 接近随机。
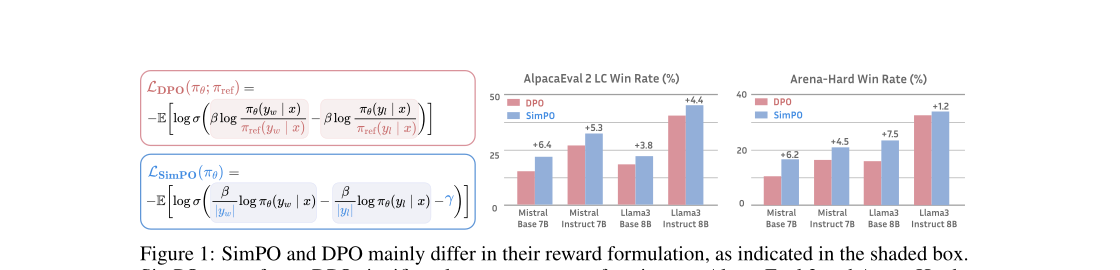
关键 idea:直接把 reward 定义成「序列平均 log-likelihood × β」,让训练 reward 与推理 metric 完全对齐。这样做有两个免费红利:(1) 公式里不再出现 π_ref,reference model 整个被消掉——省一份显存、省一次前传;(2) 平均(即对长度归一化 length normalization, LN)天然抑制 length bias。再额外往 Bradley-Terry 目标里塞一个 target reward margin γ,强制胜者 reward 比败者高出至少 γ,借鉴 large-margin classifier 的泛化收益。整个方法相对 DPO 只改 reward 表达式 + 加一个常数项 γ,6 行代码量级,却在 Mistral / Llama-3 / Gemma-2 上全面超过 DPO 及 7 个 offline 变体。
整体实现思路
SimPO 本身是一个 loss 函数,端到端 pipeline 沿用标准 offline preference optimization 两阶段(与 Zephyr / alignment-handbook 一致):
- SFT 阶段(仅 Base setup 需要):在指令数据上微调 base 模型得到 π_SFT。Base setup 用 UltraChat-200k(lr=2e-5、batch=128、max_len=2048、cosine + 10% warmup、1 epoch、Adam)。Instruct setup 直接拿现成 instruct 模型当 π_SFT(Mistral-7B-Instruct-v0.2 / Llama-3-8B-Instruct)。
- 偏好数据构造:
- Base setup:直接用 UltraFeedback 自带的 (x, y_w, y_l) 三元组。
- Instruct setup(更接近 on-policy):用 π_SFT 对每个 prompt 采 5 条响应(temperature=0.8),用
llm-blender/PairRM打分,最高分作 y_w、最低分作 y_l。只采一轮,不做 iterative。Flagship(Gemma-2)则换更强的 reward modelArmoRM-Llama3-8B-v0.1来标注偏好。
- 偏好优化阶段:从 π_SFT 初始化 π_θ,用 SimPO loss(Eq.6)训练。关键:SimPO 训练时只前传 π_θ 一次,不需要 π_ref。batch=128、单 epoch、max_len=2048、cosine + 10% warmup。每个 setup 单独调 (β, γ, lr)。
- 解码 / 评测:AlpacaEval 2 用采样解码(不同 setup temperature 0.5~0.9),Arena-Hard 用 greedy。推理时挑序列的 metric(平均 log-prob)正好就是训练 reward 的 base,训练-推理一致。
与 DPO 的端到端唯一差别就在第 3 步的 loss——把 β·log(π_θ/π_ref) 换成 (β/|y|)·log π_θ,并加上 -γ。
子模块实现(可复现细节)
1. DPO baseline reward(被替换的对象)
DPO 通过最优策略的 closed-form 把 reward 重参数化为:
r(x,y) = β·log[ π_θ(y|x) / π_ref(y|x) ] + β·log Z(x)
代入 Bradley-Terry p(y_w≻y_l) = σ(r(x,y_w) − r(x,y_l))(partition function Z(x) 抵消),得:
L_DPO = −E[ log σ( β·log(π_θ(y_w|x)/π_ref(y_w|x)) − β·log(π_θ(y_l|x)/π_ref(y_l|x)) ) ]
- 符号:π_θ 是待训策略,π_ref 是冻结的 SFT 模型,β 是温度(DPO 常用 0.01~0.1)。
- 问题:reward 含
log π_ref项,与推理 metric(1/|y|)·log π_θ不对齐,且训练时要常驻 π_ref。
2. Length-normalized reference-free reward(SimPO 核心)
推理时挑选项用的指标(beam search / multiple-choice)是平均 log-likelihood:
p_θ(y|x) = (1/|y|)·log π_θ(y|x) = (1/|y|)·Σ_{i=1..|y|} log π_θ(y_i | x, y_<i)
SimPO 直接拿它乘 β 当 reward:
r_SimPO(x,y) = (β/|y|)·log π_θ(y|x) = (β/|y|)·Σ_i log π_θ(y_i | x, y_<i) (Eq.4)
- 符号:
|y|是响应 token 数;β 控制 reward 差的缩放(SimPO 用大值 2.0~2.5,与 DPO 的小 β 不同量纲)。 - 张量维度:给定 batch B、序列长 L,policy 前传得到 logits
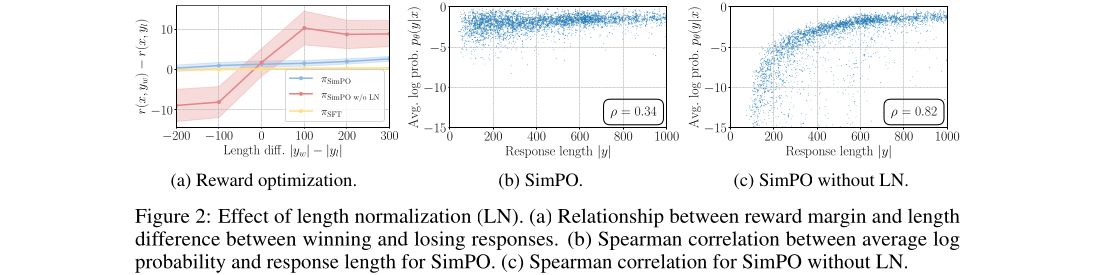
[B, L, V](V=词表)。对每个 token 取 gold token 的 log-softmax 得 per-token logp[B, L],按 response mask 求和得Σ log π_θ形状[B],再除以各自有效长度|y|([B])得到[B]的标量 reward。chosen / rejected 各算一份。 - 为什么必须 LN(而非 sum log-prob):长序列 sum log-prob 更负,若 y_w 比 y_l 长,优化 sum-reward 会逼模型人为抬高长序列概率(overcompensation)→ degeneration、生成又长又重复。LN 把每个 pair 的 reward 差都拉成正且与长度差解耦。
- 去 ref-model:Eq.4 里没有 π_ref,因此训练只需 π_θ 一次前传。
3. Target reward margin γ
把 BT 目标加一个常数 margin(γ>0),要求胜者 reward 至少高出 γ:
p(y_w≻y_l|x) = σ( r(x,y_w) − r(x,y_l) − γ ) (Eq.5)
- 直觉来自 large-margin classifier:增大类间 margin 提升泛化(BT 模型里这个 γ 也叫 home advantage)。
- 经验规律:γ 太小信号不足(退化回 DPO-like),太大优化困难导致 degeneration——win rate 随 γ 先升后降,但 reward accuracy 随 γ 单调上升(见 §实验消融)。
4. SimPO 最终目标
把 Eq.4 代入 Eq.5:
L_SimPO(π_θ) = −E_{(x,y_w,y_l)∼D}[ log σ( (β/|y_w|)·log π_θ(y_w|x) − (β/|y_l|)·log π_θ(y_l|x) − γ ) ] (Eq.6)
5. 梯度分析(理解差异)
∇L_SimPO = −β·E[ s_θ·( (1/|y_w|)∇log π_θ(y_w) − (1/|y_l|)∇log π_θ(y_l) ) ]
其中权重 s_θ = σ( (β/|y_l|)log π_θ(y_l) − (β/|y_w|)log π_θ(y_w) + γ )。
对比 DPO 权重 d_θ = σ( β·log(π_θ(y_l)/π_ref(y_l)) − β·log(π_θ(y_w)/π_ref(y_w)) )。差异两点:(1) s_θ 不含 π_ref,含义直接——模型错把 y_l 概率给得比 y_w 高时权重更大;(2) SimPO 对 y_w/y_l 的梯度都按 1/|y| 归一化,DPO 不归一,导致 DPO 中长序列(token 多)梯度更大、主导训练 → length bias。
6. 不加 KL 正则却不灾难遗忘
SimPO 没有 DPO 那种对 π_ref 的 KL 约束,靠三点经验因素维持低 KL:(1) 小 lr;(2) 偏好数据覆盖多领域多任务;(3) LLM 自身抗遗忘鲁棒性。实测 SimPO 对 π_ref 的 KL 散度仍然较低(β 越大 KL 越小)。注意:这是经验性的,论文明确指出理论上无正则的 SimPO 仍可能 reward hacking 而 degenerate(loss 低但生成崩)。
7. 关键超参(Table 8,可直接复现)
| Setting | β | γ | Learning rate |
|---|---|---|---|
| Mistral-Base | 2.0 | 1.6 | 3e-7 |
| Mistral-Instruct | 2.5 | 0.3 | 5e-7 |
| Llama-3-Base | 2.0 | 1.0 | 6e-7 |
| Llama-3-Instruct | 2.5 | 1.4 | 1e-6 |
通用搜索范围:β∈[2.0, 2.5],γ∈[0.3, 0.5, 1.0, 1.2, 1.4, 1.6]。batch=128、1 epoch、max_len=2048、8×H100、基于 alignment-handbook。
实验设置与结果
4 setups × 3 benchmarks × 8 baselines。模型族 Mistral-7B / Llama-3-8B,各 Base / Instruct 两套;旗舰额外做 Gemma-2-9B-it。
- Benchmarks:AlpacaEval 2(805 题,GPT-4 Turbo 当 judge + baseline,报 LC 长度控制胜率 / 原始 WR);Arena-Hard v0.1(500 道硬技术题,vs GPT-4-0314,报 WR);MT-Bench(80 题,单答打分 1-10,作者指出区分度差)。
- Baselines:RRHF、SLiC-HF(ranking loss)、DPO、IPO(也带 margin τ,但全目标弱于 SimPO)、CPO(序列 likelihood + SFT loss)、KTO(非配对)、ORPO(同样 ref-free,odds-ratio + SFT)、R-DPO(DPO + 长度正则项 α)。所有 baseline 都单独调过超参取最优。
- 指标定义:LC = length-controlled win rate(对模型啰嗦度做去偏,AlpacaEval 2 主指标);reward accuracy = held-out set 上满足
r(x,y_w)>r(x,y_l)的 pair 比例。
主结果(Table 4,AlpacaEval 2 LC % / Arena-Hard WR %)
| Method | Mistral-Base LC | M-Base AH | Mistral-Instruct LC | M-Inst AH | Llama3-Base LC | L3-Base AH | Llama3-Instruct LC | L3-Inst AH |
|---|---|---|---|---|---|---|---|---|
| SFT | 8.4 | 1.3 | 17.1 | 12.6 | 6.2 | 3.3 | 26.0 | 22.3 |
| DPO | 15.1 | 10.4 | 26.8 | 16.3 | 18.2 | 15.9 | 40.3 | 32.6 |
| IPO | 11.8 | 7.5 | 20.3 | 16.2 | 14.4 | 17.8 | 35.6 | 30.5 |
| KTO | 13.1 | 5.6 | 24.5 | 17.9 | 14.2 | 12.5 | 33.1 | 26.4 |
| ORPO | 14.7 | 7.0 | 24.5 | 20.8 | 12.2 | 10.8 | 28.5 | 25.8 |
| R-DPO | 17.4 | 8.0 | 27.3 | 16.1 | 17.6 | 17.2 | 41.1 | 33.1 |
| SimPO | 21.5 | 16.6 | 32.1 | 21.0 | 22.0 | 23.4 | 44.7 | 33.8 |
SimPO 在 AlpacaEval 2 LC 上比最强 baseline 高 3.6~4.8 pts,比 DPO 最高 +6.4 pts;Arena-Hard 最高 +7.5 pts。唯一被偶尔反超的是 CPO 的 Arena-Hard 原始 WR,但 CPO 生成平均长 50%,而 Arena-Hard 评测无长度惩罚(即 CPO 靠啰嗦取巧)。
消融(Table 5,Mistral-Base / Instruct)
| 变体 | M-Base LC | M-Base AH | M-Inst LC | M-Inst AH |
|---|---|---|---|---|
| DPO | 15.1 | 10.4 | 26.8 | 16.3 |
| SimPO(完整) | 21.5 | 16.6 | 32.1 | 21.0 |
| w/o LN(去长度归一化) | 11.9 | 9.4 | 19.1 | 16.3 |
| γ=0(去 margin) | 16.8 | 11.7 | 30.9 | 20.5 |
去掉 LN 是灾难性的(21.5→11.9,甚至低于 DPO),生成变长且重复;γ=0 也降但仍胜 DPO。说明两个设计都必要,LN 是更关键的那个。
DPO vs SimPO 深度分析
- likelihood-length 相关 ρ(held-out,越低越不 length-exploit):SimPO w/o LN = 0.82,DPO = 0.59,SimPO = 0.34。DPO 的 log-ratio 隐式部分抵消了长度偏置(所以比 w/o LN 好),但仍强于 SimPO。
- DPO reward 与 likelihood 错配:训练集上 r_θ(y_w)>r_θ(y_l) 的 pair 里,约一半 p_θ(y_w)<p_θ(y_l)(图中 21.2k vs 23.0k);SimPO 因 reward 就是 avg log-prob × β,二者完全一致(错配率=0)。
- reward accuracy:SimPO 持续高于 DPO(Mistral-Base / Instruct 均如此)。
- 效率(Llama-3-Base,8×H100,vanilla DPO 实现对比):SimPO 运行时间约减 20%(60min vs 73min),峰值显存约减 10%(69GB vs 77GB)——省在不跑 π_ref 前传。
旗舰与下游任务
- Gemma-2-9B-it-SimPO(用 ArmoRM 标注偏好):AlpacaEval 2 LC 72.4%、Arena-Hard 59.1%,生成长度 1833(无 length exploitation),Chatbot Arena 真实用户投票从 36 名升到 25 名,<10B 模型第一。Gemma 上对 lr 不敏感、不掉 GSM8K/MMLU,与 Llama-3 行为不同。
- 下游任务(HF Open Leaderboard):MMLU 基本保持,ARC/HellaSwag/TruthfulQA 普遍提升(TruthfulQA 最高 +10%),但 GSM8K(数学)普遍下降——SimPO 偶尔与 DPO 相当或更差。原因:偏好优化在加大 reward margin 时未必抬高 preferred 序列的 likelihood,数学题改一个 token 就翻 label(2+2=4 → 2+2=5)很脆弱。论文建议未来加回 reference-calibrated SFT loss 缓解。
- Llama-3 学习率权衡(Table 16):lr=1e-6(发布 ckpt)AlpacaEval 2 LC 53.7 但 GSM8K 暴跌到 57.4;lr=4e-7 则 LC 38.8、GSM8K 保持 77.9——chat 强度与通用能力此消彼长。
思考与可参考价值
局限:
- 超参敏感:β/γ 随 setup 变,γ 过大会崩、过小退回 DPO;缺自动定 margin 的方法。
- 无 KL 理论保证:靠「经验低 KL」撑场,原则上可 reward hacking;长训风险作者自己点名。
- 数学/推理掉点:偏好优化通病,SimPO 未专门解决,旗舰数字依赖强 reward model(ArmoRM)放大。
- 未对比 PPO:作者明确把 online RLHF 留作 future work,「超过所有 offline」≠「超过 PPO」。
- 任务面窄:评测几乎全是 chat / instruction-following,safety/honesty 未约束。
对电商 / 搜索推荐 / Agent 的可借鉴点:
- 生成式推荐(Gen-Rec)接 RLHF 时 length-norm 是刚需:用 LLM 生成 item-ID / RQ-VAE token 序列时,session 越长 sum log-prob 越负,DPO 会严重偏向短 session。SimPO 的
(β/|y|)·log π_θ直接把这个 length bias 拆掉——这正是图 2(a) 展示的「对所有长度差保持正 margin」。 - 去 ref-model 在大词表场景红利放大:Gen-Rec 词表 = 整个 item set(百万到亿级),常驻 π_ref 的显存压力比 chat 大一个数量级。SimPO 省一份 π_ref + 一次前传,在 Gen-Rec 上的相对收益远超论文里 chat 的 -20% 时间 / -10% 显存。
- 训练-推理 metric 对齐在推荐里更本质:推荐推理本就是 argmax / top-k avg log-prob,DPO 的 log-ratio reward 在这里完全错位(图 3b 那张列联表的矛盾会在推荐里更严重)。SimPO 让训练 reward 等于线上挑 item 的打分函数,是直接的因果对齐而非 hack。
- target margin γ 是个干净的可调旋钮:可推广成「好 item 的推荐 reward 必须比差 item 高 γ」,给 reward design 一个明确的间隔超参;配合 reward accuracy 监控(γ↑ accuracy↑ 但生成质量先升后降)做调参。
- Agent / 多步场景注意 reward hacking:SimPO 无 KL 约束,长 horizon / 多轮 RLHF 下漂移风险更高,落地建议保留小 lr + 监控 KL,或叠加 reference-calibrated SFT loss(论文 Appendix 已给
L_SimPO w/ SFT形式)防数学/工具调用类硬约束任务掉点。
一句话:本文严格说是 LLM 对齐方法而非生成式推荐论文,但「length-normalized + reference-free + 训练推理对齐」三件套对「生成式推荐 / 序列生成接偏好优化」是必读的方法学基底。