Self-Rewarding Language Models
Meta AI / NYU
Actor 与 Judge 合一:模型用 LLM-as-a-Judge 给自己生成的多个回答打分,组成偏好对做迭代 DPO。Instruction following 和 Judge 能力同步上升。
核心思路
问题一句话:传统 RLHF/DPO 的对齐信号上限被「人类偏好数据规模 + 一个训完即冻结的 reward model」锁死——reward model 的天花板就是人类标注员的天花板,且训练期间它不会再进步。要造「超人 agent」必须打破这个瓶颈。
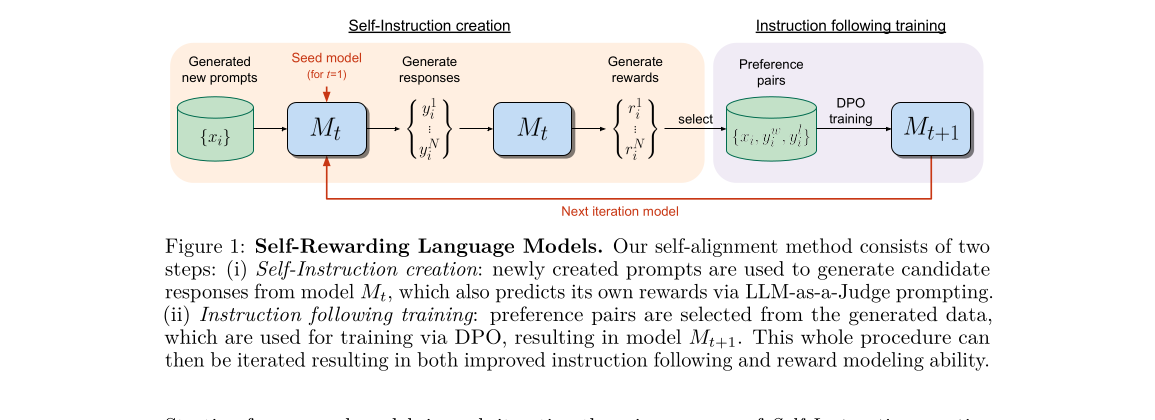
关键 idea:不再把 reward model 和 policy 拆成两个模型,而是让同一个 LLM 同时扮演 Actor(生成回答)和 Judge(给自己打分)。具体范式:
- Actor:对新 prompt 采样 N 个候选回答;
- Judge:用 LLM-as-a-Judge prompt 给这 N 个回答各打 0–5 分,取最高/最低分组成偏好对;
- 用这些自造偏好对做 DPO,得到下一代模型;新模型同时是更强的 Actor 和更强的 Judge,于是可以再造一批质量更高的偏好数据——形成「自我奖励」的迭代闭环(Iterative DPO,但 reward 来自模型自身而非外部固定 RM)。
核心命题被实证验证:随迭代进行,指令遵循能力和自我评判能力两条曲线同时单调上升,而不是出现「自评塌缩 / reward collapse」。
整体实现思路
端到端 pipeline 是「一次 SFT 初始化 + 多轮自指令构造/DPO」循环,模型序列记为 M0→M1→M2→M3:
- 初始化(SFT):从 Llama-2-70B base(M0)出发,用两类种子数据做 SFT 得到 M1:
- IFT(Instruction Fine-Tuning)数据:让模型会「答」;
- EFT(Evaluation Fine-Tuning)数据:让模型会「评」(即 LLM-as-a-Judge 能力)。
- 自指令构造(Self-Instruction creation),用当前模型 Mt:
- 生成新 prompt(few-shot self-instruct);
- 对每个 prompt 采样 N=4 个候选回答;
- 用同一个 Mt 当 Judge,给每个回答打 0–5 分(每个评 3 次取平均降方差)。
- 偏好对构造 + DPO 训练:每个 prompt 取最高分回答为 winner、最低分为 loser(分数相同则丢弃),构成 AIFT(Mt) 偏好数据集,对 Mt 做 DPO 得到 Mt+1。
- 迭代:M1 造数据 → 训出 M2;M2 造数据 → 训出 M3。Judge 与 Actor 始终是同一模型且同步更新,这是与旧 Iterative DPO(外部固定 RM,如 Pairwise Cringe Optimization)的本质区别。
模型序列与训练数据对应关系:
| 模型 | 初始化自 | 训练数据 | 训练方法 |
|---|---|---|---|
| M0 | — | 无(Llama-2-70B base) | — |
| M1 | M0 | IFT + EFT 种子数据 | SFT |
| M2 | M1 | IFT+EFT + AIFT(M1) | DPO |
| M3 | M2 | IFT+EFT + AIFT(M1) + AIFT(M2) | DPO |
子模块实现(可复现细节)
1) 种子数据:IFT + EFT
IFT 种子数据:取自 Open Assistant,沿用 Instruction Backtranslation(Li et al. 2024)的做法,只保留英文首轮对话且人工标注 rank 最高(rank 0)的高质量样本,共 3200 条 (instruction, response)。只在这份数据上做 SFT 得到的模型称为 SFT Baseline。
EFT 种子数据:同样来自 Open Assistant(每个 prompt 有多条人工排序回答)。构造方式:
- 把 (instruction, response) 套进 Figure 2 的 Judge prompt 模板(见下)作为输入;
- 训练 target(CoT justification + 最终 0–5 分)数据集里没有现成的,于是用 SFT Baseline 自己生成评测输出,仅当生成分数的排序与人工 rank 一致时才采纳进训练集;
- 因为很多样本被打 4 分导致分布偏斜,重采样丢掉部分最常见分数的样本;
- 最终 1630 train + 541 eval,与 IFT 数据不重叠。
EFT 不是必须的(光靠 IFT 模型也具备一定 Judge 能力),但加上能显著提升评判质量;t-SNE 显示 EFT 数据分布与 IFT 明显不同(位于 embedding 空间另一片区域),这正解释了「加 EFT 不损害指令遵循能力」。
2) LLM-as-a-Judge prompt(reward 函数核心)
这是整个方法的「reward 函数」,采用加性 5 分制(additive),而非多选题式打分。模型被要求对一条回答逐条累加:
- +1:相关、提供了部分相关信息(即使不完整);
- +1:覆盖了用户问题的实质部分;
- +1:以有用的方式回答了基本要素;
- +1:清晰地以 AI 助手视角直接、全面回答,组织良好;
- +1:完美贴合、无冗余、体现专家知识。
输出格式要求:先用 ≤100 词简述打分理由(CoT),最后一行写 Score: <total>。
这一 prompt 设计是关键超参:消融显示,用本文加性 prompt,SFT Baseline 的 pairwise accuracy 达 65.1%;换成 Li et al. (2024) 的多选桶式 prompt 只有 26.6%(Spearman 甚至为负 −0.18)。加性分解成子标准让模型更容易评分。
3) 自指令构造(Self-Instruction creation)
- 生成新 prompt:用一个事先固定的 Llama-2-Chat-70B 做 8-shot self-instruct(6 个示例来自 IFT 数据、2 个来自模型生成数据),解码 T=0.6, p=0.9;套用 Self-Instruct 的非分类任务模板,并做 ROUGE-L 相似度过滤、关键词过滤、长度过滤。(附录 A.5 显示新训练的 Mt 自己也能 in-context 生成 prompt,但 M2/M3 会先生成一串指令再接答案,需后处理。)
- 生成候选回答:用当前正在训练的 Self-Rewarding 模型采样 N=4 个回答,T=0.7, p=0.9。
- 评分:用同一个模型的 Judge 能力,对每个回答打分 rⁿᵢ∈[0,5];因评分有方差,采样 3 次取平均。
4) 偏好对构造 + DPO loss
对每个 prompt 的 4 个评分,取最高分回答 yʷᵢ(winner)、最低分回答 yˡᵢ(loser)构成偏好对 (xᵢ, yʷᵢ, yˡᵢ);分数相同则丢弃该 prompt。
DPO 目标(Rafailov et al. 2023),符号含义:πθ 为待训 policy、π_ref 为参考模型(本轮起点)、β 控制偏离参考的强度、σ 为 sigmoid:
L_DPO = − E_(x,yʷ,yˡ) [ log σ( β log (πθ(yʷ|x)/π_ref(yʷ|x)) − β log (πθ(yˡ|x)/π_ref(yˡ|x)) ) ]
- 加入 AIFT(M1) 偏好对 3964 对训出 M2;
- 加入 AIFT(M2) 偏好对 6942 对训出 M3。
附录 A.4 的重要消融:只把打满分 (rⁿᵢ=5) 的样本当正例加入 SFT(ReST/正例增强式,11254 条)无任何提升(29% vs 30% 平手);必须用偏好对 + DPO才有效。这说明「对比 loser」是收益来源,单纯加正样本不行。
5) 训练超参(可复现)
| 阶段 | 关键超参 |
|---|---|
| SFT | lr 5.5e-6 → cosine 衰减到 1.1e-6;batch 16;dropout 0.1;只在 target token 上算 loss |
| DPO | lr 1e-6 → 衰减到 1e-7;batch 16;dropout 0.1;β=0.1 |
| Early stopping | 每 200 步存 checkpoint,用 Claude 2 在 253 条验证集上 pairwise 评估(AlpacaEval prompt 格式),与上一步生成比较 |
实验设置与结果
Base 模型:Llama-2-70B。对齐数据来源:仅 Open Assistant 小种子集,不用任何蒸馏自更强模型的 target、也不用百万级私有标注。
评测两个维度:
- 指令遵循:GPT-4 做 judge 的 head-to-head(256 条 IFT test,双向比对、不一致记平局);AlpacaEval 2.0(805 prompt,对 GPT-4-Turbo 的 win rate);MT-Bench(多轮,GPT-4 打 10 分);9 个 NLP benchmark;外加作者人工盲评。
- Reward modeling:在 Open Assistant 留出集上测 Judge 与人工排序的一致性——pairwise accuracy、5-best%(被打满分 5 的回答确实是人类最高排序的比例)、exact match%、Spearman、Kendall τ。
指令遵循结果
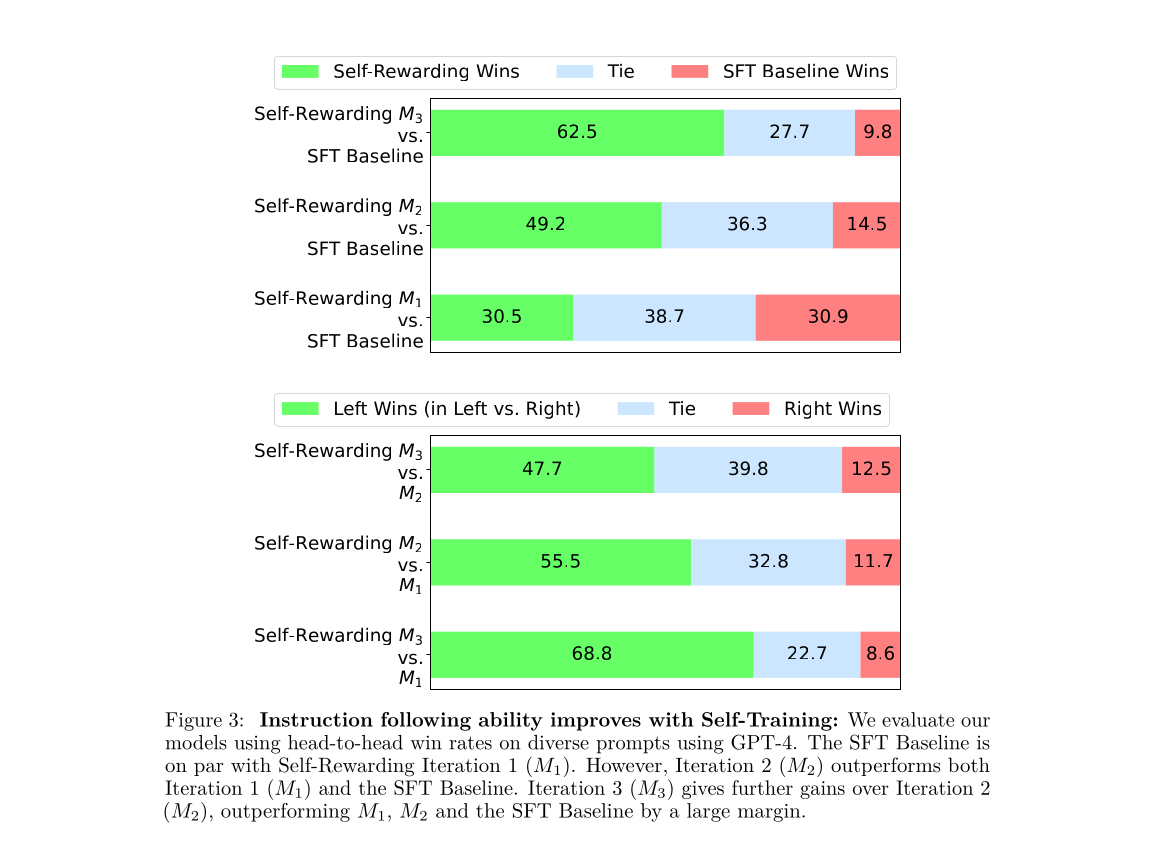
GPT-4 head-to-head(见下图 Figure 3):M2 对 M1 是 55.5% vs 11.7%,M3 对 M2 是 47.7% vs 12.5%,M3 对 SFT Baseline 高达 62.5% vs 9.8%——逐轮显著增益。值得注意的是 M1(IFT+EFT)与 SFT Baseline(仅 IFT)几乎打平(30.5% vs 30.9%),证明加入「会评判」的 EFT 能力不损害「会回答」的能力。
AlpacaEval 2.0 win rate(对 GPT-4-Turbo)——逐轮上升,M3 超过 Claude 2 / Gemini Pro / GPT-4 0613:
| 模型 | Win Rate | 用蒸馏 target | 用私有数据 |
|---|---|---|---|
| Self-Rewarding M1 | 9.94% | — | — |
| Self-Rewarding M2 | 15.38% | — | — |
| Self-Rewarding M3 | 20.44% | — | — |
| GPT-4 0314 | 22.07% | ✓ | |
| Mistral Medium | 21.86% | ✓ | |
| Claude 2 | 17.19% | ✓ | |
| Gemini Pro | 16.85% | ✓ | |
| GPT-4 0613 | 15.76% | ✓ | |
| GPT-3.5 Turbo 0613 | 14.13% | ✓ | |
| LLaMA2 Chat 70B | 13.87% | ✓ |
MT-Bench(满分 10):整体 6.78(M1)→7.01(M2)→7.25(M3)。增益主要在 humanities/STEM/roleplay/writing/extraction,math/code/reasoning 增益小(归因于 Open Assistant 种子 prompt 偏弱于推理)。
| Overall | Math/Code/Reasoning | Humanities/STEM/Roleplay/Writing | |
|---|---|---|---|
| SFT Baseline | 6.85 | 3.93 | 8.60 |
| M1 | 6.78 | 3.83 | 8.55 |
| M2 | 7.01 | 4.05 | 8.79 |
| M3 | 7.25 | 4.17 | 9.10 |
人工盲评(50 条指令、3 标注员多数投票)与 GPT-4 判断一致:M1/M2/M3 vs SFT Baseline 胜率 28%/56%/66%,逐轮拉开。
Reward Modeling 能力(自评不退化的核心证据)
Judge 与人工排序的一致性逐轮上升,且没有再喂 EFT 数据——纯靠「指令遵循变强带动评判变强」:
| 指标 | SFT Baseline (IFT) | M1 (IFT+EFT) | M2 | M3 |
|---|---|---|---|---|
| Pairwise acc. ↑ | 65.1% | 78.7% | 80.4% | 81.7% |
| 5-best % ↑ | 39.6% | 41.5% | 44.3% | 43.2% |
| Exact Match % ↑ | 10.1% | 13.1% | 14.3% | 14.3% |
| Spearman ↑ | 0.253 | 0.279 | 0.331 | 0.349 |
| Kendall τ ↑ | 0.233 | 0.253 | 0.315 | 0.324 |
两段增益分别来自:① EFT 数据(65.1%→78.7%,SFT 阶段);② 自训练迭代(78.7%→81.7%,DPO 阶段,无新 EFT)。
关键消融结论
- EFT 是否必要:去掉 EFT 只用 IFT 起步(M′ 序列),因为模型常打不出规范分数、分数收敛到 4,每轮能收集的有效偏好对极少(541 / 429 对 vs 3964 / 6942),最终 M′2/M′3 虽也超 SFT Baseline 但显著弱于 M2/M3,且差距随迭代越拉越大。
- DPO vs 仅加正例:仅加满分正例做 SFT 无效(见上),偏好对 + DPO 才有效。
- 代价与隐患:NLP benchmark(ARC/HellaSwag/GSM8K/MMLU/NQ 等)整体大致持平、部分轻微下降(「alignment tax」);生成长度逐轮显著变长(M1≈1092 → M2≈1552 → M3≈2552 字符),存在 length bias 风险。
思考与可参考价值
局限:
- 只跑了 3 轮、单一设置,缺乏「迭代 scaling law」与长期是否 reward collapse 的证据;M2→M3 在 AlpacaEval 上增益已收窄(15.38→20.44,且部分 reward 指标如 5-best% 在 M3 反降),暗示存在天花板。
- 强依赖 base 模型自身的 LLM-as-a-Judge 起点能力(加性 prompt 65.1% 才跑得动),弱模型起步会失败。
- 训练 reward 与最终评测(GPT-4)都用 LLM,length bias + 潜在 reward hacking 未深入分析;未做安全性评测。
- 增益集中在「更好地调用已有知识」(写作/角色扮演),对数学/推理几乎无效——说明它放大已有能力而非注入新能力。
对电商/搜索推荐/Agent 方向的可借鉴点:
- Judge 与 Policy 合一、随训练共同进化:在缺少大规模人工偏好标注的电商场景(商品文案生成、客服回复、搜索 query 改写),可让同一个模型既生成又用结构化 rubric 自评,迭代造偏好对——绕过「先训一个固定 RM」的重投入。
- 加性 rubric 化打分比笼统多选打分稳得多(65.1% vs 26.6%):做 LLM-as-a-Judge / 离线评测时,应把业务质量拆成可累加的子标准(相关性/覆盖度/可用性/清晰度/专业度),而非让模型直接给一个总分;多次采样取平均降方差也值得照搬。
- 偏好对 > 正例增强:自蒸馏数据飞轮里,构造「最好 vs 最差」对比对、用 DPO,远胜只把高分样本当 SFT 正例——对推荐/搜索的 rerank、生成式推荐里的偏好对齐有直接启示。
- 要监控的反模式:length bias、alignment tax(通用能力回退)、增益饱和。落地时应固定长度归一化的 judge、并在每轮保留通用能力 holdout 集做回归监控。
- 该工作是 Self-Reward 范式从概念到实证的里程碑,直接催生了 SPIN、SPPO、Meta-Rewarding LMs 等后续路线,并引出「Judge 是否也该用 RL 训练」的新课题。