On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and Training Stability
Alibaba Qwen Team
Qwen3.8-Flash-Next 的架构消融报告:125B 总参 / 6B 激活的稀疏 MoE,另加 51B 放在 host memory 的 n-gram embedding 表。核心方法论主张是「loss、下游指标、训推成本、训练稳定性是同一个设计问题」——每个候选改动都必须沿这三条轴同时评估,而不是只看 loss。四个组件承担设计:GDN + 全注意力 3:1 层间混合、微块粒度压缩索引的 Qwen Sparse Attention、把残差流拓宽到 4 路并逐通道门控读取的 Gated Residual、以及 Layer 2 的单层 n-gram embedding。配 Muon 优化器与重新拟合的超参 scaling law,用 1/3 激活参数、1/3 训练 token、约 1/9 训练 FLOPs 追平上一代 397B-A17B 旗舰。
核心思路
要解决的问题:上一代 Qwen3.7-Plus 是 397B 总参 / 17B 激活的稠密 MoE 旗舰。目标是在只花约 1/9 训练 FLOPs 的前提下把它的质量保住,同时把推理成本压下来。
关键 idea(这篇报告真正的贡献不是某一个模块,而是评估方法论):一个架构改动同时动三件事——下游能力、训推成本、以及「这个 run 还能不能稳」。所以每个候选改动都沿三条轴评估:
- loss 连同 downstream benchmark(不是只看 loss);
- 训练 / prefill / decode 三个阶段分开算成本(不是只报一个 FLOPs 数);
- 对最优超参和训练稳定性的影响。
报告反复强调「loss 与下游准确率不总是同向移动」,并且双向都有反例:
| 现象 | loss | benchmark |
|---|---|---|
| 扩大 n-gram 词表 | 单调下降 | 饱和甚至波动 |
| 把 residual 读写权重做成数据相关 | 只降 0.002 | +1.98 分 |
| 每 block 只读 gate 最高的 2 个 residual 分支 | 几乎无损 | 后训练阶段明显退化 |
| 全注意力层去掉位置编码(NoPE) | 预训练期不可区分 | 后训练后大量不终止生成 |
后两条尤其关键:它们在预训练指标上完全看不出来,只在后训练/生成阶段暴露。作者的结论是——只看预训练 loss 会做出错误决策,而这类错误在生产规模上代价极高。
最终配置:125B 总参 / 6B 激活 MoE + 51B off-accelerator n-gram embedding 参数。
整体实现思路
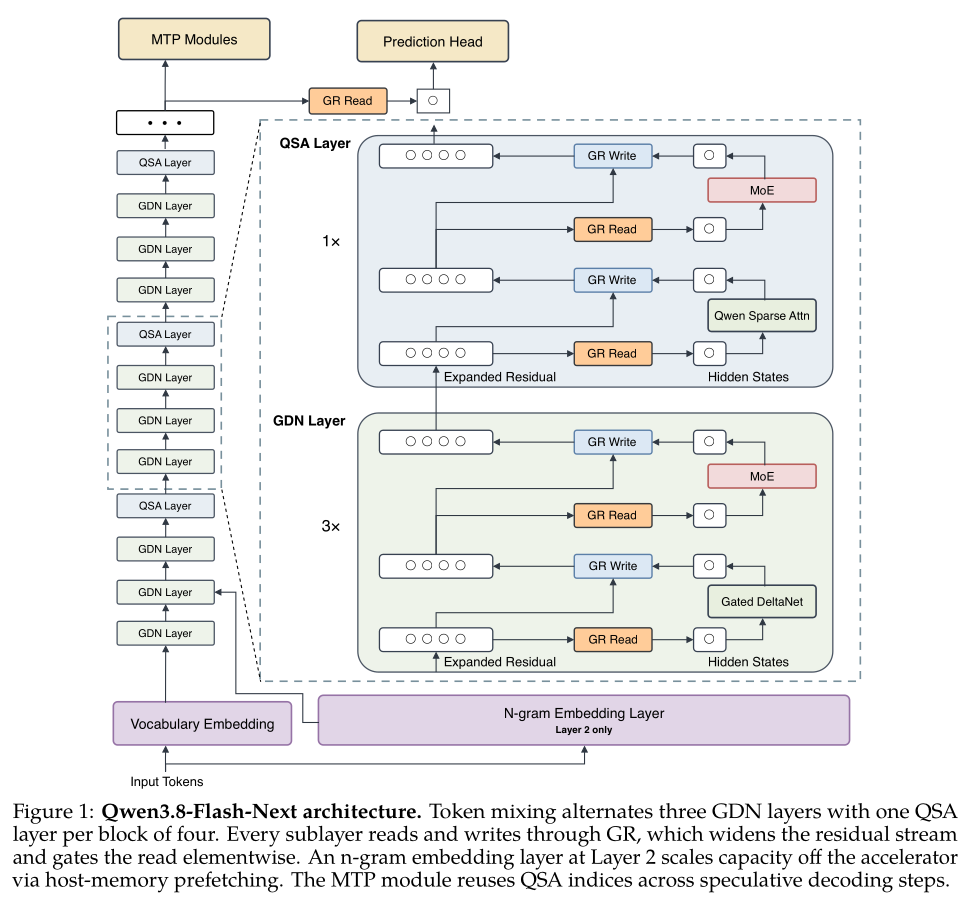
端到端数据流:
Input tokens
  → Vocabulary Embedding
  → [ 每 4 层一个 block ]  ×  N
        3 × GDN Layer      (线性递归,固定大小状态)
        1 × QSA Layer      (全注意力,CPT 后换成稀疏注意力)
        每个 sublayer(token mixer / MoE) 都通过 GR Read/GR Write
        与 4 路加宽残差流交互
  → Layer 2 额外插入 N-gram Embedding Layer
        (表放 host memory,异步 prefetch,与 Layer 1 计算重叠)
  → 顶部 GR Read(与 LM head 前的最终归一化融合成一次门控读)
  → Prediction Head  /  MTP Modules(复用 QSA 的 top-k 索引)
训练分两个大阶段:
- 预训练:全注意力层就是普通 softmax 注意力(带 RoPE),4K → 32K 逐步拉长;
- 持续预训练 CPT:序列长度 256K,把所有全注意力层(含 MTP 模块内的)替换成 QSA,分 dense distillation → sparse training 两小阶段。
四个组件各自解决一个瓶颈:
| 组件 | 解决的瓶颈 | 代价 |
|---|---|---|
| GDN / 全注意力 3:1 混合 | 注意力二次复杂度 + KV cache 线性膨胀 | GDN 是有限状态记忆,无法精确复现 token 级检索 → 用 1/4 全注意力层兜底 |
| QSA | 长上下文下 indexer 本身 的 O(n²) 开销 | 需要一个 CPT 阶段来蒸馏 + 适配 |
| Gated Residual | pre-norm 衰减信号:每层读同一条流,早期写入的特征要和后面所有东西竞争 | 加宽后多 n_r 倍残差状态的显存搬运 |
| N-gram Embedding | 想加容量但不想加每 token FLOPs | 表巨大,必须放 host memory |
子模块实现(可复现细节)
模块 A — Gated DeltaNet 混合层
输入/输出:归一化后的残差流输入 x_t ∈ R^d → token mixing 输出 o_t ∈ R^d。
递归状态:每个 head 维护 S_t ∈ R^{d_k × d_v}(注意这是原 GDN 论文状态约定的转置)。gated delta rule:
S̃_{t-1} = α_t · S_{t-1}                    # 全局衰减
e_t      = v_t − S̃_{t-1}ᵀ k_t              # 「已存的值」与目标值之差
S_t      = S̃_{t-1} + β_t · k_t e_tᵀ        # 只写残差误差
y_t      = S_tᵀ q_t
等价紧凑形式:
S_t = (α_t·I − β_t·k_t k_tᵀ) S_{t-1} + β_t·k_t v_tᵀ
两个门分工不同:α_t ∈ (0,1) 控制既有状态的整体寿命,delta 项则先估计 k_t 已经关联到的值、只写入残差误差。因此重复或相似的 key 会去更新已有关联,而不是无界地累加外积——这是 GDN 区别于纯加性线性注意力的关键。
参数化(可直接照抄复现):
q_t = L2Norm(SiLU(ShortConv(W_q x_t)))     # 短因果深度卷积 → 局部归纳偏置
k_t = L2Norm(SiLU(ShortConv(W_k x_t)))     # L2 归一化界定 q/k 幅度,稳住 rank-1 delta 转移
v_t = SiLU(ShortConv(W_v x_t))

β_t = σ(W_β x_t)                                        # 写入强度
α_t = exp[ −exp(A) · softplus(W_α x_t + b_α) ]          # 数据相关衰减,A 为可学标量

o_t = W_o [ σ(W_z x_t) ⊙ RMSNorm(y_t) ]                 # 注意:sigmoid 输出门,不是原版的 SiLU
三处与原 GDN 不同的工程选择:
- 输出门用有界 sigmoid 而非 SiLU,实验中一致更好(这与 GR、注意力模块的结论一致:有界正门 > tanh / SiLU,是全文反复出现的模式);
- zero-centered RMSNorm(沿用 Qwen3-Next),约束 RMSNorm 权重增长,全模型所有 RMSNorm 统一用这个形式;
- 全注意力层保留 RoPE。NoPE 变体在预训练期与 RoPE 几乎没有区别,但后训练后不终止生成(endless generation)的比例显著更高——典型的「预训练指标看不出来」的坑。
层间配比:每 4 层里 3 层 GDN + 1 层全注意力。周期性全注意力对长上下文尤其重要。
kernel:自研 FlashQLA(TileLang 融合线性注意力 kernel 库),相对 FLA Triton kernel 前向 2–3×、反向约 2×。已开源。
消融(28 层 25B-A3B MoE,400B tokens @4K + 80B tokens @32K,SWA 窗口 128):
| 架构 | MMLU | MMLU-Pro | SuperGPQA | MATH | GSM8K | BBH | MMMLU | EvalPlus | MultiPL-E | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|
| Full attention | 62.65 | 37.59 | 21.76 | 49.40 | 75.13 | 63.78 | 47.74 | 51.01 | 39.73 | 49.87 |
| SWA hybrid | 66.30 | 40.67 | 22.45 | 45.48 | 74.22 | 65.88 | 51.33 | 52.12 | 41.93 | 51.15 |
| GDN hybrid | 66.26 | 42.82 | 23.45 | 53.98 | 77.07 | 68.72 | 54.83 | 49.71 | 47.48 | 53.81 |
GDN hybrid 在 9 个 benchmark 中赢过 Transformer 8 个、赢过 SWA hybrid 7 个。
模块 B — Qwen Sparse Attention (QSA)
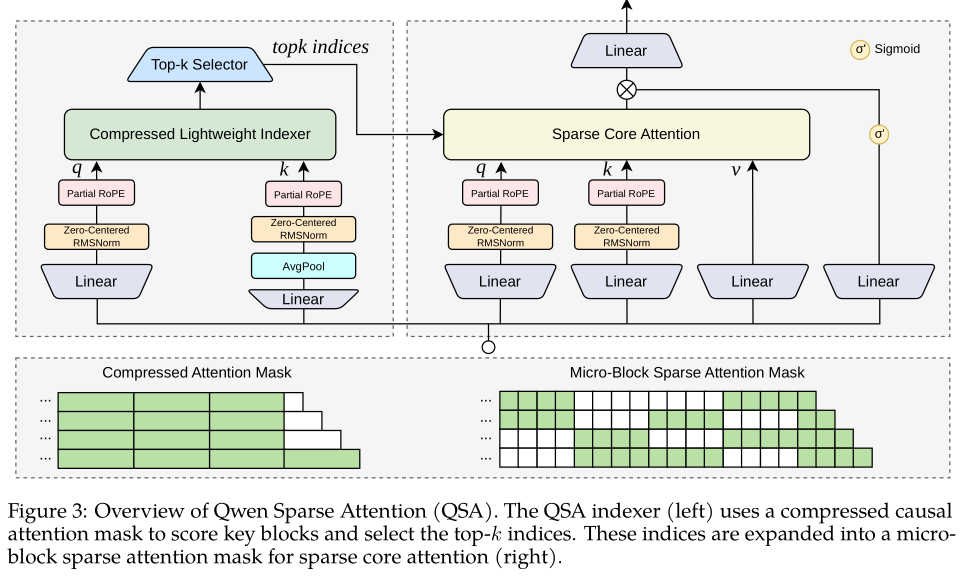
动机:DSA 这类方法用轻量 indexer 生成 token 级稀疏 mask,推理确实快了,但 indexer 自身仍是 O(n²),序列一长它就成了新瓶颈。QSA 的做法是先把序列压缩再打分,让索引开销本身随序列长度下降。
压缩轻量 indexer(MQA 结构,H=4 个 query head + 1 个共享 key head):
q̂_i^h = RMSNorm(W_Q^h x_i)                # 每 head 独立轻量投影
k_i    = W_K x_i                          # 共享 key
key 按 r 个 token 一块非重叠切分,均值池化压缩(p_b = b·r 为块起始位置):
k̂_b = RMSNorm( AvgPool(k_{p_b : p_b+r-1}) ), 0 ≤ b < ⌊n/r⌋
顺序很关键:先压缩、后加位置编码。
q_i^h = PRoPE(q̂_i^h, i)        # query 保留自己的 token 位置 i
k̄_b   = PRoPE(k̂_b,  p_b)       # 压缩 key 用块起始位置
partial RoPE 只作用于 indexer head 128 维中的 64 维(与核心注意力的 rotary 维度对齐)。如果先加 RoPE 再池化,等于把不同旋转相位的 token 表示平均掉——这个 ordering 是设计要点。
块级重要度打分(block-causal,只对已完整观测到的块打分):
I_ib = Σ_{h=1..H} ReLU( ⟨q_i^h, k̄_b⟩ )     若 p_b + r − 1 ≤ i
     = −∞                                    否则
选块:给定 token 预算 K,块预算 K_B = ⌈K/r⌉,B_i = TopK_{K_B}({I_ib})。选中的块 expand 回原始 token 索引并截到预算 K,再并上最后一个不完整块里的 tail token(永远包含):
S_i = Expand(B_i) ∪ { r·⌊(i+1)/r⌋, ..., i }
生产配置:K = 2048,r = 4 → 每个 query 选最多 512 个完整块 + tail token。
两阶段训练(在 CPT 阶段做,序列长度 256K):
-
Stage 1 — Dense Distillation:teacher 分布 = backbone 所有 head 的 softmax 注意力分布求和后 L1 归一化,得到 token 级
a_i ∈ R^n。用 MaxPool(不是 AvgPool)对齐到块级,避免显著 token 信号在聚合中被稀释:ā_ib = MaxPool(a_{i, p_b:p_b+r-1}), â_i = ā_i / ‖ā_i‖₁ L_KL = (1/N) Σ_i D_KL( â_{i,:} ‖ Softmax(I_{i,:}) )只训 indexer,1000 步,lr
1e-3,每步 8 条 256K 序列 ≈ 2B tokens。KL loss 只统计完整 key block。 -
Stage 2 — Sparse Training:backbone + indexer 联合训练,让骨干适配稀疏模式。KL 只在 top-K_B 块上算,且 teacher 概率在
B_i内重归一化到和为 1:L_KL = (1/N) Σ_i D_KL( â_{i,B_i} ‖ Softmax(I_{i,B_i}) )8000 步,lr
2.5e-5,每步 96 条 256K 序列 ≈ 200B tokens。
工程实现:融合 QSA kernel 同时算稀疏注意力输出和 KL loss,不物化中间结果,显存大幅下降;多步 MTP 跨预测步复用 top-k 索引。
复杂度:压缩比 r 把 indexer 从 O(n²) 降到 O(n²/r)。
结果 — 通用能力(Qwen3.8-Flash-Next 全尺寸):
| Method | MMLU-Pro | SuperGPQA | MATH | GSM8K | BBH | MMMLU | EvalPlus | MultiPL-E | Avg. |
|---|---|---|---|---|---|---|---|---|---|
| Full Attn | 72.9 | 51.7 | 69.8 | 91.0 | 90.4 | 81.8 | 70.8 | 78.4 | 75.9 |
| w/ QSA | 73.7 | 52.1 | 71.6 | 92.2 | 91.6 | 81.1 | 72.3 | 79.8 | 76.8 |
结果 — 长上下文检索(这是最有意思的部分:QSA 越长越赢):
| Method | RULER ≤128K | 128–256K | 256–512K | 512K–1M | MRCR 128K | 256K | 512K | 1M | Avg. |
|---|---|---|---|---|---|---|---|---|---|
| Full Attn | 99.84 | 99.81 | 97.65 | 90.08 | 97.14 | 94.20 | 30.66 | 20.71 | 78.76 |
| w/ QSA | 99.89 | 99.62 | 98.95 | 93.00 | 95.98 | 93.00 | 40.53 | 26.44 | 80.93 |
MRCR 512K 从 30.66 → 40.53,1M 从 20.71 → 26.44。稀疏不仅没有牺牲检索,反而在超长区间帮助了模型(可以理解为过滤掉了噪声上下文)。
MTP 复用索引无损(4 步投机解码平均接受长度):full attn 4.06 → QSA 4.07。
效率:1M 上下文下,注意力模块 prefill 7.6×、decode 4.9×(含 indexer 成本,dense 基线是 FlashInfer 的 paged GQA);单看 indexer 是 3.8× / 4.4×。从 64K 起就有加速,越长增益越大。
消融:
- 压缩比:block=4 是最优点。QSA 在相对 indexer latency 0.25 时就追平全注意力,而跨层共享索引的 IndexShare 到 0.5 仍不及基线——因为混合架构里全注意力层被 3 层 GDN 隔开,层间相似度低,跨层共享索引不成立;层内压缩不依赖这个假设。
- indexer head 数:4 个足够(远少于核心注意力)。注意 dense 蒸馏后直接上稀疏会明显掉点,必须有 Stage 2 的联合训练让骨干适配。
模块 C — Gated Residual (GR)
动机:pre-norm 保证了大规模训练稳定,但它衰减每层收到的信号——所有 block 读同一条流,早期写入的特征要和之后写入的所有东西竞争。已有工作分两派:一派让读写更有表达力(highway 系),一派把流本身加宽(AltUp / Hyper-Connections)。两者互补:加宽提供容量,读写机制决定容量怎么花。
先量化「只加宽」值多少:用适配 pre-norm 的简化 AltUp,残差状态是 R ∈ R^{n_r × d},每 block 持 n_r 个可学标量 h:
x     = Σ_i h_i · R_i                              # 读:加权和
R_i'  = R_i + 1[i = ℓ mod n_r] · y                 # 写:按深度 round-robin 写单支
只多 n_r 个参数、零矩阵乘,25B-A3B / 400B tokens 上 loss 就降了约 0.01。
GR 的具体设计(n_r = 4,注意力 block 和 MLP block 各有一个独立的 GR 模块):
-
每支独立归一化(各自 gain
γ_i ∈ R^d):R̂_i = RMSNorm(R_i ; γ_i), i = 1..n_r -
逐通道门控读(从所有分支预测,低秩瓶颈
r = d/8):G = unvec( σ( W_u · SiLU( (1/n_r) · W_d · vec(R̂) ) ) ) ∈ R^{n_r × d} x = (1/n_r) Σ_i G_i ⊙ R̂_i其中
vec把 n_r 支堆成长度n_r·d的向量,W_d ∈ R^{r × n_r d},W_u ∈ R^{n_r d × r}。 -
每支一个数据相关标量写:
s = 2·σ( (1/n_r) · W_w · vec(R̂) ) ∈ R^{n_r}, W_w ∈ R^{n_r × n_r d} R_i' = R_i + s_i · y, 其中 y = F(x) -
丢掉分支混合算子 H_res,并且 GR 直接取代 block 的 pre-normalization(读本身已经归一化+门控了),所以加宽没有引入任何额外的 norm 层。用标准随机初始化即可,不需要特殊初始化,static 项贡献可忽略。
这个「读」的形式其实就是作者另一篇工作里的 GatedNorm 作用在加宽流上:
GatedNorm(u) = RMSNorm(u) ⊙ σ( W₂ · SiLU( W₁ · RMSNorm(u) ) )
5 条消融结论(这是模块设计的全部依据):
- 有界正门:sigmoid 优于 tanh,loss 和稳定性都是(与 GDN / 注意力的结论一致)。
- 数据相关性:让 H_mix / H_combine 数据相关,loss 只降 0.002,但 benchmark 涨 1.98 分;而 static 加宽相对 pre-norm 是 loss 降 0.021、benchmark 涨 1.58。两者比例完全反过来——这是全文最有说服力的「不能只看 loss」证据。
- 读的粒度比写的粒度重要:把 H_mix 从「每支一个标量」细化到「每支每通道一个权重」有明显收益;对 H_combine 做同样细化几乎没用 → 读逐通道,写保持每支标量。
- 读所有分支:优于只读最后一支或先池化;再对每支单独归一化(group RMSNorm)还有额外收益。
- H_res 基本没用:读写足够有表达力后,
n_r × n_r混合算子无显著提升 → 直接砍掉,每 block 省一次残差状态的完整读(这正是加宽流的主要推理成本)。
消融数据(25B-A3B MoE,560B tokens,n_r = 4):
| Residual | Loss | MMLU | MMLU-Pro | SuperGPQA | MATH | GSM8K | BBH | MMMLU | EvalPlus | MultiPL-E | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Pre-norm | 1.617 | 64.29 | 38.40 | 21.78 | 53.92 | 77.41 | 64.73 | 51.26 | 49.25 | 37.15 | 50.91 |
| mHC (static) | 1.596 | 64.62 | 43.69 | 22.20 | 55.08 | 78.05 | 65.42 | 52.78 | 49.59 | 40.94 | 52.49 |
| mHC (dynamic) | 1.594 | 66.11 | 45.84 | 24.20 | 59.54 | 78.51 | 66.01 | 56.61 | 52.16 | 41.30 | 54.47 |
| GR | 1.590 | 66.69 | 46.02 | 23.80 | 61.18 | 78.20 | 66.54 | 56.19 | 51.36 | 42.00 | 54.66 |
与 Attention Residual 对比(28 层 = 56 sublayer,GN = GatedNorm):
| Residual design | Loss | Loss + GN |
|---|---|---|
| Pre-norm | 1.789 | 1.787 |
| Block AttnRes, S=4 | 1.773 | 1.768 |
| Block AttnRes, S=2 | 1.770 | 1.766 |
| Full AttnRes | 1.762 | 1.758 |
| GR (n_r=4) | — | 1.762 |
GR 与最强的 Full AttnRes 打平;48 层时 GR 1.707 vs Block AttnRes(S=4) 1.711。GatedNorm 在每个设置上都降 loss,且读到的输入越复杂增益越大。
机制分析:这 4 条分支到底被拿去做什么了?
因为 GR 没有分支混合,每支就是过往输出的纯累加器,可以精确分解每个 block 读到了什么:
R_c^(v) = R_c^(0) + Σ_{u<v} s_c^(u) · y^(u)                      # 分支 c 在 block v 前的内容

a_{u→v} = (1/n_r) Σ_c  G_c^(v) ⊙ γ_c ⊙ [ s_c^(u) y^(u) / rms(R_c^(v)) ]    # block u 对 block v 输入的贡献

π_uv = ‖a_{u→v}‖ / Σ_{u'<v} ‖a_{u'→v}‖                          # 归一化份额(分解精确到 3e-8)
再与「除了没有 GR 之外完全相同」的参考模型对比 Δ_uv = π_uv^GR − π_uv^ref:
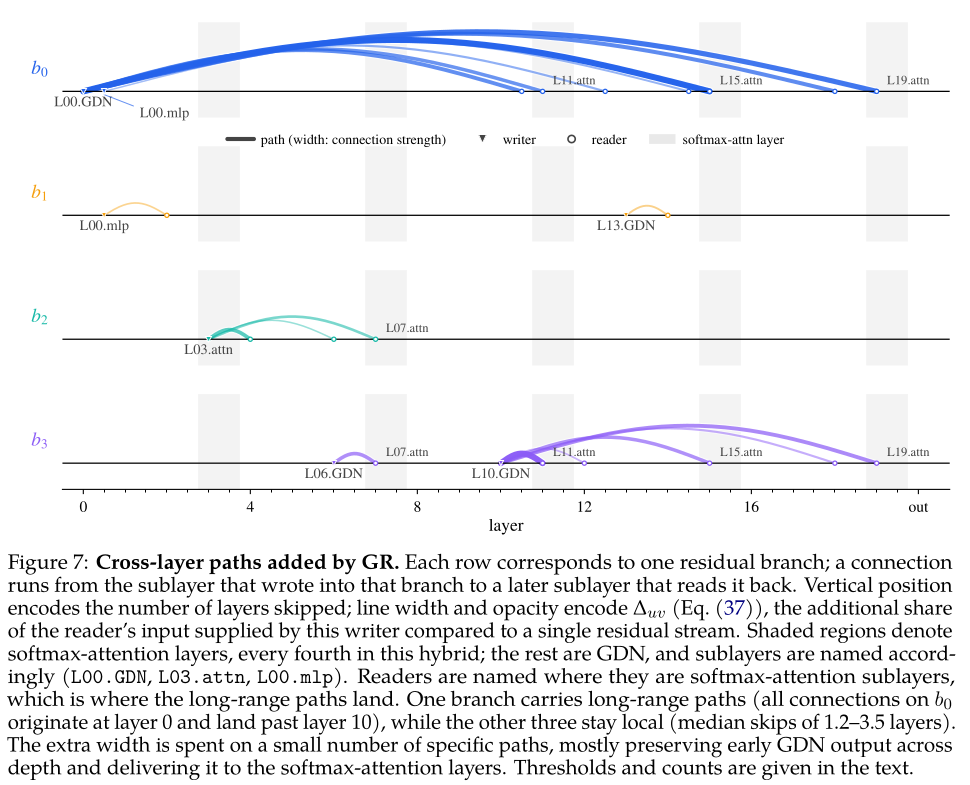
结论非常干净:
- 恰好一支承担长程(典型 skip 10.9 层),另外三支保持局部(3.4–3.9 层)。5 个 GR checkpoint 全都是这个模式,哪一支无所谓(初始化时可交换)。
- 长程支的机制直接来自公式:它在 layer 0 被重写入一次,之后几乎不再更新,于是 layer-0 的信息对之后所有层都保持可达。
- 最主要读取 GR 分支的是 softmax 注意力层——全局注意力充当整合显式长程历史的枢纽,而这些历史正是 GDN 层压缩掉的那部分。
- 具体数字:layer 0 GDN → layer 15 attention 的份额从参考模型的 0.020 涨到 0.138(layer 15 有 30 个 writer,均分是 0.03,所以 0.138 是均分的 4.6 倍),且在 layer 10–19 的每个 reader 上都保持 0.072–0.138 无下降趋势;layer 10 GDN → layer 11 attention 的
Δ_uv = 0.117(短程也在被加强);layer 0 MLP 同时在长程支上打到 layer 15(0.008→0.058)和在局部支上打到 layer 2(0.139→0.192)——同一个输出以不同强度到达远近两个 reader,这是单条残差流根本表达不了的(它对每个 writer 只有一个衰减率)。 - 按 skip 分组求和:skip=1 的通路总共 +0.96,skip>12 的 +0.91,skip 2–12 的 −3.21;加权平均 skip 几乎不变(3.97 vs 3.91)。跨层信息总量没变,变的是分布——GR 挑出少数通路并放大,代价是中程通路。
推理效率优化(加宽流的成本就是残差状态的显存搬运,所以目标是少搬字节):
- ❌ 稀疏读:训练好的模型里每层 GR 的写通常由 2 支主导,于是尝试只读 gate 最高的 2 支(从头训 / 训练中途切都试了)。预训练 loss 和 benchmark 几乎无影响,但后训练之后质量明显退化;逐层变化稀疏度等更复杂变体也没解决。报告明确写:这是一个只看预训练指标就会做出错误决策的案例。
- ✅ FP8 存残差状态:GR、gated attention、GDN 里的门都界定了写入流的幅度,残差值范围窄,天然适配低精度。相对 BF16 搬运字节减半,质量几乎无损。
- ✅ kernel 融合:读(公式 30–32)和写(公式 33–34)各融成一个 kernel,group RMSNorm 折进读里,每 block 每方向只遍历一次加宽流。
模块 D — N-gram Embedding
思路:以每个 token 结尾的短 n-gram 作为 key 去查嵌入表,取回的向量增强对应 token 表示。相比 unigram 查表,它把记忆检索条件在局部上下文而非只看 token 身份。用 multi-head hashing 查表,通过 contextual gating 注入残差流。因为寻址是确定性的,表可以放 host memory 并异步 prefetch,参数量涨而每 token FLOPs 和延迟几乎不涨。全部实验用 300 TPP(tokens per active parameter)。
放置消融(固定 n-gram 参数总量):
| Layer Index | Loss | MMLU | MMLU-Pro | MATH | GSM8K | BBH | Avg. |
|---|---|---|---|---|---|---|---|
| w/o N-gram emb. | 1.585 | 62.78 | 33.43 | 32.52 | 59.21 | 53.40 | 45.44 |
| 1st | 1.541 | 64.19 | 35.25 | 36.20 | 65.73 | 56.00 | 47.30 |
| 2nd | 1.541 | 64.71 | 35.80 | 37.32 | 64.00 | 57.56 | 47.94 |
| 15th | 1.543 | 65.07 | 34.95 | 36.12 | 63.50 | 57.15 | 47.37 |
| 25th | 1.541 | 64.70 | 35.15 | 36.26 | 63.31 | 55.73 | 47.40 |
| 2nd + 25th | 1.540 | 64.94 | 35.40 | 37.40 | 64.33 | 57.79 | 47.75 |
结论:没有哪个深度区间稳定占优;把同样预算分散到多层没有一致收益;单层就够。放置选择对注意力机制类型也不敏感(full attn 和 GDN 下相对排序相似)。最终选 Layer 2,让 host-memory prefetch 与 Layer 1 的计算重叠。
词表规模消融 A — 固定总参数预算(扩 n-gram 就减 MoE expert,V = 基础 tokenizer 词表 250K):
| Vocab Scale (Param Ratio) | Loss | Uncheatable PPL | MMLU | MMLU-Pro | MATH | GSM8K | C-Eval |
|---|---|---|---|---|---|---|---|
| None (0%) | 1.202 | 5.55 | 68.25 | 44.38 | 46.02 | 74.79 | 70.78 |
| 5× (10%) | 1.200 | 5.54 | 68.15 | 44.49 | 45.64 | 72.86 | 70.93 |
| 10× (25%) | 1.197 | 5.55 | 67.71 | 44.66 | 46.56 | 73.65 | 70.71 |
| 30× (50%) | 1.201 | 5.59 | 67.75 | 42.61 | 44.62 | 74.45 | 72.49 |
loss 在 10× 处非单调取到最低,但这个最优点在其他评测上完全看不到:out-of-domain uncheatable PPL 基本不动,下游 benchmark 相对纯 MoE 基线没有明显提升。作者由此判断 n-gram embedding 与 MoE expert 在扩容量上扮演的是不同角色,不该互换预算,后续实验改为固定 MoE 预算。
词表规模消融 B — 额外加参数:
| Vocab Scale | Loss | MMLU | MMLU-Pro | MATH | GSM8K | BBH | C-Eval | CMMLU |
|---|---|---|---|---|---|---|---|---|
| None | 1.585 | 62.78 | 33.43 | 32.52 | 59.21 | 53.40 | 66.91 | 68.10 |
| 20× | 1.553 | 64.14 | 34.46 | 37.38 | 65.09 | 57.13 | 71.75 | 72.29 |
| 50× | 1.541 | 64.71 | 35.80 | 37.32 | 64.00 | 57.56 | 72.12 | 72.48 |
| 100× | 1.534 | 64.70 | 35.87 | 36.98 | 63.08 | 56.03 | 73.75 | 72.73 |
| 200× | 1.526 | 64.85 | 35.21 | 35.34 | 62.96 | 56.23 | 74.94 | 73.24 |
loss 随词表单调下降(1.585 → 1.526),但下游在 50× 之后就饱和甚至波动——这是摘要里点名的第一个「loss 与 benchmark 不同向」案例。唯一一个跟着单调涨的是中文 benchmark(C-Eval 66.91 → 74.94,CMMLU 68.10 → 73.24),这个信号本身值得注意。
其他尝试(token 归一化压词表、按 n-gram 阶非均匀分配、按频率划分 slot)在他们的训练配方下都没有一致收益。
最终生产配置:51B n-gram embedding 参数,全部放在加速器之外。
模块 E — Muon 优化器的工程细节
正交化:对 Nesterov 加速动量(μ=0.95)做 Newton–Schulz 迭代,结果按 γ(A,B) = 0.2·√(max(A,B))(形状 A×B)缩放,使更新的 RMS 与矩阵形状无关。NS 系数用 Polar Express 的逐步 schedule(给定步数预算下 minimax 最优),迭代步数设 8(比更少步正交化更准,并且在压测里降低了梯度范数尖峰的幅度和频率),NS 前 Frobenius 归一化的数值稳定常数取 1e-14。
哪些参数用 Muon(只给真正充当线性映射的二维权重):
| 用 Muon | 用 AdamW | 理由 |
|---|---|---|
| 注意力 q/k/v/o 投影 | input embedding、output head | 正交化不适用/无益 |
| GDN 输入/输出投影 | MoE router | Muon 加剧早期波动并破坏 router 稳定;中后期加也无收益。可能解释:router 每个输出维对应一个 expert 的分数,各维基本独立,没有可供正交化利用的共享线性结构 |
| routed + shared expert 的 fc1/fc2 | GR 的两个低秩投影 | 形状过于扁长 |
| n-gram embedding 的 key/value 投影 | GDN 的 decay / beta 投影 | 每 head 出一个标量,本质是向量,正交化无意义 |
| — | 输出门(注意力输出门、GDN 的 z 投影) | 消融显示 AdamW 持平或略好 |
| — | n-gram embedding 表(Adam,关掉 weight decay) | — |
拆分融合参数(关键正确性问题):Megatron-LM 里 attention qkv 投影、SwiGLU fc1、GDN 输入投影各存成一个融合矩阵,但语义上是沿输出维拼接的独立线性算子。直接正交化融合矩阵错两次:(1) 迭代会跨不相关子块混合奇异方向;(2) γ(A,B) 用的是拼接后的形状而非真实算子形状。
做法:正交化前拆开融合梯度 → 每个子矩阵独立跑 NS → 结果 gather 回原布局再 apply。
- qkv 和 GDN 输入投影按 per-head 粒度拆 → loss 和 benchmark 都改善;
- fc1 拆成 gate / up 两半 → loss 基本不变,benchmark 略涨;
- 拆分还顺便提供了把个别子矩阵排除出 Muon 的天然粒度。
分布式实现(两个真实痛点):
- NS 迭代需要对完整参数矩阵做整体更新(K 步约
4K·max(A,B)·min(A,B)²FLOPs),与 Megatron 分片冲突:TP 下没有任何 rank 持有完整权重;DP 下开销是短边的三次方,Megatron 的等元素数划分会造成严重长尾。 → 自研 Canzona:把逻辑上的 optimizer 归属与物理参数布局解耦。α-balanced 静态分区器以整个参数为单位重新分配(不切进张量内部),按估计的 NS FLOPs 均衡各 DP rank;异步 Micro-Group 流水通过融合 All-to-All 跨 TP rank 重建每个 Muon 拥有的矩阵。每个 owner 跑的这一步在数学上等价于单卡 Muon;ZeRO-1 的 bucket 几何保持不变,因此 Megatron 的 Reduce-Scatter / backward overlap 仍然生效。 - 拆分之后一层贡献上百个子矩阵,optimizer step 变成一长串极小 kernel,瓶颈是 launch overhead 而非算术。 → 整个 step 用 CUDA graph 捕获。
模块 F — 超参 scaling law 重拟合
为什么要重拟合:最优 lr 和 batch size 同时依赖架构与优化器,两者都换了,上一代的配方就不再最优。而且新组合训练明显更稳,说明有空间往更激进的方向调。
新拟合的结论:更大的 batch size、更大的 learning rate,且 lr 随模型规模衰减更慢。作者分开验证两个预测,各自选一个能把该效应放大的场景:
验证 1 — batch size(小模型 + 大 token 预算,过大 batch 最容易露馅):20 层 10.8B-A0.89B MoE,4T tokens,每个配置用 scaling law 给它自己的 lr,同 token 预算即同算力。
| Batch size | 最后 20B tokens 平均 loss |
|---|---|
| B = 12.6M(上一代配方) | 1.5774 |
| B = 25.2M(新拟合预测最优) | 1.5702 |
| B = 37.7M(预测的 1.5×) | 1.5707 |
新拟合比旧配方好 7.2e-3;再放大 1.5× 只有 4.3e-4 的惩罚(不显著)。loss 在预测值以下陡升、以上近乎持平——说明预测值贴近最优且足够大。
验证 2 — batch size warmup 不再需要:常规做法是早期 ramp batch(临界 batch size 早期小、后期增长)。但用 Muon 时观察到:低于预测最优的惩罚远大于高于,且 Muon 在 AdamW 会退化的大 batch 上仍保持数据效率;稀疏 MoE 的大 batch 还能保证每个 expert 每步收到足够多样的 token 信号。于是重测 ramp:从 6.3M 每次 +6.3M,524B tokens 达到 25.2M,两个变体(保持峰值 lr / 按小 batch 调低峰值 lr)分别比恒定 batch 差 2.5e-4 / 3.5e-4,且同 token 预算多花 18.8% 的 optimizer step。稳定性也没有差别(无 loss spike,p99.9 pre-clip 梯度范数 0.088–0.190,远低于 0.5 阈值)。
机制解释也很清楚:warmup 期小 batch 在同 lr 下梯度噪声更大 → loss 更高;刚到目标 batch 时因为累积了更多步会有短暂优势;但随着 lr 衰减、模型接近收敛,这个步数优势被抵消,恒定 batch 最终反超。结论:生产 run 不用 batch warmup。
验证 3 — learning rate(大模型 + 有限 token 预算,不稳定风险最大):48 层 156B-A7B MoE,419B tokens。
| Setting | B | η | MMLU | MMLU-Pro | SuperGPQA | MATH | GSM8K | BBH | MMMLU | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|
| 新拟合,预测最优 | 8.4M | 1.76e-3 | 73.84 | 48.35 | 29.31 | 49.98 | 80.89 | 73.25 | 68.23 | 60.55 |
| 新拟合,η ÷ √2 | 8.4M | 1.24e-3 | 73.59 | 47.00 | 28.10 | 48.92 | 77.48 | 72.00 | 66.88 | 59.14 |
| 新拟合,η × √2 | 8.4M | 2.49e-3 | 73.84 | 46.92 | 28.04 | 49.58 | 80.06 | 73.82 | 68.46 | 60.10 |
| 新拟合,B × 1.25 | 10.5M | 2.01e-3 | 73.73 | 48.51 | 28.52 | 49.32 | 80.06 | 72.58 | 67.72 | 60.06 |
| Qwen3.5 配方 | 4.2M | 6.8e-4 | 71.23 | 45.35 | 25.67 | 45.54 | 74.32 | 69.54 | 63.19 | 56.41 |
旧配方比预测最优高 7.8e-3 loss;预测最优附近四个设置彼此在 7e-4 以内(噪声水平)——最优点位于一个平底盆的底部,lr 上下 √2 倍、batch +25% 都在盆内。稳定性:预测最优的最大 pre-clip 梯度范数只到 clip 阈值的 28%,旧配方 51%(小 batch 梯度更噪);warmup 之后 5 个 run 全程没有触发过梯度裁剪。
模块 G — 稳定性压测
动机:万亿参数 / 数十万亿 token 的规模才会出现的不稳定,在小规模实验里完全看不到。要在中等规模高效迭代又能暴露生产规模的失效模式,就需要放大压力。
设计:跟随 Wortsman et al. (2023) 的观察——大规模不稳定可以在小模型上通过抬高 lr 复现。做法是把 lr 恒定在最优值的某个倍数(绕过标准衰减 schedule),模拟生产 run 长期停留在峰值 lr 的情形。28 层 MoE,2× 和 4× 最优 lr,所有 run 同 batch,梯度裁剪阈值 0.5。
判据(写得很克制,值得学):新配方必须在同等压力下至少与它所替代的那一代一样稳(Qwen3.5 结构 + AdamW,已被成功放大过)。
测三个量:loss spike(超过 201 步滚动中位数 0.1 的步)、pre-clip 梯度范数的 p99.9 与越阈次数、每 block 最大激活。
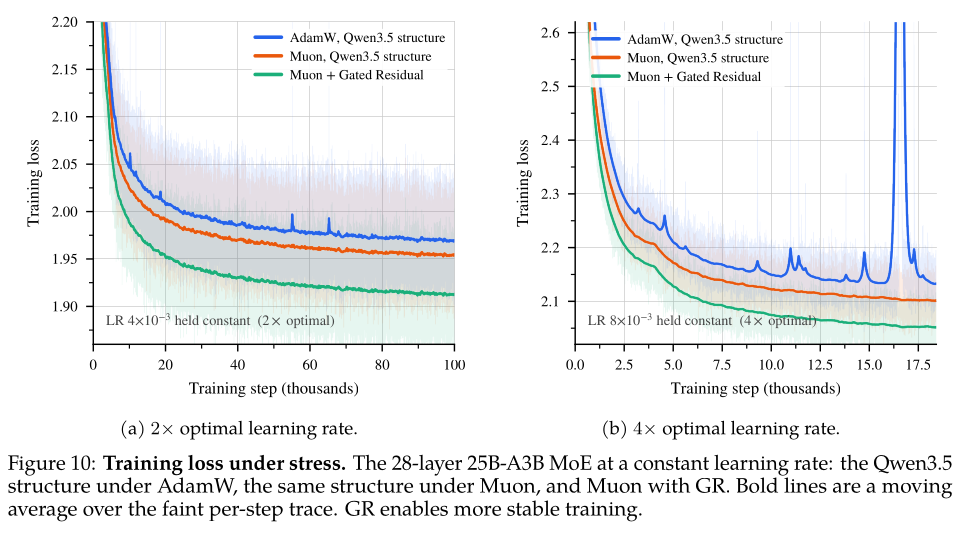
结果:
| 压力 | AdamW + Qwen3.5 结构 | Muon + Qwen3.5 结构 | Muon + GR |
|---|---|---|---|
| 2× 最优 lr | 4.3 spikes / 10k steps | 0.2 / 10k | 0.2 / 10k |
| 4× 最优 lr | 183 / 10k,19,932 步中 213 步越阈(裁剪器持续工作) | 从不越阈 | 从不越阈,零 loss spike |
机制隔离(单变量对照):固定 AdamW + 结构 + 数据顺序,只开关 GatedNorm,3× 最优 lr:spike 率 32.0 → 3.2 per 10k,越阈次数 256 → 20。再做一个 lr 阶梯(不开 gate):激活离群值随 lr 近似线性增长,而 spike 率增长快得多;开 gate 后即使在最高 lr 下,离群值也低于不开 gate 时最低 lr 的水平。
作者给出的解释很关键:高 lr 训练需要某种 rescaling 机制。没有显式门时,网络靠把激活离群值养大来实现它,因而脆弱;乘性门直接提供这个 rescaling,训练就稳了。
生产 run 验证(前 276B tokens,同数据顺序 / lr schedule / 优化器):
| 配置 | 276B tokens 处 loss 相对改善 | median 梯度范数 | p99.9 | 1000 步窗口 std |
|---|---|---|---|---|
| Qwen3.5 结构 + Muon | 基线 | 0.097 | 0.298(唯一越过裁剪阈值的) | 基线 |
| + GR | −0.026 | 0.053 | 0.071 | 低 4.3–4.7× |
| 完整 Flash-Next | −0.058(再降 0.032) | 0.043 | 0.066 | 低 4.3–4.7× |
在 8 倍模型规模、生产 lr 下复现了压测结论。把残差读与 LM head 前的最终归一化融合成一次门控读,进一步降低了梯度范数,很可能是 Flash-Next 与 Muon+GR 之间差距的主因。加 GR 后残差最大值在每个探测深度上都显著下降。
最终结果:全量训练全程没有一次 loss spike、没有异常梯度范数波动,也不需要 qk-clip 或 SwiGLU-clip 这类显式激活控制手段。
实验设置与结果
最终基座评测(14 个 benchmark:MMLU/MMLU-Redux/MMLU-Pro/BBH/SuperGPQA 5-shot 或 CoT;GPQA/GSM8K/MATH;EvalPlus/MultiPL-E/SWEBench-Pretrain;MGSM/MMMLU/INCLUDE):
| Qwen3.8-Flash-Next-Base | Qwen3.8-27B-Base | Qwen3.7-Plus-Base | |
|---|---|---|---|
| # Params | 125B | 27B | 397B |
| # Activated Params | 6B | 27B | 17B |
| # N-gram Embedding Params | 51B | – | – |
| MMLU | 90.36 | 87.51 | 90.43 |
| MMLU-Redux | 90.68 | 87.26 | 91.47 |
| MMLU-Pro | 73.23 | 68.60 | 70.90 |
| SuperGPQA | 51.36 | 44.86 | 48.42 |
| BBH | 90.87 | 89.56 | 89.41 |
| GPQA | 51.42 | 45.01 | 51.52 |
| GSM8K | 93.29 | 93.18 | 92.95 |
| MATH | 72.78 | 60.54 | 74.38 |
| EvalPlus | 78.76 | 76.05 | 78.06 |
| MultiPL-E | 79.09 | 74.50 | 81.68 |
| SWEBench-Pretrain | 50.99 | 41.66 | 49.24 |
| MGSM | 89.33 | 86.37 | 85.42 |
| MMMLU | 84.86 | 79.74 | 84.53 |
| INCLUDE | 78.40 | 74.37 | 78.90 |
- 对 Qwen3.8-27B-Base:14/14 全胜。
- 对大得多的 Qwen3.7-Plus-Base:8/14 领先,落后的 6 项最多差 2.6 分,而它只用约 1/3 激活参数、1/3 训练 token、≈1/9 训练 FLOPs。
SWEBench-Pretrain 是他们自建的预训练版 SWE-bench:给基座模型问题描述 + 相关代码文件,让它直接产出 diff patch,用与 golden patch 的序列相似度打分。
思考与可参考价值
这篇报告最有价值的地方不是模块,是方法论
一份架构报告最容易写成「我们试了 A、B、C,选了 C」。这篇不同的是它系统性地记录了三条评估轴什么时候会互相矛盾,并且四个反例里有两个是只在后训练阶段才暴露的(稀疏 read、NoPE)。这对任何自己训模型 / 做架构改动的团队都是可直接复用的检查清单:
不要用预训练 loss 单独做架构决策,尤其是那些「几乎不掉 loss」的省成本改动——它们恰恰是最危险的一类,因为看起来免费。
局限
- 每一条结论都绑在他们自己的训练配方上。n-gram embedding 那节里 “no consistent gains in our training recipe” 出现了不止一次——换数据、换 TPP、换 tokenizer,很多结论未必成立。
- 消融规模与生产规模的 gap。绝大部分消融在 25B-A3B / 35B-A3B 上做,然后外推到 125B-A6B。作者自己在结论里点名最紧的瓶颈是评估吞吐:他们缺一个便宜的中等规模探针来可靠预测后训练之后的排序,这正是稀疏 read 那个坑的根源。
- Canzona 只有描述没有开源(FlashQLA 开源了)。想复现 Muon 在 Megatron 上的分布式实现,α-balanced 分区器 + Micro-Group All-to-All 流水这块要自己造。
- Table 10 的排序作者自己标注为”观察性”——单次评测、top 设置之间差距在噪声内。这个诚实度值得肯定,但也意味着不能拿这张表去论证”更大 lr 一定更好”。
- QSA 需要专门的 CPT 阶段(约 202B tokens)才能装上,不是一个可以在已有 checkpoint 上零成本插入的推理优化。
对电商 / 搜推 / Agent 方向的可借鉴点
-
「压缩后打分」优于「跨层共享」——这是稀疏检索的通用结论。QSA vs IndexShare 的对比说明:当各层表示差异大时,跨层复用索引会失效,而层内先压缩再打分不依赖任何跨层假设。这对长行为序列建模是直接可迁移的:把用户历史按微块(如每 4 个行为)AvgPool 成块表示、块级打分选 top-K 块、再展开回行为粒度做精细注意力——比在 token 级建索引便宜 r 倍,且长序列越长增益越大。“先压缩再加位置编码”这个 ordering 也要照抄,否则会把不同相位的行为平均掉。
-
有界正门(sigmoid)在三个不相关模块上一致胜出,且机制解释很有说服力:高 lr 训练需要一个 rescaling 机制,没有显式门时网络会靠养大激活离群值来实现,因而脆弱。任何自己训 ranking / retrieval 塔并且遇到过训练尖峰的团队,这是个成本极低的改动——比事后加各种 clip 干净得多(他们全程没用 qk-clip / SwiGLU-clip)。
-
GR 的分支分析给出了”多路残差到底在干什么”的第一个精确答案:一支专门保存 layer-0 的输入信息并送给全局注意力层,其余三支走局部;同一个输出能以不同强度到达远近两个 reader——单条残差流做不到,因为它对每个 writer 只有一个衰减率。这对多塔 / 多任务架构有直接启发:如果你的网络需要把原始特征同时以不同强度送到浅层和深层,加宽残差比加 skip connection 更自然。而且这个分析方法(π_uv 分解 + 与无 GR 参考模型作差)本身就是一个可复用的诊断工具。
-
n-gram embedding 那节的负面结果比正面结果更有价值:固定参数预算下拿 MoE expert 换 n-gram slot 在下游上没有收益——两者扩的是不同维度的容量,不该互换预算。同时中文 benchmark 是唯一随词表单调提升的,说明 n-gram 记忆对形态学/分词更复杂的语言帮助更大。做多语种电商(东南亚小语种、阿拉伯语)的话,这条线值得单独验证。
-
「压力测试」这个做法本身可以直接搬:把 lr 恒定在最优的 2–4 倍来在小规模复现大规模不稳定,判据定成”新配方必须至少与已被成功放大过的那一代一样稳”——这是一个廉价、可自动化、判据明确的 gate,比”跑到 X% 再看”实用得多。同样可用在推荐模型的大规模训练上。
-
Muon 的两条工程教训与模型无关:(a) 融合参数必须在正交化前拆开,否则跨不相关子块混合奇异方向、缩放因子还用错形状——这是一个纯 bug 级别的正确性问题,任何要在 Megatron 上接 Muon 的人都会踩;(b) router 用 AdamW(各输出维独立,无共享线性结构可供正交化利用)。这两条省下的调试时间,可能比论文里任何一个架构模块都值钱。