Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models
Peking University × DeepSeek-AI
提出「条件记忆(conditional memory)」作为与 MoE「条件计算」正交的第二条稀疏性轴——Transformer 缺少原生的知识查表原语,被迫用多层计算去"模拟"检索。Engram 把经典 N-gram embedding 现代化(tokenizer 压缩 + 多头哈希 + 上下文门控 + 多分支融合),以 O(1) 查表提供静态记忆。关键发现是 Sparsity Allocation 呈 U 形 scaling law:把 20–25% 的稀疏参数预算从 MoE 专家挪给 Engram 严格优于纯 MoE。更反直觉的是收益不止在知识题(MMLU +3.4),而在通用推理(BBH +5.0)和代码数学(HumanEval +3.0)更大——机理分析显示 Engram 把浅层从"静态重建"中解放,等效加深网络,并把注意力容量让给全局上下文(Multi-Query NIAH 84.2 → 97.0)。
核心思路
问题:语言建模其实是两类异质子任务的混合——组合推理(compositional reasoning,需要深层、动态计算)和知识检索(knowledge retrieval,大量是局部、静态、高度模式化的,比如命名实体、固定搭配、成语)。当前的稀疏化路线 MoE 只提供了条件计算(conditional computation):稀疏激活参数去处理动态逻辑。但标准 Transformer 没有原生的”查表”原语,只能用计算去模拟检索。
论文用一个 PatchScope 的实证例子说明这有多浪费(Table 3):要识别实体 "Diana, Princess of Wales",模型得逐层拼装——
| Layer | LogitLens 翻译出的潜在语义 |
|---|---|
| 1-2 | ”Country in the United Kingdom”(只认出 Wales) |
| 3 | ”Country in Europe” |
| 4-5 | ”Title given to the wife of the Prince of Wales”(Princess of Wales,但还不具体) |
| 6 | ”Diana, Princess of Wales (1961-1997)…” |
整整 6 层 Attention + FFN,只为运行时重建一张本可以 O(1) 查到的静态表。 这些顺序深度本该留给高阶推理。
关键 idea:引入**条件记忆(conditional memory)**作为与条件计算互补的第二条稀疏性轴。二者的区分是本文最核心的概念贡献:
| 条件计算(MoE) | 条件记忆(Engram) | |
|---|---|---|
| 稀疏什么 | 稀疏激活参数去做计算 | 稀疏查表取静态 embedding |
| 寻址方式 | 依赖运行时 hidden state 的动态路由 | 仅依赖 input token id 的确定性哈希 |
| 处理的信号 | 动态、上下文相关的逻辑 | 静态、局部、模式化的知识 |
| 系统含义 | 路由不可预知 → 必须常驻 HBM | 索引可提前算出 → 可预取、可 offload 到 host 内存 |
Engram 就是这条轴的一个实例化:把经典 N-gram embedding 现代化,用后缀 N-gram 做 key,O(1) 查一张巨大的 embedding 表,再用上下文门控融进 backbone。
整体实现思路
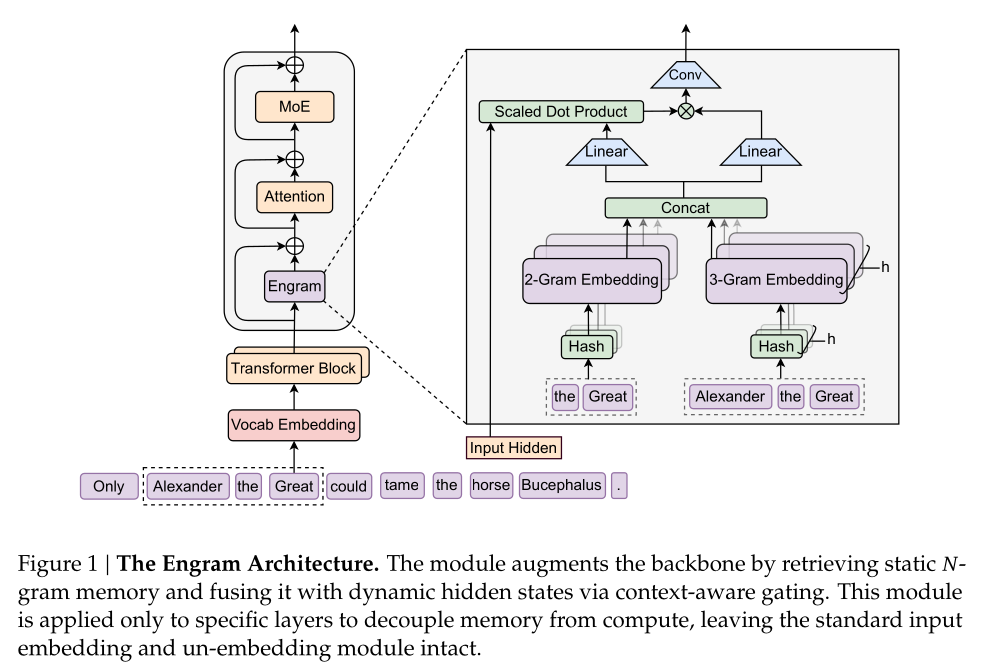
端到端 pipeline(给定输入序列 X = (x_1, ..., x_T) 和第 ℓ 层 hidden states H^(ℓ) ∈ R^{T×d}),每个位置 t 走两个阶段:
- 检索(retrieval):token id 先过词表压缩
P: V → V',取后缀 N-gramg_{t,n} = (x'_{t-n+1}, ..., x'_t);对每个阶n用K个哈希头映射到各自的 embedding 表,取出的向量拼成e_t ∈ R^{d_mem}。这一步完全不依赖 hidden state,只看 token id ——这是后面所有系统优化的前提。 - 融合(fusion):用当前 hidden state
h_t作 Query、e_t作 Key/Value 算一个标量门α_t ∈ (0,1),门控后再过一个短因果深度卷积,输出Y。 - 注入:残差接入
H^(ℓ) ← H^(ℓ) + Y,然后才走标准 Attention 和 MoE。
关键设计选择:Engram 不是每层都加,只插在特定的少数几层(27B 模型是 layer 2 和 15)。这一点同时受建模效果(越早越好)和系统延迟(越深预取窗口越大)两个约束,是典型的算法-系统协同设计。输入 embedding 和 un-embedding 模块保持不动。
子模块实现(可复现细节)
模块 A — Tokenizer Compression(词表压缩)
- 动机:subword tokenizer 以无损重建为目标,会把语义等价的词切成互不相干的 id(
Applevs␣applevsAPPLE)。做 N-gram key 时这会把同一个模式的统计量打散。 - 实现:预计算一个满射
P: V → V',按规范化文本等价性(NFKC 归一化 + 小写化等)把 raw token id 折叠成 canonical id。 - 效果:128k 词表的有效大小降低 23.43%。Top-5 合并组示例(Appendix C):
| Rank | 合并数 | 归一化后 token | 原始 tokens |
|---|---|---|---|
| 1 | 163 | ' ' | \t, \n, \r, ␣, ␣␣, \n\n, … |
| 2 | 54 | 'a' | A, a, ␣a, ␣A, á, ä, ã, ą, … |
| 3 | 40 | 'o' | O, o, ␣o, ␣O, ó, ö, ô, … |
- 消融地位:这是三个最关键组件之一,去掉后 val loss 明显回退。
模块 B — Multi-Head Hashing(多头哈希检索)
- 输入:压缩后的后缀 N-gram
g_{t,n};输出:e_t ∈ R^{d_mem}。 - 公式:对每个阶
n、每个哈希头k,用确定性函数φ_{n,k}映射到表E_{n,k}(表大小M_{n,k}取质数):
z_{t,n,k} ≜ φ_{n,k}(g_{t,n}),    e_{t,n,k} = E_{n,k}[z_{t,n,k}]        (1)

e_t ≜ ‖_{n=2..N} ‖_{k=1..K} e_{t,n,k}                                   (2)
φ_{n,k}实现为轻量 multiplicative-XOR 哈希。直接参数化 N-gram 的组合空间不可行,多头哈希是为了降低碰撞(单头碰撞会让两个语义无关的 N-gram 共享 embedding)。- 27B 配置:
N-gram = [2,3](只用 2-gram 和 3-gram),num_head K = 8,d_mem = 1280,Engram vocab size = 2,262,400(40B 版本 7,239,680)。 - 消融:在固定 1.6B 预算下加 4-gram 反而略差——因为它会稀释更高频的 2/3-gram 的容量。论文不排除更大内存规模下高阶 N-gram 才开始有用。
模块 C — Context-aware Gating(上下文门控)
- 动机:查出来的
e_t是上下文无关的先验,既无法自适应上下文,又可能因哈希碰撞或一词多义带噪。 - 公式(Attention 式的 QKV 结构,但输出是标量门):
k_t = W_K e_t,   v_t = W_V e_t                                          (3)

α_t = σ( RMSNorm(h_t)ᵀ · RMSNorm(k_t) / √d )                            (4)

ṽ_t = α_t · v_t
h_t已经过前面的 attention 层聚合了全局上下文,所以能作为一个”够格”的 Query。RMSNorm 加在 Q 和 K 上是为梯度稳定。- 语义对齐效应:如果检索到的记忆
e_t与当前上下文h_t冲突,α_t → 0,噪声被自动抑制。 - 消融地位:三个最关键组件之一。
模块 D — Short Depthwise Causal Conv(短因果卷积)
- 目的:扩大感受野 + 增加非线性。设
Ṽ ∈ R^{T×d}为门控后的序列:
Y = SiLU( Conv1D(RMSNorm(Ṽ)) + Ṽ ) (5)
- 超参:kernel size
w = 4,dilationδ= 最大 N-gram 阶(即 3),激活 SiLU。 - 卷积参数零初始化,训练起始严格保持恒等映射(不扰动预训练动力学)。
- 消融:去掉它只有边际退化——这是四个组件里最不关键的一个。
模块 E — 与多分支 backbone(mHC)的融合
Backbone 用的是 mHC(Manifold-Constrained Hyper-Connections, M = 4),残差流被展开成 M 条并行分支。Engram 的适配策略:
- 共享:一张 sparse embedding 表 + 一个 Value 投影
W_V,被所有 M 条分支共用。 - 不共享:M 个不同的 Key 投影
{W_K^(m)},让每条分支有各自的门控行为:
α_t^(m) = σ( RMSNorm(h_t^(m))ᵀ · RMSNorm(W_K^(m) e_t) / √d )             (6)

u_t^(m) = α_t^(m) · (W_V e_t)
- 工程收益:一个
W_V+ M 个W_K^(m)可以融进单次 dense FP8 矩阵乘,打满 GPU 算力。 - 消融地位:branch-specific fusion 是三个最关键组件里排第一的。把它换成”在 pre-mapping 后的
H_pre上做单次 Engram 融合”会造成最大的 loss 回退。
模块 F — 系统实现:解耦存储与计算
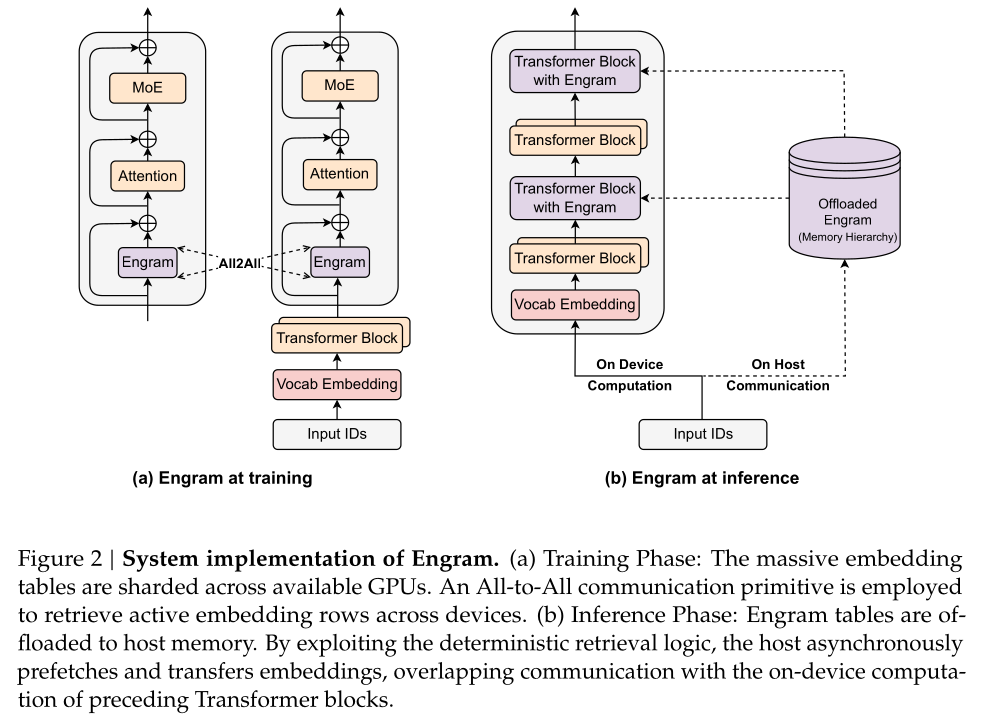
- 训练期:巨大的 embedding 表按模型并行切片分散到各 GPU;前向用 All-to-All 收集激活行,反向用 All-to-All 分发梯度。总内存容量随加速器数量线性扩展。
- 推理期:因为索引在 forward 之前就已确定(只依赖 token id),系统可以异步从 host DRAM 经 PCIe 预取,用前面若干层的计算来掩盖通信延迟。这正是把 Engram 放在较深层(而非 layer 0)的系统理由——放 layer 0 会把访存和计算强制串行化,这也是本文相对 OverEncoding / SCONE 的关键差异点。
- 多级缓存:自然语言 N-gram 服从 Zipf 分布,少数模式占绝大多数访问。因此可以做分层:高频 embedding 缓存在 HBM/Host DRAM,长尾放 NVMe SSD。
- placement 张力:放深 → 预取窗口大(系统喜欢);放浅 → 更早卸载局部模式重建(建模喜欢)。最优位置必须同时满足两个约束。
优化器配置(容易被忽略但很关键)
- Backbone 用 Muon;Engram embedding 单独用 Adam。
- Engram embedding 的 learning rate 是 base lr 的 5×,且 weight decay = 0(base lr 4e-4,backbone wd 0.1)。
- 卷积参数零初始化。
Sparsity Allocation:U 形 scaling law
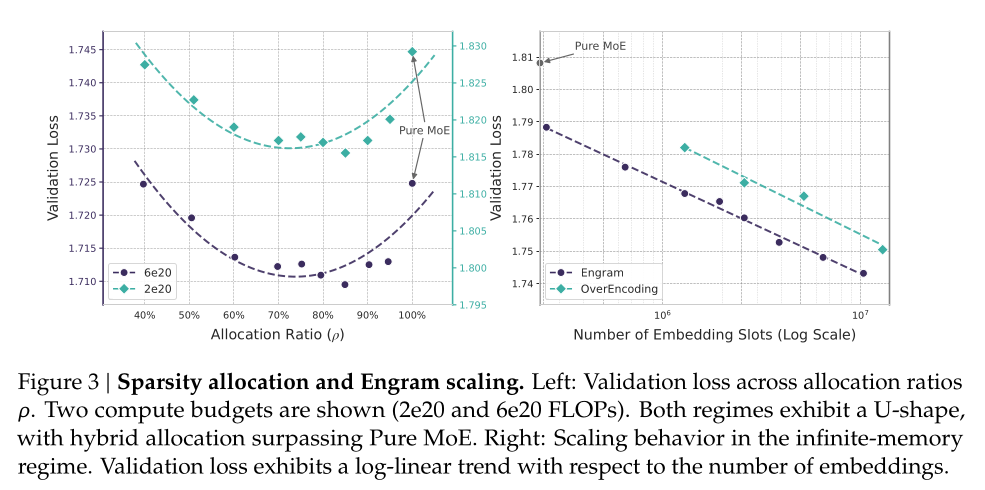
这是论文的第二个核心贡献——把”MoE 和 Engram 怎么分参数预算”形式化成一个可优化问题。
三个参数口径:
P_tot:总可训参数(不含词表 embedding 和 LM head)P_act:每 token 激活参数 → 决定训练 FLOPsP_sparse ≜ P_tot − P_act:非激活参数,即”免费”的扩容预算(未选中的专家 / 未检索的 embedding)
分配比 ρ ∈ [0,1]:
P_MoE^(sparse) = ρ · P_sparse, P_Engram = (1 − ρ) · P_sparse (7)
ρ = 1 即纯 MoE;ρ < 1 减少 routed expert 数、把省下的参数换成 Engram slot。实验严格固定 P_tot 和 P_act(iso-parameter + iso-FLOPs),只调专家数和 slot 数。
实验设置:两个算力档,保持稀疏率 P_tot/P_act ≈ 10
C = 2×10²⁰FLOPs:P_tot ≈ 5.7B,P_act = 568M,baseline 106 专家C = 6×10²⁰FLOPs:P_tot ≈ 9.9B,P_act = 993M,baseline 99 专家
结论:
- 两个算力档都呈现清晰的 U 形。
- 纯 MoE 是次优的:把 20–25% 的稀疏预算挪给 Engram 最优。10B 档 val loss 从
ρ=100%的 1.7248 降到ρ≈80%的 1.7109(Δ = 0.0139)。 - 最优点位置跨规模稳定在
ρ ≈ 75%–80%。 - 即便把 MoE 砍到只剩
ρ ≈ 40%(5.7B 模型只剩 46 个专家),性能仍持平纯 MoE baseline。 - 两端都变差说明二者结构互补:
ρ→100%缺静态记忆,只能用深度重建;ρ→0%缺条件计算,动态推理受损——记忆替代不了计算。
无限内存 regime(右图):固定 3B MoE backbone(P_act = 568M,训 100B tokens),slot 数从 2.58×10⁵ 扫到 1.0×10⁷(最多加 ~13B 参数)。Val loss 随 slot 数呈严格幂律(log 空间线性)——内存是一个可预测的 scaling 旋钮,且不增加任何计算。对比 baseline OverEncoding(把 N-gram embedding 直接与词表 embedding 平均),Engram 在同样内存预算下解锁的 scaling 潜力显著更大。
实验设置与结果
预训练主结果
四个模型,全部 262B tokens、同一数据课程(同 token 预算同顺序)、激活参数严格对齐 3.8B。Backbone:30 层、hidden 2560、MLA 32 头、mHC expansion 4、DeepSeek-V3 tokenizer(128k)、seq len 4096、batch 1280、50k steps。
| 模型 | 总参 | 激活参 | 专家配置 | Engram 参数 |
|---|---|---|---|---|
| Dense-4B | 4.1B | 3.8B | — | — |
| MoE-27B | 26.7B | 3.8B | 2 shared + 72 routed (top-6) | — |
| Engram-27B | 26.7B | 3.8B | 2 shared + 55 routed (top-6) | 5.7B (ρ=74.3%) |
| Engram-40B | 39.5B | 3.8B | 2 shared + 55 routed (top-6) | 18.5B |
关键 benchmark(Engram-27B vs iso-param/iso-FLOPs 的 MoE-27B):
| 类别 | Benchmark | MoE-27B | Engram-27B | Δ | Engram-40B |
|---|---|---|---|---|---|
| LM | Validation loss ↓ | 1.634 | 1.622 | −0.012 | 1.610 |
| LM | Pile loss ↓ | 1.960 | 1.950 | −0.010 | 1.942 |
| 知识 | MMLU | 57.4 | 60.4 | +3.0 | 60.6 |
| 知识 | MMLU-Redux | 60.6 | 64.0 | +3.4 | 64.5 |
| 知识 | MMLU-Pro | 28.3 | 30.1 | +1.8 | 31.3 |
| 知识 | CMMLU | 57.9 | 61.9 | +4.0 | 63.4 |
| 知识 | C-Eval | 58.0 | 62.7 | +4.7 | 63.3 |
| 知识 | CCPM | 79.6 | 87.1 | +7.5 | 87.7 |
| 推理 | BBH | 50.9 | 55.9 | +5.0 | 57.5 |
| 推理 | ARC-Challenge | 70.1 | 73.8 | +3.7 | 76.4 |
| 推理 | AGIEval | 38.6 | 41.8 | +3.2 | 45.9 |
| 阅读 | DROP (F1) | 55.7 | 59.0 | +3.3 | 60.7 |
| 阅读 | RACE-High | 75.4 | 78.2 | +2.8 | 79.2 |
| 代码 | HumanEval | 37.8 | 40.8 | +3.0 | 38.4 |
| 代码 | MBPP | 46.6 | 48.2 | +1.6 | 46.2 |
| 数学 | GSM8K | 58.4 | 60.6 | +2.2 | 62.6 |
| 数学 | MATH | 28.3 | 30.7 | +2.4 | 30.6 |
| 数学 | MGSM | 46.8 | 49.4 | +2.6 | 52.4 |
最值得注意的一点:直觉上记忆模块只该帮知识题,但通用推理(BBH +5.0)和代码数学(HumanEval +3.0 / MATH +2.4)的增益反而更大。这说明加一条查表原语提升的是表示效率本身,而不只是知识容量。
Engram-40B 进一步降低 loss,但没在每个任务上严格压过 27B——论文归因为欠训练(40B 与 baseline 的 loss gap 在训练末期仍在扩大,18.5B 记忆容量还没吃饱)。
长上下文
预训练后做 32768 上下文扩展:YaRN(s=10, α=1, β=32, f=0.707),5000 steps / 30B 高质量长文本 token。
评测的方法论亮点:长上下文能力与 base 模型能力强耦合,所以严格的架构对比必须对齐预训练 loss 而非训练步数。因此选了 Engram-27B 的 41k / 46k 中间 checkpoint,其中 46k 的预训练 loss 恰好等于完整训练的 MoE-27B(50k)的 1.63,构成 Iso-Loss 对照。
| 设置 | LongPPL-Book ↓ | NIAH-MQ ↑ | VT ↑ | FWE ↑ | QA ↑ |
|---|---|---|---|---|---|
| MoE-27B (50k, loss 1.63) | 4.38 | 84.2 | 77.0 | 73.0 | 34.5 |
| Engram-27B (41k, loss 1.66) — 仅 82% FLOPs | 4.37 | 89.5 | 83.2 | 99.6 | 44.0 |
| Engram-27B (46k, loss 1.63) — Iso-Loss | 4.19 | 97.0 | 87.2 | 98.6 | 37.5 |
| Engram-27B (50k, loss 1.62) — Iso-FLOPs | 4.14 | 97.0 | 89.0 | 99.3 | 40.5 |
- Iso-Loss 下(46k vs 50k baseline):Multi-Query NIAH 97.0 vs 84.2,Variable Tracking 87.2 vs 77.0,Frequent Words Extraction 98.6 vs 73.0。
- 只用 82% 预训练算力的 41k checkpoint,LongPPL 已持平 baseline、RULER 全面超越。
- 机理解释:把局部依赖外包给查表,腾出了注意力容量去处理全局上下文。
机理分析:Engram ≈ 加深网络
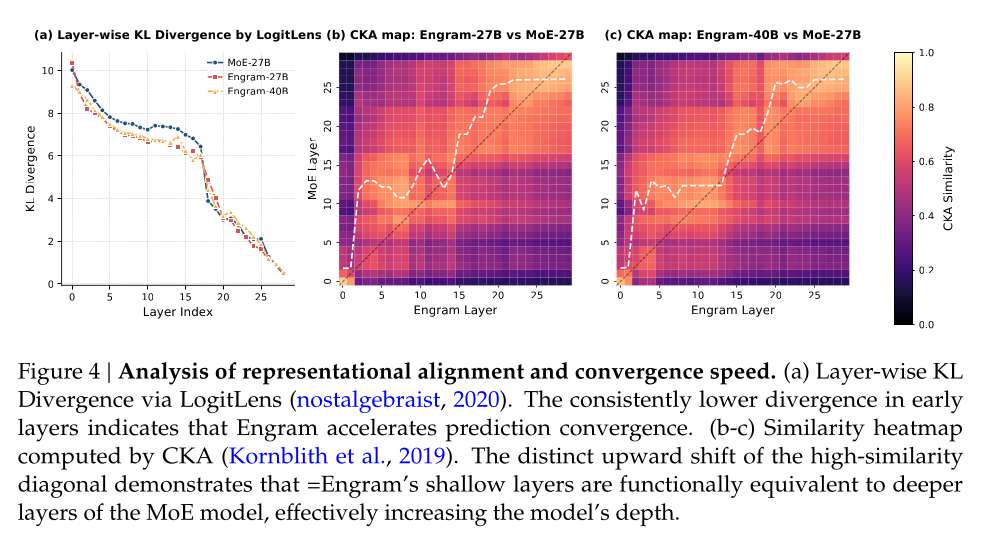
两个可解释性工具验证”等效加深”假说:
-
LogitLens(图 a):用最终 LM Head 投影每层 hidden state,算它与最终输出分布的 KL 散度(衡量表示离”预测就绪”有多远)。两个 Engram 变体的 KL 在所有层都更低,早期层差距最明显,下降更陡——说明特征组装完成得更早。
-
CKA(图 b/c):用线性核 Gram 矩阵
K = XXᵀ、L = YYᵀ:
CKA(K, L) = HSIC(K, L) / √( HSIC(K,K) · HSIC(L,L) ) (8)
在 Few-NERD 数据集上抽命名实体最后一个 token 的 hidden state。定义 soft alignment index(top-k 加权质心,k=5)作为”Engram 第 j 层对应 MoE 的有效深度”:
a_j = Σ_{i∈I_j} S_{i,j} · i / Σ_{i∈I_j} S_{i,j}, I_j = argtop_k_i(S_{i,j}) (9)
结果:高相似度对角线明显向上偏移(a_j > j)。例如 Engram-27B 的第 5 层,表征上最接近 MoE baseline 的第 12 层。这直接证实了核心假说:跳过早期特征组装 ≈ 增加有效深度。
组件消融与层敏感性
3B MoE backbone(12 层,0.56B 激活),训 100B tokens,baseline val loss 1.808。参考配置:1.6B Engram,{2,3}-gram,插在 Layer 2 和 6,val loss 1.768(Δ = 0.04)。
- 插在哪一层:把 1.6B 合成单个模块扫 layer 1→12,Layer 2 最优(1.770),比 Layer 1 好,越深越差。解释是一个张力——早插能在 backbone 耗费深度前就卸载局部模式;但早期 hidden state 还没通过 attention 聚够全局上下文,门控精度差、并行分支也缺乏表征分化。一轮 attention 就足以提供够用的上下文 query。
- 分两处更好:同样 1.6B 拆成两个更小模块(降
d_mem)放 Layer 2 + 6,val loss 1.768 < 单点 1.770。兼顾早期干预与后期富上下文门控,且对内存层级更友好(系统侧优势)。 - 组件重要性排序(去掉后 loss 回退幅度):
multi-branch 分支专属融合>tokenizer 压缩≈context-aware gating≫short conv(边际);加 4-gram 在固定预算下略负。
功能敏感性:记忆装的是什么
推理时完全屏蔽 Engram 输出(backbone 不变),看各任务保留多少性能:
| 任务类型 | 保留性能 | 代表 |
|---|---|---|
| 事实知识 | 29–44%(崩溃) | TriviaQA 29%,PopQA 36%,TriviaQA-ZH 44% |
| 数学/算法推理 | 44–68% | MATH 44%,GSM8K 62% |
| 代码 | 72–76% | HumanEval / MBPP |
| 常识推理 | 78–85% | HellaSwag, ARC-C, PIQA |
| 阅读理解 | 81–93%(几乎不受影响) | C3 93%,RACE-Middle 89%,DROP 84% |
功能二分非常干净:Engram 是参数化知识的主要仓库;而依赖上下文接地的阅读理解主要靠 backbone 的注意力,几乎不动。
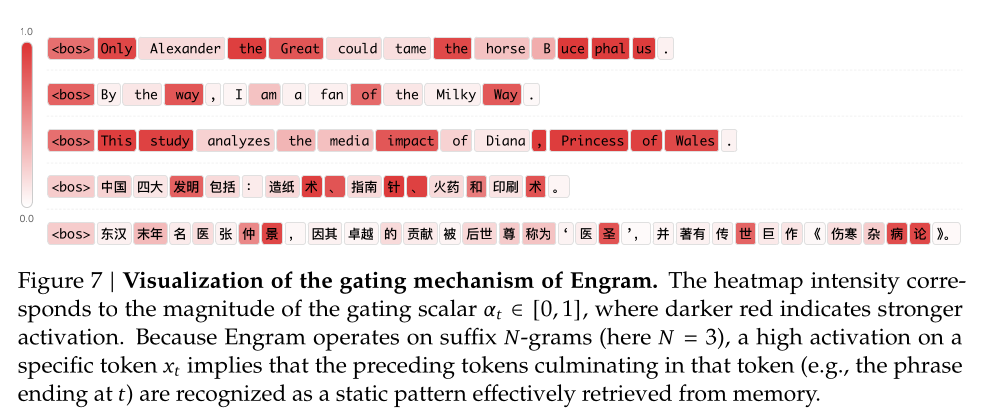
门控可视化(Figure 7)定性验证:α_t 在多 token 命名实体(“Alexander the Great”、“the Milky Way”、“Princess of Wales”)和固定搭配(“By the way”)上强激活,且跨语言泛化——中文样本上在”四大发明”、“张仲景”、“伤寒杂病论”这类成语和历史实体上激活。因为用的是后缀 N-gram,某个 token 上的高激活意味着以它结尾的短语被识别为静态模式。
系统吞吐
基于 nano-vLLM 的推理 harness,把一个 100B 参数的 Engram 层整个 offload 到 host DRAM,插在第 2 个 Transformer block,异步预取与第 1 个 block 的计算 overlap。H800,512 条序列,长度 Uniform(100, 1024):
| Base Model | 配置 | 吞吐 (tok/s) | 开销 |
|---|---|---|---|
| Dense-4B | Baseline | 9,031.62 | — |
| Dense-4B | + 100B Engram (CPU offload) | 8,858.28 | −1.9% |
| Dense-8B | Baseline | 6,315.52 | — |
| Dense-8B | + 100B Engram (CPU offload) | 6,140.02 | −2.8% |
关键点:每步的有效通信量取决于激活的 slot 数,而非表的总大小。而且这还是保守下界——实验强制所有检索都走 PCIe,没有用 §2.5 的 Zipf 局部性缓存;真做了分层缓存开销会更低。这意味着 Engram 事实上绕开了 GPU 显存对参数量的约束。
思考与可参考价值
这篇的真正贡献在哪
不在”用 N-gram embedding”——N-Grammer、OverEncoding、SCONE、BLT、SuperBPE、DeepEmbed、PLE 都做过类似的事。这篇的差异是三点:
- 把它上升成一条与 MoE 并列的架构原语(conditional memory),并给出可优化的 Sparsity Allocation 框架。之前的工作大多把 N-gram embedding 当”外挂增强”,没有在严格 iso-parameter + iso-FLOPs 下验证。论文点名 OverEncoding 在稀疏 MoE backbone 上即使非等参也拿不到有意义提升,SCONE 则依赖额外训练 FLOPs 的辅助模块。
- 算法-系统协同设计。既往方案都把 embedding 放在 Layer 0,访存与计算被强制串行;Engram 有意放深层来做 overlap,并用 Zipf 分布论证内存层级。这是”因为系统约束而改变建模位置”的少见例子。
- 机理解释是 U 形 law 的因果说明,不是事后包装。LogitLens + CKA 的”有效深度上移”给了 BBH/HumanEval 这些非知识任务为什么也涨的解释。
局限
- Engram-40B 没有严格压过 27B,论文自己归因欠训练,但 262B tokens 下”更大记忆表反而在部分任务变差”这件事没有被排除掉别的可能(例如更大表下 2/3-gram 稀释、长尾 slot 训练不足)。
- 只做到预训练 + 长上下文扩展,没有 SFT/RLHF 阶段的结果。静态记忆在指令跟随和 RL 阶段是否稳定(比如门控会不会被 RL 破坏)完全未知。
- 敏感性分析用 post-hoc 屏蔽,制造了 train-inference 不一致,论文自己也承认这在混合能力任务上信噪比低,只敢用两个极端类别下结论。
- N-gram 只到 3 阶,本质仍是很局部的模式。跨句、跨文档的”静态知识”仍然只能靠 backbone。
- 知识更新问题没碰:这张表虽然是”记忆”,但仍是训练出来的参数,不是可编辑的外部 KV store——比 RETRO/REALM 那类非参数记忆少了可编辑性。
对电商 / 搜推 / Agent 方向的可借鉴点
最直接的映射:这套东西本质上就是把推荐系统的 embedding table 工程搬进了 LLM。 论文的 Related Work 也专门写了 High-Cardinality Categorical Embeddings 一节,承认与 multi-hash、frequency-aware hashing、混合维度 embedding 是同一类问题。反过来看,对做搜推的人这篇的可迁移点是:
- “哪些信号该查表、哪些该算”这个分解值得直接用。搜推里同样存在两类信号:静态的(item 属性、类目、品牌、固定搭配 query)和动态的(用户当下意图、上下文序列)。目前很多生成式推荐/LLM4Rec 的做法是把商品信息统统塞进 prompt 让模型”算”,这正是论文批判的”用计算模拟检索”。用一条 O(1) 查表原语接管静态 item/query 知识,把 Transformer 深度留给意图推理,是一个很干净的架构方向。
- U 形 allocation law 的方法论可以直接照搬做实验设计:固定
P_tot和P_act,扫分配比 ρ,找互补最优点。这个 iso-param + iso-FLOPs 的对照协议本身就比大多数”加个模块涨点”的消融严谨得多。 - 上下文门控
α_t = σ(RMSNorm(h)ᵀRMSNorm(k)/√d)是个便宜且好用的去噪原语。在 ID 特征碰撞、embedding 带噪(冷启 item、hash 冲突)的场景下,用当前上下文做 Query 去打分静态 embedding、冲突时自动压到 0,比硬拼接或直接相加要稳。而且它天然可解释——Figure 7 的可视化就是免费的诊断工具。 - 确定性寻址 → 可预取 → 可 offload,这个链条对成本敏感的线上服务价值很大。搜推的大 embedding table 同样是确定性寻址(ID 已知),同样服从 Zipf。100B 参数表 offload 到 host 只掉 2%,意味着”参数量不再受显存约束”这件事在推理侧是真的可行的。反过来,MoE 的动态路由拿不到这个好处——这是选型时值得记住的结构性差异。
- 对做 Agent 的启示更间接但也有:长上下文 RULER 的大幅提升(NIAH-MQ 84.2 → 97.0)说明卸载局部依赖能换来全局注意力预算。长程 agent 轨迹里有大量模式化的、重复出现的局部结构(工具调用格式、固定 schema、模板化的观察),如果能用类似机制查表接管,理论上能把注意力让给真正的跨步推理。