ELF: Embedded Language Flows
MIT
把 Diffusion Language Model 的「连续」推到极致——从 token embedding 起,整条 denoise 轨迹都待在连续 embedding 空间,只在最后一步 t=1 才离散化;而且 denoiser 和 decoder 共享同一份网络权重(用 mode token 切分支),没有独立 decoder。配合 x-prediction + Flow Matching 的 rectified-flow 路径,让 image-domain 的 CFG / SDE 采样器自然迁移过来。
核心思路
问题:连续扩散语言模型(continuous DLM)长期被离散 DLM(MDLM/Duo)碾压。作者的关键判断是——这不是「语言天生离散」的锅,而是已有连续派给连续轨迹加了太多 discrete leash(每步 rounding 损失、simplex 约束、中间步 token-level cross-entropy),把 flow dynamics 绑死在词表上。
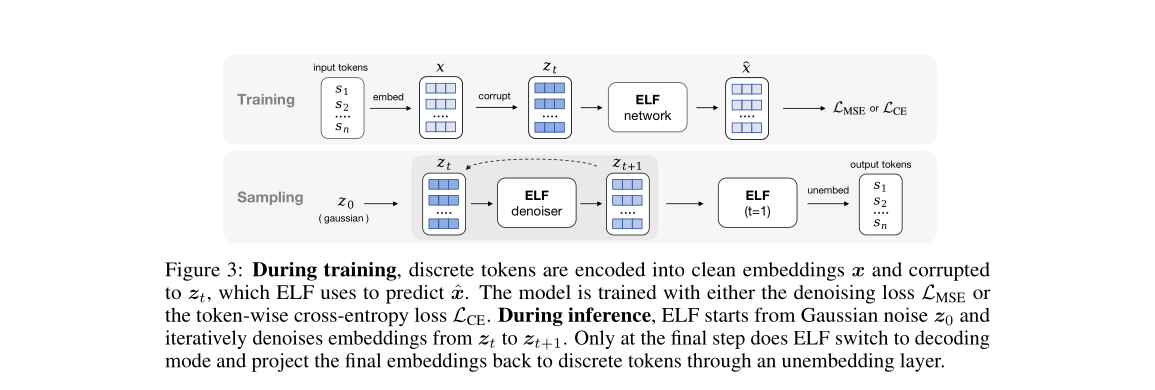
关键 idea:让 denoising 轨迹整段都留在 unrestricted 连续 embedding 空间,只在 Flow Matching 的最后一个时间步 t=1 做离散化——而这一步天然就是 continuous→discrete 解码,于是不需要独立 decoder,可以用同一份网络权重既做去噪(denoise mode)又做解码(decode mode),靠一个 binary mode token 切分支。范式上三件套缺一不可:(1) 在冻结 T5 encoder 给出的 contextual embedding 上做 rectified-flow;(2) 用 x-prediction(预测干净 embedding)而非 v-prediction,让 MSE 去噪损失与最后一步的 CE 解码损失能在共享权重下兼容;(3) self-conditioning 充当 CFG 的 condition,把图像扩散里成熟的 classifier-free guidance、SDE 采样、x-prediction 整套工具无缝搬过来。结果:32 步、45B 训练 token、无 distillation,就压过 500B+ token 的离散 / 连续 baseline 及其 distilled 变体。
整体实现思路
端到端 pipeline(训练 + 推理共用一张网络 net_θ(z, t, mode)):
- 编码:离散 token 序列
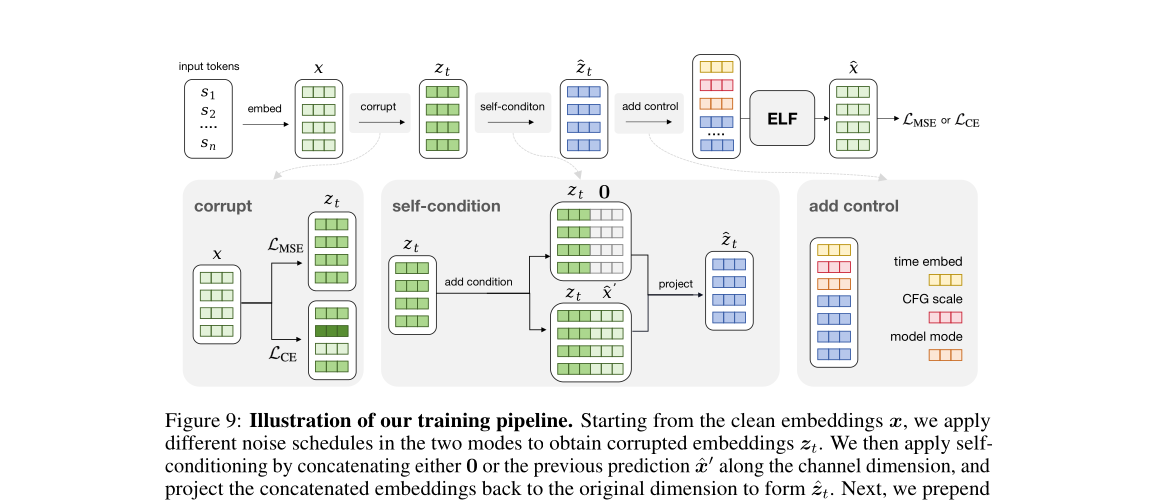
s = [s_1,…,s_L] ∈ V^L→ 冻结 pretrained T5-small encoder(35M,512-d 上下文 embedding)→ 线性投到 128-d bottleneck 再投到模型 hidden(768)。encoder 只在训练用,推理不引入额外模块。先用 OWT 估计的 mean/std 对 clean embeddingx做归一化。 - 加噪(两分支,单 batch 用 mask 分流):
- denoise 分支(80%):任意
t∈[0,1],线性插值z_t = t·x + (1−t)·ε,target velocityv = x − ε。 - decode 分支(20%,固定
t=1):因z_t → x(无信息),改用 per-token 损坏z̃ = p·x + (1−p)·ε制造非平凡输入。
- denoise 分支(80%):任意
- self-conditioning + control token:把上一次预测
x̂'(或 0)沿 channel 维 concat 进z_t,linear 投回原维得ẑ_t;再 prepend control token(time / CFG scale / model-mode)。 - ELF 网络:标准 DiT(SwiGLU+RMSNorm+RoPE+qk-norm,in-context conditioning 取代 adaLN-Zero),双向 self-attention,输出
x̂。 - 损失:denoise 分支
L_MSE(带(1−t)^{-2}权重),decode 分支x̂过可学习 unembeddingW出 logits 算L_CE。 - 推理:从
z_0 ∼ N(0,I)起,按 logit-normal 时间网格用 ODE(Euler)或 SDE 采样器迭代z ← z + dt·v(v = (x̂ − z)/(1−t)),最后一步切 decode mode → unembed → argmax 出 token。
子模块实现(可复现细节)
1) Embedding 空间构造(encoder + bottleneck)
- 输入/输出:token 序列 → 512-d T5-small contextual embedding → 128-d bottleneck → 768-d 模型空间。
- 为什么 bottleneck=128:假设自然语言数据落在高维 embedding 空间里的低维 manifold 上。消融对比 32/128/512:32 维 Gen.PPL 最低但 entropy 偏低(多样性差),512 维 entropy 高但 Gen.PPL 显著恶化,128 维是最佳折中。
- embedding 选择消融结论(按 Gen.PPL–entropy 前沿排序):pretrained T5 contextual > scratch encoder(OWT 上 T5 目标自训)> pretrained T5 token(非上下文)> frozen Gaussian > learnable(最差,联合优化 embedding+denoiser 太难)。上下文 embedding 是关键。
2) Flow Matching + x-prediction(denoise 分支)
-
插值:
z_t = t·x + (1−t)·ε,t∈[0,1],z_0∼p_noise、z_1∼p_data;velocityv = dz/dt = x − ε。 -
x-prediction 损失(核心公式,
x_θ = net_θ(z_t,t)是网络直接输出):利用关系
v(z_t,t) = (x − z_t)/(1−t)。 -
为什么必须 x-prediction(而非 v / ε):① 高维(768-d/token)下 ε-prediction 全面崩溃、v-prediction 在 512-d 可用但 768/1024-d 退化,x-prediction 跨维度稳定(符合「干净数据落低维 manifold」假设);② x 预测天然对齐末步「预测干净 token」,让去噪 MSE 与解码 CE 能共享权重——若用 v-prediction,与末步离散化共享权重时经验上会崩。
-
time 采样:denoise 分支
t从 logit-normal 采样:t' ∼ N(P_mean, P_std²),t = σ(t'),全程P_mean=−1.5, P_std=0.8;高斯噪声额外乘 noise scale 2.0。
3) 共享权重 decoder(decode 分支,t=1)
- 输入/输出:per-token 损坏的
z̃ = p·x + (1−p)·ε(p是 per-token 损坏度)→ 同一网络在mode="decode"下出x̂→ unembeddingW→ logits。 - CE 损失:
L_CE = E_{z̃}[ CrossEnt(W·x_θ(z̃), s) ],推理时只在t=1评W·x_θ(z_t)再 argmax。 - per-token 损坏调度:
p ∼ logit-normal(P_mean=0.8, P_std=0.8),ε乘 noise scale(OWT 用 5.0,conditional 用 1.0)。同一句内各 token 损坏度不同,迫使 decoder 借上下文恢复被去噪器在推理时弄脏的不完美 embedding,提升末步离散化鲁棒性。 - denoise vs decode 配比:单 batch 内用 mask 选分支,denoise 概率 0.8(消融:0.8 > 0.5 > 0.2,去噪需要足够训练,0.2 在 SDE 下明显恶化)。
- shared vs separate decoder 消融:另训一个 separate decoder(冻结 encoder、mask 20% token、加 logit-normal 噪
P_mean=0.5,P_std=1.0、3 epoch)与 shared 权重前沿相近,但 shared 能延伸到更低 Gen.PPL 区且省一个训练阶段。
4) Self-conditioning + training-time CFG
-
self-conditioning:第二次前传以前一步
x̂'(stop-grad)作 condition,x̂ = net_θ(z_t | x̂', t),实现为 channel 维 concat[z_t, x̂']再 linear 投回。训练时 50% 用x̂'、50% 用 null 0;推理时直接用上一时间步预测,不增加前传次数。decode 分支恒用 0。 -
CFG:把 self-conditioning 的
x̂'当 conditionc。标准 CFG 是v_cfg(z_t|c) = ω·v(z_t|c) + (1−ω)·v(z_t|∅),需推理双前传。ELF 用 training-time CFG,让网络直接拟合 post-combination 量,regression target:ω=1时退化为无 CFG。每样本从[0.5,5.0](偏小值的幂分布)采 self-conditioning CFG scalew,因为 x-prediction,v 都由 x 预测换算。 -
control token(in-context conditioning):prepend 各 4 个 time / CFG-scale / model-mode token(连续值用 positional embedding 编码),共 12 个 control token。相比 adaLN-Zero:in-context 略好且省参数(ELF-B 148M→105M)。
-
conditional 生成:把 condition 序列的 clean embedding(不加噪)prepend 在 control token 之后、target 之前,靠 self-attention 条件化;训练时 10% 概率 zero-out condition 以学无条件分支,支持 input-condition CFG。
5) 采样器(ODE / SDE)
- ODE step:
x̂=net(z,t,denoise);v=(x̂−z)/(1−t);z ← z + dt·v。 - SDE step(每步注入小噪 + 把 t 往噪声侧 shift,等效单步随机扰动):
α = 1 − γ·dt;t_back = α·t;z_back = α·z + (1−α)·ε;x̂=net(z_back, t_back, denoise);v=(x̂−z)/(1−t);z ← z + dt·v。γ=0退化为 ODE。 - time schedule:推理用 logit-normal 网格(
P_mean=−1.5,P_std=0.8,与训练对齐),t 近 0 处间隔更细——few-step 下比 uniform 显著更好。 - γ 选择:消融 γ∈{0,0.1,0.5,0.75,1,1.5,2},γ 调控 Gen.PPL–entropy 折中,默认 γ=1.0;system 级 8/16 步用 γ=2,32 步用 γ=1.5(长轨迹需更少随机纠正)。SDE 在 8–32 步显著优于 ODE(随机性纠正早期去噪误差,而非像 ODE 确定性放大)。
关键超参(ELF-B 默认)
| 项 | 值 | 项 | 值 |
|---|---|---|---|
| Encoder | T5-small (35M) | Optimizer | Muon |
| Emb dim / bottleneck / model dim | 512 / 128 / 768 | Learning rate | 0.002 |
| Sequence length | 1024 | Weight decay | 0 |
| Denoiser (P_mean,P_std) / noise scale | (−1.5, 0.8) / 2.0 | Batch size | 512 |
| Decoder (P_mean,P_std) / noise scale | (0.8, 0.8) / 5.0 | Epochs (OWT) | 5 (≈95K steps) |
| Denoise vs decode prob | 0.8 vs 0.2 | LR schedule / warmup | constant / 0.5 ep |
| Self-cond prob / CFG range | 0.5 / [0.5,5] | EMA decay | 0.9999 |
| #time / #mode / #CFG tokens | 4 / 4 / 4 | SDE γ | 1.0 |
模型规模(Tab.3):ELF-B 12 层/768/12 头/105M(5 ep)、ELF-M 24/1056/16/342M(4 ep)、ELF-L 32/1280/16/652M(3 ep)。训练于 TPU v5p×64,约 1.5h/epoch。
实验设置与结果
无条件生成(OWT,9.04B token,L=1024):生成 1000 样本,用 GPT-2 Large 评 Gen.PPL(越低越好)+ unigram entropy(多样性,越高越好,不用 validation PPL 因 flow 模型似然评估需额外训练)。
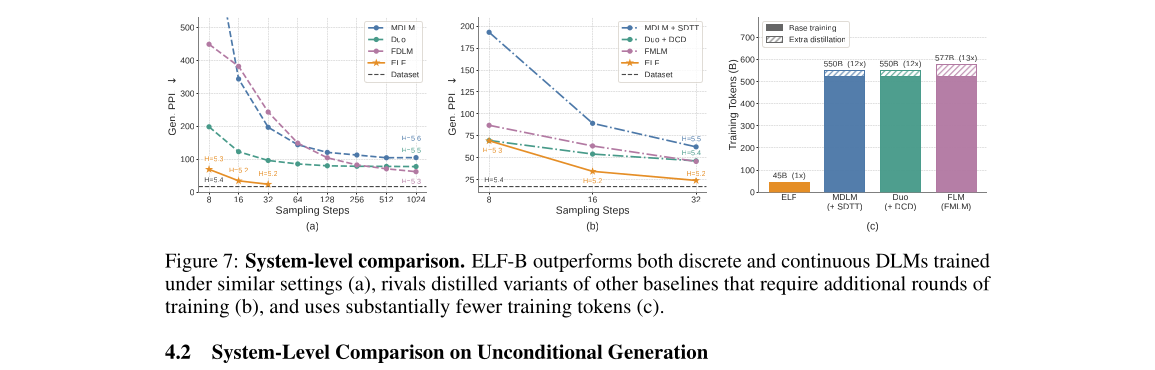
System-level(Fig.7):ELF-B(105M,SDE + self-cond CFG=3)vs MDLM/Duo/FLM/LangFlow(~170M)。ELF 32 步即达 Gen.PPL≈24,远少于对手的采样步数;无 distillation 就压过 distilled 的 MDLM+SDTT / Duo+DCD / FMLM;训练 token 仅 45.2B,对手 524–577B(10–13×)。
Scaling(Tab.7,64 步)关键数字(Gen.PPL / Entropy):
| Sampler | SC CFG | ELF-B 105M | ELF-M 342M | ELF-L 652M |
|---|---|---|---|---|
| SDE | 1.0 | 29.50 / 5.23 | 33.45 / 5.30 | 31.82 / 5.37 |
| SDE | 2.0 | 22.53 / 5.14 | 25.34 / 5.23 | 26.47 / 5.32 |
| SDE | 3.0 | 19.72 / 5.10 | 21.69 / 5.18 | 23.31 / 5.28 |
| ODE | 1.0 | 65.30 / 5.40 | 62.47 / 5.44 | 49.72 / 5.45 |
| ODE | 3.0 | 26.62 / 5.15 | 28.80 / 5.24 | 26.57 / 5.29 |
放大模型一致推动 Gen.PPL–entropy 前沿(同 entropy 下更低 PPL);SC CFG>3 收益递减。System few-step(Tab.6,6 seed):8 步 67.3、16 步 33.7、32 步 24.1,步数越多 SE 越小。
条件生成(Tab.1):WMT14 De-En(L=128,BLEU)+ XSum(L=1088,ROUGE)。最佳配置:64 步 ODE + self-cond CFG=1 + input-condition CFG=2。
| Model | Size | De-En BLEU↑ | XSum R-1↑ | R-2↑ | R-L↑ |
|---|---|---|---|---|---|
| AR | 99M | 25.2 | 30.5 | 10.2 | 24.4 |
| MDLM | 99M | 18.4 | 33.4 | 11.6 | 25.8 |
| Duo | 170M(+35M) | 21.3 | 31.4 | 10.1 | 25.0 |
| E2D2 | 99M | 24.8 | 28.4 | 8.3 | 22.0 |
| CDCD | – | 24.9 | – | – | – |
| ELF (ours) | 105M(+35M) | 26.4 | 36.0 | 12.2 | 27.8 |
ELF 在两个任务全面最优。条件 CFG 消融(Fig.16):CFG 1→2 显著涨点,CFG=2 最佳,过强反降。
其他消融结论:① prediction target:x > v(高维退化)> ε(全维崩);② in-context > adaLN-Zero(略好且省参);③ Muon > AdamW(同步数更低 loss、更优前沿,尤其 SDE 下);但换 AdamW 仍超 baseline,说明强不是靠优化器。
思考与可参考价值
局限:① 主网络依赖 35M T5 encoder 提供 data manifold——宣传「无额外 inference module」成立,但训练侧 dependency 真实存在,embedding 质量是隐性天花板(scratch encoder 略差于 pretrained);② 评估仍是 unconditional OWT + WMT/XSum 传统三件套,缺 instruction tuning / reasoning / 长文 QA / chat;③ few-step 下限仍 16–32 步,真正单步生成还得 distill,相对 AR per-token 单 step 仍有差距;④ 末步 token-level CE 只占 20% 训练,长尾词 / OOV 表现未探;⑤ 方法当前停在 seq2seq,离 LLaDA 式 chat 还有距离。
对电商 / 生成式推荐:若 item embedding 已稳定(类比 T5 给出 fixed manifold),生成式推荐可直接在 item embedding 空间做 flow,末步 argmax 出 item id,绕开为超大 vocabulary 设计 categorical diffusion 的难题。x-prediction + shared denoiser-decoder 范式天然契合「label space 巨大但 embedding 已稳」的电商场景;bottleneck(128-d)思路也提示:item 表征落低维 manifold 时,压缩去噪空间能同时提质量与多样性。
对搜索推荐:CFG 在 conditional 生成上「适度引导(scale=2)涨点、过强反降」的规律可直接迁到「query/context 引导的候选生成」;training-time CFG 让引导强度变成一个推理时可调的 input(不增前传),等价于一个可在线调的「相关性 vs 多样性」旋钮,对召回/重排的探索-利用很实用。
对 Agent / RL:当前 reasoning RL 几乎都在 token space 跑 GRPO,ELF 暗示「在连续 embedding 上 iterative refine + 末步出 token」的 reasoning chain 可能更样本高效(轨迹不被词表绑死、SDE 注噪纠错);mean-flow / training-time CFG 也为 prompt 优化 / preference alignment 提供了新的连续侧 entry point。与同期字节 Cola DLM 互为镜像(Cola 学 latent prior 再投 token,ELF 直接在原 embedding flow + 末步合一),两条路径都拒绝 token-space diffusion,相互佐证「连续派可行」。