DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation
Peking University × DeepSeek-AI
把投机解码的两个瓶颈——草稿质量与验证开销——各用一个正交机制解决。① 语义上,并行 drafter 因位置间独立而产生「多模碰撞」导致后缀接受率崩塌,DSpark 用半自回归结构(重并行骨干 + 轻量串行头)在几乎不增延迟的前提下注入块内依赖;② 系统上,固定验证长度在高并发下是净浪费,DSpark 用置信度头预测逐位置「前缀存活概率」,配合硬件感知调度器把验证长度形式化成全局吞吐最大化问题按负载动态裁剪。关键概念区分是「verify smarter, not longer」:投机解码的收益上限不由草稿长度决定,而由验证预算的边际回报决定。线上 DeepSeek-V4 实测把 Pareto 前沿整体外推。
核心思路
问题:投机解码的每 token 延迟是
L = (T_draft + T_verify) / τ (1)
τ = 每轮被接受的 token 数。所以提速只有三个杠杆:draft faster(降 T_draft)、draft better(升 τ)、verify smarter(降有效 T_verify)。既有工作各占一端,都有硬伤:
| 路线 | 代表 | T_draft | 问题 |
|---|---|---|---|
| 自回归 drafter | Eagle3 | O(γ) ——随块大小线性增长 | 被迫用小 γ + 浅网络,容量受限 |
| 并行 drafter | Medusa / DFlash | O(1) ——一次前向出全部 | 位置间独立 → 多模碰撞、后缀接受率崩塌 |
多模碰撞(multi-modal collision)是并行 drafter 的结构性缺陷,论文给的例子极清楚:上下文同时允许 “of course” 和 “no problem” 两种延续,并行 drafter 每个位置都在对所有可能前驱做边缘化而非条件于实际采样到的那一个,于是会产出 “of problem” / “no course” 这种缝合怪。
第二个瓶颈在系统侧:并行 drafter 能轻松产出长草稿块,但无差别验证全部草稿会拖垮吞吐。理想验证长度沿两个轴变化——数据侧(代码这类结构化文本接受率天然高于开放聊天)、系统侧(轻载时多验一个几乎免费,重载时每一个无谓验证都在占用本可服务其他请求的 batch 容量)。
关键 idea:两个瓶颈用两个正交机制打。
- 半自回归生成:保留重并行骨干(
T_draft仍近似 O(1)),只挂一个轻量串行头注入块内局部依赖 → 缓解后缀衰减,升τ。 - 置信度调度验证:置信度头预测逐位置前缀存活概率,硬件感知调度器按实时引擎吞吐曲线把验证预算只投给期望回报为正的 token → 降有效
T_verify。
整篇最值得记住的一句是 “Verify Smarter, Not Longer”:投机解码的收益上限不由草稿能产多长决定,而由验证预算的边际回报决定。
整体实现思路
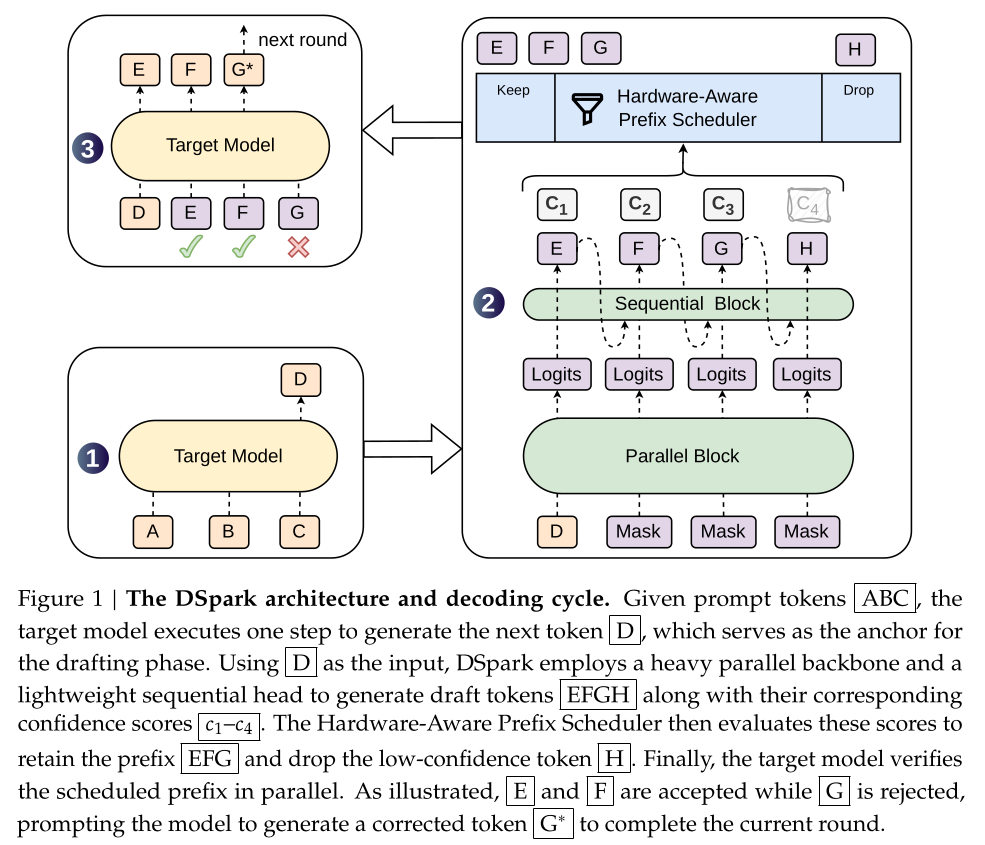
一个解码周期(图中 ①②③):
- ① target 出锚点:prompt
ABC经 target model 一步生成D。D即本轮 drafting 的 anchor token(也叫 bonus token,是上一轮 target 生成的最后一个 token)。 - ② DSpark 起草:以
D为输入,- Parallel Block(重)一次前向产出全部位置的 hidden
h_1..h_γ与 base logitsU_1..U_γ; - Sequential Block(轻)左到右采样,逐位置给 base logits 加一个依赖前缀的转移偏置
B_k,产出EFGH; - Confidence Head 同时输出逐位置置信度
c_1..c_4。
- Parallel Block(重)一次前向产出全部位置的 hidden
- Hardware-Aware Prefix Scheduler:按
c的累乘(前缀存活概率)+ 引擎吞吐曲线决定验证长度,图中保留EFG、丢弃低置信的H。 - ③ target 验证:并行验证被调度的前缀,
E/F接受、G拒绝,target 顺带产出修正 tokenG*完成本轮。
关键点:丢弃 H 不是质量妥协,是吞吐优化——H 大概率会被拒,验它等于白占 batch 容量。整个流程仍然是无损的(严格保持 target 分布),这一点的证明比看起来微妙,见下面调度器部分。
子模块实现(可复现细节)
模块 A — Parallel Block(并行骨干)
直接用 DFlash(Chen et al., 2026)作实例化,它靠 KV 注入把 target 的丰富上下文喂给草稿模型:
H_ctx = RMSNorm( W_c [ H^(l_1) ; ... ; H^(l_m) ] )                        (2)

K_i = [ W_i^K H_ctx ; W_i^K H_d ],   V_i = [ W_i^V H_ctx ; W_i^V H_d ]    (3)
H^(l_j):target 模型第l_j层的 hidden state,取一组层拼接后用W_c ∈ R^{d×md}投影到草稿隐空间。- 这些上下文特征沿序列维拼进每一层草稿的 K/V,块内所有位置双向互相 attend 并 attend 到注入的 target 上下文。
- 草稿模型共享 target 的 embedding 层和 LM head,两者都冻结。
DSpark 对 DFlash 的唯一改动:原版输入 = anchor + γ 个 mask token,只预测 mask 位置;DSpark 把 anchor 本身当作第一个预测位置,于是 γ 个输入 token(anchor + γ−1 个 mask)产出 γ 个草稿 logits。这减少了草稿计算量而草稿质量基本不变。
模块 B — Sequential Block(串行头,本文核心)
设计约束:因为采样过程天然串行,这个模块必须足够轻(T_sequential ≪ T_parallel),否则整体草稿延迟就退化回 O(γ)。
不定义全局归一化的能量模型(那样算不出精确逐 token 概率,就没法做 rejection sampling),而是用自回归因子分解诱导一个因果块分布:
P(X | x_0) = Π_{k=1..γ} p_k(x_k | x_0, x_<k)

                                exp( U_k(v) + B_k(x_0, x_<k, v) )
p_k(v | x_0, x_<k) =  ─────────────────────────────────────────────        (4)
                        Σ_{u∈V} exp( U_k(u) + B_k(x_0, x_<k, u) )
x_0 是 anchor,U_k 是并行骨干给的 base logit 向量,B_k 是串行头加的转移偏置。这个设计的要害是:p_k 仍然是一次标准 softmax,逐 token 概率精确可算——这正是投机解码 rejection sampling 的硬性要求(见下面「为什么不是 CRF/CTC」)。
两种实例化:
B-1. Markov head(默认)
偏置只依赖前一个 token,退化成一阶转移 B(x_{k-1}, x_k)。原则上是个 V×V 矩阵,用低秩分解近似:
B = W_1 W_2 ,   W_1 ∈ R^{V×r} ,  W_2 ∈ R^{r×V}

B(x_{k-1}, ·) = W_1[x_{k-1}] W_2 ∈ R^V                                    (5)
W_1当 embedding 查表、W_2当 logit 投影,默认r = 256。低秩使得大词表下存储与逐步计算都很小,串行循环才跑得动。- 回到开头的例子:位置 1 一旦采样出 “of”,Markov head 就在位置 2 抬高 “course”、压低 “problem”,跨模碰撞被消解。
B-2. RNN head
Markov head 一步之外无记忆(位置 k 看不到 x_{k-1} 之前)。RNN head 维护递归状态 s_k 累积块内完整前缀:
z_k = [ s_{k-1} ; W_1[x_{k-1}] ; h_k ] ∈ R^{2r+d}

s_k = σ(W_g z_k) ⊙ s_{k-1} + (1 − σ(W_g z_k)) ⊙ tanh(W_c z_k)
B_k(x_<k, ·) = W_2^T tanh(W_o z_k)                                        (6)
W_g, W_c, W_o ∈ R^{r×(2r+d)} 由单个线性投影切成 gate/candidate/output 三份,s_0 = 0。
结论:默认用 Markov head。 RNN head 只在长块上有边际增益,但实现复杂度更高、部署性质更差,不划算。
模块 C — Confidence Head(置信度头)
c_k = σ( w^T [ h_k ; W_1[x_{k-1}] ] ) (7)
- 输入:骨干 hidden
h_k+ 来自 Markov head 的前一个草稿 token 的 embedding(复用W_1,零额外参数)。 - 输出:标量
c_k ∈ (0,1)。语义要看清:c_k建模的是条件概率——「在块内所有前置 token 都已被接受的前提下,位置k能通过验证的概率」。 - 监督信号用解析接受率:
c*_k = 1 − ½ ‖ p^d_k − p^t_k ‖_1 (8)
即草稿分布与 target 分布的全变差距离决定的逐步接受率(Leviathan et al., 2023 的标准结论)。
模块 D — Sequential Temperature Scaling(STS 校准)
为什么必须校准:阈值类方法只需要置信度能排序正确;但 DSpark 的硬件感知调度要用累乘的绝对量级去算期望接受长度 τ。而神经网络置信度普遍过度自信,直接用生 raw 分数会扭曲吞吐估计、导致调度次优。
做法:因为每个 c_i 是条件概率,链式法则下前缀被接受的联合概率 = 累乘 Π_{i≤k} c_i。STS 在留出验证集上从左到右逐位置校准这个联合概率——在位置 k 做一维网格搜索找最优温度标量,最小化累乘的 ECE(Expected Calibration Error),同时固定住所有前置位置已校准的分数。
温度缩放是保序变换,所以它只把预测概率拉到与经验接受率对齐,不破坏置信度头学到的相对排序。
模块 E — Hardware-Aware Prefix Scheduler(硬件感知前缀调度器)
把验证长度选择形式化成全局吞吐最大化问题。设 batch 里有 R 个活跃请求,请求 r 的调度验证长度 ℓ_r ∈ {0..γ}:
前缀存活概率:  a_{r,j} = Π_{i≤j} c_{r,i}        (累乘,单调非增)

送进 target 的总 batch(按 token 计):  B = Σ_r (1 + ℓ_r)
期望接受 token 数:  τ = Σ_r ( 1 + Σ_{j=1..ℓ_r} a_{r,j} )
目标:  Θ = τ · SPS(B)          ← 最大化系统级 token 吞吐
SPS(B) = 给定前向 batch B 时的引擎吞吐(steps/second)。关键工程点:这条容量曲线在引擎初始化时 profile 一次,存成一张轻量 cost table,运行时只是查表。
为什么贪心是对的:a_{r,j} 对 j 单调非增,所以把请求 r 的验证长度从 j−1 延到 j 的边际收益恰好是 a_{r,j}。这个单调性保证了「把所有 {a_{r,j}} 放进全局池按大小排序贪心录取」天然满足块内前缀依赖(不会出现选了位置 3 却没选位置 2)。
Algorithm 1  Hardware-Aware Prefix Scheduler
 1: 对每个请求 r 算前缀存活概率 a_{r,j} = Π_{i≤j} c_{r,i}
 2: 构造候选集 E ← {(r,j) | a_{r,j} > 0},按 a_{r,j} 降序排序
 3: 初始化 ℓ_r ← 0;B ← R;τ* ← R;Θ_best ← R · SPS(R)
 4: for each (r,j) ∈ E in sorted order:
 5:     ℓ_r ← j ;  B ← B + 1 ;  τ* ← τ* + a_{r,j}
 6:     Θ ← τ* · SPS(B)                       ← 查 cost table
 7:     if Θ > Θ_best:  Θ_best ← Θ ; 更新 ℓ*_r
 8:     else:           break                 ← 早停,这一步是无损性的关键
 9: return (ℓ*_1, ..., ℓ*_R)
为什么第 8 行的 early-stopping 是正确性而非性能优化
这是全文最精妙的一处,也最容易被漏掉。
无损投机解码严格要求 non-anticipating 性质:录取决策不能依赖未来候选 token。但 DSpark 的置信度头用了 Markov 特征(前一个采样 token 的 embedding),所以算 a_{r,k+1} 必须先实例化 x_{r,k}。如果做「回溯式全局搜索」(不早停,一路评估到底再回头选最优),x_{r,k} 就会泄漏进第 k 步的录取决策,引入选择偏差。
论文附录 A 给了一个具体反例,值得完整看一遍:
设 a_1 = 0.8,SPS(1)=1.0、SPS(2)=0.5、SPS(3)=0.45,则 Θ_0 = 1.0、Θ_1 = 1.8×0.5 = 0.9。不早停的话会继续评估 Θ_2,而 c_2 依赖 x_1 的实现值:
| 情形 | c_2 | a_2 | Θ_2 | 全局最优 | 结果 |
|---|---|---|---|---|---|
x_1 导致高 c_2 | 0.9 | 0.72 | (1+0.8+0.72)×0.45 = 1.134 | Θ_2 | ℓ=2,x_1 被录取 |
x_1 导致低 c_2 | 0 | 0 | (1+0.8+0)×0.45 = 0.81 | Θ_0 = 1.0 | ℓ=0,x_1 不被录取 |
第一个草稿 token 是否被录取,取决于它自己的取值——这就是选择偏差。论文进一步把分布偏差算了出来:设词表 {A,B},p_t(A)=0.7, p_t(B)=0.3,p_d(A)=p_d(B)=0.5(此时标准接受概率恰为 min(0.7,0.5)+min(0.3,0.5)=0.8,与假设一致)。若 x_1=A 走高置信分支被录取、x_1=B 走低置信分支不录取:
Pr(Y=A) = Pr(x_1=A)·min(1, 0.7/0.5) + Pr(x_1=B)·p_t(A)
        = 0.5·1 + 0.5·0.7 = 0.85     ≠ p_t(A) = 0.7      ✗ 有损!
而早停:因为 Θ_1 = 0.9 < Θ_0 = 1.0,调度器立刻停在 ℓ=0,根本没机会去算依赖 x_1 的 c_2,录取决策只依赖 pre-token 信息 → non-anticipating 性质恢复,无损性保住。
代价:早停只在目标 Θ 单峰时才等于全局最优,这隐含假设硬件容量曲线平滑衰减。真实硬件不是这样——见下面 §5.2 的生产改造。
模块 F — 训练
target 全程冻结;草稿模型共享并冻结 target 的 embedding 与 LM head;只更新骨干 drafter、串行块、置信度头。训练数据构造:从每条 target 序列随机采样多个 anchor 位置组成 γ-token 块。
三项 loss,全部按位置权重 w_k = exp(−(k−1)/γ) 加权(早位置对期望接受长度贡献更大,因为是前缀存活):
L_ce   = − Σ_k w_k · log p^d_k(x*_k)                                      (9)
L_tv   =   Σ_k w_k · ‖ p^d_k − p^t_k ‖_1                                 (10)
L_conf = − Σ_k w_k [ c*_k log c_k + (1−c*_k) log(1−c_k) ]                (11)

L = α_ce · L_ce + α_tv · L_tv + α_conf · L_conf                          (12)
    默认 α_ce = 0.1,  α_tv = 0.9,  α_conf = 1.0
注意权重配比:α_tv = 0.9 ≫ α_ce = 0.1。因为逐步接受概率 = 1 − ½‖p_d − p_t‖_1,最小化 L_tv 就是直接最大化期望接受率,而 cross-entropy 只是间接代理。这个取舍很重要——目标不是「预测对下一个 token」,而是「分布对齐到 target」。
为什么不用 CRF / CTC 这类结构化输出层
投机解码额外要求 drafter 提供精确的逐 token 概率给 rejection sampling 用。论文点名了两个近亲的失败原因:
- CRF-NAT(Sun et al., 2019):同样在并行 hidden 上挂串行模块,但全局归一化的配分函数使得精确逐 token 概率算不出来。
- CTC-drafter(Wen et al., 2024):对齐路径的隐变量边缘化导致只能用贪心验证。
DSpark 的规避方式是把串行修正保持在局部(式 4 的自回归因子分解),于是每个 p_k 仍是一次精确 softmax。这是个容易被忽略但决定成败的设计约束。
实验设置与结果
离线设置
- target 模型:Qwen3-{4B, 8B, 14B}、Gemma4-12B(跨模型族验证)。
- baseline:DFlash(SOTA 并行 drafter)、Eagle3(自回归 drafter,基于 Training-Time Test)。公平性处理:所有 drafter 在同一训练框架、同一数据上重新训练;Eagle3 的 TTT horizon 对齐到块大小 7;所有 drafter 用相同的 target 特征层;层数 Eagle3 = 1,DSpark/DFlash = 5。
- 训练数据:Open-PerfectBlend(130 万样本,chat 17.6% / math 39.4% / code 38.9% / instruction 4.1%)。只用 prompt,response 由各自的 target 模型重新生成(这点很关键,保证草稿学的是该 target 的分布)。每个 drafter 训 10 epoch 到充分收敛,non-thinking 模式。
- 评测:数学(GSM8K / MATH500 / AIME25)、代码(MBPP / HumanEval / LiveCodeBench)、闲聊(MT-Bench / Alpaca / Arena-Hard)。温度 1.0,chain-based drafting,报告每轮接受长度 τ(含 target 的 bonus token)。
- 离线评测关闭置信度调度器,强制固定块长,以隔离纯草稿质量。
主结果:接受长度 τ
| Target | Drafter | GSM8K | MATH | AIME25 | MBPP | HumanEval | LCB | MT-Bench | Alpaca | Arena-Hard |
|---|---|---|---|---|---|---|---|---|---|---|
| Qwen3-4B | Eagle3 | 5.14 | 4.62 | 3.92 | 3.69 | 4.16 | 3.77 | 2.39 | 2.26 | 2.55 |
| Qwen3-4B | DFlash | 5.40 | 4.85 | 4.15 | 4.40 | 4.74 | 4.18 | 3.07 | 2.96 | 2.83 |
| Qwen3-4B | DSpark | 6.11 | 5.70 | 4.89 | 5.13 | 5.38 | 4.86 | 3.64 | 3.54 | 3.29 |
| Qwen3-8B | Eagle3 | 5.30 | 4.77 | 3.91 | 3.96 | 4.33 | 4.17 | 2.66 | 2.54 | 2.54 |
| Qwen3-8B | DFlash | 5.33 | 4.91 | 4.07 | 4.36 | 4.64 | 4.39 | 3.11 | 2.98 | 2.81 |
| Qwen3-8B | DSpark | 6.17 | 5.78 | 5.01 | 5.16 | 5.52 | 5.17 | 3.72 | 3.58 | 3.21 |
| Qwen3-14B | DSpark | 6.21 | 5.74 | 4.94 | 5.26 | 5.43 | 5.02 | 3.70 | 3.58 | 3.13 |
| Gemma4-12B | Eagle3 | 5.87 | 5.46 | 4.83 | 4.72 | 5.37 | 4.16 | 3.19 | 3.06 | 2.72 |
| Gemma4-12B | DSpark | 6.05 | 5.78 | 5.12 | 5.11 | 5.64 | 4.51 | 3.49 | 3.35 | 2.92 |
宏平均相对提升:对 Eagle3 +30.9% / +26.7% / +30.0%(4B/8B/14B),对 DFlash +16.3% / +18.4% / +18.3%。跨模型族(Gemma4-12B)同样成立。
强烈的域效应:结构化任务(Qwen3-4B 上 math 5.57、code 5.12)远高于开放聊天(3.49)——这正是「固定验证长度必然浪费」的直接证据,也是置信度调度的动机。
关键分析 1:为什么并行 drafter 反而打赢自回归?
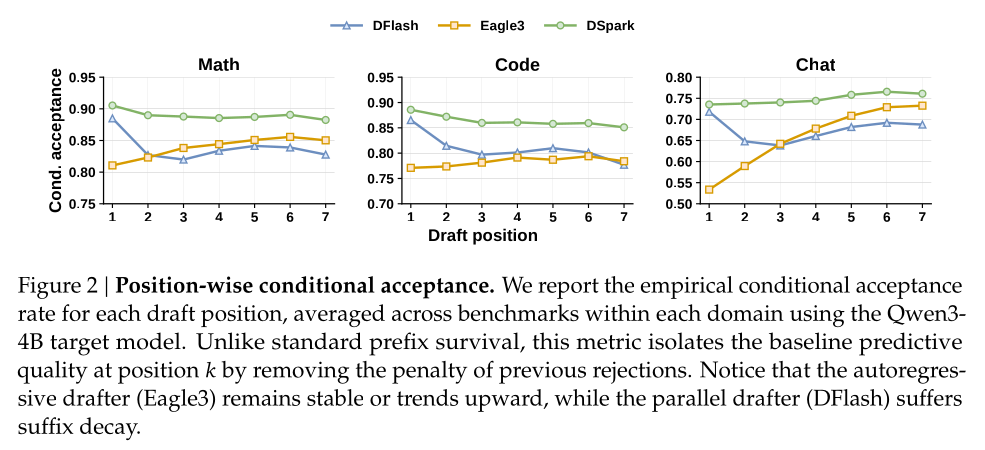
这是全文我认为最有洞察力的一节。表面上「并行 < 自回归」是常识,结果反了。论文引入逐位置条件接受率拆开看:分母只统计「位置 1..k−1 全部被接受」的实例,从而剥离前缀错误的惩罚,露出每一步的裸预测质量。
结论分两段:
① 位置 1 的容量优势(决定性) 第一个位置上两种架构都只依赖 target 上下文,差距纯粹来自架构容量:自回归因 O(γ) 延迟被迫用浅网络,O(1) 并行 drafter 能用深得多的网络。实测 DFlash 起点显著高于 Eagle3(Math 0.88 vs 0.81,Chat 0.72 vs 0.53)。
而投机解码是严格前缀存活过程——第一个 token 杠杆最大,它一被拒整块作废。所以这个起点优势被不成比例地放大,足以盖过后面的衰减。这解释了那个「反直觉」现象。
② 位置 2–7 的独立性代价 前缀一旦锁定语义路径,后续 token 本应更好预测。Eagle3 确实吃到了这个红利——条件接受率保持甚至上升(Chat 从 0.53 爬到 0.74)。而 DFlash 衰减(Code 0.87→0.78,Chat 0.72→0.63),因为每个并行位置都在对所有可能前驱边缘化。
③ DSpark = 两者长板 如图,DSpark 继承深并行骨干的高起点(Math 起步 0.93),同时靠串行头压住衰减,全块维持高且平稳的条件接受率。这张图基本就是整个架构动机的实证。
关键分析 2:一点点自回归就够用
- 深度:固定块长 7,DSpark 层数 1→5 单调变好,1→2 层边际增益最陡。2 层 DSpark 就在所有域上打赢 5 层 DFlash → 注入局部自回归比单纯堆并行层数的「精度/参数」性价比高得多。
- 块长:固定 5 层,草稿长度扫 {4, 8, 12, 16},DSpark 在每个长度上都赢,且差距随 γ 增大而扩大——纯并行的边际效用因后缀衰减而递减,DSpark 压住了衰减。
γ=7时 math/code/chat 分别 +16%/+15%/+18%,γ=15时扩大到 +30%/+26%/+22%。 - RNN head vs Markov head:RNN 只在长块上有边际增益,实现复杂度高、部署性质差 → 默认 Markov。
- 延迟开销:batch 128、上下文长度 {512,1024,2048,4096} 取算术平均,串行循环把整轮延迟相对 DFlash 只增加 0.2%–1.3%(草稿长度 4→16),换来最多 30% 的接受长度提升。这个比值是半自回归成立的根本。
关键分析 3:置信度头与校准
- 静态阈值扫描(诊断用,Qwen3-4B):阈值升高 → 接受率稳步上升,因为估计器筛掉了本来会被拒的 token。Chat 上剪枝最显著:接受率 45.7% → 95.7%;结构化任务剪枝温和(Math 76.9%→92.5%,Code 67.6%→92.0%)。这直接印证了域间差异需要动态而非静态的验证长度。
- 校准(Alpaca 可靠性图):原始置信度判别力很强(ROC-AUC 0.81–0.90)但系统性过度自信(ECE 3%–8%)。STS 把平均 ECE 压到约 1%,同时保序不破坏排序。这一步是硬件感知调度能用绝对量级算
τ的前提。
生产部署:从算法到线上的两个冲突
DSpark-5(γ=5,Markov head)部署在 DeepSeek-V4-Flash / V4-Pro(preview)。草稿骨干 = 3 层 MoE + mHC + 滑窗注意力(窗口 128)。
训练侧两个系统优化(HAI-LLM 框架内):
- Hidden state 通信:传 target 全词表 logits(
V ≈ 10⁵)是带宽瓶颈。改为只传 LM head 之前的 hidden state,LM head 投影在草稿 worker 本地、只对采样到的 target 位置执行 → 每 token 通信复杂度降到 O(d)。 - Anchor-bounded sequence packing:从训练序列采样固定数量的 anchor,把这些孤立的预测块打包成稠密 batch,用 token 级 attention 索引而非标准 2D mask 管理 → 在多序列多 anchor 间保持精确因果掩码,避免 padding 开销。这让草稿模型的计算成本与 target 上下文长度解耦。
Algorithm 1 直接上线会撞两堵墙:
| 冲突 | 现实 | 改造 |
|---|---|---|
假设 SPS(B) 平滑单峰 | 真实硬件容量是离散、锯齿状阶梯衰减 | 去掉 early-stopping,做无约束全局搜索 |
| 需要逐步动态调度 batch | 与 CUDA graph replay 和 ZOS(Zero-Overhead Scheduling) 冲突——ZOS 要求当前步完成前就知道下一步 batch | 异步化:用两步之前的置信度输出近似即将到来的验证容量 |
异步化的精妙之处:当前步的候选 token 仍按实时的累积置信度严格排序,两步前的历史预测只用来决定动态截断长度 K(即 batch 容量上限)——整个录取过程被转化为动态 top-K 选择,选择机制本身保序,最自信的草稿 token 永远优先。
更妙的是:异步化反而使得「去掉早停」变得安全。因为无约束搜索评估的只是两步之前的历史预测,录取决策与当前 token x_{r,k} 的实现值天然隔离——异步设计形成了一道因果屏障。于是既能跨过硬件锯齿悬崖拿到最大物理吞吐,又保住了精确 target 分布。
执行层:动态路由要求单个 batch 内支持变长 query,而标准 decode kernel 都为定长优化,朴素处理会因 padding 和负载不均严重掉 GPU 利用率。解法是把物理执行与逻辑序列跟踪解耦——所有请求的 token 拍平成独立元素同等处理,序列内依赖用一个 marker tensor 通过稀疏注意力实现传达。在 V4 架构上只需改 index-attention 和 compress 两个 kernel。
线上实测(活体用户流量)
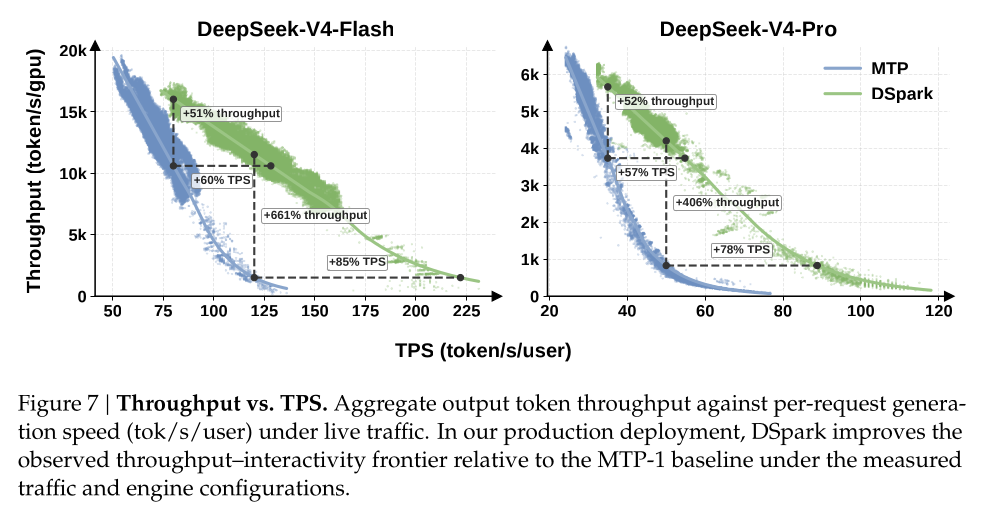
baseline 是 MTP-1(此前的生产配置)。为什么生产上一直只用单 token?因为静态多 token drafter(MTP-3/5)在高并发下会因过量验证开销严格拖垮总吞吐——这恰恰说明了「能产长草稿」和「敢验长草稿」是两回事。
| 引擎 | SLA 锚点 | 吞吐提升 | 匹配吞吐下的 TPS 提升 |
|---|---|---|---|
| V4-Flash | 80 tok/s/user(中等) | +51% | +60% ~ +85% |
| V4-Flash | 120 tok/s/user(严格) | 名义 +661% | — |
| V4-Pro | 35 tok/s/user(中等) | +52% | +57% ~ +78% |
| V4-Pro | 50 tok/s/user(严格) | 名义 +406% | — |
必须正确解读那两个大数字——论文自己也明确做了限定:+661% / +406% 不是「对一个健康 baseline 的倍数加速」,而是因为在严格 SLA 下 MTP-1 已逼近其运行边界、只能维持极小并发批,分母塌了。正确读法是:DSpark 让此前根本不可用的交互性档位变得可用。稳定可比的数字是「匹配吞吐下每用户生成速度快 57%–85%」。
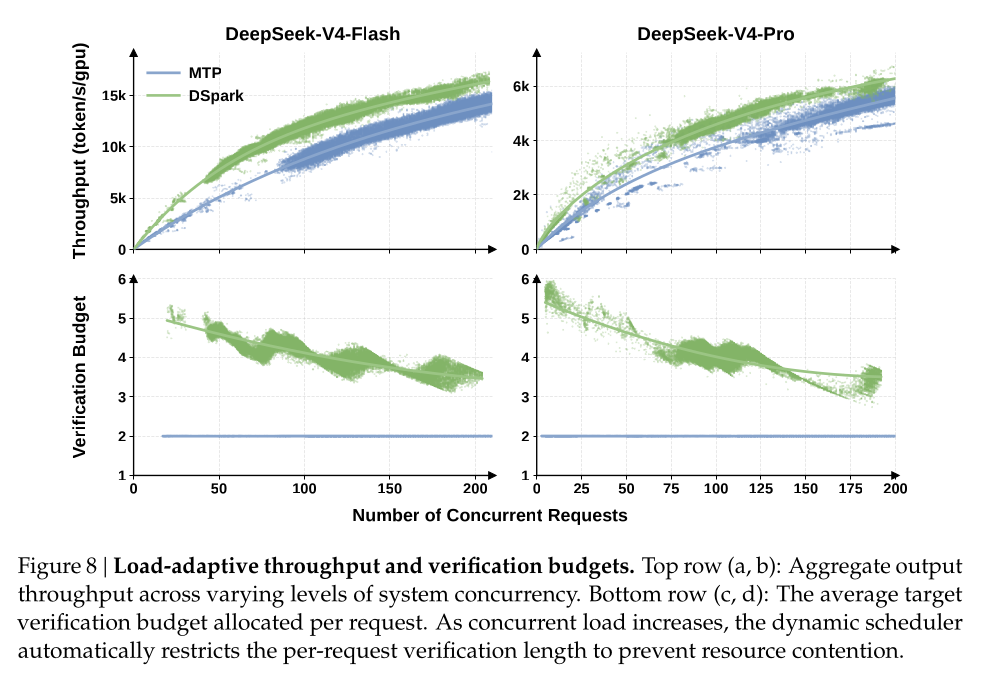
Figure 8 揭示了收益的机制:
- 中等并发(V4-Flash <200、V4-Pro <150 并发请求):调度器利用空闲 target 算力放大验证预算,从 MTP-1 的静态 2 token 扩到约 4–6 token/请求 → 每次前向接受更多 token。
- 高并发:随 target 容量饱和,验证预算平滑下降,低置信 token 在占用关键 batch 容量之前就被剪掉。
这条「验证预算随负载单调下降」的曲线,就是 confidence-scheduled 这个词的全部含义——同一套权重,在轻载时激进、在重载时保守,无需人工调参。
思考与可参考价值
这篇的真正贡献在哪
不在「半自回归」这个结构本身——并发工作 Domino 的 CausalEncoder 概念上就很接近,论文自己也在 Related Work 里点名了。真正的差异是三点:
- 把「验证长度」提升为一个可优化的系统变量。既有工作要么用静态阈值(Eagle 系),要么用启发式。DSpark 把它写成
Θ = τ · SPS(B)的全局吞吐最大化,并且证明了单调性让贪心解是对的。cost table 只 profile 一次这个工程选择让它几乎零运行时开销。 - 无损性的边界被精确刻画了。附录 A 那个反例不是形式主义——它说明「用 Markov 特征的置信度 + 回溯式调度」是一个看起来完全合理但实际有损的组合。很多做投机解码调度的工作大概率踩了这个坑而不自知。更漂亮的是,生产异步化恰好重建了因果屏障,让早停可以安全去掉——这是被约束逼出来的设计,不是事后合理化。
- 逐位置条件接受率这个诊断指标。它剥离了前缀惩罚,第一次把「并行 drafter 为什么反而赢」讲清楚了:赢在位置 1 的容量,输在位置 2+ 的独立性。有了这个拆解,架构结论就是自明的。
局限
- 草稿侧固定成本不可回收(论文自己在 §5.4 承认):前缀调度只省 target 验证,但并行骨干产出整个 γ-token 块的开销是固定付出的。对本身接受率就低的复杂 query,这笔预算纯属浪费。论文给的方向是「难度感知的草稿早退」,但没做。
- SPS(B) 的建模假设偏强。脚注 2 承认它假设引擎吞吐主要取决于验证 batch 大小,理由是 PD 分离部署下负载均衡会摊平序列长度方差。这在 DeepSeek 自己的基础设施上成立,换一个引擎(长上下文占比高、或没做 PD 分离)未必。
- 异步化的代价没有量化。用两步前的置信度近似容量会引入时间偏移,论文只定性说「保序所以没事」,但近似容量导致的吞吐损失有多大、在流量突变时表现如何,一个数字都没给。
- 线上对比的 baseline 偏弱。MTP-1 是单 token,而论文自己解释了为什么生产上没敢用 MTP-3/5。这个对比诚实但不充分——缺一个「静态 DSpark-5(关掉调度器)」的线上对照,否则无法区分收益里多少来自半自回归、多少来自调度器。离线实验里调度器是被关掉的,两部分贡献始终没在同一环境下拆开过。
- 没有质量验证的实测。无损性是理论保证(rejection sampling + non-anticipating),但线上没有报告任何输出分布一致性的经验检查。
对电商 / 搜推 / Agent 的可借鉴点
- 「按边际回报分配算力」这个形式化可以直接搬。
Θ = τ · SPS(B)的结构是通用的:某个操作的期望收益乘以系统在该负载下的吞吐。搜推的粗排/精排链路里同样存在「多召回 100 个候选值不值」的问题——答案同样取决于当前负载。把「离线 profile 一张容量曲线 + 在线按边际收益贪心录取 + 单调性保证贪心最优」这套搬过去,比拍一个静态 topK 强得多。 - 条件概率的累乘要校准,排序对不够。这是个很容易踩的坑:如果你的下游决策只需要排序(选 top-K),置信度过度自信无所谓;但一旦要用绝对量级去算期望值(预算分配、ROI 估计、是否触发下一跳),就必须做校准。STS 这种「逐位置、保序、一维网格搜索」的做法极其轻量——不需要重训,留出集上跑一遍就行,ECE 从 8% 降到 1%。任何做级联决策的系统都值得抄。
- 「位置 1 杠杆最大」的洞察适用于所有前缀存活型系统。级联漏斗(召回→粗排→精排)本质也是前缀存活:第一级漏掉就永远回不来。DSpark 的教训是——在杠杆最大的那一级堆容量是最划算的,哪怕后面几级弱一点。这与「各级均匀投入算力」的直觉相反。
- 轻量串行头修正并行输出,是个通用模式。任何「一次前向出一批结果、但结果之间其实有依赖」的场景(多目标预估、多槽位广告排布、一次生成多个推荐理由)都可能有多模碰撞问题。低秩
W_1 W_2(r=256)的一阶转移偏置成本极低,而且 §4.3.2 的结论是「2 层带串行头 > 5 层纯并行」——先加依赖建模再加深度,性价比高得多。 - 异步近似形成因果屏障,这个思路值得记住。很多在线系统为了性能被迫用「上一步/上几步的状态」做决策,通常被当作纯粹的精度妥协。DSpark 展示了反面——这个时间偏移恰好切断了不该有的信息依赖,把一个有偏的算法变成无偏的。在做 A/B 分流、动态限流、探索策略时,「用滞后状态决策」有时是正确性的来源而非损失。
- 与同 topic 的 DeepSeek-V4 那篇对照读:V4 从注意力机制侧压低单 token 成本,DSpark 从解码策略侧压低单 token 的 target 前向次数,两者正交且在同一套生产系统上叠加。想理解 DeepSeek 的推理成本结构,这两篇要一起看。