DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
DeepSeek-AI
把「百万 token 上下文」从昂贵的实验配置做成工业可常态化服务的能力——核心范式是用混合稀疏注意力(CSA 压缩+稀疏选择 / HCA 极致压缩)替换标准注意力,配合 KV cache 压缩与低精度存储,在 1M 上下文下把单 token 推理 FLOPs 砍到 V3.2 的 27%、KV cache 砍到 10%(Flash 更激进到 10%/7%)。同时引入 mHC(把残差映射约束到双随机矩阵流形以保稳定)与 Muon 优化器加速收敛,是一份"以效率为第一性原理"重构长上下文 LLM 的工业级技术报告。
核心思路
问题:reasoning 模型带来的 test-time scaling 与 agentic / 跨文档长程任务,都把上下文推到极长。但标准注意力是 O(n²) 复杂度,KV cache 随序列线性膨胀,导致超长上下文既算不动也存不下——这是阻碍 test-time scaling 继续放大、阻碍长程 agent 落地的根本架构瓶颈。
关键 idea:不是在标准 Transformer 上做工程优化,而是从注意力机制本身重构效率。DeepSeek-V4 用一套混合稀疏注意力替换 dense attention:
- CSA(Compressed Sparse Attention):先把每
m个 token 的 KV 沿序列维压成 1 个 entry(压缩),再用 DeepSeek Sparse Attention(DSA)让每个 query 只 attend top-k 个压缩 entry(稀疏)——压缩 × 稀疏双重降本。 - HCA(Heavily Compressed Attention):用更激进的压缩率
m'(≫ m,论文取 128)把每 m’ 个 token 压成 1 个 entry,但保持 dense attention(不稀疏)。 - 两者**逐层交替(interleaved)**堆叠,CSA 保留细粒度长程检索能力,HCA 用极低的 KV 占用兜住超长历史。
配套三项升级:mHC(把残差混合矩阵约束到双随机矩阵流形,保证非扩张、稳定深层信号传播)、Muon 优化器(用 Newton-Schulz 正交化梯度,更快更稳)、KV 低精度存储(RoPE 维 BF16 + 其余维 FP8,indexer 走 FP4)。
结果范式:在 1M 上下文下,即便是激活参数更多的 V4-Pro,单 token 推理 FLOPs 仅为 V3.2 的 27%、KV cache 仅 10%;更小的 V4-Flash 进一步压到 10% FLOPs / 7% KV。这让”百万 token 上下文”从奢侈实验变成可以常态化提供的线上服务。
两个尺寸:DeepSeek-V4-Pro 1.6T 总参 / 49B 激活,DeepSeek-V4-Flash 284B 总参 / 13B 激活,均原生支持 1M token。-Max 后缀指最大 reasoning effort 模式(如 V4-Pro-Max)。
整体实现思路
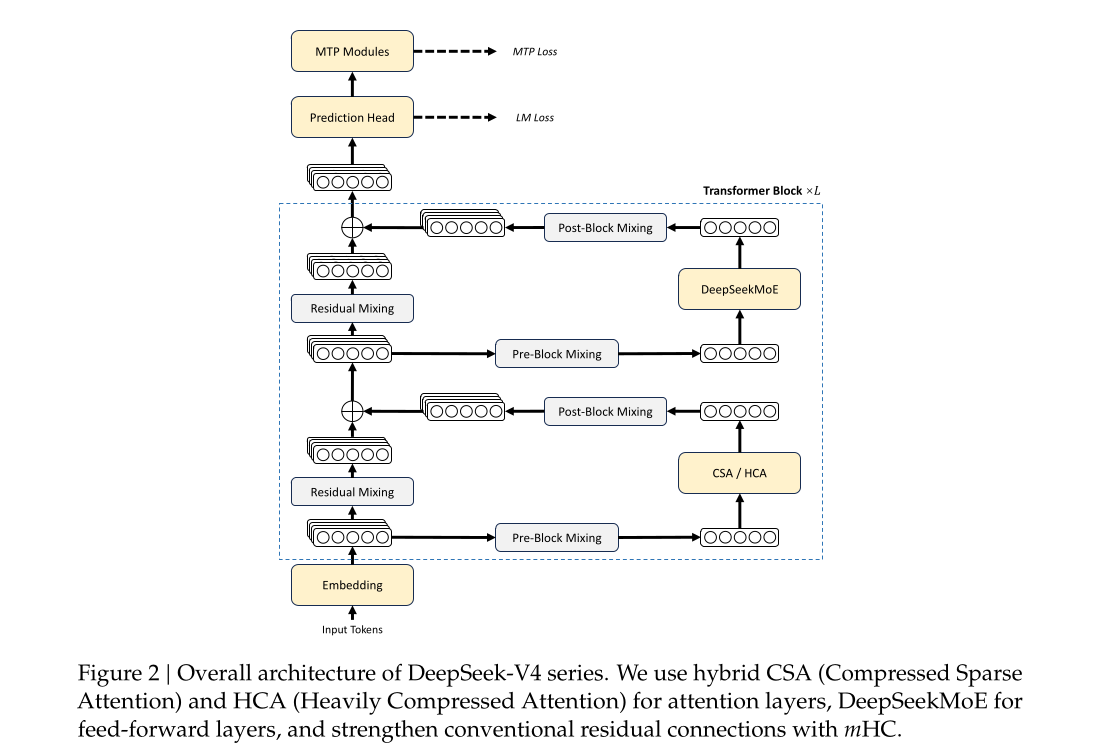
端到端结构(图 2)继承 DeepSeek-V3 的 Transformer + DeepSeekMoE + MTP(Multi-Token Prediction)骨架,主要改三处:
- 注意力层 = 交替的 CSA / HCA(替代 V3 的 MLA dense attention);
- FFN 层 = DeepSeekMoE(细粒度 routed experts + shared expert),前 3 个 MoE 层用 Hash routing(按 token ID 的预定义哈希函数定专家,省路由);
- 残差连接 = mHC(Manifold-Constrained Hyper-Connections)替代普通 residual——图中每个 Transformer block 内的 Pre-Block Mixing / Post-Block Mixing / Residual Mixing 就是 mHC 的输入/残差/输出三组动态线性映射。
数据流:Input Tokens → Embedding → L × Transformer Block(mHC 残差 ⊕ {CSA/HCA, DeepSeekMoE}) → Prediction Head(LM Loss)+ MTP Modules(MTP Loss)。
训练 pipeline:
- 预训练:Flash 32T tokens / Pro 33T tokens;序列长度课程式从 4K → 16K → 64K → 1M;注意力先 dense warmup(Pro 比 Flash dense 阶段更长),在 64K 处引入 sparse attention(先 warmup lightning indexer 再全程稀疏)。
- 后训练:两阶段范式——(a) Specialist Training:每个领域(数学/代码/agent/指令跟随)独立训一个专家(SFT → GRPO RL);(b) On-Policy Distillation (OPD):把多个专家蒸馏进单一统一模型(学生在自己 rollout 上优化对各 teacher 的 reverse-KL)。注意:V4 把 V3.2 的”混合 RL 阶段”整体替换成了 OPD。
子模块实现(可复现细节)
模块 A — Manifold-Constrained Hyper-Connections (mHC)
目的:普通残差只是 x + F(x);Hyper-Connections (HC) 把残差流宽度从 R^d 扩展到 R^{n_hc × d}(多条残差流),但堆叠多层会数值不稳。mHC 通过把残差映射约束到流形上来稳住。
标准 HC 更新(式 1):设第 l 层前的残差态 X_l = [x_{l,1}; …; x_{l,n_hc}]^T ∈ R^{n_hc × d},引入三个线性映射——输入映射 A_l ∈ R^{1×n_hc}、残差变换 B_l ∈ R^{n_hc × n_hc}、输出映射 C_l ∈ R^{n_hc × 1}:
X_{l+1} = B_l X_l + C_l F_l(A_l X_l)
其中 F_l 是真实层(如一个 MoE 层),其输入 A_l X_l ∈ R^d 仍是 d 维——扩展的残差宽度不影响内层设计,n_hc 通常远小于 d,开销极小。
mHC 核心约束(式 2):把残差矩阵 B_l 约束到双随机矩阵流形(Birkhoff 多胞形)M:
M := { M ∈ R^{n×n} | M·1_n = 1_n, 1_n^T·M = 1_n^T, M ≥ 0 }
即行和、列和均为 1 且非负。这保证 ‖B_l‖₂ ≤ 1(非扩张),前向与反向都数值稳定;且 M 对乘法封闭,深层堆叠仍稳。输入/输出映射 A_l, C_l 则用 Sigmoid 约束到非负有界(避免信号相消)。
动态参数化(式 3–5):参数拆成动态(依赖输入)+ 静态分量。先把 X_l 拉平归一化 X̂_l = RMSNorm(vec(X_l)) ∈ R^{1×n_hc·d},再生成未约束原始参数,例如 B̃_l = α^res_l · Mat(X̂_l W^res_l) + S^res_l,其中 W^res_l ∈ R^{n_hc·d × n_hc²} 是可学习权重,Mat(·) 把长度 n_hc² 的向量 reshape 成 n_hc × n_hc,S^res_l 是静态偏置,门控因子 α 初始化为小值。
施加约束(式 6–8):A_l = σ(Ã_l),C_l = 2σ(C̃_l);对 B̃_l 用 Sinkhorn-Knopp 算法投影到双随机流形:先 M^(0) = exp(B̃_l) 保正,再迭代行/列归一化 M^(t) = T_r(T_c(M^(t-1))),取 t_max = 20 次得到 B_l。
配置:mHC 扩展因子 n_hc = 4,Sinkhorn 迭代 20 次(Flash / Pro 同)。
模块 B — Compressed Sparse Attention (CSA)
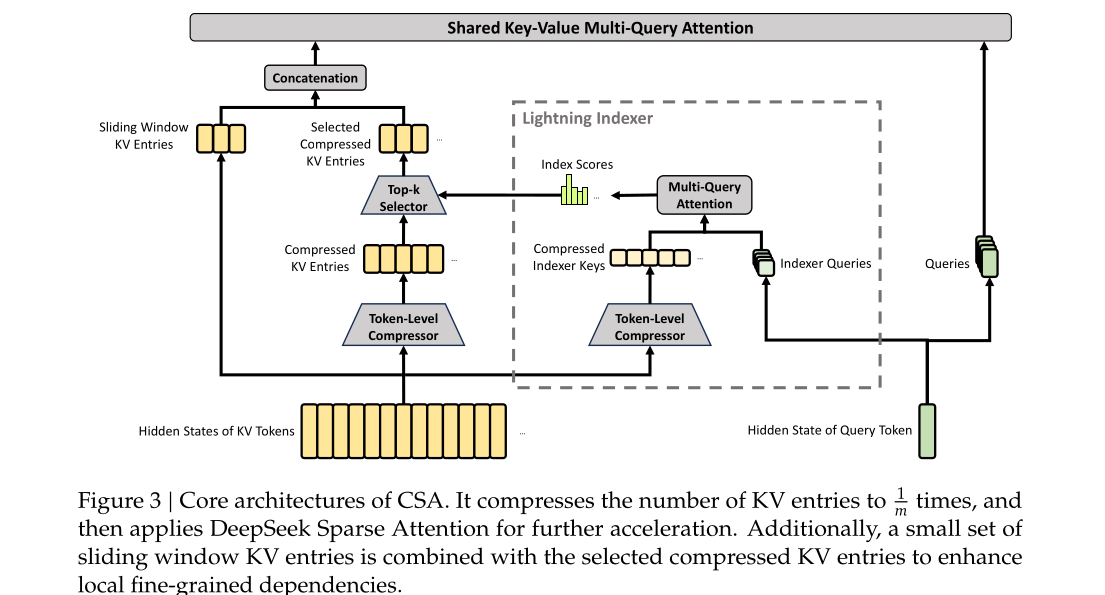
输入/输出:输入 hidden states H ∈ R^{n×d}(n 序列长、d 隐藏维),输出每个 query token 的注意力结果 ô_t ∈ R^d。流程 = 压缩 KV → lightning indexer 选 top-k → shared-KV MQA → grouped output projection(见图 3)。
1) 压缩 KV entries(式 9–12):先算两组 KV entry C^a, C^b ∈ R^{n×c}(c 为 head dim)及压缩权重 Z^a, Z^b ∈ R^{n×c},权重矩阵 W^{aKV},W^{bKV},W^{aZ},W^{bZ} ∈ R^{d×c}。每 m 个 entry 连同可学习位置偏置 B^a,B^b ∈ R^{m×c},按 row-softmax 归一化(对 2m 个元素归一)后加权求和压成 1 个 C^Comp_i ∈ R^c。C^a/C^b 的索引在相邻压缩块间重叠,所以序列长实际压到 1/m 倍。
2) Lightning Indexer 稀疏选择(式 13–17):对压缩后的 indexer key K^IComp ∈ R^{(n/m)×c_I},用低秩方式生成 indexer query:c^Q_t = h_t·W^{DQ}(压到 d_c 维),q^I_t = c^Q_t·W^{IUQ}。index score 用 ReLU 内积加权:I_{t,s} = Σ_h w^I_{t,h}·ReLU(q^I_{t,h}·K^IComp_s),其中 head 权重 w^I_t = h_t·W^w。然后 top-k 选取压缩 entry:C^SprsComp_t = { C^Comp_s | I_{t,s} ∈ Top-k(I_{t,:}) }。
3) Shared-KV MQA(式 18–19):query q_t = c^Q_t·W^{UQ}(latent c^Q_t 与 indexer 共享),每个选中的压缩 entry 同时作 key 和 value,做 Multi-Query Attention:o_{t,i} = CoreAttn(q_{t,i}, C^SprsComp_t, C^SprsComp_t)。
4) Grouped output projection:因 c·n_h 很大,直接投影开销巨大,故把 n_h 个 head 输出分成 g 组,每组先投到中间维 d_g(d_g < c·n_h/g),再拼起来投到最终 ô_t ∈ R^d。
配置:Flash — m=4,indexer query head n_h^I=64,indexer head dim c_I=128,attention top-k=512,query head n_h=64,head dim c=512,query 压缩维 d_c=1024,输出组 g=8,d_g=1024,sliding window n_win=128。Pro — m=4,top-k=1024,n_h=128,d_c=1536,g=16。
模块 C — Heavily Compressed Attention (HCA)
目的:CSA 仍要为每层维护 top-k 的稀疏检索路径;HCA 走另一极端——极致压缩 + dense,用极小的 KV 占用兜住超长历史。
实现(式 20–26):与 CSA 类似但用更大压缩率 m' ≫ m(论文取 128),且不做重叠压缩。算原始 C = H·W^{KV}、Z = H·W^Z,每 m’ 个 entry 经 row-softmax + 位置偏置 B 压成 1 个 C^Comp_i(式 22–23),序列压到 1/m’ 倍。query 同样低秩生成 q_t = c^Q_t·W^{UQ},对全部压缩 entry 做 shared-KV MQA(不 top-k):o_{t,i} = CoreAttn(q_{t,i}, C^Comp, C^Comp),再走相同的 grouped output projection。
模块 D — 注意力的其它关键技巧
- Q/KV 归一化:core attention 前对 query 每个 head 和压缩 KV 的唯一 head 各做一次 RMSNorm,防 attention logits 爆炸(也因此 Muon 不需要 QK-Clip)。
- Partial RoPE:只对 query/KV entry 的最后 64 维加 RoPE;因 KV entry 同时当 key 和 value,会把绝对位置带进输出,故对输出
o_{t,i}的最后 64 维再施加 position = −i 的 RoPE,使输出携带相对位置。 - Sliding Window 分支:为严格保因果,query 只 attend 之前的压缩块,会丢失同块内/近邻细粒度信息——额外加 n_win=128 个未压缩的近邻 KV entry 一起进 core attention。
- Attention Sink:每个 head 设可学习 sink logit
z'_h,加到 attention 分母s_{h,i,j} = exp(z_{h,i,j}) / (Σ_k exp(z_{h,i,k}) + exp(z'_h)),允许某 head 的总注意力权重不为 1(甚至近 0)。
模块 E — Muon 优化器
适用范围:大部分模块用 Muon;embedding、prediction head、mHC 的静态偏置与门控因子、所有 RMSNorm 权重仍用 AdamW。
算法(Algorithm 1,对每个逻辑独立权重 W ∈ R^{n×m}):
- 梯度
G_t = ∇_W L_t(W_{t-1}); - 动量
M_t = μ·M_{t-1} + G_t; - Hybrid Newton-Schulz 正交化
O'_t = HybridNewtonSchulz(μ·M_t + G_t)(Nesterov trick); - RMS rescale
O_t = O'_t · √max(n,m) · γ; - 带权重衰减更新
W_t = W_{t-1}·(1 − ηλ) − η·O_t。
Hybrid Newton-Schulz(式 28):目标是把矩阵 M = UΣV^T 近似正交化为 UV^T。先 M_0 = M/‖M‖_F,迭代 M_k = a·M_{k-1} + b·(M_{k-1}M_{k-1}^T)M_{k-1} + c·(M_{k-1}M_{k-1}^T)²M_{k-1}。共 10 次、两阶段:前 8 步用 (a,b,c)=(3.4445, −4.7750, 2.0315) 快速把奇异值拉近 1;后 2 步用 (2, −1.5, 0.5) 把奇异值精确稳定在 1。
超参:AdamW β1=0.9, β2=0.95, ε=1e-20, wd=0.1;Muon momentum=0.95, wd=0.1, RMS rescale 到 0.18(复用 AdamW 学习率)。
模块 F — 效率与 KV cache 工程
- 混合精度 KV 存储:RoPE 维用 BF16,其余维用 FP8 → KV cache 体积约减半。
- FP4 indexer:lightning indexer 内的注意力计算走 FP4,加速超长上下文。
- routed expert 用 FP4 精度(当前硬件 FP4×FP8 峰值同 FP8×FP8,未来硬件理论可再快 1/3)。
- 以 BF16 GQA8(head dim 128)为基线,1M 上下文下 V4 系列 KV cache 可压到基线的 约 2%。
- On-disk KV cache:CSA/HCA 的压缩 entry 全部落盘,命中共享前缀直接复用(尾部不完整压缩块需重算);SWA 的未压缩 entry 体积约为压缩 entry 的 8 倍,提供 Full SWA Caching / Periodic Checkpointing / Zero SWA Caching 三种存储-计算权衡策略。
训练稳定性
- Anticipatory Routing:解耦 backbone 与路由网络的同步更新——第 t 步用当前参数 θ_t 算特征,但路由索引用历史参数 θ_{t−Δt} 算并预缓存。只在检测到 loss spike 时短回滚并启用,额外 wall-clock 开销约 20%。
- SwiGLU Clamping:把 SwiGLU 线性分量 clamp 到 [−10,10]、gate 上界封 10,消除 outlier 稳住训练。
实验设置与结果
Base 模型对比(统一内部框架,同设置;DeepSeek-V3.2-Base 671B/37B-act vs Flash-Base 284B/13B-act vs Pro-Base 1.6T/49B-act):
| Benchmark (Metric) | V3.2-Base | V4-Flash-Base | V4-Pro-Base |
|---|---|---|---|
| MMLU-Pro (EM, 5-shot) | 65.5 | 68.3 | 73.5 |
| Simple-QA verified (EM, 25-shot) | 28.3 | 30.1 | 55.2 |
| FACTS Parametric (EM, 25-shot) | 27.1 | 33.9 | 62.6 |
| MultiLoKo (EM, 5-shot) | 38.7 | 42.2 | 51.1 |
| HumanEval (Pass@1) | 62.8 | 69.5 | 76.8 |
| MATH (EM, 4-shot) | 60.5 | 57.4 | 64.5 |
| LongBench-V2 (EM, 1-shot) | 40.2 | 44.7 | 51.5 |
要点:Flash-Base 用更小参数(13B 激活 vs 37B)在多数 benchmark 反超 V3.2-Base(尤其世界知识与长上下文);Pro-Base 在几乎所有类目刷新 DeepSeek base 模型上限。
后训练旗舰对比(V4-Pro-Max vs 闭源/开源前沿;Max/xHigh/High 为 reasoning effort):
| Benchmark (Metric) | Opus-4.6-Max | GPT-5.4-xHigh | Gemini-3.1-Pro-High | K2.6 | GLM-5.1 | DS-V4-Pro-Max |
|---|---|---|---|---|---|---|
| MMLU-Pro (EM) | 89.1 | 87.5 | 91.0 | 87.1 | 86.0 | 87.5 |
| SimpleQA-Verified (Pass@1) | 46.2 | 45.3 | 75.6 | 36.9 | 38.1 | 57.9 |
| Chinese-SimpleQA (Pass@1) | 76.4 | 76.8 | 85.9 | 75.9 | 75.0 | 84.4 |
| HLE (Pass@1) | 40.0 | 39.8 | 44.4 | 36.4 | 34.7 | 37.7 |
| LiveCodeBench (Pass@1) | 88.8 | – | 91.7 | 89.6 | – | 93.5 |
| Codeforces (Rating) | – | 3168 | 3052 | – | – | 3206 |
| Apex Shortlist (Pass@1) | 85.9 | 78.1 | 89.1 | 75.5 | 72.4 | 90.2 |
| MRCR 1M (MMR) | 92.9 | – | 76.3 | – | – | 83.5 |
| CorpusQA 1M (ACC) | 71.7 | – | 53.8 | – | – | 62.0 |
| SWE Verified (Resolved) | 80.8 | – | 80.6 | 80.2 | – | 80.6 |
| BrowseComp (Pass@1) | 83.7 | 82.7 | 85.9 | 83.2 | 79.3 | 83.4 |
| Toolathlon (Pass@1) | 47.2 | 54.6 | 48.8 | 50.0 | 40.7 | 51.8 |
要点:知识上 V4-Pro-Max 是开源 SOTA(SimpleQA-Verified 超开源基线约 20 个点),但仍落后 Gemini-3.1-Pro;reasoning(代码/数学)首次让开源模型在 Codeforces / LiveCodeBench 上与 GPT-5.4 等闭源齐平甚至反超(Codeforces Rating 3206,人类榜约第 23);长上下文 CorpusQA-1M 超 Gemini-3.1-Pro。论文自评整体落后前沿闭源约 3–6 个月。
Reasoning effort 模式(Table 7 节选,V4-Pro):Non-Think / High / Max 三档随 thinking budget 单调提升,如 HLE 7.7 → 34.5 → 37.7,SimpleQA-Verified 45.0 → 46.2 → 57.9,CorpusQA-1M 35.6 → 56.5 → 62.0。Max 模式用更长 context(最大 384K)+ 更小 length penalty。
效率头条(图 1 右,1M 上下文 vs V3.2):
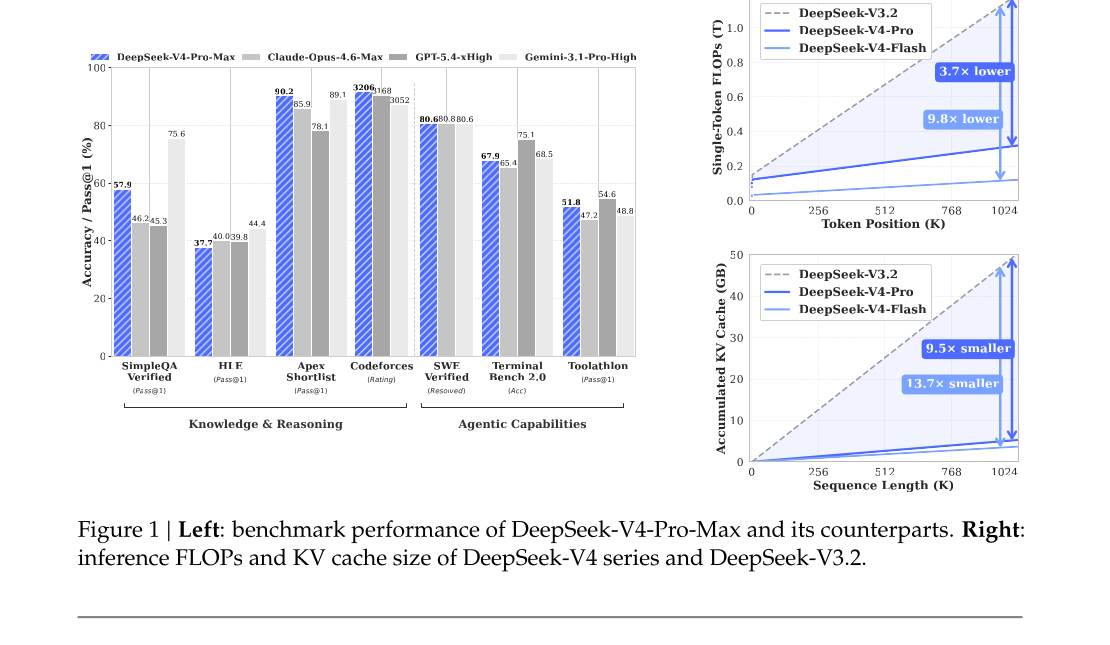
| 模型 | 单 token 推理 FLOPs(vs V3.2) | KV cache(vs V3.2) |
|---|---|---|
| DeepSeek-V4-Pro | 27%(约 3.7× lower) | 10%(约 9.5× smaller) |
| DeepSeek-V4-Flash | 10%(约 9.8× lower) | 7%(约 13.7× smaller) |
即便 V4-Pro 激活参数(49B)多于 V3.2(37B),FLOPs/KV 仍大幅更低——效率收益完全来自架构(混合压缩注意力 + 低精度),而非缩参数。
思考与可参考价值
局限(论文自陈 + 观察):
- 架构复杂度高:为降风险保留了大量”预验证”组件与 trick(CSA/HCA/sliding window/attention sink/partial RoPE/grouped projection 叠在一起),作者明确说未来要”蒸馏到最本质设计”。
- 稳定性机制缺理论:Anticipatory Routing 和 SwiGLU Clamping 经验有效但原理不明。
- 绝对能力仍落后前沿闭源:知识/部分 agent 任务落后 Gemini-3.1-Pro / Opus-4.6,自评差约 3–6 个月;MRCR-1M 检索仍不及 Opus-4.6。
- 预览版:暂无多模态,长程多轮 agent 仍在迭代。
对电商 / 搜推 / Agent 长上下文落地的借鉴:
- 长上下文从”贵”变”可常态化”是范式级信号:把整段用户行为序列 / 整本商品知识库 / 多轮 agent 历史塞进单次推理,过去因 KV cache 爆炸不可行;CSA+HCA 把 1M KV 压到基线 ~2%,意味着生成式推荐 / 长行为序列建模 / 长程客服 agent 可以直接吃更长上下文而不重设计召回-截断。
- 混合注意力的分工思路可迁移:CSA(压缩+稀疏,保细粒度检索)兜近期/相关、HCA(极致压缩+dense)兜超长历史——这套”近期高保真 + 远期低成本摘要”的分层,正是长行为序列 / 长会话记忆该有的存储结构;on-disk 共享前缀复用对多用户共享 system prompt / 共享商品上下文的线上服务直接省 prefill。
- reasoning-effort 三档(Non-Think/High/Max)是工程友好的成本-质量旋钮:电商场景里高频低风险请求走 Non-Think、复杂决策走 Max,按业务价值分配 test-time compute,值得在自研 agent 服务里照抄这个接口。
- OPD 替代混合 RL 做能力合并:先训领域专家(数学/代码/agent)再 reverse-KL 蒸馏进统一模型,比直接多任务 RL 更可控——对需要同时压数个垂域能力(搜索/推词/导购)的电商大模型是干净的 merge 范式。
- 落地相关性:DeepSeek-V4-Pro 正是本作者 ai-papers-daily / stock-advisor 两个自用项目的底座模型——长上下文 + 低 KV 成本意味着可以把更长的论文全文 / 更长的多市场行情历史一次性喂进单次推理做分析,直接受益于本文的效率突破。