DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
DeepSeek
证明纯 RL(GRPO + 规则可验证奖励)就能涌现出 self-reflection / verification / aha moment;R1-Zero 完全不用 SFT 冷启动,R1 加少量 cold-start SFT 修可读性。
核心思路
一句话问题:能否完全甩掉「人工标注的 reasoning 轨迹(SFT)」,只靠 reward 信号让大模型自己「学会推理」?以往(o1 之前)的 reasoning 模型要么蒸馏强模型、要么靠人工 CoT 数据,性能天花板被人类示范锁死,且人类先验会限制模型探索非人类式的更优解法。
关键 idea / 范式:在 DeepSeek-V3-Base(671B MoE,37B 激活)上直接做纯 RL,奖励只来自最终答案是否正确(rule-based verifiable reward),完全不约束推理过程本身。这样训出来的 DeepSeek-R1-Zero 自发涌现出反思(reflection)、验证(verification)、回溯、多解法探索等高级推理行为,并出现 response 长度随训练自然增长的「test-time compute scaling」和著名的 aha moment(突然大量使用 “wait” 重新审视)。
由于 R1-Zero 可读性差、中英混杂、通用能力弱,再用一套多阶段流水线(cold-start SFT → reasoning RL → rejection-sampling SFT → 全场景 RL)打磨成可读、对齐人类偏好的 DeepSeek-R1;最后把 R1 的 800K 输出蒸馏进 Qwen / Llama 1.5B–70B 小模型。核心方法论是把推理能力的天花板从「人类标注质量」换成「硬题目 + 可靠 verifier + 足够算力」三要素。
整体实现思路
整篇工作由两条主线 + 一条蒸馏支线组成:
- R1-Zero(纯 RL 路线,验证可行性):V3-Base + GRPO + 仅 accuracy/format reward,无 SFT 冷启动。证明 reasoning 能 reward-only 涌现。
- R1(产品化多阶段流水线):在 R1-Zero 经验上叠加冷启动 SFT 修可读性、两阶段 RL、rejection-sampling 造 800K 高质量 SFT 数据,得到对齐后的最终模型(图 2)。
- 蒸馏支线:用 R1 产出的 800K 样本对开源 base 做 SFT(不做 RL),把推理能力迁移到小模型。
整个 R1 流水线(图 2)的端到端 checkpoint 链路是:V3-Base →(纯RL: Accuracy&Format)→ R1-Zero →(采样+Filter+V3/Human Refine 造 cold-start)→ cold-start SFT → R1-Dev1 →(reasoning RL: rule reward + 语言一致性)→ R1-Dev2 →(rejection sampling 出 600K reasoning + 200K non-reasoning,第二次 SFT)→ R1-Dev3 →(全场景 RL: rule reward + preference reward)→ R1。
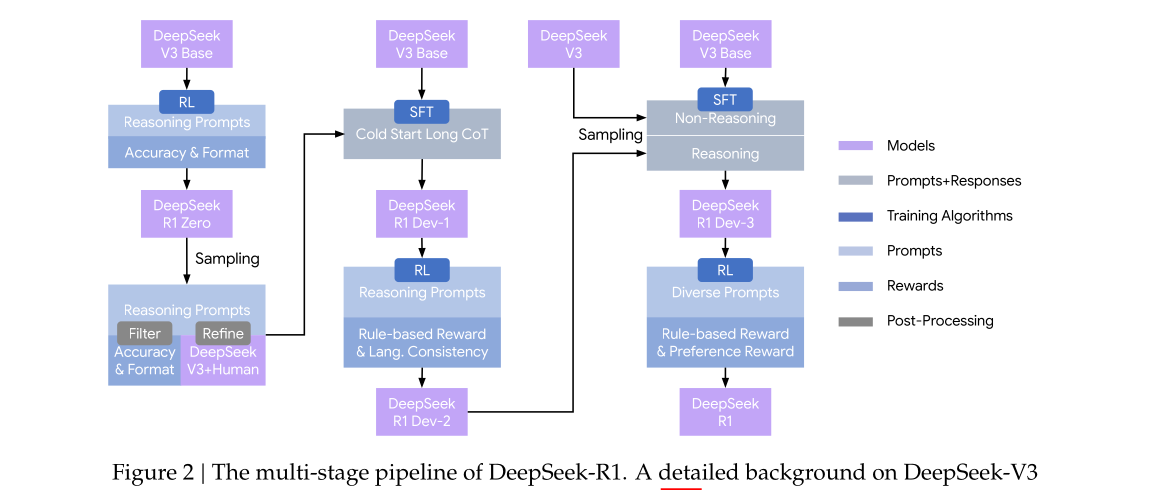
训练成本(H800,294K。
子模块实现(可复现细节)
1. GRPO 训练目标(核心 RL 算法)
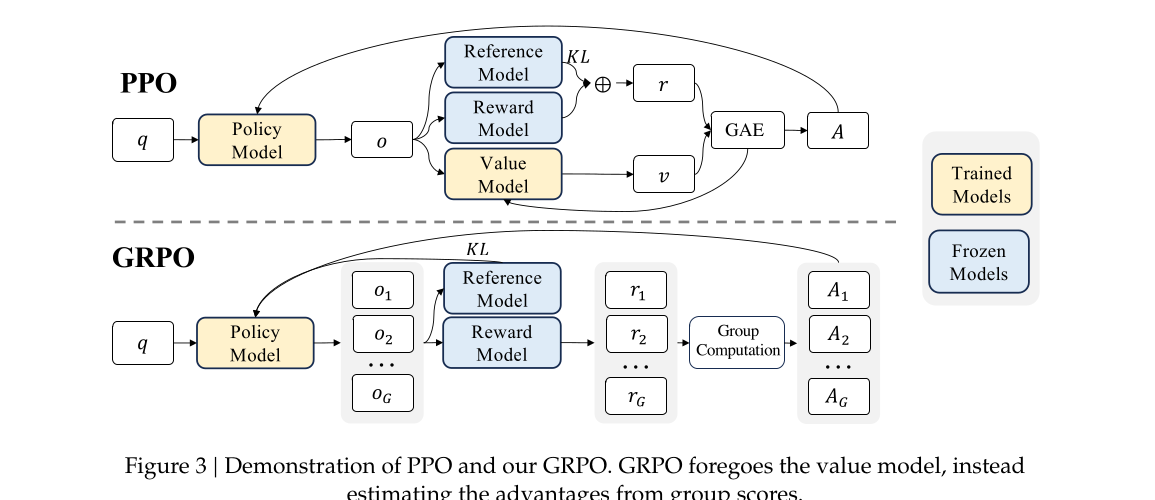
GRPO 用「组内相对优势」替代 PPO 的 value/critic 模型,省掉一整个与策略同尺寸的价值网络(图 3)。
对每个 question ,从旧策略 采一组 个输出 ,最大化:
其中组内优势直接由组奖励标准化得到(不需要 GAE、不需要 value model):
KL 用无偏估计 ,直接加在 loss 里(而非像 PPO 那样把 per-token KL 当 dense reward 加进 reward——后者会隐式惩罚 response 长度,抑制长 CoT 的自然增长)。
- 符号含义: = clip 比例, = KL 系数, = 参考策略(每 400 步替换为最新 policy,平衡探索范围与稳定性)。
- PPO vs GRPO 对比:在 DeepSeek-Coder-V2-Lite(16B MoE/2.4B 激活)的 MATH 任务上,PPO 对 GAE 的 极敏感:(开源默认)显著差于 GRPO, 才追平。GRPO 免去这层调参 + 价值网络显存/算力开销。
R1-Zero 关键超参:lr=3e-6,KL 系数 =0.001,rollout 温度=1.0;每题采 =16 个输出,max length 32,768 tokens(8.2k 步后放宽到 65,536);每步 32 道唯一题 → batch size 512;每 400 步换 ref model;每个 rollout 生成 8,192 条输出,随机切 16 个 mini-batch、仅训 1 个 inner epoch。总共 10,400 步 ≈ 1.6 epoch。性能与长度在 8.2k 步(放宽长度上限)出现显著跳变。
2. 奖励设计(Reward Design)
R1-Zero 完全用 rule-based reward,刻意不上神经 reward model(无论 outcome 还是 process based),因为后者在大规模 RL 下易被 reward hacking、且重训成本高。
- Accuracy reward:数学题要求把最终答案放进指定格式(如
\boxed{}),用规则匹配 reference(对=1,错=0);代码题用 compiler 跑预定义测试用例。 - Format reward:强制把推理过程包进
<think>...</think>、答案进<answer>...</answer>(模板见下),两项等权相加。
R1-Zero 训练模板(System/User):「The reasoning process and answer are enclosed within <think>...</think> and <answer>...</answer> tags …」——刻意只约束结构、不注入任何内容偏好,以便观察模型自然演化。
R1 阶段额外奖励:
- 语言一致性奖励 (CoT 中目标语言词占比),直接加进最终 reward 治中英混杂。消融(Distill-Qwen-7B)显示:不加 LC reward 时语言一致性随训练持续下降;加了能稳住一致性,代价是数学持平、代码略降——属于「轻微降点换可读性」的人类偏好对齐。
- 第二阶段全场景 RL 奖励:,其中 ,。
3. Model-based Reward(仅用于 R1 通用数据)
通用/开放任务无法 rule 验证,才用神经 RM:
- Helpful RM(pairwise):用 arena-hard 格式让 V3 生成偏好对,每对让 V3 判 4 次(随机交换 A/B 位消除位置偏差),取均值,只保留分差 的对;控制 chosen/rejected 长度可比以消除长度偏差。共 66,000 对,batch=256,lr=6e-6,1 epoch,max len 8192。
- Safety RM(pointwise):106,000 条标 safe/unsafe,逐点训练。
- Reward hacking 防护:preference-based reward 只在第二阶段 RL 的最后 400 步引入(总 1,700 步),更多步会触发 reward hacking(reward 升但 CodeForces 性能降,见消融图)。
4. Cold-start 数据构造(修可读性)
数千条「第一人称、对话式、含反思/验证」的长 CoT。构造:高温(T=1.0)从 R1-Zero 采多条轨迹 → 只留答案正确 + 格式可读的(数学用 sympy 解析比对,格式用重复检测 + 语言混杂过滤)→ 让 DeepSeek-V3 refine 成人类友好表达(“Translate the thinking process to the same language as the question”)→ 人工二次校验。
5. 800K rejection-sampling SFT 数据(造 Dev3)
- Reasoning(~600K):从第一阶段 RL checkpoint 做 rejection sampling,每 prompt 采多条只留正确的;这一阶段除 rule reward 外,还用 generative RM(把 ground-truth + 预测喂给 V3 判 correct/incorrect,输出 JSON)扩展到非 rule-可验证题;过滤掉中英混杂、超长段落、含代码块的 CoT。
- Non-Reasoning(~200K):复用 V3 的 SFT 数据(写作、事实 QA、self-cognition、翻译)+ 软件工程(程序修复、前端)。简单 query(如 “hello”)不带 CoT。
- SFT 数据统计(共 804,745 条,平均 5355 tokens/条):
| Domain | #Samples | Avg Rounds | Avg Tokens |
|---|---|---|---|
| Math | 395,285 | 1.0 | 6094.2 |
| Code | 211,129 | 1.1 | 7435.7 |
| STEM | 10,124 | 1.0 | 4928.8 |
| Logic | 10,395 | 1.0 | 2739.0 |
| General | 177,812 | 1.1 | 1419.8 |
绝大多数是单轮,作者承认这限制了 R1 的多轮对话能力。
6. RL 数据配方
| Data Type | #Prompts | Question Type | Output Type | 备注 |
|---|---|---|---|---|
| Math | 26K | 定量推理 | 数/表达式/方程 | avg 122 tokens,排除证明题(难判对错) |
| Code | 17K(+8K bug-fix) | 算法/改 bug | 代码 | bug-fix 取自真实 GitHub issue + unit test |
| STEM | 22K | 多选 | 选项 | 化学46.5%/生物30.7%/物理15.5% |
| Logic | 15K | 选择/定量 | 选项/数 | avg 420 tokens,含 code-IO、Zebra、24点等 |
| General | 66K | helpful/harmless | 排序响应 | 含 12K harmlessness |
代码题原始测试用例不公开,作者用 DeepSeek-V2.5 生成候选 test case(含对抗性大输入生成器)+ 两阶段过滤(先用正确提交剔无效用例,再选能区分错误提交的子集),来源 5151 道 Codeforces + 2504 道 AtCoder。
7. 蒸馏(Distillation,仅 SFT 无 RL)
用 800K 样本对 base 模型 SFT 2–3 epoch,cosine decay 衰减到初始 lr 的 1/10,max len 32,768,batch=64。各模型初始 lr:
| Distilled Model | Base | Init LR |
|---|---|---|
| R1-Distill-Qwen-1.5B | Qwen2.5-Math-1.5B | 1e-4 |
| R1-Distill-Qwen-7B | Qwen2.5-Math-7B | 8e-5 |
| R1-Distill-Qwen-14B | Qwen2.5-14B | 7e-5 |
| R1-Distill-Qwen-32B | Qwen2.5-32B | 6e-5 |
| R1-Distill-Llama-8B | Llama-3.1-8B | 5e-5 |
| R1-Distill-Llama-70B | Llama-3.3-70B-Instruct | 2e-5 |
RL 基础设施(图未截,文字说明)
解耦四模块:① Rollout(vLLM workers + actor,MoE 专家并行 + 热点专家冗余 + MTP self-speculative decoding 加速长样本);② Inference(reward/reference 前向);③ Rule-based Reward(code executor/answer matcher/format checker,异步调度与前两者 overlap 隐藏延迟);④ Training(actor/critic,按长度排序 + Best-Fit packing 减 padding + DualPipe 流水并行)。每模块结束自动 offload VRAM→内存/磁盘。
实验设置与结果
Benchmark:MMLU/MMLU-Redux/MMLU-Pro、C-Eval、CMMLU、IFEval、FRAMES、GPQA Diamond、SimpleQA、SWE-Bench Verified、Aider-Polyglot、LiveCodeBench(2024-08~2025-01)、Codeforces、CNMO 2024、AIME 2024。指标:Pass@1(单次准确率)、Cons@k / cons@64(k 次自洽多数投票)、Codeforces Elo Rating/Percentile、EM、LC-winrate 等。
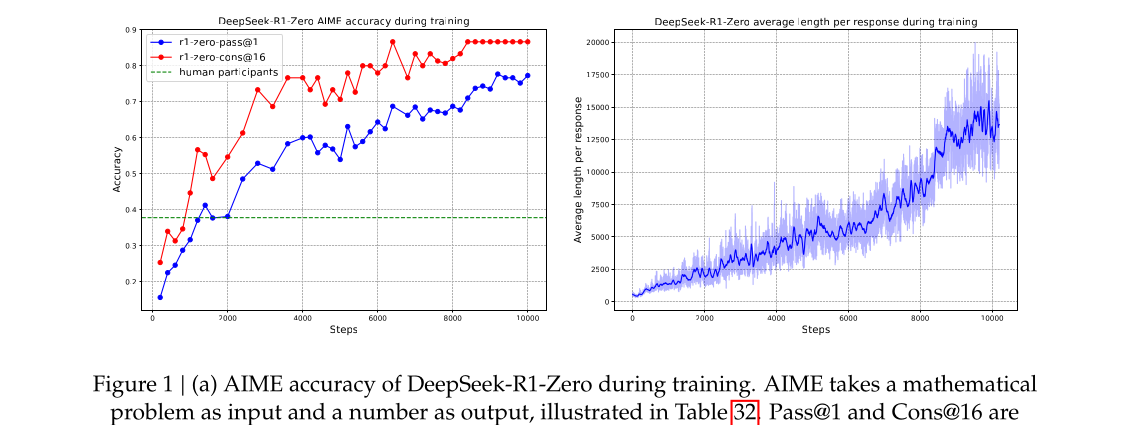
R1-Zero 训练曲线:AIME 2024 pass@1 从初始 15.6% → 77.9%,self-consistency(cons@16)进一步到 86.7%(超人类参赛者均值);response 平均长度随训练从数百 → 上万 tokens 自然增长(图 1),并出现 aha moment(“wait” 用量突增)。
各阶段消融(节选 Table 3,看 R1-Zero→Dev1→Dev2→Dev3→R1 的演化):
| Benchmark (Metric) | R1-Zero | Dev1 | Dev2 | Dev3 | R1 |
|---|---|---|---|---|---|
| AIME 2024 (Pass@1) | 77.9 | 59.0 | 74.0 | 78.1 | 79.8 |
| MATH-500 (Pass@1) | 95.9 | 94.2 | 95.9 | 95.4 | 97.3 |
| Codeforces (Rating) | 1444 | 1534 | 1687 | 1746 | 2029 |
| Codeforces (Percentile) | 80.4 | 84.5 | 90.5 | 92.1 | 96.3 |
| LiveCodeBench (Pass@1) | 50.0 | 57.5 | 63.5 | 64.6 | 65.9 |
| GPQA Diamond (Pass@1) | 75.8 | 66.1 | 70.7 | 71.2 | 71.5 |
| IF-Eval (Prompt Strict) | 46.6 | 71.7 | 72.0 | 78.1 | 83.3 |
| AlpacaEval2.0 (LC-winrate) | 24.7 | 50.1 | 55.8 | 62.1 | 87.6 |
| ArenaHard (GPT-4-1106) | 53.6 | 77.0 | 73.2 | 75.6 | 92.3 |
| Aider-Polyglot (Acc) | 12.2 | 6.7 | 25.6 | 44.8 | 53.3 |
关键消融结论:① cold-start SFT(Dev1)大幅提升 instruction-following(IF-Eval 46.6→71.7、ArenaHard 53.6→77.0),但因冷启动数据量小,reasoning 短暂回退(AIME 77.9→59.0);② reasoning RL(Dev2)把推理/代码/STEM 拉回来;③ 加 non-reasoning SFT(Dev3)大涨 AlpacaEval/Aider(工程类);④ 最终全场景 RL(R1)主要涨通用对齐(AlpacaEval +25%、ArenaHard +17%),代码/数学因前期已充分 RL 只微增。
最终 R1 旗舰成绩:AIME 2024 79.8% pass@1(vs o1-1217 79.2%)、MATH-500 97.3%、Codeforces Elo 2029(超 96.3% 人类)、LiveCodeBench 65.9%、MMLU 90.8%、GPQA Diamond 71.5%。AIME Pass@64 可达 90.0%,majority voting 把 79.8%→86.7%。
Test-time scaling:R1 按难度自适应分配思考 token——简单题 <7000、最难题 >18000 tokens;2024 竞赛集 Pass@1=61.8%(均 8793 思考 token)。对比 GPT-4o-0513 同题仅 24.7%、均 711 token;GPT-4o 即便 AIME 上 64 路 majority voting 也只从 9.3%→13.4%,远不及推理模型——因为独立采样不能像长 CoT 那样回溯自纠。
蒸馏结果(Table 15,pass@1 除注明):
| Model | AIME24 | MATH-500 | GPQA-D | LiveCodeBench | CF Rating |
|---|---|---|---|---|---|
| GPT-4o-0513 | 9.3 | 74.6 | 49.9 | 32.9 | 759 |
| Claude-3.5-Sonnet-1022 | 16.0 | 78.3 | 65.0 | 38.9 | 717 |
| R1-Distill-Qwen-1.5B | 28.9 | 83.9 | 33.8 | 16.9 | 954 |
| R1-Distill-Qwen-7B | 55.5 | 92.8 | 49.1 | 37.6 | 1189 |
| R1-Distill-Qwen-14B | 69.7 | 93.9 | 59.1 | 53.1 | 1481 |
| R1-Distill-Qwen-32B | 72.6 | 94.3 | 62.1 | 57.2 | 1691 |
| R1-Distill-Llama-70B | 70.0 | 94.5 | 65.2 | 57.5 | 1633 |
蒸馏 vs 直接 RL(Table 16):在 Qwen2.5-32B-Base 上跑 >10K 步纯 RL(Qwen2.5-32B-Zero)只能追平 QwQ-32B-Preview(AIME 47.0 / GPQA 91.6 / LiveCodeBench 40.2),而 R1-Distill-Qwen-32B 全面碾压(AIME 72.6 / GPQA 94.3 / LiveCodeBench 57.2)。结论:小模型直接做大规模 RL 既贵又难超过「蒸馏强教师」;要突破能力上界仍需更强 base + 更大规模 RL。
两个关键复现 caveat:① base 模型容量决定 RL 成败——7B dense / 16B MoE 上纯 RL 在 AIME 几乎不涨(response 变长就开始重复、无法利用长 CoT),换到 32B/230B/671B 才看到显著增益;② verifier 可靠性是命门——rule-based RM 和「LLM 判答案对错」是抗 reward hacking 的稳妥机制,但 LLM 判别只对短答案有效,开放生成/长文写作迁移性差。
两个失败尝试(值得记):PRM(过程奖励模型)——难定义细粒度步骤、难判中间步对错、必然 reward hacking,性价比低,只适合 rerank top-N;MCTS——token 空间指数级远超棋类、value model 难训,自搜索迭代提升不可行。
思考与可参考价值
局限:① rule-verifiable 之外(创意写作、开放生成)纯 RL 难做,论文坦言这些任务仍要 human-annotation SFT + 只跑几百步 RL;② cold-start「数千样本」仍是隐性人工监督,且 vivid reasoning 多是 DeepSeek 工程化 heuristic,不代表真获得人类智能;③ 671B 级算力门槛 + base 容量依赖,独立复现需 32B 起步;④ 结构化输出/工具调用弱、few-shot 反而掉点(建议 zero-shot)、非中英语种语言混杂;④ SFT 数据近全单轮,多轮能力受限。
对电商 / 搜索推荐 / Agent 的可借鉴点:
- 「reward 换标注」范式直接可移植:电商里大量任务天然 verifiable——价格/库存/类目抽取可规则校验、检索结果可用点击/转化做 outcome reward、SQL/工具调用可执行验证。优先把这类任务做成 rule-based verifiable reward 的 GRPO 训练,避免训神经 RM 被 hack。
- GRPO 工程性价比:对电商场景动辄要在线/近线训大模型,去掉 value model 省一半显存与一套调参(PPO 的 敏感),组内相对优势对「同一 query 下多个候选 response/动作」打分天然契合推荐/检索的 listwise 结构。
- 多阶段流水线模板:cold-start SFT(修格式/对齐)→ verifiable RL(提硬指标)→ rejection-sampling 造数据(自举高质量样本)→ 全场景 RL(最后小步加 preference reward,警惕 reward hacking)——这套「先对齐格式、再 RL 拉指标、再小步对齐偏好」的顺序对 Agent 训练有直接参考价值。
- test-time compute 自适应:模型按难度自动多想/少想,对应推荐/搜索 Agent 可按 query 复杂度动态分配推理预算(简单 query 直出、复杂 query 长 CoT + 工具调用),是「算力换效果」的可落地杠杆。
- 蒸馏 > 小模型自己 RL:线上部署受限算力时,与其在小模型上烧 RL,不如用强教师(如自家大模型 RL 后)产出高质量轨迹做 SFT 蒸馏——1.5B 蒸馏模型即超 GPT-4o 数学,对端侧/低延迟推荐 Agent 极有价值。
- verifier-first 思维:能不能做 RL,先问「有没有可靠 verifier」。电商里转化/GMV 是延迟稀疏信号,需谨慎设计可验证的中间 proxy reward,并警惕神经 RM 的 reward hacking(论文里 preference reward 只敢跑最后 400 步)。