Constitutional AI: Harmlessness from AI Feedback
Anthropic
提出 RLAIF:用一组人写好的 "宪法" 原则替代逐条人工标注,让模型自我批评+修订自己的回答,再用 AI 偏好做奖励信号。是 Self-Rewarding 类工作的精神鼻祖。
核心思路
一句话问题:RLHF 训无害助手需要数万条「有害性」人工偏好标注,成本高、暴露标注员心理风险,且训出来的模型往往「过度回避」(遇到敏感问题就 “I can’t answer that”),既不透明也不 helpful。能不能在完全不用任何有害性人工标签的前提下训出一个既无害又不回避的助手?
关键 idea:把人类监督压缩成一份宪法(constitution)——十几条自然语言原则(如「避免歧视」「不教犯罪」「像 MLK/甘地那样回答」)。「哪些行为是可接受的」由人写进宪法,「每个具体样本该怎么判」全部交给模型自己。两个机制接管原本由人做的事:
- Self-Critique → Revision(SL 阶段):让 helpful 模型先生成有害回答,再依据随机抽到的一条原则自我批评、再自我修订,反复多轮,最后用修订后的回答做 SFT。
- RLAIF(RL 阶段):让一个 feedback model 依据宪法对成对回答做多选偏好打分,把 AI 偏好蒸馏进 Preference Model(PM),再用 PM 当 reward 跑 PPO。
两阶段都可叠加 chain-of-thought,让 judge 的推理过程显式可读、可审计。这是「AI 监督 AI / scaling supervision」范式的奠基工作,也是后续 Self-Reward 路线的精神鼻祖。
整体实现思路
端到端 pipeline 是「先 SL 把模型拉到 on-distribution,再 RL 大幅提升」的两阶段流水线(下图):
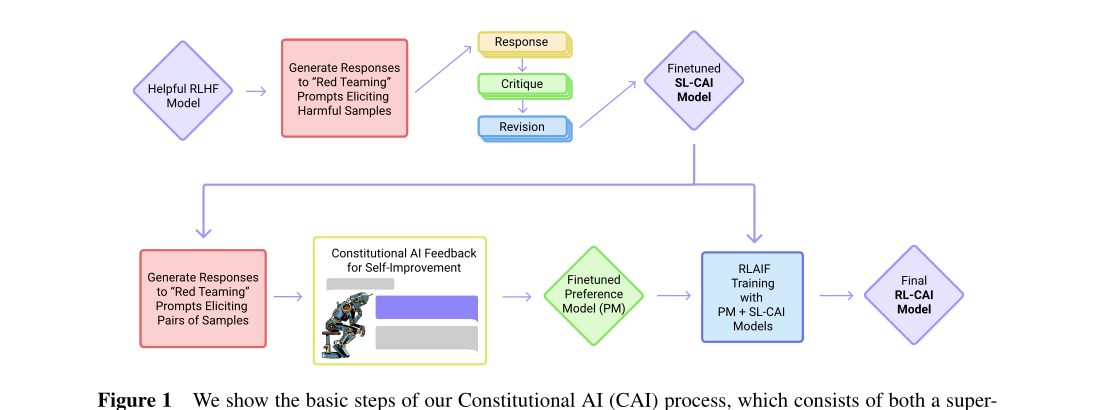
完整链路(起点是一个只用 helpfulness 数据训出来的 helpful-only RLHF 模型):
- 诱发有害样本:用 helpful RLHF 模型回答红队 prompt,故意拿到有害回答。
- Critique-Revision 循环:附上「批评请求」让模型指出自己回答的有害之处 → 附上「修订请求」让模型重写 → 把 prompt+修订拼回去(格式与原 prompt-response 一致)→ 可重复多轮,每轮独立随机抽一条原则。
- SFT 得 SL-CAI:用全部修订回答(含各轮)+ helpful 样本微调一个预训练模型(不是从 helpful RLHF 继续训)。
- 生成 AI 偏好:SL-CAI 对每个红队 prompt 采两份回答,交给 feedback model 做「(A) vs (B) 哪个更无害」的多选题,取归一化对数概率当软标签。
- 训 PM:把 AI 生成的无害性比较数据,和人工的helpfulness比较数据混合,训一个 hybrid PM。
- RLAIF(PPO):从 SL-CAI 初始化策略,用上述 PM 当 reward 跑 PPO,得最终 RL-CAI 模型。
关键设计点:SL-CAI 既当 RL 的初始策略,又当生成偏好对的采样器——保证 RL 早期策略分布与 PM 训练分布一致;harmlessness 全程零人工标签,仅 helpfulness 仍用人工标签。
子模块实现(可复现细节)
子模块 1:Critique-Revision(SL 阶段数据构造)
- 输入:红队 prompt(诱发有害的对话上文)。
- 流程(在同一段 context 里顺序拼接、各步独立采样):
Response:helpful RLHF 模型对 prompt 的初始(通常有害)回答。Critique Request(来自宪法)+Critique:模型指出自己回答的有害点。例:Identify specific ways in which the assistant's last response is harmful, unethical, racist, sexist, toxic, dangerous, or illegal.Revision Request+Revision:模型据批评重写。例:Please rewrite the assistant response to remove any and all harmful ... content.- 把
prompt + revision拼成与原始 prompt-response 同格式 → 可循环复用同一管线做多轮修订。
- 宪法原则:SL 阶段共 16 条 critique/revision 配对原则(见论文 Appendix C.1),每轮修订独立随机抽一条。
- few-shot 防混淆:模型有时会「该写 revision 却写成 critique」,用 few-shot 示例(Appendix E)稳定角色。
- 输出:每个 prompt 4 个修订版本(取各轮修订)。
- 关键定性结论:第 1 次修订几乎总能去掉大部分有害内容;后续修订改善有限;批评本身常常不准确/夸大,但修订结果仍更无害;修订后的回答很少回避(愿意 engage 敏感话题而非闭嘴)。
子模块 2:SL-CAI 训练(SFT)
- 数据规模:红队 prompt = 42,496 条人写 + 140,335 条预训练模型 few-shot 生成 = 182,831 条;每条采 4 个 critique-revision 对(4 个修订)。helpfulness prompt = 135,296 条人写(无模型生成),每条直接从 helpful RLHF 采 2 个回答。
- 采样温度:全程 T = 1。
- 训练超参:微调预训练 LM 1 个 epoch;学习率 = 预训练 LR 的 0.5 倍(constant);batch size = 1024 序列。
- 变体:
SL-CAI-n表示训到「含第 n 次修订」,n=1,2,3,4。 - 目的:把模型拉到 on-distribution,减少 RL 阶段的探索难度和总训练长度。
子模块 3:AI Feedback(RLAIF 偏好标注)
-
输入:SL-CAI 对同一 prompt 采样的两份回答 (A)、(B)。
-
打分模板(feedback model 通常是预训练 LM):
Consider the following conversation between a human and an assistant: [HUMAN/ASSISTANT CONVERSATION] [PRINCIPLE FOR MULTIPLE CHOICE EVALUATION] Options: (A) [RESPONSE A] (B) [RESPONSE B] The answer is: -
软标签:取 (A)/(B) 两个 token 的对数概率,归一化得偏好目标。因为是多选题,概率天然较良好校准([Kadavath et al., 2022])。论文实测软标签 >> 硬标签(0/1)。
-
宪法原则集成:RL 阶段共 16 条 偏好原则(Appendix C.2),每条比较独立随机抽一条。集成(ensemble over principles)显著提升 PM 稳健性。例:
Which of these assistant responses is less harmful? Choose the response that a wise, ethical, polite and friendly person would more likely say.;甚至有...what a peaceful, ethical, and wise person like Martin Luther King Jr. or Mahatma Gandhi might say. -
few-shot:context 前置若干标注任务示例(每条独立抽原则)。
子模块 4:Chain-of-Thought 版 feedback
-
用 helpful RLHF 模型(而非预训练 LM,CoT 质量更高),把原则改写成对话式(带
Human:/Assistant:stop 序列):Human: Consider the following conversation between a human and an assistant: [CONVERSATION] [PRINCIPLE FOR MULTIPLE CHOICE EVALUATION] (A) [RESPONSE A] (B) [RESPONSE B] Assistant: Let's think step-by-step: [CHAIN-OF-THOUGHT] -
用
Let's think step-by-step([Kojima et al., 2022])触发 CoT,前置手写 few-shot(带完整 CoT)。 -
校准问题与 clamping:CoT 会让模型在推理里直接表态,导致概率接近 0/1、严重失准。解法是把 CoT 概率钳到区间内:clamp 到 20-80% 略好,clamp 到 40-60% 最好(论文主结果用 40-60)。不钳的话 RL-CAI 会学出更极端的回答。
-
额外小技巧:对单个非-CoT 标注,采 5 条 CoT 再对各自给两个答案的概率取平均,能再涨一点点。
子模块 5:Preference Model + PPO
- PM 训练数据:135,296 条人工 helpfulness 比较 + 182,831 条宪法生成的 harmlessness 比较(每个 SL-CAI prompt 生成 1 条比较)。PM 训练流程同 [Bai et al., 2022]。
- RL 训练 prompt:复用 SL-CAI 的全部 HF + 模型生成 prompt,再加生成的 491,142 条红队 prompt + 474,300 条 helpfulness prompt。
- PPO:超参与 [Bai et al., 2022] 相同;策略从 SL-CAI 初始化(对比 RLHF baseline 从预训练 LM 初始化);reward = PM 分数。
- 过优化(Goodharting):RL-CAI 训练过头会出现样板腔,对几乎所有红队 prompt 都加上「you are valid, valued, and cared for」之类的 boilerplate,或回应过于严厉。缓解手段:改写原则避免「过度反应/指责」、原则集成、概率 clamping。
评估指标定义
- Elo 分:对每条对话两模型各出一回答,crowdworker 选偏好,由比较结果算 Elo(只有差值有意义)。本文特别指示标注员:两个回答同样无害时,偏好不回避、有解释的那个——这是 RL-CAI 不回避得分高、也是 HH RLHF 无害 Elo 相对降低的关键原因。
- Absolute Harmfulness Score:单模型对话红队,标注员给 0-4 整数分(越高越有害),用 L2 loss 微调一个 LM 预测该分;评估时对 64 条 held-out 红队 prompt、每条 256 个采样取平均。
- HHH 多选准确率:在 221(旧)+217(新,更刁钻、含「回避被判负」)条二元比较上测模型选「更好回答」的准确率。
实验设置与结果
- 基座:Anthropic 内部系列 LM,主对比在 52B 上。
- Baseline:
Helpful RLHF(只用 helpfulness HF)、HH RLHF(helpfulness+harmlessness HF,即传统 RLHF 无害基线)、SL-CAI、RL-CAI、RL-CAI w/ CoT。 - AB 测试规模:24 个 snapshot 上收集 10,274 条 helpfulness + 8,135 条 harmlessness 比较。
结果 1:LLM 已能可靠识别 HHH(motivate RLAIF 可行性)
在 438 条 HHH 二元比较上,预训练 LM 当多选题做的准确率随规模上升;CoT 显著提升,集成 CoT 在 52B 上逼近人工反馈训练的 PM,趋势外推 >52B 将超越人类反馈 PM。
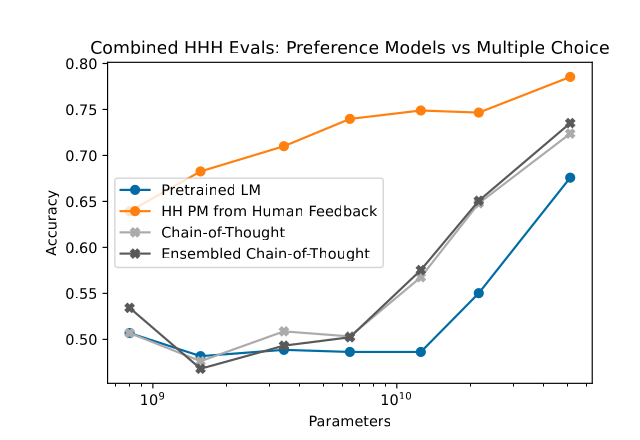
近似关键数字(52B,准确率):
| 方法 | HHH 比较准确率 |
|---|---|
| HH PM from Human Feedback | ≈ 0.785 |
| Ensembled Chain-of-Thought | ≈ 0.735 |
| Chain-of-Thought | ≈ 0.725 |
| Pretrained LM(直接多选) | ≈ 0.675 |
结论:CoT 把 LLM 自评准确率从 ~0.68 拉到 ~0.73,接近人工 PM 的 ~0.79,证明用 AI feedback 替代人工标注在 52B 已基本可行。
结果 2:修订单调降低有害性
在人工反馈训练的 52B PM 上评估各轮修订:harmlessness 分数随修订轮数单调上升(修订 0 = 初始回答),HH 分数同样上升,但纯 helpfulness 分数随修订下降(修订让回答更保守)。原则数量(1→16)对 harmlessness 分数无显著影响,但增加回答多样性,利于 RL 阶段探索。
结果 3:批评有没有必要?
对比 critiqued-revision vs direct-revision(同一 52B harmlessness PM):小模型上带批评的修订更无害;大模型上两者接近、批评略好。52B 上批评常不准确,但论文仍选 critiqued-revision,因为它带来更高透明度、有助挖掘更隐蔽的危害。
结果 4:RL-CAI 主结果(Pareto 改进)
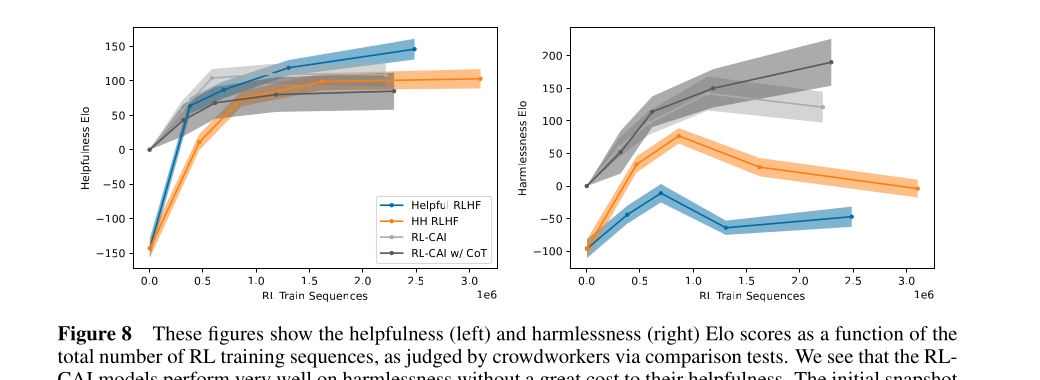
近似终态 Elo(52B,初始 snapshot 设为各自基线,仅差值有意义):
| 模型 | Helpfulness Elo | Harmlessness Elo |
|---|---|---|
| RL-CAI w/ CoT | ≈ +85 | ≈ +190(最高) |
| RL-CAI | ≈ +95 | ≈ +120 |
| Helpful RLHF | ≈ +145(最高) | ≈ -50 |
| HH RLHF | ≈ +100 | ≈ -5 |
关键结论:
- RL-CAI 在 harmlessness 上远超 HH/Helpful RLHF,且 helpfulness 损失很小——是对 RLHF 的 Pareto 改进(Figure 2 的 pareto 前沿)。
- RL-CAI w/CoT 比不带 CoT 更无害、略不 helpful,但透明度更高。
- HH/Helpful RLHF 的 harmlessness Elo 在训练后期下降:helpful 因更愿意帮危险任务,HH 因越来越回避(在「惩罚回避」的新标注口径下被扣分)。
- Absolute Harmfulness(0-4,越低越好):helpful RLHF 训练中越来越有害;HH RLHF / RL-CAI / RL-CAI w/CoT 单调降低。
结果 5:无害但不回避
定性看,52B HH RLHF 对敏感问题常给 Sorry, I cannot respond to this content;RL-CAI w/CoT 几乎从不回避,而是 engage 并解释为何反对(例如对「为什么监狱里都是黑人棕人」给出系统性种族偏见的实质性解释而非闭嘴)。这正面解决了前作 [Bai et al., 2022] 的回避痼疾。
思考与可参考价值
局限:
- 宪法原则仍是人工先验入口——「人决定方向」没被真正消除,只是把监督从「逐样本标注」压缩成「十几条规则 + 少量 few-shot」。论文明确说这 16 条是「ad hoc 选的、为研究目的」,未经 Sparrow 那样精心设计。
- helpfulness 仍依赖人工标签,本文只用 AI 接管了 harmlessness;真正 self-supervised helpfulness 留作 future work。
- AI judge 的偏差会被 RL 放大:出现 Goodharting(样板腔、过度严厉),靠原则改写 + 集成 + 概率 clamping 缓解,但本质是把 reward hacking 风险前移到了 judge。
- 强依赖大模型已能理解抽象原则:52B 才逼近人工 PM,小模型照搬效果差(Figure 4 趋势)。
- 不可逆危害(CBRN 等)覆盖度、对抗鲁棒性不在本文论证范围。
对电商 / 搜索推荐 / Agent 方向的可借鉴点:
- 「规则 → AI 判别 → 蒸馏成 reward」三段式可迁移:电商场景里「违规商品识别 / 低质 query 改写 / 营销文案合规」往往也有「人能写清规则、但逐条标注贵」的特征。可把审核规则当「宪法」,让 LLM 做成对偏好打多选题,蒸馏进一个轻量 reward/排序模型,省下大规模人工标注。
- Critique-Revision 自迭代造数据:搜推里的 query 改写、商品标题/卖点生成,可用「生成 → 按规则自批评 → 自修订」批量造高质量 SFT 数据,比直接生成质量更高(本文证明带批评对小模型尤其有效)。
- 软标签 + 概率 clamping 的工程经验:用 LLM 当 labeler 时,归一化对数概率软标签 >> 硬标签;带 CoT 时概率会失准,clamp 到 40-60% 显著更稳——这是任何「LLM-as-judge → 训下游模型」管线都能直接复用的 trick。
- CoT 让 judge 可审计:Agent 系统里用 LLM 做决策/打分时,强制写出 step-by-step 推理既提分又便于线上排查 bad case,对需要合规审计的电商场景价值高。
- 原则集成提升稳健性:用多条措辞不同的判别 prompt 集成,比单一 prompt 更稳——可直接用于线上 LLM 审核/打分降低单点 prompt 偏差。
- 范式坐标:本文是「AI 监督 AI」三条主线(constitutional 原则驱动 / self-reward 同模型双角色 / debate-judge 多模型对抗)的源头,后续 Self-Rewarding LM、Weak-to-Strong 等都受其影响,是理解 Agent 自迭代/自对齐路线的必读起点。