Cola DLM: Continuous Latent Diffusion Language Model
ByteDance Seed × HKU × ANU × PKU × RUC
把扩散建模从「对 token 做 observation recovery」升级为「对连续隐变量做 prior transport」:先用 Text VAE 学文本↔latent 的稳定映射,再用 block-causal DiT + Flow Matching 在 latent 空间学 global semantic prior,最后由 conditional decoder 实现局部 token。用 unified Markov-path view 把自身与 AR / LLaDA / Plaid 在理论上完全区分。
核心思路
问题一句话:现有非 AR 文本生成(离散 diffusion LLaDA、连续 token-aligned diffusion Plaid)的扩散过程本质都是「在 token 空间或 token-aligned 表示上做 observation recovery(恢复被噪声破坏的观测)」,中间离散/对齐状态难以稳定承载全局语义,也没有显式的层次化隐变量,因此无法同时拿到「生成效率 + 可 scale 的表示 + 全局语义建模」。
关键 idea:把图像域 LDM(Stable Diffusion 的 latent diffusion 优于 pixel diffusion)的范式真正搬到文本——扩散的角色不应是「恢复观测」而应是「传输先验」(latent prior transport)。Cola DLM 把文本生成显式拆成两层:
- 全局语义组织:在连续 latent 空间
z₀∈ℝ^d上,用 block-causal DiT + Flow Matching 学一个先验p_ψ(z₀); - 局部 token 实现:用条件解码器
p_θ(x|z₀)把 latent 还原成离散文本。
生成模型的定义就是这个层次分解:
p(x, z₀) = p_θ(x|z₀) · p_ψ(z₀), p(x) = ∫ p_θ(x|z₀) p_ψ(z₀) dz₀
注意 q_ϕ(z₀|x)(VAE encoder)只在训练时做变分推断用,不属于生成模型本身。扩散(Flow Matching)只是学 p_ψ 的 solver,而不是模型的定义。作者进一步用 unified Markov-path 视角(见下表)证明:AR 走 prefix 直接生成路径、LLaDA/Plaid 走离散/连续 observation-recovery 路径,只有 Cola DLM 走 prior-transport 路径且唯一拥有 explicit latent。
| Method | State Space | Path Role | Generative Factorization | Explicit Latent |
|---|---|---|---|---|
| AR | Prefix Tokens | Direct Generation | ∏ᵢ p(xᵢ|x_{<i}) | ✗ |
| LLaDA | Discrete Masked Seq | Discrete Observation-Recovery | p(s_T)∏ p_θ(s_{t-1}|s_t) | ✗ |
| Plaid | Continuous Token-Aligned | Continuous Observation-Recovery | p(h_T)∏ p_θ(h_{t-1}|h_t) | ✗ |
| Cola DLM | Compressed Latent Seq | Prior-Transport | ∫ p_θ(x|z₀) p_ψ(z₀) dz₀ | ✓ |
整体实现思路
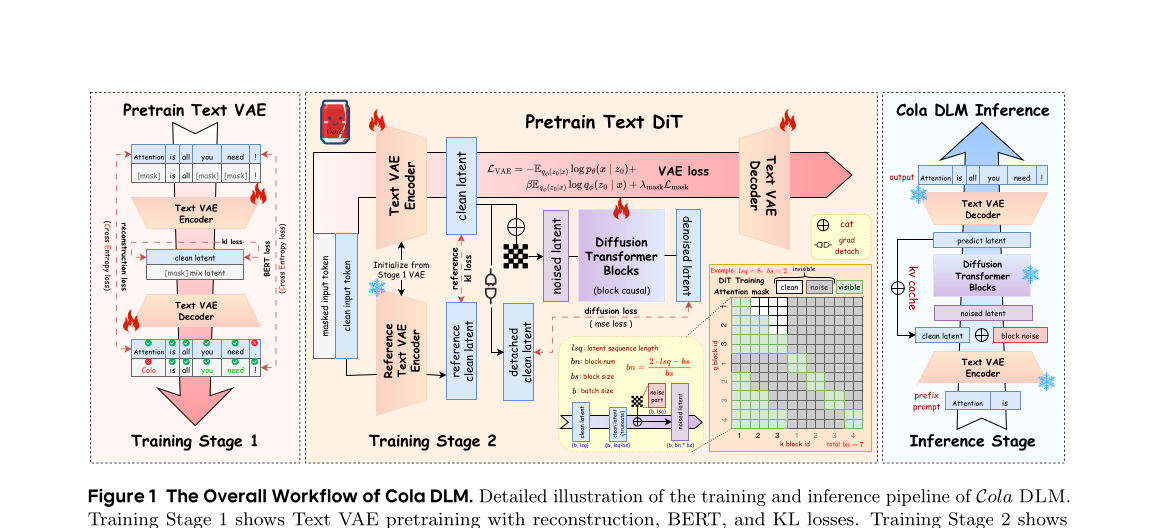
端到端是 两阶段训练 + 一阶段推理:
- Stage 1 — Pretrain Text VAE(500M):strict-causal 的 encoder/decoder,学一个稳定的「文本↔latent」映射界面。loss = 重建 + β·KL(约束到 base 先验)+ λ_mask·BERT-style mask loss(防 encoder 语义塌缩、decoder 只记表面串)。VAE 不压缩序列长度(每 token 一个 latent),encoder/decoder 都严格因果以防信息泄漏、便于流式生成。
- Stage 2 — Joint VAE + Block-causal DiT(1.8B):在稳定 latent 上学最终条件先验
p_ψ(z₀)。DiT 采用 块内双向注意力 + 块间因果;对每个 block 做 conditional Flow Matching;同时 VAE 保持可训(与 DiT 联合 co-adaptation),并加一个 reference-encoder KL 抑制 latent drift。 - Inference:先把 prefix 编码成 clean latent 条件 → 逐 block 从噪声种子用 ODE 传输生成 latent(块间用 KV cache,自回归式地在 latent 空间往后推)→ conditional decoder 把生成的 latent block 解码成 token。8–10 步去噪即可基本饱和。
下图(论文 Figure 1)是完整 pipeline:左为 Stage 1 VAE 预训练(reconstruction / BERT / KL 三个 loss),中为 Stage 2 联合训练(带 grad-detach 的梯度控制 + block-causal attention mask),右为推理阶段(KV cache 的块式解码)。
子模块实现(可复现细节)
1. Text VAE(latent 接口)
- 输入/输出:输入离散 token 序列
x;encoder 输出后验q_ϕ(z₀|x)=N(μ_ϕ(x), diag(σ²_ϕ(x))),采样z₀∼q_ϕ;decoder 重建x̂∼p_θ(x|z₀)。 - 结构(Table 9):encoder/decoder 各 4 个 block,hidden=1,536,FFN=6,144,RoPE 位置编码,严格因果。latent 维度
d=16(默认最优配置),每 token 一个 latent(patch size=1,不压序列)。VAE 共 ~500M 参数。 - Stage 1 损失:
其中L_VAE = −E_{q_ϕ}[log p_θ(x|z₀)] + β·KL(q_ϕ(z₀|x) ‖ p_base(z₀)) + λ_mask·L_maskL_mask是 BERT-style masking loss(对 latent 加 [mask] 后要求 decoder 恢复原 token 的交叉熵),作用是防止 latent 语义塌缩 + decoder 死记表面文本。消融证明:在 latent 主动更新(VAE lr 比 = 1)时加 BERT loss 一致提升下游;lr 比 = 0.01 时增益有限。 - VAE logSNR(关键平滑度旋钮,Appendix H.7):定义为后验均值信号功率 / 后验方差噪声功率的对数比
logSNR 越大 → latent 越「干净/确定」。消融(Table 3):learnable logSNR(实测≈4.5)整体最优,固定 logSNR=1.5 是最强固定备选。注意低 logSNR 会平滑局部密度、改善 likelihood-PPL,但模糊语义、生成退化(见 §实验 PPL≠质量)。logSNR_vae = log( E_{x,i}[μ_{ϕ,i}(x)²] / E_{x,i}[σ²_{ϕ,i}(x)] )
2. Block-causal DiT(先验学习)
- 结构(Table 9):hidden=2,048,FFN=8,192,24 层,16 个 attention head(head dim=128),RoPE,~1.8B 参数。
- 可见集(block b 的注意力可见范围):
V_b = { sg(z₀^{(<b)}), z_t^{(b)} }sg(·)是 stop-gradient——历史块用 clean latent 且 detach 梯度,当前块是带噪 latent。这实现了「块内双向、块间因果」,对应先验分解p_ψ(z₀)=p_ψ(z₀^{(1)})∏_{b≥2} p_ψ(z₀^{(b)}|z₀^{(<b)})。 - Flow Matching 目标(Eq. 3.7):
L_FM = Σ_b E_{t,z₀,z₁} ‖ v_ψ(z_t^{(b)}, t; z₀^{(<b)}) − u_t^{(b)}(z₀,z₁) ‖²₂v_ψ是要学的向量场,u_t是 ground-truth conditional velocity,z₁∼N(0,I)为 base 分布,推理时z₀=Φ_ψ^{0←1}(z₁)是 ODE 从噪声 transport 回 latent。 - Stage 2 联合损失(Eq. 3.18):
第一组保留带正则的自编码结构、第二项学块级条件先验、第三项(reference encoder KL)抑制联合训练时的 latent drift。L_stage2 = λ_VAE·( −E_{q_ϕ}[log p_θ(x|z₀)] + β·E_{q_ϕ}[log q_ϕ(z₀|x)] + λ_mask·L_mask ) + λ_fm·L_FM + λ_ref·E_{p_data} KL( q_ϕ(z₀|x) ‖ q_{ϕref}(z₀|x) ) - block size 消融(Figure 6):block size=16 在两个 checkpoint 上 Task Avg 均最优;64/128 明显变差(SIQA/MMLU 掉得多);block size=1(全因果细粒度)有竞争力但弱于 16 → 适度局部分组有益。
- DiT 张量维度(Figure 1 标注):clean latent
(b, lsq)、truncate 后(b, lsq−bs)、噪声部分(b, bn·bs),其中b=batch、lsq=latent 序列长、bs=block size、bn=block num。
3. 噪声调度(timeshift,Appendix H.9)
不用均匀采样 timestep,改用 LogitNormal:u∼N(μ,σ²),s=sigmoid(u)∈(0,1),t=T·s。即归一化 timestep s∼LogitNormal(μ,σ²)。增大 μ 把采样质量推向更晚的 timestep,σ 控制集中/分散程度。
- 论文里的 timeshift loc 即 μ。消融(Figure 7/8):
d=16下 loc=1.0 全任务最优(尤其 Joint DiT),loc=0 或 uniform 明显弱;信息论解释(Appendix G):loc 改变 logSNR 轨迹 → 改变 DiT 在去噪时看到的「有效语义信息区间」。 - RQ1 关键现象(Figure 2,原文):最优 timeshift loc 随 latent dim 系统性漂移:d=16→loc≈1.0、d=64→loc≈1.7、d=128→loc≈2.3,且经验峰值与理论预测一致。若 latent 纯局部可分离则不会漂移——漂移的存在反证了 latent 中存在 cross-dimensional shared semantic structure。
4. 推理(prefix 编码 + 块式生成 + 条件解码)
z_pre ∼ q_ϕ(z_pre | x_pre)                         # prefix 编码为 clean 条件
ẑ₀^{(b)} = Φ_ψ^{0←1}( ε^{(b)}; z_pre, ẑ₀^{(<b)} ),  ε^{(b)}∼N(0,I)   # 逐块 ODE transport
x̂_res ∼ p_θ( x_res | z_pre, ẑ₀^{(1:B)} )           # 条件解码出 token
- first-block 条件化(§5.2, Table 5):第一生成块混合已知 prompt latent + 待生成 latent。对比 partial repaint / clean condition repaint / left-right padding:clean condition repaint(全程把已知区固定为干净条件)最优(Avg 24.6),partial repaint 弱很多(Avg 8–9),padding 居中。结论:强且持久的条件 > 部分噪声修正 > 仅调位置布局。
- 不确定性估计(Algorithm 1/2):
log p_ψ(z₀)用 CNF change-of-variables(解 augmented ODE 累积散度ℓ),高维散度用 Hutchinson trace estimator(一次 ODE solve 内固定同一个 ε);条件似然log p(x_res|x_pre)=log p(x_pre,x_res)−log p(x_pre)。
5. 统一多模态扩展(§5.5,prototype)
模态各自 VAE 出 latent,拼成 joint latent z̃₀=(z₀^text, z₀^img),共享 block-causal MMDiT 先验 transport,模态各自 decoder 实现。Image VAE:内部多分辨率数据(256/384/640/1024),空间下采样 16×、64 latent channel,图像 latent 当作一个大 block,文本仍切块。训练:256 分辨率 80k 步(global batch≈3k)→ 640 分辨率 10k 步(batch≈1k);image-conditioned text 约 50k 步。当前仅 qualitative。
实验设置与结果
设置(严格对齐,Table 8/9)
- 数据/分词:外部开源预训练语料;OLMo 2 tokenizer(vocab 100,278)。
- 优化:AdamW,betas (0.9,0.95),weight decay 0.01,grad clip 1.0;峰值 lr
1.5e-4,前 5k 步从1e-6线性 warmup,cosine 衰减到1e-5(1,000,000 步);max seq len 512,global batch 1,408(720,896 tokens/step);bf16 autocast(LayerNorm/softmax 留 fp32),random seed 66 / data seed 6198 全模型一致(训练数据严格 matched)。 - 参数规模 strictly matched:
| AR | LLaDA | Cola DLM | |
|---|---|---|---|
| 类型 | Autoregressive | Masked diffusion | Continuous latent diffusion |
| 总参数 | ~2.2B | ~2.2B | ~2.3B |
| core non-embed | ~1.8B | ~1.8B DiT | ~1.8B DiT |
| VAE | – | – | ~500M |
| embedding | 410.7M | 410.7M | 308.1M |
| hidden / FFN | 2048 / 8192 | 2048 / 8192 | DiT 2048 / 8192 |
| 层数 | 27 | 27 | DiT 24 |
| 注意力 | Causal | Bidirectional | VAE causal + DiT block-causal |
- 评估协议:8 benchmark(MMLU/RACE/Story Cloze/LAMBADA/OBQA/HellaSwag/SIQA/SQuAD),全部统一为 few-shot generative(2-shot,多选题让模型生成选项文本而非标签,首行截断+归一化后字符串匹配;LAMBADA 0-shot 续写取首词;SQuAD 1-shot 抽取式生成)。scaling 跑到 ~2000 EFLOPs。
- 最优配置(RQ4):
d=16、block size 16、joint VAE-DiT(lr 比=1)、BERT loss、logit-normal loc=1;推理 16 步去噪、CFG=7。
注意:所有多选题用「生成式」协议而非传统 likelihood 分类,导致绝对分偏低;这是为公平对比刻意为之,relative scaling trend 才是结论载体。
主结果:scaling 对比(论文 Figure 10)
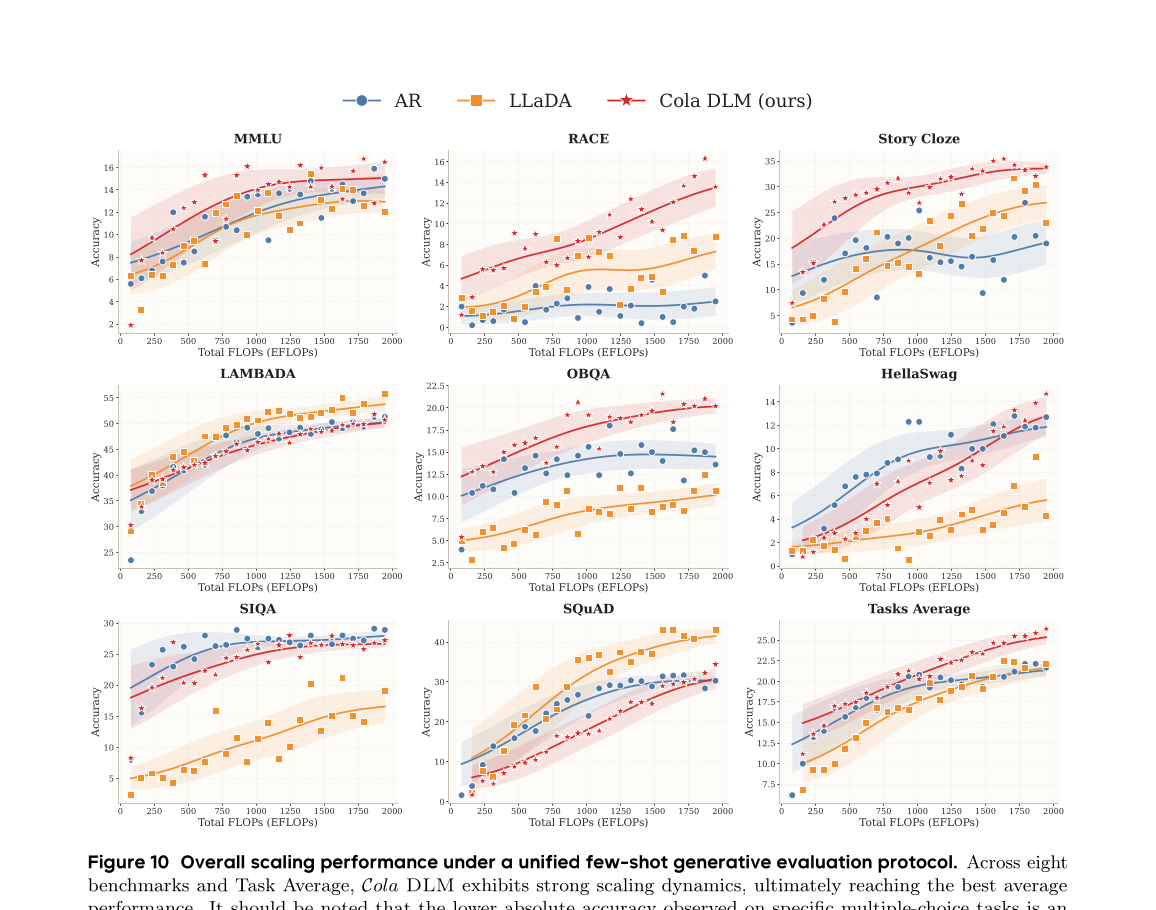
- Task Average:Cola DLM 随 compute 持续上升,最终达到最优;AR 在小预算有竞争力,LLaDA 早期有增益,但 Cola 在高 compute 区段升得更持久。
- 推理/全局语义任务(MMLU, RACE, Story Cloze, OBQA):Cola DLM 维持强上升趋势、中大预算最优或近最优——连续 latent prior 适合依赖全局语义组织、整体答案形成的任务。
- 生成任务(LAMBADA, SQuAD):LAMBADA 稳步逼近 AR;SQuAD 随 scale 增益明显,最终超过 AR、逼近 LLaDA 的强区。
- 作者强调当前是保守配置(d=16 而非 128,logSNR 仍有空间),实际上界更高。
推理超参(论文 Figure 9)
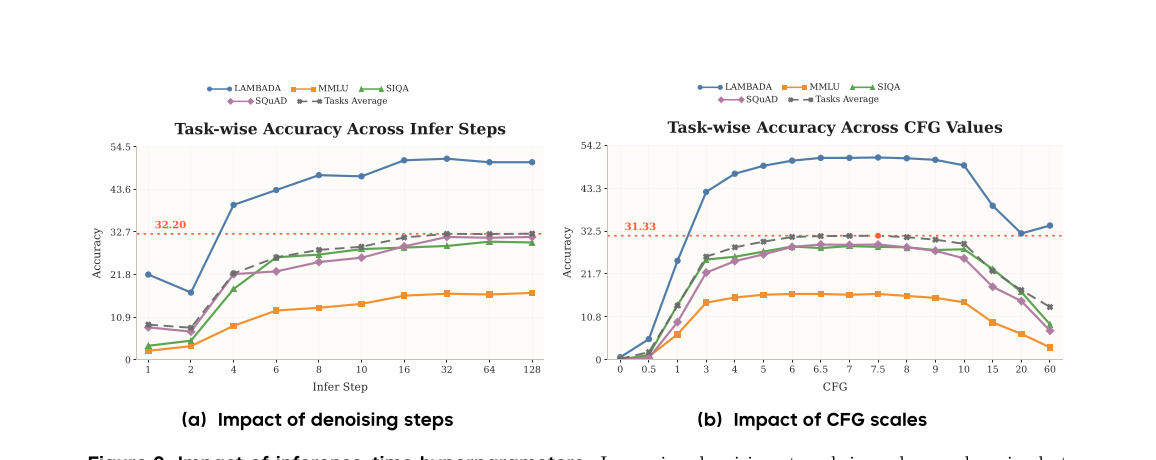
- 去噪步数:1-2 步严重不足,4-8 步全任务大涨,16-32 步后近乎平坦。8-10 步已恢复绝大部分性能;因 block size=16,意味着 16 个 token 只需 8-10 次串行去噪迭代,相对 AR 解码 1.6-2.0× 减少串行生成深度。
- CFG:3-6 最优,过强(>10,尤其 20/60)严重破坏去噪轨迹。最终选 CFG=7。
其他关键消融
| 维度 | 结论 |
|---|---|
| latent 演化策略(Fig 3/4 原文) | 既不固定也不从头训:从稳定预训练 VAE 出发 + 与 DiT 联合强更新(lr 比=1) scaling 最强;All-Scratch 最差(说明靠的不是可训性而是好初始化);lr 比=0.01 / interval 冻结都更弱 |
| latent 维度(Table 2,117 EFLOPs) | d=16→avg 8.7、d=64→11.3、d=128→11.8(MMLU/SIQA 提升最明显),但纯靠加维不能替代正确的 latent 形成 + 噪声标定 |
| latent 压缩 patch(Table 6,d=128) | p2(2 token→1 latent)整体弱于 p1,但几乎全因 prompt 长度不能被 2 整除(Mod1)的边界塌缩;Mod0(偶长)下 p2 反而略超 p1 → 压缩本身可行,瓶颈是非整除边界处理 |
PPL ≠ 生成质量(§5.1, Table 4,结构性发现)
token-level 证据:对目标词 at,固定 VAE logSNR 把 likelihood-PPL 从 1.15e6 改善到 641→245,但生成 token 从 on 退化为 in→逗号。原因:生成只要求先验质量落到 decoder-valid 区域(语义平滑度),而 likelihood-PPL 还额外要求 gold posterior 邻域的局部密度精确标定(概率空间平滑度,由 VAE logSNR 决定)——两种平滑度不同,故二者不必对齐。作者把它定义为这类模型的「特性」而非 bug,并据此主张用 generation quality + scaling trend 而非 PPL 评判模型能力。
思考与可参考价值
局限:
- 规模偏小:~2B 对 2026 年的 LLM standard 不足以撑起「AR 替代品」的声明,缺 instruction tuning / chat 评估;多选题绝对分低(生成式协议所致)。
- block-causal 仍是块间因果,1.6-2.0× 串行减少在工程上有意义但不算激进的「真·非 AR」。
- PPL 不对齐虽被定义为特性,但实际给 reward design / 早停 / 在线监控带来困难(没有可靠的 likelihood 信号)。
- 多模态部分仍是 qualitative prototype,缺数据清洗与 SFT;超参(latent dim / logSNR / block size / 噪声调度)耦合敏感,调参成本高。
对电商/搜索推荐/Agent 的可借鉴点:
- 「prior transport vs observation recovery」是一把好尺子:做生成式推荐 / query 改写 / 商品文案生成时,可以先问「我是在恢复一个观测,还是在传输一个先验」——如果任务有低维全局语义(如「这条 query 的购买意图」「这个用户的偏好结构」)+ 高维局部实现(具体 token/商品 id),那 latent-prior 分解可能比 token-level AR 更贴近真实生成机制。论文给的三条曲线判据(
D(R)在低 rate 已小 ∧E(M)下降 ∧ inference gap 可控)可直接当「该不该上 latent diffusion」的事前判断。 - hierarchical latent + modality-specific decoder 是 unified 多模态(商品图×标题×属性)最干净的一条路:共享 latent prior 组织跨模态全局语义,各模态 decoder 管局部实现——对「图文统一商品理解/生成」有结构启发。
- block-causal + KV cache 的块式 latent 生成:在保留流式/因果的前提下把串行深度压 1.6-2.0×,对低延迟在线生成(实时文案、对话 Agent)有工程参考价值;block size=16、8-10 步去噪是可直接借的起点。
- 「评估语言要随表示和目标一起换」:当训练目标从 token-level MLE 变成 latent transport,PPL 就失效——这一点对推荐/Agent 里「用 likelihood 当 reward / 早停」的惯例是个警示,应转向生成质量与 scaling trend。
- 后续可追:scale 到 7B/70B、在 latent 空间做 reasoning RL(latent-space GRPO?)、用更强 latent 模块(AE/RAE)或 drifting-model 式分布匹配替换 Flow Matching、设计能对齐 PPL 与生成质量的新 objective。