OneSearch-V2: The Latent Reasoning Enhanced Self-distillation Generative Search Framework
Kuaishou Technology
OneSearch 的 V2,给生成式电商搜索加「潜在推理 + 自蒸馏」三件套:① 用 LLM 造 keyword-based CoT 教小模型深度理解复杂/长尾 query;② 用「同权重 teacher(带 CoT)/student(不带)」自蒸馏把推理内化进参数,推理时零额外 token/延迟;③ 用真实行为反馈 + TPMA-GRPO(按 SID 层级位置分配 advantage + 前缀门控)替代独立 reward model。线上 +3.98% item CTR / +3.45% GMV,且不增推理成本。
核心思路
生成式检索(GR)用单模型端到端把电商搜索做完(query → 自回归生成 item 的 Semantic ID),比多级级联架构更高效、可联合优化。Kuaishou 的 OneSearch(V1) 已工业级部署,但有三个瓶颈:① 复杂 query 理解不足(2-3 词短 query 常不指明具体 item,长尾/否定/问句类语义鸿沟大);② 个性化意图推理弱(靠历史共现 + log 拟合,浅匹配,挖不出真实意图);③ reward 系统脆弱(独立训练的 RM 采样偏置 + reward hacking,过拟合历史偏好,加剧信息茧房与长尾稀疏)。
关键 idea:给 GR 加「潜在推理 + 自蒸馏」,但推理时零额外开销。三招:用 LLM 离线造关键词式 CoT教模型理解复杂 query;用同权重 teacher/student 自蒸馏把推理能力内化进参数(不加 token/不改结构);用真实行为反馈 + 位置感知的 TPMA-GRPO替代独立 RM。这是 OneRec/OneSearch 家族(OneRec/OneSug/OneRetrieval…)里专攻「让生成式搜索会推理且不增延迟」的一环。
整体实现思路
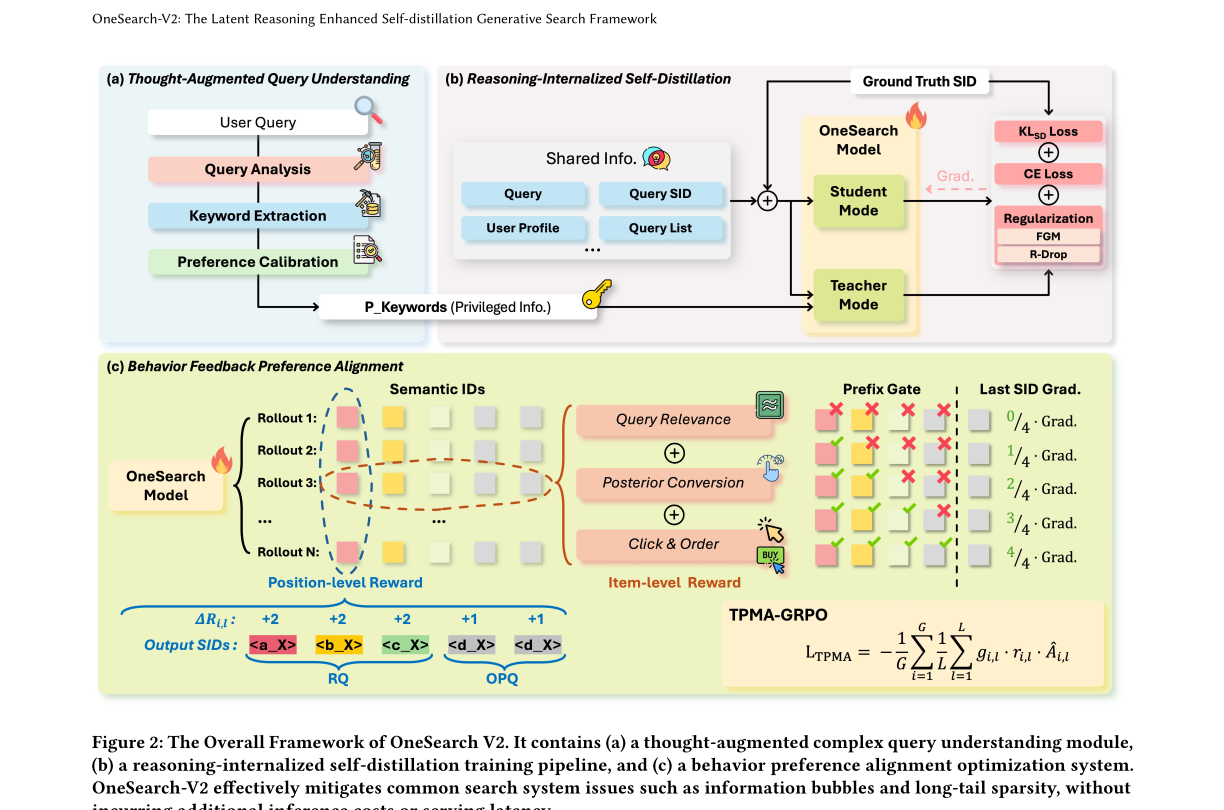
端到端是在 V1 基础上的三阶段 SFT + RL 训练管线(Table 2):
SFT Stage1 语义对齐(query/item↔SID, ↔category, + 4 个 CoT 任务)
  → SFT Stage2 共现同步(query↔item, SID_q↔SID_i)
  → SFT Stage3 用户个性化 + 自蒸馏(uid&q, SID_q&Seq_q, keywords(RAG)→SID_q)
  → RL(先 listwise DPO 学真实交互偏好,再 TPMA-GRPO 平衡多目标 reward)
在线推理时:query 经 KHQE 实时 tokenize → 模型一次前向生成 top-K SID(beam 512)→ 映射回 item。CoT 的生成是离线异步 + 缓存复用,不进在线链路;自蒸馏把推理内化后,在线 student 不需要 CoT 输入。
前置选型(§3.1):对比 unimodal / multimodal / KHQE 三种 SID tokenization(Table 1),unimodal 显著优于 multimodal(跨模态表征差异 + 冗余属性拖累多模态),而 V1 的 KHQE(关键词分层量化)最好(Recall@10 0.2542 / ICR 99.50%)且体积小可实时——所以 V2 沿用 KHQE。
子模块实现(可复现细节)
模块 ① Thought-Augmented Query Understanding(关键词式 CoT)
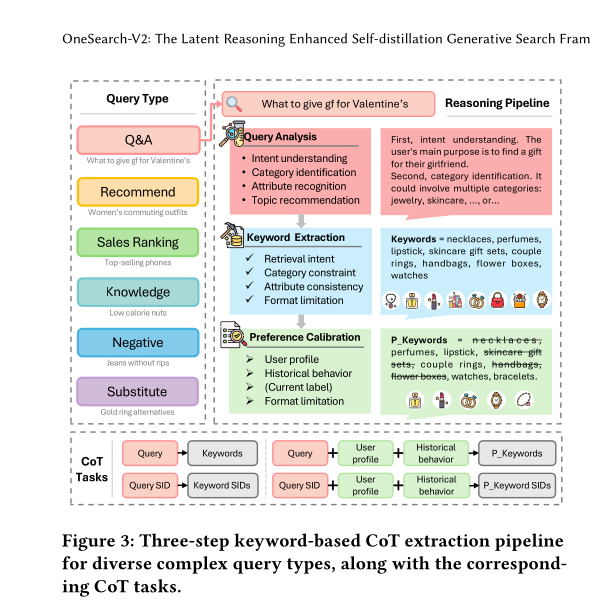
- 动机:Kuaishou Mall 上复杂 query 约占 1/3 PV 但只贡献 8% 转化;full CoT 太长小模型生成不起、且 SID 与文本异构。
- 三步 pipeline(用 Qwen3-32B 离线生成):Query Analysis(意图理解/类目识别/属性识别/话题推荐)→ Keyword Extraction(按意图+类目+属性一致性抽关键词,同义合并/去冗余/按热度排序)→ Preference Calibration(用用户画像+历史行为过滤/扩充关键词,训练时把当前 session 交互 item 注入,保证 ground-truth item 的关键词被保留)。
- 怎么用:
⟨query, keywords⟩与⟨query, user, keywords⟩元组作为 4 个 CoT 任务并入 SFT Stage1;注意显式 CoT(+direct CoT)反而暴跌(HR@10 order 0.0898 vs baseline 0.2046,SID↔文本异构),而把关键词当**输入端补充信号(+RAG)**才涨(0.2139)。
模块 ② Reasoning-Internalized Self-Distillation(同权重自蒸馏)
把「带 keyword 的推理」蒸进参数,不加参数/不加 token/不改结构:
- 信息不对称:teacher 输入 = student 输入 + keyword CoT;两者共享同一套权重 θ(省一半显存,无需独立 teacher)。
- teacher 输入
x^(T)=(uid,q,SID_q,Seq_q,Seq_short,Seq_long^emb, kw);student 输入x^(S)去掉kw。
- teacher 输入
- 蒸馏 loss(Eq.4-5):
L_KL = (1/|V|)Σ_t KL(softmax(z_t^(T)/τ) ‖ softmax(z_t^(S)/τ))·τ²,teacher logits detach(只更 student);L_base = L_CE(z^(S),y) + α_KL·L_KL。 - 治表征不稳(student 要从更少信息给出同样自信的预测,loss 面变尖):
- R-Drop(Eq.6):student 两次独立 dropout 前向
z_1,z_2,对称 KL½[KL(P1‖P2)+KL(P2‖P1)]拉一致。 - FGM(Eq.7):对 embedding 沿梯度方向加对抗扰动
r_adv=ε·∇_e L_base/‖∇_e L_base‖,再前向反向累积梯度,平滑 loss 面。
- R-Drop(Eq.6):student 两次独立 dropout 前向
- 总目标(Eq.8):
L_SDFT = L_CE + α_KL·L_KL + α_R·L_R-Drop + L_adv,并把 CE 换成 focal loss 治 SID 词表长尾类不均衡。
模块 ③ Behavior Feedback Preference Alignment(TPMA-GRPO)
去掉独立 RM,直接用真实交互反馈 + 位置感知 advantage:
- 复合 reward(Eq.9-10):
R_item = R_C&O + R_CTR + R_FR——R_C&O(下单 V_o=3 / 点击 V_c=4 的常数奖励)+ 校准后验 CTR(clip 到 (0,1) 防高 CTR 低相关项主导)+ 相关性(4 档 3-Excellent…0-Irrelevant)。加法设计避免 reward 稀疏。 - TPMA(Token-Position Marginal Advantage):SID 是 L=5 token 的粗→细层级序列,标准 GRPO 给每个 token 同一 sequence-level advantage(Eq.11-12)不合理。
- 前缀 reward(Eq.13-14):位置 l 的边际贡献
ΔR_{i,l}=[l<3]·2+[3≤l<L]·1(前 2 个共享/层级特征权重×2,后面唯一特征权重×1)。 - 位置级 advantage(Eq.15):每个位置只和组内其它 rollout 的同位置比,精确归因。
- 前缀门控(Eq.16):
g_{i,l}=[l=1]·1+[l≥2]·R_{i,l-1}/(l-1),前缀全对门全开(g=1)、前缀全错门全关(g=0)→ 抑制错误分支下游梯度,天然形成「先学粗再学细」的课程。 - 合并 advantage(Eq.18):
Â_final = Â_{i,l} + w_item·Â_item(位置结构 + 业务转化)。 - TPMA-GRPO loss(Eq.19):
L=-(1/G)Σ_i (1/L)Σ_l g_{i,l}·r_{i,l}·Â_final,故意不要 GRPO 的 clip——前缀门 g→0 时梯度自然消失,比显式截断更稳(类比 OneRec-V2 的 GBPO)。
- 前缀 reward(Eq.13-14):位置 l 的边际贡献
实验设置与结果
数据/骨干:Kuaishou Mall 搜索近 3 月交互对训练、末日 log 测试(30k click + 7229 order PV);骨干验证 Bart-B / GPT-2 / Qwen3-0.6B 都适用;CoT 用 Qwen3-32B 生成;beam 512;batch SFT/DPO/GRPO=512/2048/256;τ=1.0,α_KL=0.1,α_R=0.5,FGM ε=0.6,focal α=2 γ=3,V_o/V_c=3/4。
主结果(Table 5,逐项叠加):
| 方法 | Order HR@10 | Order MRR@10 | Click HR@10 |
|---|---|---|---|
| OneSearch(V1) | 0.2046 | 0.0985 | 0.2231 |
| + CoT tasks | 0.2094 | 0.1008 | 0.2266 |
| + self-distill | 0.2163 | 0.1017 | 0.2398 |
| + R-Drop | 0.2168 | 0.1045 | 0.2398 |
| + FGM | 0.2180 | 0.1047 | 0.2422 |
| + focal loss | 0.2214 | 0.1048 | 0.2471 |
| + GRPO | 0.2248 | 0.1106 | 0.2481 |
| + TPMA | 0.2265 | 0.1136 | 0.2498 |
| **OneSearch-V2(全) ** | 0.2314 | 0.1151 | 0.2568 |
- 有效 SID rate:click 98.90% / order 99.15%;消融(Table 3)显示 +direct CoT 暴跌(0.0898)、+RAG 才涨;Table 6 显示 R-Drop/FGM/focal 单加也有效、叠在自蒸馏上更稳。
- 在线 A/B(Kuaishou Mall):item CTR +3.98%、PV CTR +1.17%、buyer +2.90%、order +2.11%、GMV +3.45%;人工评测 page good rate +1.37%、query-item relevance +1.65%;且不增推理成本/延迟,缓解信息茧房与长尾稀疏。
思考与可参考价值
局限:① 全部离线指标基于 Kuaishou 单平台自有数据,无公开 benchmark;② keyword CoT 质量强依赖 Qwen3-32B 与离线 pipeline,冷启/无此基建难复用;③ 自蒸馏的 teacher/student 信息不对称靠 R-Drop+FGM+focal 三件套兜底,调参成本不低;④ TPMA 的 ΔR 权重(2/1)、V_o/V_c(3/4)是经验设定。
对电商/搜推的可借鉴点:
- “显式 CoT 训练时用、推理时内化” 是生成式搜推上潜在推理落地的关键范式——直接让小模型生成 CoF/CoT 会因 SID↔文本异构而暴跌,把推理当 privileged teacher 信息做同权重自蒸馏(零额外推理开销)是更务实的路子,可直接迁到你的生成式召回/排序。
- TPMA-GRPO 针对 SID「粗→细层级」做位置级 advantage + 前缀门控,解决标准 GRPO 给 SID 序列均匀 advantage 的 credit 错配——做 Semantic ID 生成式 RL 时值得抄(前缀门 g→0 替代 clip 防梯度爆炸也巧妙)。
- 直接行为反馈复合 reward(相关性+后验CTR+点击/下单)替代独立 RM,避免 RM 采样偏置/reward hacking,且支持流式更新接新 query——和 OneRec-V2 的”真实反馈 + GBPO”同思路。
- 与同家族 OneRetrieval(可编辑生成式检索)、OneReason(先想后答) 串读,是 Kuaishou 生成式搜推「会推理 + 可编辑 + 不增延迟」工业化的一条完整脉络。