OneRetrieval: Unifying Multi-Branch E-commerce Retrieval with an Editable Generative Model
Kuaishou (快手)
第一个可实时编辑的生成式检索框架:用 Keyword-Aligned Encoding(KAE) 把 item/query 编码成由「关键属性词」(而非量化 embedding)构成的 6-token 语义 ID,并预留一批 codebook 槽位,让运营像改倒排索引一样几小时内、不重训模型就注入新词/新品牌,从而有潜力用单个生成模型替换整个多路召回。深召回 HR@350 与最强生成基线 OneSearch 打平,干预命中率高一个数量级以上;线上替倒排分支订单 +0.71%。
核心思路
工业电商搜索召回是倒排(词面)+向量(语义)+协同三路并联,手工调融合、无法联合优化。生成式检索(GR)想用单模型收口,但卡在一个**「可编辑性悖论」:倒排分支转化率低于平台均值,却删不掉——因为它是唯一能让运营在几小时内注入新词/爆款品牌(如 LABUBU)且不重训模型的分支。它活着不是因为召回好,而是因为可编辑**。
现有 GR 结构性地不可编辑:闭码本(TIGER/DSI/OneSearch)每个槽绑定训练时固定的量化 embedding,新词进不来;开放词表(SEAL/GRAM)生成自由文本,新词能否路由全靠模型泛化,运营无显式绑定机制。
OneRetrieval 的关键 idea:开辟第三条标识符路线——可扩展码本(extensible codebook)。用 Keyword-Aligned Encoding(KAE) 把每个 SID token 锚定到一个可读的关键属性词(而非量化 embedding),并在每个码本位置预留一批空槽;新词部署后才绑到预留槽。这样可编辑性沉到上游字典(和倒排一样),而非藏在训练好的策略里。
整体实现思路
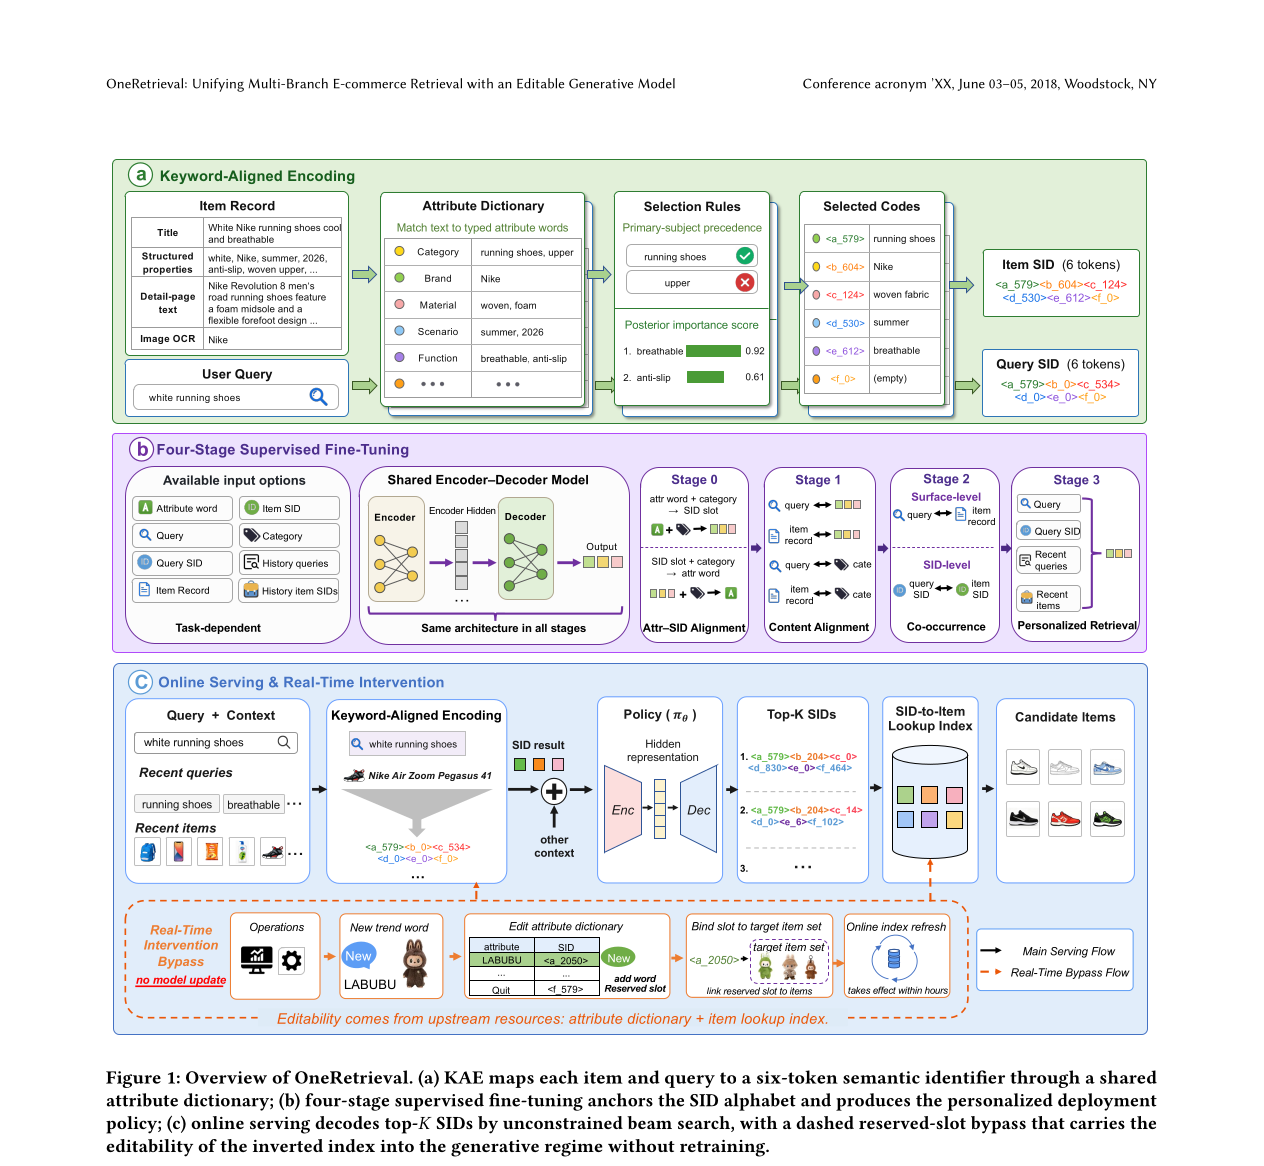
端到端把检索建模成对结构化语义 ID 的自回归生成:
item/query 文本 ──[KAE 确定性字典匹配]──> 6-token SID
        │
        ▼
   四阶段 SFT 训练策略 π_θ (BART-base + 9276 个 SID token)
        │
  在线: query ──KAE──> s_q ──[π_θ 无约束 beam search]──> top-K SID
                                   │
                          SID-to-item 查表 T (一对多) ──> 候选商品 ──> 预排序
        │
  旁路(实时干预,不训练): 运营给字典加新词→映射到预留槽→在 T 里把预留槽绑到目标商品集 → 几小时生效
形式化:item i 的 SID 为 s_i = (s_i^1,…,s_i^L),第 ℓ 个 token 取自位置专属码本 V_ℓ。策略自回归分解 π_θ(s|q,c_u)=∏_ℓ π_θ(s^ℓ | s^{<ℓ}, q, c_u),最大似然训练(对每个位置求和)。在线 R(q,c_u)=T(TopK_s π_θ(s|q,c_u)),TopK 用无约束 beam search 近似,T 是预算好的 SID→item 索引(一对多,所以解析出的候选通常多于 K)。
子模块实现(可复现细节)
1. KAE — 关键字对齐编码
- 输入:item 的标题 / 结构化属性 / 详情页 / 图片 OCR(拼接),或 query。
- 匹配:用 Aho-Corasick 自动机把文本对一份生产属性字典 A(去重后约 1.08×10⁶ 个 typed 属性词)做确定性匹配 → 在线零神经推理(字典离线由内部属性抽取模型 bootstrap)。
- 分组与选代表:18 类属性合并成 6 组(见模块 2);一组命中多个词时,用一张离线 importance table 选单一代表:① 主体优先(对每对同类共现词,离线问 LLM 谁是真正在卖的主体,如「ice cream / mold」选 mold);② 行为后验重要性(PV/CTR)排序。
- 输出:拼接每组的槽 → 6-token SID。对 item 和 query 对称编码;query SID 既是在线输入,也是 Stage 2/3 的协同训练信号。
2. 信息论属性分组(18→6)
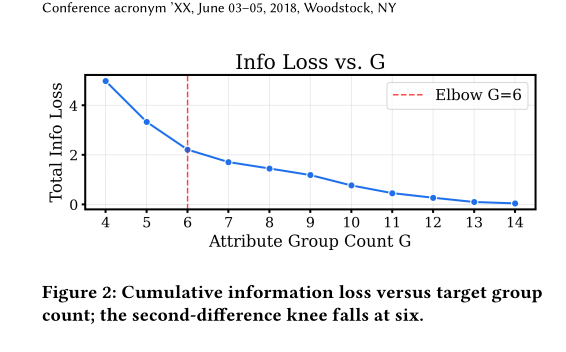
18 类各占一位会让 L=18、推理成本线性爆炸且每位密度稀释。把每个类别 X 当 Bernoulli 激活变量(item 是否带该类属性词),用对称条件熵度量把 X、Y 并到一位的信息损失:
IL(X,Y) = ½[H(X|Y)+H(Y|X)] = ½[H(X)+H(Y)] − MI(X,Y)
它是 variation of information 的一半,构成类别上的度量;做凝聚聚类,信息损失曲线二阶差分拐点 G=6(ECOM6)。
3. 可扩展码本(四块布局 —— 可编辑性的载体)
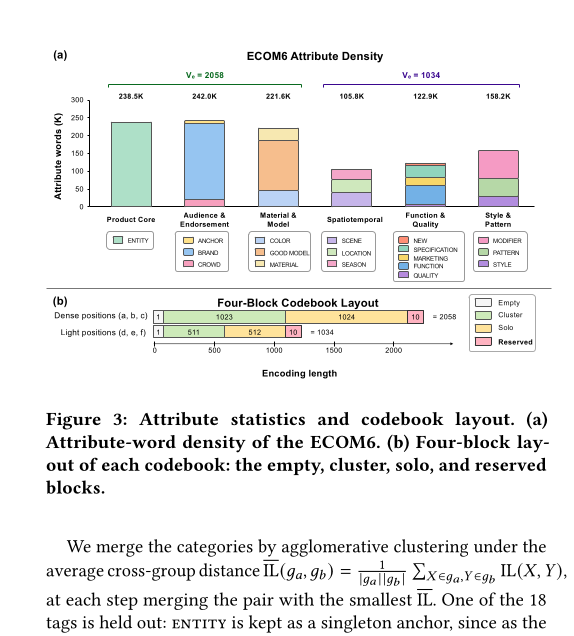
每个位置 ℓ 的码本分四块:
- empty 槽(index 0):表示该组无属性词命中。
- cluster 槽:k-means 质心,每个覆盖一簇同义尾词。
- solo 槽:高频头词,约一词一槽(双语别名/常见拼写错合并);密集位
V_solo=1024、轻位 512。 - reserved 预留槽:每位 10 个(共 60),训练时不绑任何词,部署后才绑新词;Stage 0–2 不出现,Stage 3 仅作为「身份路由」目标暴露。
密度感知非均匀分配 L6-D3:密集头 3 组各 V_ℓ=2048、轻尾 3 组各 1024 → 核心码本 ∑V_ℓ=9216 + 预留 60 = 9276 个 token 加进 BART 词表。60 个预留位「足够吸收平台一周趋势周期」。
4. 四阶段 SFT(BART-base,质量与可编辑性近似解耦)
| 阶段 | 任务模板 | 作用 |
|---|---|---|
| S0 属性–SID 对齐 | 属性词⟨attr⟩+类别⟨cate⟩→⟨a_v⟩ 及逆向,覆盖每个 solo/cluster 槽 | 锚定槽位语义,建立「词→对应位置」偏置(为可编辑性铺垫) |
| S1 内容对齐 | query/title ↔ SID 四个双向任务 + q→cate_q、title→cate_i 两个类别预测 | 召回质量主力(供给绝大部分 query↔SID / item↔SID 对齐) |
| S2 协同共现 | click/order 的 (q,i):表层 q↔title 两任务 + SID 层 s_q↔s_i 两任务 | 可编辑性主力(建立 query-SID→item-SID 路由) |
| S3 个性化检索 | (q, s_q, hist_q, hist_s) → s_i(s_i 为真实交互 item 的 SID) | 产出部署策略;滑窗刷新对齐最新流量 |
预留槽自路由监督(S3 内一小块,量级约 S3 的 10⁻⁵):形如 prefix(⟨ℓ_v⟩)→prefix(⟨ℓ_v⟩),教策略把任意预留前缀当恒等路由器;同时让从不作为目标的 token 不被负梯度抑制、保持可发射。
5. 在线服务 + 实时干预(三性质)
- 服务:query 经同一字典编码得 s_q(请求路径上除策略外无神经模块);π_θ 无约束 beam search(beam size 512)解出 top-K SID,每个 SID 经 T 物化最多 5 个 item,item 级算指标。
- 干预为何无需重训:(P1) 句法可达——beam search 任意位可发射任意码,预留槽是训练时已存在的字母表子集;(P2) 词无关身份路由——S3 自路由监督建立;(P3) 编码端确定性——Aho-Corasick 扫更新后字典,把新词确定映射到 ⟨ℓ_v⟩。运营只做两步增量编辑(字典加词→预留槽、T 里绑目标 item 集),几小时随索引刷新生效,不动策略与码本结构。对照:RQ-VAE 量化码 P1–P3 全不满足,其 IHR@350 仅 0.0025(偶发碰撞)。
实验设置与结果
数据:快手电商搜索 31 天;前 30 天采 500 万带交互请求作训练,第 31 天取 ~3 万 click + ~3 万 order 测试;去重后 query 侧 7.63M、item 侧 20.17M、属性词 1.08M。骨干 BART-base,H800 训练 / L20 服务。
指标:HR@K、MRR@K(K=10/100/350);自造两个干预指标——IHR@K(item 级,目标换成伪造 item)、IAR@K(词级,注入词是否在 top-K 被激活,对标倒排)。
RQ1 召回质量(Table 2,HR@350):
| 方法 | Order HR@350 | Click HR@350 |
|---|---|---|
| DPR(最强传统) | 0.4346 | 0.5027 |
| LC-Rec | 0.3751 | 0.4164 |
| OneSearch(最强生成基线) | 0.5550 | 0.6007 |
| OneRetrieval | 0.5482 | 0.6055 |
深召回与 OneSearch 打平(click 反超),但 MRR@350 远低(0.0880 vs 0.1333)——定位深列表覆盖而非 top 精排。
RQ3 编码范式(Table 5,同 L6 码本):
| 编码 | Order HR@350 | Click HR@350 | total IHR@350 |
|---|---|---|---|
| KAE | 0.5452 | 0.6033 | 0.0806 |
| RQ-VAE | 0.5075 | 0.5516 | 0.0025 |
| RQ-kmeans | 0.5355 | 0.5837 | 0.0030 |
| RQ-OPQ | 0.5376 | 0.5848 | 0.0021 |
KAE 召回最好,且干预命中高一个数量级以上。对比可编辑现任 BM25(Table 6):IAR@350 0.553 vs 0.761(约 3/4),但召回翻倍(HR@350 0.5482 vs 0.2215)。
RQ4 SFT 留一(Table 7,total IHR@350):完整 0.1340;去 S2 → 崩到 0.0030(可编辑性=S2);去 S1 → 召回掉(质量=S1);去 S0 → 0.1020。两目标近似不相交。
RQ5 线上 A/B(Table 8,out-of-mall search,†=p<0.05):
| 配置 | Item CTR | Buyer | Order |
|---|---|---|---|
| 替换倒排分支 | +0.074% | +0.450% | +0.710%† |
| 再替换向量分支(替近乎全部) | +0.821%† | −0.028% | +0.255% |
16/20 行业 CTR 正向(均值 +1.00%),人工 GSB 三轴全胜(relevance +0.82% / quality +1.36% / page good +0.54%)。已部署快手外搜,日数亿 PV。
思考与可参考价值
局限:① 召回精度本身不超 OneSearch(打平),卖点全在可编辑性;② 强依赖 108 万词的生产属性字典 + 抽取 pipeline,无此基建难复用;③ IAR 仍只有倒排 3/4,激活未追平;④「替换全部」时 Order/Buyer 不显著,差临门一脚,窗口仅 11 天单平台;⑤ 干预测试用 LLM 造 2000 词模拟,非真实运营分布;⑥ 骨干仅 BART-base。
对电商/广告/搜索推荐的可借鉴点:
- 「可编辑性」是 SID/生成式召回落地的隐形门槛——做 Semantic ID/生成式检索别只看 Recall,要把「运营能否几小时注入新词/新品/活动词」当一等公民;解法是把可编辑性沉到上游字典 + 预留槽,而非塞进模型,这个解耦极可迁移。
- KAE 用属性词当 SID token,比 RQ-VAE 量化码可读可控,且能规避量化码本(尤其 CID)的热度偏置/结构茧房问题,是另一条编码路线。
- 非层级 + 全局共享码本 + 密度感知非均匀分配 是可直接抄的工业 GR 配置结论(层级化编码反而掉 1.3+ HR 点)。
- Kuaishou 线上系统(OneRec/OneSearch/OneRetrieval 一脉),与字节 OneRec 系直接对标,跟踪价值高。