Large Reasoning Embedding Models: Towards Next-Generation Dense Retrieval Paradigm
USTC (中科大) × Taobao & Tmall Group of Alibaba (淘宝天猫)
把"先推理再编码"塞进稠密检索:对难 query,LREM 先用一个 LLM 生成关键词式 CoT(<think>…</think>),再把 [query;CoT] 编码成 reasoning-augmented embedding 去 ANN 召回,用显式推理弥合 query 与 item 的语义鸿沟。两阶段训练——冷启动 SFT+InfoNCE 学会推理与对齐,再用 GRPO(format/length/检索准确率三路 reward)+InfoNCE 强化推理轨迹。同一个 LREM 兼做 query 侧和 item 侧编码。在淘宝四类难 query 上 HitRate@6000 +5.75%、Precision@100 +3.90%,线上 GSB 全正,2025 年 8 月已上线,延迟 15ms→50ms。
核心思路
电商搜索的稠密检索(dense retrieval)一直是”直接编码”范式:把 query 一次前向过 encoder 拿到一个 embedding,再和预存的 item embedding 算相似度做 ANN 召回。即使 backbone 从 BERT 换成 LLM(RepLLaMA / NV-Embed),本质还是 single forward pass 出 embedding,再靠对比学习(InfoNCE)把人标的正样本对硬拉近。作者指出这条路的根本缺陷:对比学习让模型去拟合训练数据里的统计共现,退化成浅层的词面/语义匹配。一旦 query 和目标 item 字面差异大(“比茶更提神的饮料”应召回咖啡/红牛,而不是各种茶饮),直接编码就崩。
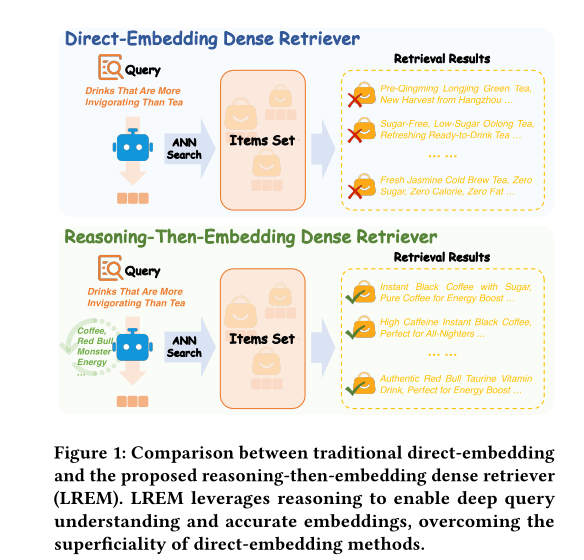
LREM(Large Reasoning Embedding Model)提出一个全新范式 —— reasoning-then-embedding(先推理再编码):
- 对难 query,先让模型显式生成一段 CoT(
c_i = f_gen_θ(q_i)),CoT 是 LLM 对 query 真实购物意图的推理; - 再把原始 query 和 CoT 拼成 reasoning-augmented query
[q_i; c_i],编码成最终 query embedding(q_i = f_emb_θ([q_i;c_i])); - item 侧照旧直接编码
d_j = f_θ(d_j),离线预存; - 召回就是
TopK_{d_j∈D} s(q_i, d_j)。
CoT 在这里充当 语义桥梁:把字面相距很远的 query 和 item 连起来。关键工程取舍是 CoT 必须短(关键词列表而非流畅句子),否则在线自回归生成会引入巨大延迟甚至请求超时。同一个 LREM 同时承担 query 侧(带推理)和 item 侧(不带推理)的编码。
整体实现思路
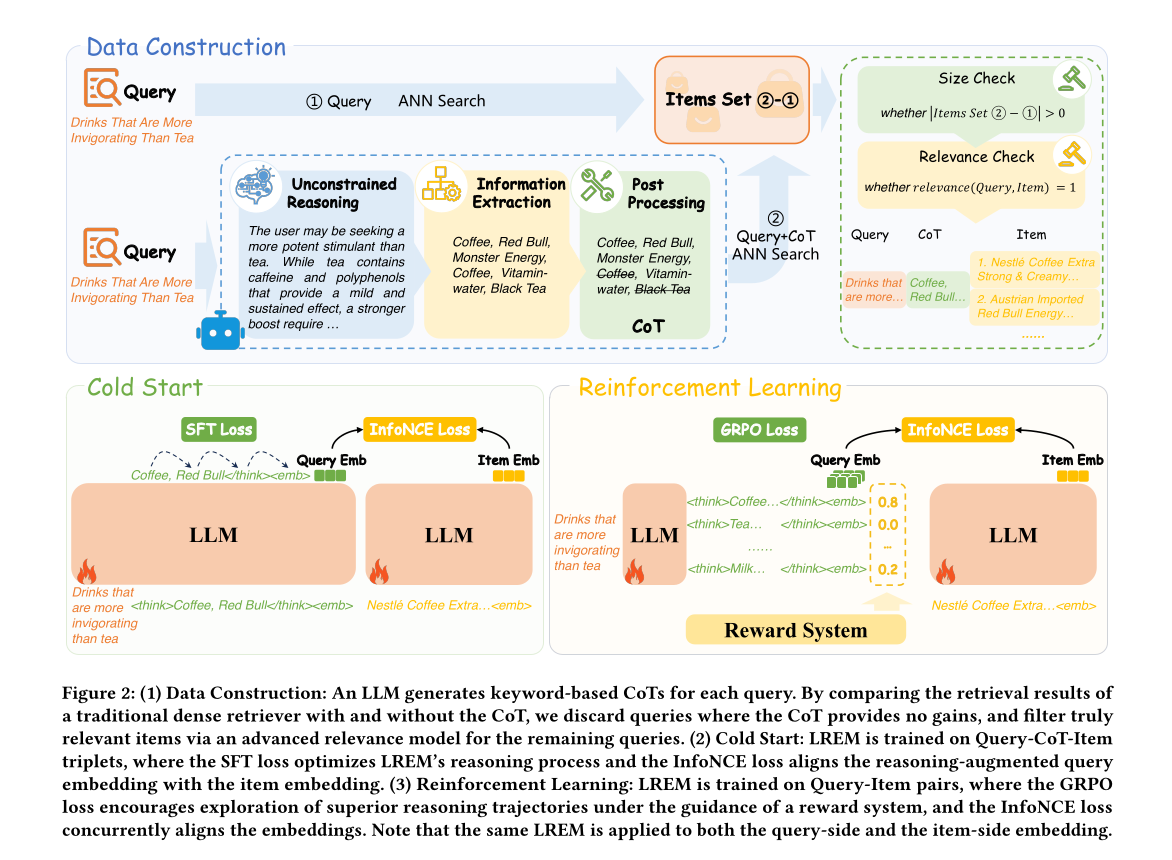
LREM 需要同时具备推理能力和编码能力,作者用三段式管线 + 两阶段训练实现:
- 数据构造(Query-CoT-Item 三元组):从线上日志挑出传统直接编码召回效果差的难 query → 用 Qwen3-30B-A3B-Instruct 生成关键词式 CoT → 用”带 CoT vs 不带 CoT 召回结果做差集”筛掉无增益 query → 用内部 42B MoE 关联性模型 TaoSR1 过滤真正相关的 item。最终得到约 7506 万条 Query-CoT-Item 三元组。
- 冷启动(Cold Start):在三元组上联合 SFT loss(教会模型按
<think>…</think><emb>格式做关键词推理)+ InfoNCE loss(把 reasoning-augmented query embedding 和 item embedding 对齐)。 - 强化学习(RL):冷启动后模型只是模仿 teacher CoT,受限于构造数据质量。用 GRPO 鼓励模型探索更优推理轨迹,reward 由 format / length / 检索准确率三路组成,同时保留 InfoNCE 维持 embedding 对齐。
骨干模型是 Qwen2.5-3B-Instruct(注意:远小于生成数据用的 30B teacher,这是为在线延迟服务的蒸馏),128 卡训练,已于 2025 年 8 月上线中国最大电商平台。
子模块实现(可复现细节)
1. CoT 生成(数据构造第一步)
为什么用 30B teacher 但 CoT 要做成关键词:在线 LREM 是自回归逐 token 生成 CoT 的,流畅自然语言 CoT 太长会导致延迟甚至超时。所以两步生成:
- 无约束推理(Unconstrained Reasoning):先让 30B LLM 对 query 自由推理,不限制输出格式/风格,保留最大推理能力。System prompt 把它设定为”中文电商搜索 query 助手”,user prompt 给出 4 类 query 范例(替代品 substitute / 平替 lookalike / 问答 Q&A / 通用 general),再让它分析目标 query。例如 “La Mer dupe” → 输出一大段分功能(修护/抗老 vs 修护/提亮)的平替推荐。
- 信息抽取(Information Extraction):把原 query + 上一步推理结果再喂回 LLM,抽取与 query 强相关的关键词短语。规则:只输出关键词、去重、若 query 指定品牌则不含其它品牌、问答/平替类抽产品/品牌名或属性。“La Mer dupe” →
Winona, Proya, The Ordinary, SkinCeuticals, Runbaiyan, HBN。 - 规则后处理(Post-Processing):去重、去掉与 query 重叠的词、去掉违禁词,得到紧凑 CoT。
2. Item 过滤(数据构造第二步,确保 CoT 真的有用)
难 query 的正样本很难收。做法是用同一个传统 dense retriever 跑两次:
- 集合① = 只用原始 query 召回的 top-k(大多无关);
- 集合② = 用 [query + CoT] 召回的 top-k(相关比例显著更高);
- 取差集 ②-①:这批 item 是因为加了 CoT 才被召回的,说明 CoT 与它们文本强相关。
- Size Check:
|②-①| > 0?若为 0(加 CoT 对召回无任何影响),直接丢弃该 query; - Relevance Check:对 ②-① 里每个 item 用 TaoSR1(42B MoE,多阶段 RL 训练、带 thinking)判
relevance(query, item)=1,只留相关的。
- Size Check:
附录给出了 ①/② 的完整 query-side 输入模板(②是在 query 后括号拼上 CoT 关键词),以及 TaoSR1 的判定过程(query 意图分析 → item 信息分析 → 类目匹配 → 属性匹配 → 最终相关性分级,例如把 “La Mer dupe” 配 “La Mer 原品” 判为 Partial Mismatch,因为违背 dupe=平替意图)。
最终三元组随机切分:留 400 万 Query-Item 对给 RL 阶段,其余给冷启动。
3. 冷启动(Cold Start)
引入三个特殊 token <think>、</think>、<emb> 进词表,训练模型按 <think> CoT </think><emb> 格式输出。每条 CoT 训练样本截断到最大长度 l(最终 l=16),逼模型在长度限制内高效推理。
- SFT loss(公式 4,标准 next-token prediction):
L_SFT = -1/N · Σ_i Σ_{j=1..l_i} log P(t_j | q_i, t_{<j}) - InfoNCE loss(in-batch 对比,公式 5-7):
- query embedding
q_i = H[-1]_<emb>[LREM(q_i <think>c_i</think><emb>)],取<emb>token 最后一层 hidden state。因 LLM 因果注意力,这个 embedding 已整合 query+CoT 的全部信息; - item embedding
d_i = H[-1]_<emb>[LREM(d_i <emb>)],item 侧在标题后人工拼一个<emb>token; L_InfoNCE = -1/N · Σ_i log[ exp(s(q_i,d_i)/τ) / Σ_j exp(s(q_i,d_j)/τ) ],s为余弦相似度,τ温度系数。
- query embedding
- 总损失(公式 8):
L = λ1·L_SFT + λ2·L_InfoNCE,λ1=0.1, λ2=1。
超参:l=16,per-GPU batch 128,lr 1e-5,cosine scheduler warmup 0.03,全参微调 1 epoch。
附录 Table 9 给出冷启动完整输入模板:query 侧 system prompt 让它”从多角度推理 query 背后购物意图、不要把 query 本身写进推理短语”,assistant 端输出 <think> Winona, Proya, … </think><emb>;item 侧只在标题后接 <emb>。
4. 强化学习(RL,GRPO)
冷启动只是模仿,无法激活模型内在推理。RL 阶段对每个 q_i 采样一组 G=8 条 CoT {c_i^g},由 reward system 从三个维度打分:
- Format Reward(公式 9):CoT 符合
<think>…</think><emb>格式得 1 否则 0(在线只有格式对了才取得到 embedding); - Length Reward(公式 10):CoT 长度 ≤ l 得 1 否则 0(防超长自回归导致超时);
- Retrieval Accuracy Reward(公式 11-12):对 q_i 和采样的 c_i^g 算 query embedding,与当前 batch 内所有 item embedding 算余弦并排序,按 ground-truth item d_i 的排名给 reward:
rank(d_i) = 1 + Σ_{j≠i} I[s(q_i^g,d_j) > s(q_i^g,d_i)],r_accuracy = 1 - log(rank(d_i)) / log(N),排名越高 reward 越大; - 总 reward(公式 13):
r = β1·r_format + β2·r_length + β3·r_accuracy,β1=0.5, β2=0.2, β3=1。
GRPO loss(公式 14):标准 PPO-clip 形式但用 group-normalized advantage A_i = (r_i - mean({r}))/std({r}),无 critic。同时保留 InfoNCE loss(公式 15)把同一 q_i 的 G 条 reasoning-augmented query embedding 都对齐到目标 item embedding。总损失(公式 16)L = γ1·L_GRPO + γ2·L_InfoNCE,γ1=1, γ2=0.1。
超参:G=8,l=16,per-GPU batch 256,lr 1e-6,cosine warmup 0.03,全参更新 1 epoch。
实验设置与结果
数据:Qwen3-30B-A3B-Instruct 造 CoT + TaoSR1 过滤,共 7506 万 Query-CoT-Item 三元组(400 万留给 RL)。测试集聚焦四类极难 query:问答(Q&A)、平替(Alternative)、否定(Negative)、知识密集(Knowledge),共 7209 条 query,候选商品池 7663 万 item。
指标:HitRate@6000(ground-truth item 落入 top6000 的比例)、Precision@100(top100 中被 TaoSR1 判相关的比例)、线上 GSB(人工 side-by-side 好/平/坏对比)。
Baseline(统一 Qwen2.5-3B-Instruct 骨干,在全量 7506 万 Query-Item 对上训 1 epoch):BERT(RetroMAE)、Query-Rewrite(CSA-QR)、Qwen2.5 五种编码变体(Uni-Attn Last/Mean/Latent/Ly4、Bi-Attn Last)。
主结果(Table 1,Overall 列)
| 方法 | HitRate@6000 | Precision@100 |
|---|---|---|
| BERT (RetroMAE) | 24.96 | 51.09 |
| Query-Rewrite (CSA-QR) | 28.24 | 58.37 |
| Qwen2.5 (Uni-Attn. Last) | 32.52 | 65.38 |
| Qwen2.5 (Uni-Attn. Latent) | 32.69 | 65.14 |
| Qwen2.5 (Bi-Attn. Last)(最强 baseline) | 32.89 | 65.66 |
| LREM (Cold Start) | 32.45 | 64.83 |
| LREM (Cold Start+RL) | 34.78 | 68.22 |
相对最强 baseline(Bi-Attn Last):Overall HitRate@6000 +5.75%、Precision@100 +3.90%。其中 Q&A 类提升最大:HitRate +19.20%、Precision +4.19%;Alternative 类 HitRate +5.81%、Precision +9.01%。值得注意:冷启动后的 LREM 还略低于最强 baseline,全部增益来自 RL——RL 单独贡献 Overall HitRate +7.18%、Precision +5.23%。
LREM 为兼顾生成,保留单向注意力(理论上弱于双向 Bi-Attn),但靠显式推理仍反超,说明推理弥补了单向注意力的劣势。
消融:CoT 内容(Table 2)
| 方法 | HitRate@6000 | Precision@100 |
|---|---|---|
| LREM(自生成 CoT) | 34.78 | 68.22 |
LREM (Empty-CoT) <think></think> | 31.59 | 64.25 |
| LREM (Random-CoT) 随机 token | 30.16 | 62.32 |
| LREM (Query-CoT) 重复原 query | 32.54 | 65.63 |
- Empty-CoT 退化成直接编码,HR 掉 9.17%、Precision 掉 5.82%;
- Random-CoT 最差(引入与 query 无关的噪声);
- Query-CoT(只在推理区重复 query)反而比 Empty-CoT 好一点(HR +0.95、Precision +1.38),因为重复 query 让早期 token 也能被”后面的 token”看到,部分缓解了单向注意力前面看不到后面的缺陷——这是个有意思的副产物结论。
消融:CoT 长度(Figure 5 文字)
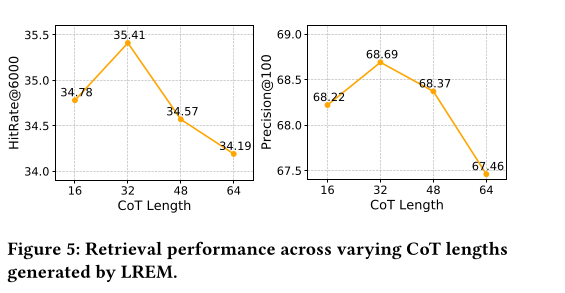
l 从 16→32 提升明显(过短约束伤推理);但 l 增到 48/64 反而下降——LREM 是关键词式推理,过长发散的关键词序列稀释语义精度、分散注意力。最终取 l=16 平衡效果与效率。
线上 A/B(Table 3)
2000 条线上 query(四类),LREM vs 当前最优在线模型 side-by-side 人评:GSB Q&A +7.39%、Alternative +7.27%、Negative +15.7%、Knowledge +4.94%,全正。代价:因在线多了推理生成,平均检索延迟 15ms → 50ms(仍在最大允许延迟内)。
思考与可参考价值
核心 insight(对搜推强相关):把”query 改写/意图理解”这一步从外挂模块(query rewrite + 倒排,多阶段误差累积)内化进 embedding 模型本身,做成一个统一的”先推理再编码”模型,端到端只一个模型、推理结果直接进 embedding,避免改写的信息损失和多级误差累积。这对电商 query understanding 链路是很直接的简化方向。
可借鉴点:
- 关键词式短 CoT 是在线落地的关键工程取舍:自然语言 CoT 太慢,做成 ≤16 token 的关键词列表,既保留推理增益又把延迟控制在 15→50ms。任何”推理增强检索/召回”想上线都要面对这个延迟-效果取舍。
- 检索准确率 reward = 1 - log(rank)/log(N):用 in-batch rank 直接做 RL reward,把”召回正确 item”这个最终目标直接变成可优化信号,不需要额外标注,电商场景里 batch 内负样本天然充足。
- 差集 ②-① 筛数据:用”加 CoT 才召回的 item”自动定位 CoT 真正起作用的样本,是一种低成本、强针对性的难样本/正样本挖掘思路,可迁移到任何”辅助信息是否有用”的数据清洗。
- 同一模型双侧编码 + 三个特殊 token:query 侧带
<think>,item 侧只接<emb>,统一参数,省掉双塔异构。 - 冷启动几乎无增益、全靠 RL:提示纯 SFT 蒸馏 teacher CoT 上限低,RL 探索才是激活内在推理的关键——和当前 reasoning model 的主流认知一致。
局限:
- 论文未给 codeUrl,复现需自建 75M 数据管线 + 内部 TaoSR1 关联性模型,强依赖工业级基础设施(128 卡、内部 42B relevance model、线上 ANN),学术界难直接复现。
- 评测全在自有难 query 测试集 + 内部 TaoSR1 判定,缺公开 benchmark(如 BRIGHT/MTEB)对比,泛化性不明。Precision@100 用 TaoSR1 判定,relevance model 本身的偏差会传导进指标。
- 推理只对”难 query”开,但论文没细说线上如何路由难/易 query(全量都推理 vs 难 query 才推理),简单 query 多花的延迟是否值得未充分讨论。
- CoT 是关键词而非真推理链,l=16 的硬约束让它更像”扩展词/同义词生成”而非深度推理,离真正的 reasoning-intensive retrieval(如多跳)还有距离;本质更接近”端到端可学的 query expansion”。
- item 侧不做推理,长尾/语义模糊 item 的表征仍是直接编码,召回质量瓶颈可能转移到 item 侧。