UniSID: End-to-End Semantic ID Generation for Generative Advertisement Recommendation
Tencent × 武汉大学
把 Semantic ID 构造从 "先学 embedding 再 RQ 量化" 的两阶段范式改造成端到端联合优化:Embedding 与 SID 共同从原始广告数据训练,避免两阶段语义损失与 RQ 的层间误差累积。配合多粒度对比学习 + summary-based 重建,Hit Rate 提升最高 4.62%、Recall 最高 45.46%。
核心思路
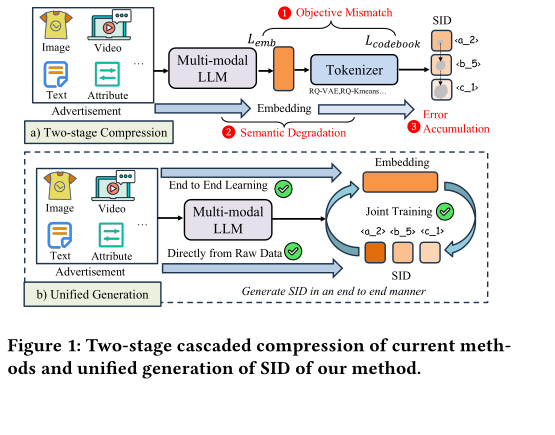
问题一句话:生成式推荐(GR)把 item 量化成离散 Semantic ID(SID)序列后做 next-token 生成,而当前所有主流 SID 的造法都是”先学 embedding,再用 Residual Quantization(RQ)多层量化”的两阶段瀑布——这套范式有三个结构性缺陷:① 目标错配(embedding 阶段优化的是”语义丰富”,SID 阶段优化的是”适合 next-token 预测”,两个目标解耦无法协同);② 语义退化(SID 只能看到 pretrained embedding,看不到原始多模态/属性信号,关键语义被压没了);③ 误差累积(RQ 第 层量化的是前 层的残差 ,前层误差沿残差链逐层放大,深层 SID 越来越不可靠)。
关键 idea:把 SID 生成从”两阶段量化”改成”端到端统一生成”。用一个共享 MLLM 直接吃原始广告的(图 + 文 + 结构化属性 + 任务指令)拼成的 token 序列,在序列尾部挂上可学习的 SID tokens 和 Emb token,让 MLLM 一次性、全上下文并行地预测所有 层 SID(不再走残差链),并联合学一个 item embedding。三个核心设计对应三个缺陷:端到端联合优化破”目标错配”,广告增强输入 schema 破”语义退化”,全上下文并行多层预测破”误差累积”。再叠两个语义保真目标:多粒度对比学习(每层 SID 用粒度相关的正样本集做对比,coarse 抓共性、fine 抓差异)和 summary-based 重建(先用冻结 LLM 把广告属性蒸成 high-level 语义摘要,再用 SID+Emb 把摘要重建出来,逼 SID 编码隐式高阶语义)。
整体实现思路
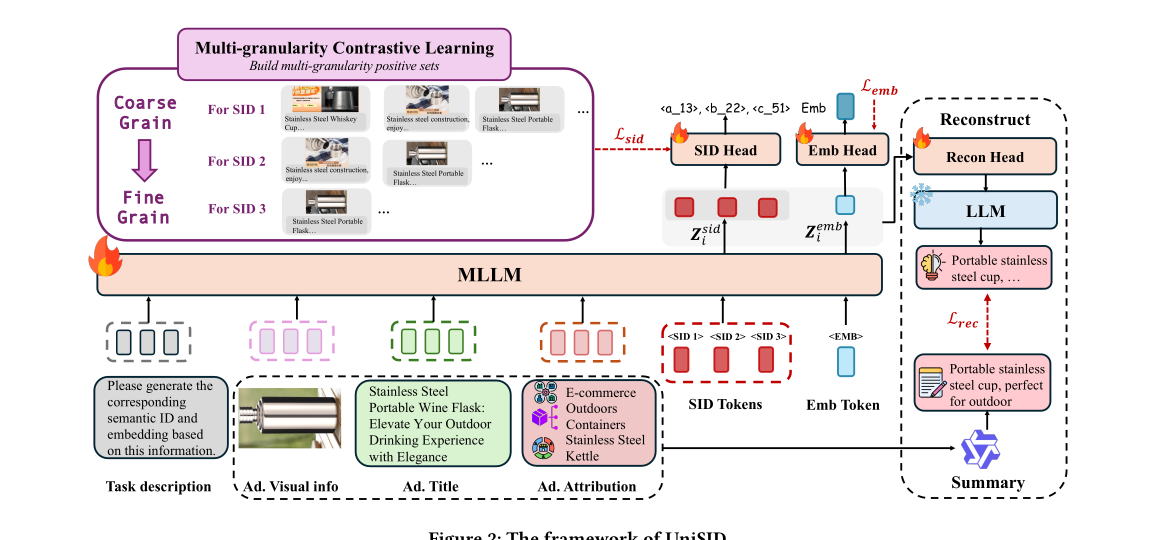
端到端 pipeline(推理/训练共用一个前向):
- 构造广告增强输入序列 :把任务指令 prompt + 图像 token + 文本 token (标题/描述)+ 结构化属性 token (行业 + 多级类目路径)线性化拼接,再在尾部追加 个可学习 SID token 和 1 个 Emb token。
- 共享 MLLM 编码:,得到全序列 contextualized 隐状态。从中抽出 SID token 位置的表示 与 Emb token 位置的表示 。
- 双头投影:SID head 把 投到 SID logits;Emb head 把 投到 item embedding。SID logits 切成 层,每层 argmax 取 token,拼成 SID 序列 。注意 Emb token 排在 SID token 之后,借 next-token 机制天然地 condition 在 SID 序列上,相当于一条隐式 CoT:先 coarse-to-fine SID,再 emb。
- 三个目标联合回传:多粒度 SID 对比损失 + embedding 对比损失 + 摘要重建损失 ,端到端一起更新 MLLM + 三个 head(重建用的 LLM 冻结)。
子模块实现(可复现细节)
1. 广告增强输入 schema(破”语义退化”)
- 输入:异构广告信号。
x_task(指令,如”Given the following advertisement information, please generate the corresponding Semantic IDs and embedding.”)、x_img(视觉 token)、x_text(标题/描述)、x_att(结构化属性)。 - 属性的关键作用:广告图文有歧义(一瓶标”natural”的瓶子可能是饮料/护肤/保健品),结构化属性给出硬语义约束。属性 =
industry(如 general e-commerce)+ 多级类目路径(如 daily necessities → tableware → drinkware → water cup)。 - SID token / Emb token:标准 MLLM 只会生成文本,不会直接产离散 SID。做法是在广告输入后追加 个可学习 SID token,next-token 过程中它们聚合前面所有多模态/属性特征,再由 SID head 映射成离散 SID;Emb token 紧随其后,吃到的是”原始内容 + coarse-to-fine SID”,比孤立 raw data 表示更富。
2. 统一 SID & Embedding 生成(破”误差累积”)
- ;抽 。
- ,,两个 head 都是轻量线性投影。
- 切成 层 logits ;离散化 。
- 与 RQ 的本质区别:RQ 第 层量化的是残差 ,信息逐层稀疏、误差沿链累积;UniSID 的每一层 SID 都从同一份完整广告上下文预测,所有层都拿到完整信息,从结构上切断残差链。
- 超参(附录 A.3): 层,每层 codebook size = 2048。
3. 多粒度对比学习 (破”目标错配”+ 粒度对齐)
核心:不同 SID 层用不同粒度的正样本集——层越深,对正样本要求的语义相似度越高。在第 层给 query item 定义正样本集 (与 在第 层共享语义类目的 item)和候选集 (正 + 负):
其中 为余弦相似度, 为温度。正样本构造(附录 A.1,关键复现细节):以 query “Dough Basin(和面盆)“为例——SID1(coarse)正样本是 Water Ladle / Draining Basin / Wash Basin 等共享高层类目的 item;SID2(中粒度)收紧到 Wash Basin / Stainless Basin;SID3(fine)正样本只剩语义最贴的 Dough Basin 自己。也就是说同一对 item 在 coarse 层是正、在 fine 层可能被判成负,强制粒度区分。
4. Embedding 对比学习
标准 InfoNCE:正样本对 + 负样本集 ,
5. Summary-based Ad Reconstruction (编码隐式高阶语义)
动机:raw 广告即便有多模态 + 属性,也没显式给出”目标人群/卖点/风格”等高阶语义。做法分两步:
- Summary(冻结 LLM 蒸馏):,用行业 + 多级类目,在 prompt 指引下推理出一句高阶语义摘要(prompt 见附录图 5,要求摘要含”广告对象 + 行业 + 一级类目”,并尽量补”目标人群/卖点/促销策略”,但不准描述图片细节/型号/OCR)。这个 summary 是 raw data 里没显式写的。
- Reconstruct(用 SID+Emb 还原 summary):拼接 → 重建头 → 作为冻结 LLM 的条件输入,按 next-token 重建摘要:
逼 SID 把”目标是追求品质/职业形象的男性消费者""舒适、时尚、百搭”这类隐式语义也编码进去(case study 验证)。
6. 联合优化与超参
实现细节(附录 A.3):MLLM backbone = Qwen2.5-VL-3B,ViT 视觉编码器冻结,对 MLLM 做 SFT;重建用的 LLM = Qwen2.5-3B(参数全冻结,只训 recon head);学习率 4e-5,batch size 512;、每层 codebook=2048;(附录 A.2: 太小重建监督不足、太大会干扰对比学习,0.1 最优)。效率上:唯一新增组件是重建 LLM,但它冻结、不进反传,整体训练复杂度与 RQ 类方法相当。
实验设置与结果
数据集(表 1):
| 数据集 | Train | Test | 模态 | 任务 |
|---|---|---|---|---|
| Ad-60W | 500,000 | 100,000 | Text, Image, Ad_att | SID Quality / Ad-Retrieval |
| Ad-100W | 1,000,000 | 1,000,000 | Text, Image, Video, Ad_att | Next-Ad-Pre |
| Beauty(Amazon 公开) | 12,101 | 12,101 | Text, Image | Next-Item-Pre |
Baseline:① SID 构造(RQ 两阶段)—— RQ-VAE、RQ-KMeans;② 多模态 embedding —— GME、LamRA、VLM2Vec2;③ Beauty 上的推荐 —— Bert4Rec / LightGCN / SASRec(DLRM)+ BIGRec / P5-SemID / TIGER / LETTER(GR)。
指标定义:SID 质量用 V-measure(拿最细粒度类目当 ground truth 评 SID 聚类质量,分 3 层评);SID 下游用 next-ad prediction 的 HR@K;embedding 用把广告改写成”1 正 + 999 负”的排序检索任务,评 R@K;Beauty 评 R@K / N@K。
主结果 1:SID 质量 + next-ad(Ad-60W / Ad-100W,表 2)
| 任务 | 指标 | RQ-VAE | RQ-KMeans | UniSID | 相对最强 baseline 提升 |
|---|---|---|---|---|---|
| SID 质量 | layer1 | 0.6769 | 0.6887 | 0.7015 | +1.86% |
| SID 质量 | layer2 | 0.6908 | 0.6918 | 0.7132 | +3.09% |
| SID 质量 | layer3 | 0.6863 | 0.6955 | 0.7045 | +1.29% |
| next-ad | HR@1 | 0.0416 | 0.0434 | 0.0449 | +3.46% |
| next-ad | HR@5 | 0.0735 | 0.0758 | 0.0793 | +4.62% |
| next-ad | HR@10 | 0.1077 | 0.1122 | 0.1167 | +4.01% |
| next-ad | HR@20 | 0.1675 | 0.1754 | 0.1813 | +3.36% |
对 RQ-VAE 的 next-ad 提升更大(HR@1/5/10/20 分别 +7.93%/7.89%/8.36%/8.24%)。
主结果 2:Embedding 检索(Ad-60W,表 3,R@K)
| 模型 | R@1 | R@5 | R@10 | R@20 |
|---|---|---|---|---|
| GME-Qwen2-VL-7B | 0.2545 | 0.3620 | 0.4312 | 0.4830 |
| LamRA-Qwen2.5-VL-7B | 0.3112 | 0.4280 | 0.4745 | 0.5390 |
| VLM2Vec2-Qwen2.5-VL-3B | 0.3238 | 0.4475 | 0.5062 | 0.5597 |
| UniSID-Qwen2.5-VL-3B | 0.4710 | 0.5735 | 0.6102 | 0.6488 |
| 相对最强 baseline 提升 | +45.46% | +28.16% | +20.55% | +15.92% |
注:3B 的 UniSID 超过 7B 的 GME/LamRA,说明收益来自联合建模而非堆参数。R@1 暴涨 45.46% 是论文标题数字。
主结果 3:公开 Beauty(表 4,把 TIGER 的 RQ-VAE 换成 UniSID)
| 模型 | R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|
| SASRec | 0.0380 | 0.0588 | 0.0246 | 0.0313 |
| TIGER | 0.0395 | 0.0610 | 0.0262 | 0.0331 |
| TIGER-LETTER | 0.0431 | 0.0672 | 0.0286 | 0.0364 |
| TIGER-UniSID | 0.0482 | 0.0741 | 0.0323 | 0.0406 |
| 相对最强 baseline 提升 | +11.83% | +10.27% | +12.94% | +11.54% |
只换 SID 模块、其余 TIGER 协议不变,证明增益来自 SID 本身。
消融
- 联合训练 vs 单任务(图 3):单独优化 SID 或 embedding 都比联合训练差,二者互为正则(SID 的层级结构正则化 emb,emb 的语义信号反哺 SID)。
- 对比损失(表 5 上半,SID 质量 L1/L2/L3):Baseline(Qwen2.5-VL + InfoNCE)= 0.5889 / 0.6913 / 0.6966;+KL Loss 反降;+JS=0.6030/…;+BCE≈持平;+MG Loss(本文)= 0.6838 / 0.6978 / 0.6967,尤其 L1 大涨。KL/JS 不能区分粒度、BCE 建模层级能力弱,MG 用”粒度感知正样本”显著拉高。
- 重建(表 5 下半):+Attributions(直接用属性元数据监督重建)→ 0.6999 / 0.7130 / 0.7031,已显著涨;+LLM summary(本文)→ 0.7015 / 0.7132 / 0.7045,再进一步,说明蒸出的隐式高阶语义比原始属性更有用。
- 分析(附录 A.2,图 4):,0.1 三层 V-measure 均最优。
思考与可参考价值
局限:① summary-then-reconstruct 依赖冻结 LLM 的推理能力,摘要质量受底座模型上限制约;② 目前只在广告 + 推荐域验证,对其它 SID-based 生成任务(短视频/跨域)泛化未证;③ 端到端训 3B MLLM + SFT,复现门槛和算力要求高于纯 RQ;④ 并行多层预测虽断了误差累积链,但层间一致性靠 MG Loss 软约束,没有 RQ 那种硬层级结构,可能引入新的层间耦合问题(论文未深入);⑤ 数据/代码声称会开源但尚未释出。
对电商/搜推/Agent 的可借鉴点:
- “SID 是推荐目标导向的可学表示,而非 embedding 的事后产物” 这个观点值得电商 GR 团队重审:与其先训一个通用 item 塔再 RQ 量化,不如让 SID 直接从原始多模态 + 结构化属性端到端学,尤其电商类目体系天然是多级树,正好对上”多粒度对比 + 层级正样本”的设计。
- 结构化属性当硬语义约束:电商场景图文歧义严重(同一张图可能是不同类目),把行业 + 多级类目路径线性化进输入序列、并用它构造层级正样本,是低成本高收益的工程动作。
- summary-then-reconstruct 蒸隐式语义:用冻结大模型把”目标人群/卖点/风格”蒸成摘要再让表示重建,等价于把 LLM 的常识当辅助监督注入 ID 表示——这套对电商冷启 item、Agent 的 item 理解都可直接复用,且因 LLM 冻结、推理期不需要它,开销可控。
- 全上下文并行多层 ID 预测替代残差链,是任何做多层离散 ID(检索/生成/索引)都能借的结构技巧,避免深层 token 不可靠。
- Emb token 排在 SID token 之后形成隐式 CoT(先粗到细 SID 再 emb),对”先生成结构化中间表示再产最终表示”的 Agent/推荐统一建模有启发。