UniRec: Bridging the Expressive Gap between Generative and Discriminative Recommendation via Chain-of-Attribute
Shopee
生成式推荐(GR)一直被诟病「表达力天花板低于判别式精排」:判别模型能直接拿 item 特征做 user×item 交叉打分,GR 却只在压缩后的 Semantic ID 上自回归解码、解码时看不到任何 item 侧信号。本文用贝叶斯定理证明:按判别分 p(y|f,u) 排序等价于按生成后验 p(f|y,u) 排序,后者可沿 item 特征自回归分解——即「带全特征访问的生成模型 = 判别模型」,差距只来自特征覆盖度而非建模范式。由此提出 Chain-of-Attribute(CoA):在 SID 序列前先「speculate」出 category/seller/brand 等粗粒度属性 token,再条件解码 SID,把被 SID 压缩丢掉的 item 侧特征交叉补回生成轨迹,每步条件熵严格下降、beam search 更稳。再加 Capacity-constrained SID(曝光加权残差量化压马太效应)+ CDC(Task-Conditioned BOS 多场景条件 + hash Content Summary 组合特征)+ RFT/DPO 业务对齐。Shopee 离线 HR@50 +22.6%(订单样本 +15.5%),线上 A/B GMV +5.60%、订单 +4.76%、PVCTR +5.37%,端到端 110ms(旧多级链路 266ms)。
核心思路
一句话问题:生成式推荐(GR)把「召回→粗排→精排→重排」多级判别链路统一成在 Semantic ID(SID)上的单模型自回归解码,消除了级间目标不一致、样本选择偏差与误差累积。但它有一个结构性的表达力差距:判别模型估 (p(y\mid f,u)),解码/打分时直接看得到 item 特征向量 (f),能做显式的 user×item 特征交叉;GR 在压缩后的 SID token 上解码,(\prod_l p(s_l\mid s_{<l},u)),承诺一条生成路径时还没见过任何 item 侧信号。叠加推荐天然的 one-to-many(同一用户行为序列可对应多个合理 target),生成不确定性和训练冲突被放大。
本文的回答(两步):
-
理论上差距不是范式问题,是特征覆盖问题。由贝叶斯定理 (p(y\mid f,u)\propto p(f\mid y,u),p(y\mid u)),而 (p(y\mid u)) 与 (f) 无关,所以按判别分排序 ≡ 按生成后验 (p(f\mid y,u)) 排序。再用链式法则 (p(f\mid y,u)=\prod_{k=1}^n p(f_k\mid f_{<k},y,u)),这恰好就是「在 item 特征上做自回归解码」。结论:一个能访问完整 item 特征 (f) 的生成模型,表达力等价于判别模型;实际差距只来自 SID 压缩把 taxonomy/seller/brand 等结构化属性「折叠」进了离散码、解码时变成隐变量。
-
工程上把丢掉的属性补回来就够了 —— Chain-of-Attribute(CoA):在 SID 前先生成 (m) 个粗粒度属性 token (a=[\text{attr}1,\dots,\text{attr}m]),做成 speculate-then-refine:先预测 category/seller/brand,再条件生成 SID。因为同属性的 item 在 SID 语义空间里是相邻聚集的,条件在 (a) 上每一步的条件熵严格下降 (H(s_k\mid s{<k},a)<H(s_k\mid s{<k})),搜索空间收窄、beam search 更稳、端到端解码误差衰减。
与 GRACE(同样在 SID 前 prepend 属性)的区别:GRACE 是经验设计,CoA 给出了第一个信息论刻画——用贝叶斯上界解释「为什么 prefix 属性能缩小 GR 的表达力差距」,并把缩小程度量化为互信息 (I(a;s_l\mid s_{<l},u))。
落地还解决两个问题:Capacity-constrained SID(曝光加权残差量化,压 SID 的「世袭马太效应」)和 CDC(Conditional Decoding Context:Task-Conditioned BOS 注入场景/目标条件 + hash Content Summary 注入组合特征)。最后 RFT + DPO 联合把模型从「拟合曝光分布」对齐到业务目标。
整体实现思路
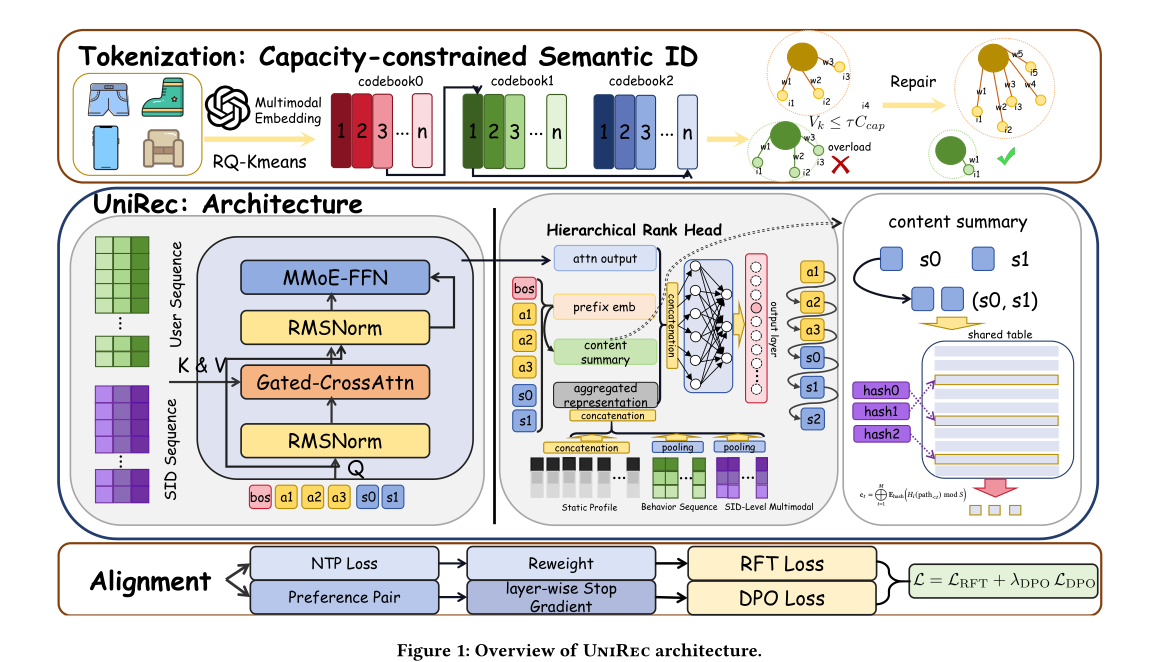
UniRec 把召回与排序融进统一的自回归解码:每个 item = 多层 SID + 前缀属性 token。Decoder-Only backbone,对 user 行为序列做 Cross-Attention(行为序列当 K/V,解码侧「BOS + 属性 + SID」当 Q),每个解码步一个专属 Rank Head 出 token 分布。整条 pipeline:
- 3.2 Capacity-constrained SID:曝光加权的残差量化(RQ-KMeans 改造),保证 codebook 负载均衡,治本马太效应。
- 3.3 CoA:在 SID 前 speculate 出 L2→L3 类目链,条件解码 SID。
- 3.4 CDC:Task-Conditioned BOS(场景×行为目标条件) + Content Summary(Bloom-filter 式 hash 组合特征)。
- 3.5 生成模型:输入建模(静态画像 / 行为序列 / SID 级多模态) + Gated Cross-Attention + 分层 Rank Head + NTP 训练。
- 3.6 对齐:RFT(连续业务价值 reweight NTP) + DPO(离散行为偏好对),联合优化。
完整解码路径长度 = (1+m+L)(1 个 BOS + (m) 个属性 + (L) 层 SID),论文配置 (m=2)(L2、L3 类目)、(L=3)(s0/s1/s2)。
子模块实现(可复现细节)
3.2 Capacity-constrained Semantic ID
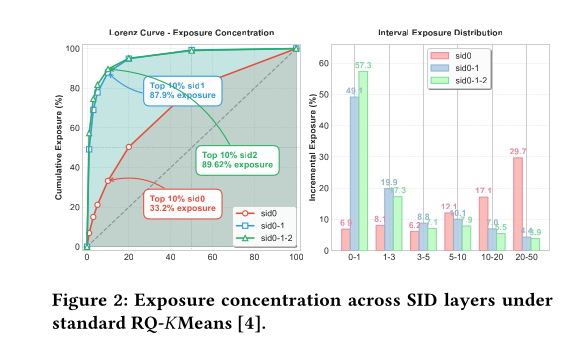
动机(量化的马太效应):用生产流量统计 SID 各层曝光集中度。第一层 (s_0) top-10% token 占 33.24% 曝光(温和倾斜);但 ((s_0,s_1)) 组合 top-10% 占 87.90%,((s_0,s_1,s_2)) top-10% 占 89.62%。从 (s_0) 到 (s_1) 2.6× 放大——轻微 item-count 不均被组合级放大成极端流量集中。标准均衡量化只约束「每簇 item 数」相等,但热门 item 仍霸占其 codebook entry 的曝光。
做法:在残差量化聚类时约束曝光负载而非 item 数。层 (l) 样本 ({x_i}{i=1}^N),每个带曝光权重 (w_i>0)(历史 impression 数),簇 (k) 的曝光负载 (V_k=\sum{i:z_i=k}w_i)。带容量约束的聚类:
[ \min_{{z_i},{\mu_k}}\sum_{i=1}^N\lVert x_i-\mu_{z_i}\rVert_2^2,\quad \text{s.t. } V_k\le \tau C_{cap},\ \forall k ]
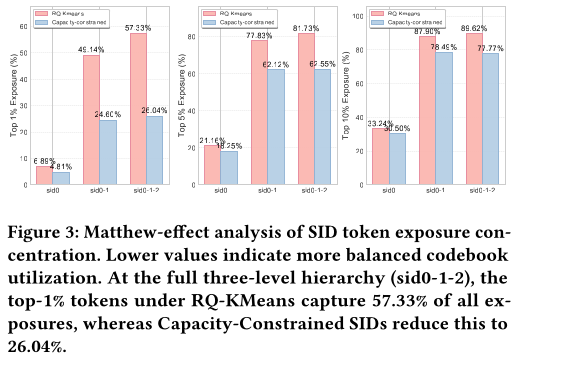
容量参考 (C_{cap}=\frac1K\sum_i w_i)(每簇平均曝光负载),(\tau\ge1) 是容差。这是 NP-hard,用两阶段贪心(Algorithm 1):① 每个样本先分到最近簇心(最小化重构误差);② 修复超载簇——把超出容量的样本重分到「加进去仍不超容量」的最近欠载簇 (\arg\min_{k’:V_{k’}+w_i\le\tau C_{cap}}\lVert r_i-\mu_{k’}\rVert^2),并更新 (V_k,V_{k’});迭代到 (|\Delta J|<\epsilon)。逐层用残差 (r_i=e(x_i)-\sum_{j<l}\mu_{j,s_j(x_i)})。配置 (K=4000)/层、3 层、(\tau=1.05)。效果:sid0-1-2 层 top-1% token 曝光占比从 RQ-KMeans 的 57.33% 降到 26.04%。
3.3 Chain-of-Attribute(CoA)
理论上界(核心论证,见上):贝叶斯 + 链式法则证明带全特征访问的 GR ≡ 判别模型,差距源于 SID 压缩丢失结构化属性。
CoA 因式分解:在 SID 前 prefix (m) 个粗属性 token,
[ p(s\mid u)=p(a\mid u)\cdot\prod_{l=0}^{L-1}p(s_l\mid a,s_{<l},u) ]
强调它是上界的实用近似:不解码全特征向量,只选择性恢复「最被 SID 压缩丢掉的粗粒度属性」,代价是固定 (m) 个额外自回归步的延迟。缩小程度由互信息 (I(a;s_l\mid s_{<l},u)) 度量。
两个可证收益:
- 每步熵下降:(\Delta H_l=H(s_l\mid s_{<l},u)-H(s_l\mid a,s_{<l},u)=I(a;s_l\mid s_{<l},u)\ge0),只要 (a) 与 (s_l) 不条件独立就严格 >0(实际成立,因同类目 item 在 SID 空间相邻、token 序列与粗属性结构相关)。累积 (\sum_l\Delta H_l) 稳定 beam search。
- 级联失败率下降:条件在 (a) 上每层 token 错误率从 (\epsilon_l) 降到 (\epsilon’_l<\epsilon_l),端到端 (P’(\text{error})=1-\prod_l(1-\epsilon’_l)<1-\prod_l(1-\epsilon_l)=P(\text{error}))。
与 Cross-Attention 互补:Cross-Attn 在表征层把 user 偏好编码进 hidden state(“who the user is”);CoA 在解码层每步注入显式 item 侧语义(“what kind of item”)。论文实现取类目层级链 L2→L3作为属性。
3.4 Conditional Decoding Context(CDC)
Task-Conditioned BOS:把固定 BOS 换成可学习 embedding,条件在任务上下文 (c_{task}) ——是「行为目标 × 推荐场景」的笛卡尔积:
[ c_{task}\in{\text{click},\text{purchase},\text{cart},\text{cross-border},\dots}\times{\text{main feed},\text{search},\text{similar items},\text{flash sale},\dots} ]
不改解码架构就让一个统一模型学到不同条件下的不同生成分布,避免「裸共享参数」导致的目标干扰。
Content Summary:层级解码里单个 token embedding 抓不到联合组合语义(同一 SID token 配不同父 token/属性含义不同)。显式建模解码路径上的笛卡尔积交叉,但全量存储 token 对会参数爆炸(如两个 4000 词表层 ≈ 16M entry)。用 Bloom-filter 式 hash 投影:(M) 个 hash 函数共享一张 embedding 表。第 (t) 步:
[ c_t=\bigoplus_{i=1}^M E_{\text{hash}}\big[H_i(\text{path}_{<t})\bmod S\big] ]
(\bigoplus)=拼接,(\text{path}{<t})=step (t) 前已解码 token,(E{\text{hash}}\in\mathbb R^{S\times d_{\text{hash}}}) 共享表,(S=\lfloor(\prod_{i=1}^n V_i)^{2/(n+1)}\rfloor)。配置:(M=3),(H_1(x,y)=x+y)、(H_2=x\cdot y)、(H_3=p_1x+p_2y)((p_1,p_2) 素数),(d_{\text{hash}}=64)。笛卡尔积对包括 (L2,s0)(L2,s1)(L3,s0)(L3,s1)(s0,s1)。参数量 (M\times S\times d_{\text{hash}}) 可控。
3.5 生成模型与训练
输入建模(3 部分):
- 静态画像:(h_{\text{static}}=\text{RMSNorm}([e_{\text{uid}}\oplus e_{\text{ctx}}\oplus\cdots]))。
- 行为序列:每个行为 (h_i=\text{Linear}(\text{RMSNorm}([e_{\text{item}i}\oplus e{\text{shop}i}\oplus e{\text{cate}i}\oplus\cdots]))\in\mathbb R^{d{\text{model}}}),序列 (H_{\text{seq}}\in\mathbb R^{T\times d_{\text{model}}})。
- SID 级多模态:(h_j^{mm}=\text{RMSNorm}(\text{Linear}([e_j^{(0)}\oplus e_j^{(1)}\oplus e_j^{(2)}]))),拼到序列末尾 (H_{\text{seq}}\leftarrow[H_{\text{seq}};H_{mm}]\in\mathbb R^{(T+L_{mm})\times d_{\text{model}}})。
- 聚合 (h_{\text{agg}}=\text{RMSNorm}([h_{\text{static}}\oplus\text{Pool}(H_{\text{seq}})]))。
Cross-Attention 条件化:行为序列当 K=V,解码侧 Q:
[ Q^{(0)}=\text{PosEnc}([e_{\text{BOS}}\oplus e_{\text{attr}}\oplus e_0\oplus e_1\oplus e_2])\in\mathbb R^{(1+m+L)\times d_{\text{model}}} ]
每层 Pre-Norm + 残差,Gated Cross-Attn用可学习门控 (\gamma):(\text{GatedCrossAttn}(Q,K,V)=\gamma\cdot\text{Softmax}(QK^\top/\sqrt{d_{\text{model}}})V)。FFN 用 MMoE-FFN(SwiGLU)。配置:3 层 cross-attn、8 头/层、4 expert、hidden (4d_{\text{model}})。
分层 Rank Head:每步 (t) 独立 head,输入 (x_t=[q_t\oplus e_{\text{prefix}}\oplus c_t\oplus h_{\text{agg}}])(cross-attn 输出 + 前缀 emb + content summary + 聚合表征),过 SENet + MaskNet 出 (p(s_t\mid s_{<t},u,c_{task})=\text{Softmax}(g^{(t)}(x_t)))。输出词表分任务:(t\le m) 是属性域,(t>m) 是 SID 层 (V_{t-m-1})。
NTP loss(teacher forcing,target (s^\star=(a_1^\star,\dots,a_m^\star,s_0^\star,\dots,s_{L-1}^\star))):
[ \mathcal L_{\text{NTP}}=-\sum_{t=1}^{m+L}\alpha_i\cdot\log p_\theta(s_t^\star\mid s_{<t}^\star,u,c_{task}) ]
(\alpha_i) 按 engagement(click/conversion)加权,AdamW 优化。
3.6 业务对齐(RFT + DPO 联合)
联合损失:(\mathcal L=\mathcal L_{\text{RFT}}+\lambda_{\text{DPO}}\mathcal L_{\text{DPO}})。
RFT(Reward-Driven Fine-tuning):复合 reward (R(u_i,x_i)=\mathcal F({\hat y_k}{k=1}^{N{\text{obj}}}))(预测的多目标 engagement 如观看时长、转化率,按业务优先级聚合)。batch 内归一化 advantage:(A_i=R_i-\frac1{|B|}\sum_j R_j),(\hat A_i=A_i/(\sigma_A+\epsilon)),(\tilde A_i=\text{clip}(\hat A_i,-c_{\text{clip}},c_{\text{clip}}))((\sigma_A)=batch RMS)。reweighted 目标:
[ \mathcal L_{\text{RFT}}=-\sum_{i\in B}\sum_{t=1}^{m+L}(1+\lambda\tilde A_i)\cdot\alpha_i\cdot\log p_\theta(s_{i,t}^\star\mid s_{i,<t}^\star,u_i,c_{task}) ]
(\alpha_i) 正比于交互 item 的 GMV;(\tilde A_i>0) 放大高 reward 样本、(<0) 抑制低效模式。
DPO:行为偏好级 (\mathcal R(x)=2)(购买)/(1)(点击)/(0)(仅曝光),同一 request 上下文 (u) 内 (x_i\succ x_j) 构对 (\mathcal D={(u,x_i,x_j)\mid x_i\succ x_j,\ x_i,x_j\in E_u})。标准 DPO 损失,(\beta=0.1),reference (\pi_{\text{ref}})。Layer-wise Stop Gradient:除最后一层 SID 外所有解码步 stop-gradient,只让最后一层梯度流动,保证 DPO 只更新 final-layer Rank Head、不破坏前缀(条件上下文)预测:
[ \log\pi_\theta(y\mid u)=\sum_{t=1}^{L-1}\text{sg}[\log p_\theta(s_t^\star\mid s_{<t}^\star,u)]+\log p_\theta(s_L^\star\mid s_{<L}^\star,u) ]
配置:(d_{\text{model}}=256)、(T=200)、(L_{mm}=100)、lr (3\times10^{-4})、(\lambda_{\text{RFT}}:\lambda_{\text{DPO}}=20:3)。
实验设置与结果
数据:Shopee 主 feed 场景生产日志,连续 9 天,数十亿交互(曝光/点击/加购/购买),模型 0.05B 参数。
指标:Token Hit Ratio@3(teacher-forcing 下 ground-truth token 进 top-3 的比例,逐解码步);BS Hit Ratio@K(beam search 后 target item 进 top-K,(K\in{50,100,200})),并单独报订单(购买)样本子集。
Baseline:SASRec(判别式序列召回,用学到的表征做 SID 近邻检索)、TIGER(Encoder-Decoder GR)、OneRec-V2(Decoder-Only + cross-attn GR)。
主结果(Table 1,HR)
| Method | 全样本 HR@50 | @100 | @200 | 订单 HR@50 | @100 | @200 |
|---|---|---|---|---|---|---|
| SASRec | 0.421 | 0.489 | 0.556 | 0.548 | 0.631 | 0.709 |
| TIGER (0.05B) | 0.437 | 0.508 | 0.578 | 0.567 | 0.652 | 0.731 |
| OneRec-V2 (0.05B) | 0.438 | 0.523 | 0.587 | 0.582 | 0.671 | 0.752 |
| UniRec (0.05B) | 0.537 | 0.618 | 0.688 | 0.672 | 0.774 | 0.867 |
全样本 vs 最强 GR baseline OneRec-V2:HR@50 +9.9pt(+22.6% 相对)、@100 +9.5pt(+18.2%)、@200 +10.1pt(+17.2%);订单样本提升更大:+9.0/+10.3/+11.5pt(@200 即 +15.5% 相对)。
CoA 属性链消融(Table 2)
| 属性链 | L2@3 | L3@3 | s0@3 | s1@3 | s2@3 | HR@50 | @100 | @200 |
|---|---|---|---|---|---|---|---|---|
| Direct SID(无属性) | — | — | 0.314 | 0.752 | 0.952 | 0.458 | 0.532 | 0.595 |
| L1→SID | — | — | 0.488 | 0.776 | 0.961 | 0.471 | 0.569 | 0.622 |
| L2→SID | 0.755 | — | 0.591 | 0.789 | 0.963 | 0.515 | 0.597 | 0.664 |
| L3→SID | — | 0.694 | 0.654 | 0.801 | 0.967 | 0.517 | 0.601 | 0.670 |
| L2→L3→SID | 0.757 | 0.962 | 0.682 | 0.821 | 0.971 | 0.537 | 0.618 | 0.688 |
关键观察:加任何属性前缀都显著抬高 s0@3(0.314→最高 0.682),印证「属性条件降低首层 SID 解码熵」;属性链越细/越长越好,L2→L3 两级类目最佳。
其余消融(Table 3 / 4,Full Model HR@50/100/200 = 0.537/0.618/0.688)
| 配置 | HR@50 | @100 | @200 |
|---|---|---|---|
| (a) SID:RQ-KMeans(去掉容量约束) | 0.481 | 0.558 | 0.627 |
| (b) w/o Task-Cond. BOS | 0.493 | 0.570 | 0.638 |
| (b) w/o Content Summary | 0.485 | 0.565 | 0.637 |
| (c) scaling (d_{\text{model}}=64) | 0.397 | 0.459 | 0.514 |
| (c) (d_{\text{model}}=128) | 0.477 | 0.551 | 0.615 |
| (c) (d_{\text{model}}=256)† | 0.537 | 0.618 | 0.688 |
| (c) (d_{\text{model}}=512) | 0.557 | 0.639 | 0.712 |
- Capacity-constrained SID:去掉后 HR@50 0.537→0.481;top-1% token 曝光占比从 26.04% 恶化到 57.33%。
- Task-Cond. BOS / Content Summary:去掉分别 HR@100 相对 -7.8% / -8.6%,二者解决正交问题。
- Scaling:(d_{\text{model}}) 64→512 单调提升,仍有放大空间。
多场景 Task-Cond. BOS(Table 4):单场景独立模型 HR@50/100/200=0.386/0.470/0.540 → 多场景联合训练 0.395/0.486/0.570(跨场景知识迁移 +0.9/+1.6/+3.0pt) → 多场景 + Task-Cond. BOS 0.400/0.510/0.590(再一致提升,说明场景条件化必要)。
线上 A/B(Table 5)
20% 流量/桶,control = 旧判别式多级链路。
| 指标 | Overall | Feed | Landing |
|---|---|---|---|
| Total Orders | +4.76% | +4.27% | +5.78% |
| GMV | +5.60% | +5.42% | +6.19% |
| Page-view CTR | +5.37% | +5.37% | — |
延迟:UniRec 端到端 110ms(约等于单个排序模型),旧多级 pipeline 266ms —— 端到端化省一半延迟。engagement/PVCTR 相对增益 > 转化增益,说明内容相关性与满意度提升更明显。
思考与可参考价值
核心洞见的价值:把 GR vs 判别式的「表达力差距」从玄学拍回到一个可操作的命题——差距 = 特征覆盖度。贝叶斯等价 (p(y\mid f,u)\Leftrightarrow p(f\mid y,u)) 这个论证很干净,给「GR 该不该、该怎么补 item 侧特征」提供了第一性原理依据,而不是堆 trick。CoA 的「speculate-then-refine(先属性后 SID)」是个通用范式:任何 SID 类生成式召回/排序,都可以在 SID 前 prefix 一段判别力强、词表小的结构化属性,用每步熵下降换 beam search 稳定性。
对电商/搜推可直接借鉴:
- Capacity-constrained SID 解决了一个 GR 落地真痛点——SID 组合级马太效应(top-10% 组合吃 87.9% 曝光)。把均衡量化的约束从「item 数」换成「曝光负载 (w_i)」+ 两阶段贪心修复超载簇,是低成本可复用的工程改造,直接改善长尾 codebook 利用率。
- Task-Conditioned BOS = 用「行为目标 × 场景」的笛卡尔积条件化 BOS,一个统一模型服多场景多目标而不互相打架,比训 N 个模型省,且有跨场景迁移红利。中国出海多市场(domestic vs cross-border)场景特别契合。
- Content Summary 的 Bloom-filter hash 共享表:显式组合特征又不参数爆炸(避开 4000²≈16M),(S=\lfloor(\prod V_i)^{2/(n+1)}\rfloor) 这个 sizing 公式 + 多 hash 函数(加/乘/素数线性组合)可直接搬到任何需要笛卡尔积交叉的离散特征场景。
- RFT + DPO 联合 + layer-wise stop gradient:RFT 走连续业务价值(GMV)reweight、DPO 走离散行为偏好对(购买>点击>曝光,从线上流量自动构对、无需人工标注),(20:3) 权重;stop-gradient 只让最后一层 SID 受 DPO 更新、冻结前缀,避免偏好对齐破坏条件上下文——这个细节对「多步自回归 + DPO」很关键。
- 端到端 110ms vs 266ms:GR 统一链路的延迟优势是真金白银的部署论据。
局限 / 待观察:
- 实验全在 Shopee 私有数据(数十亿交互),无公开数据集复现,也无开源代码,外部很难复刻具体数字。
- 模型规模只到 0.05B、(d_{\text{model}}\le512),scaling 表明还没到饱和,但工业大规模(如 OneRec 的 B 级)下 CoA 收益是否保持未知。
- CoA 的理论上界依赖「属性与 SID 强相关」,对属性体系稀疏/噪声大的品类(如长尾白牌、缺类目标注 item)熵下降可能很弱,论文未给反例分析。
- 属性链固定取 L2→L3 类目,seller/brand 虽在动机里提及但主实验未单独消融其增益;(m) 个额外解码步的延迟-收益权衡也只给了固定配置。
- DPO 的偏好仅 3 级(购买/点击/曝光),对更细粒度业务价值(如不同 GMV 档)的偏好建模留白,RFT 的连续 reward 与 DPO 的离散偏好之间是否冗余/冲突未深入分析。