UniGRec: Unified Generative Recommendation with Soft Identifiers for End-to-End Optimization
USTC × NUS × CUHK × Upwork
用「软标识符」(对码本的连续概率分布) 替代 RQ-VAE 的离散 one-hot 码字, 打通一条可微路径, 让最终推荐损失同时反传监督 tokenizer 与 recommender, 实现真正端到端联合训练。再用温度退火对齐训练/推理、码字均匀性正则防码本坍缩、双路协同蒸馏补回粗粒度协同信号, 三剂量解决软标识符带来的三个副作用。
核心思路
生成式推荐 (TIGER 范式) 由两个部件组成: tokenizer 把每个 item 量化成一串离散码字 (Semantic ID), recommender (T5 编码器-解码器) 在这些 token 上自回归预测下一个 item。问题在于二者的优化是「断开」的:
- Staged (分阶段): 先把 tokenizer 训好冻住, 再训 recommender。tokenizer 完全感知不到下游推荐目标, 标识符僵化。
- Alternating (交替): 加辅助 loss、按 epoch 交替更新两个模块 (如 ETEG-Rec), 但没有一个统一的高层目标, 两模块仍是异步更新, 无法真正对齐。
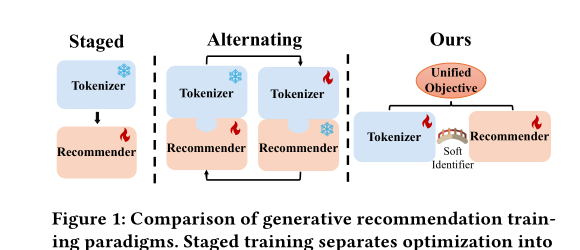
UniGRec 的关键 belief: 最终的推荐损失 L_Rec 本身就应该是 tokenizer 和 recommender 共同的统一目标。障碍是 RQ-VAE 的码字选择用 argmin (硬量化), 不可微, 梯度无法从推荐损失反传到 tokenizer。
解法是 软标识符 (soft identifier): 不再选一个最近码字, 而是把每个 item 表示成「对整个码本的概率分布」(对码字距离做温度 softmax)。这条连续路径可微, 于是推荐损失能直接反传监督 tokenizer, 两模块在单一目标下联合端到端训练。
但软标识符引入三个副作用, UniGRec 对应三个组件各破一个:
- 训练-推理差异 (Training–Inference Discrepancy): 训练用软分布, 推理必须用确定性硬 ID, soft→hard 失配导致掉点 → Annealed Inference Alignment (温度退火)。
- 标识符坍缩 (Item Identifier Collapse): 软标识符让每个 item 在梯度上与整个码本交互, 优化倾向集中到少数主导码字, 码字使用严重失衡 → Codeword Uniformity Regularization (码字均匀性正则)。
- 协同信号不足 (Collaborative Signal Deficiency): 软标识符过度强调细粒度 token 级语义, 弱化了粗粒度 item 级协同信号 → Dual Collaborative Distillation (双路协同蒸馏)。
整体实现思路
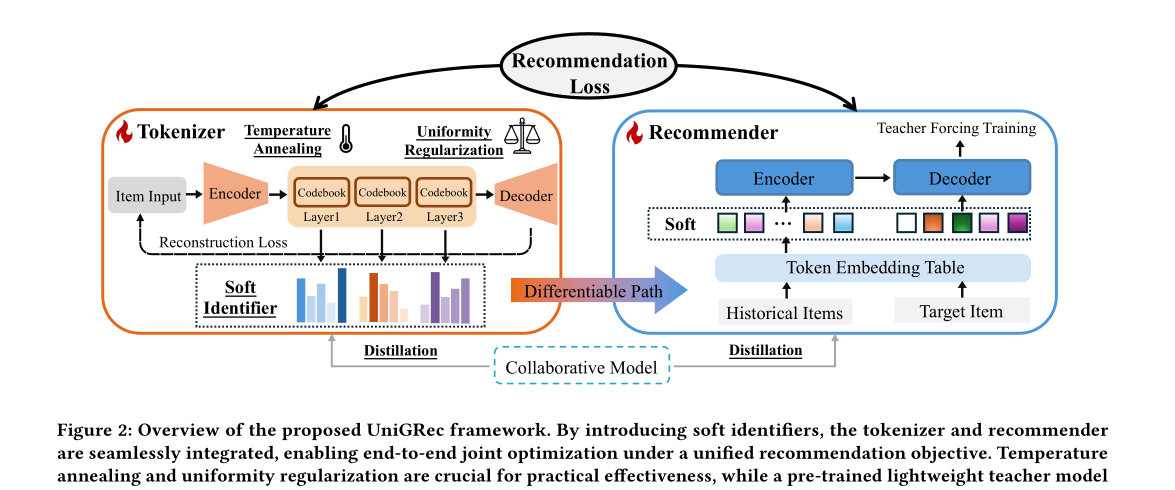
整条链路 (输入 item 语义 embedding → tokenizer → 软标识符 → recommender → 推荐损失) 全程可微, 两阶段训练:
- Stage 1 (Tokenizer 预训练): 只更新 tokenizer, 目标
L_Pre = L_Recon + λ_CU · L_CU。注意不含量化项L_Quant(软标识符下重构损失本身就能可微地更新码本, 不需要 stop-gradient 的量化对齐项)。目的是先建立语义丰富且码字均衡的码本, 否则直接联合训练会码字大量碰撞。温度 τ 在此阶段从 τ_max 线性退火到 τ_min。 - Stage 2 (端到端联合训练): 固定 τ = τ_min, 联合更新 tokenizer T 和 recommender R, 目标
L_Joint = L_Rec + λ_Recon·L_Recon + λ_T_CD·L^T_CD + λ_R_CD·L^R_CD。此阶段去掉L_CU(预训练后分布已足够 sharp, 不再需要正则)。
backbone: recommender = T5 (encoder-decoder); tokenizer = RQ-VAE, 3 层码本, 每层 256 个码字、维度 32, encoder 维度 {512,256,128,64}; 协同 teacher = 预训练好的 SASRec。
子模块实现 (可复现细节)
1. 软标识符 (Soft Identifier)
RQ-VAE 原本逐层取最近码字 (式3 c_l = argmin_k ‖v_l − e^k_l‖²), 残差更新 v_l = v_{l−1} − e^{c_{l−1}}_{l−1}。UniGRec 把硬选择换成温度 softmax 概率:
p_l(k) = exp(−‖r_{l−1} − e^k_l‖² / τ) / Σ_j exp(−‖r_{l−1} − e^j_l‖² / τ), k = 1..K
其中负平方距离当 logits, τ 控制锐度。这样离散码字选择 → 码字的概率加权聚合, 既保留更丰富语义又全程可微, 推荐目标可直接监督 tokenizer。
喂进 recommender 的方式: 软分布只在 K=256 个码字上, 远小于 recommender 的完整 token 词表 |V|。做法是 scatter + 概率加权 embedding 聚合 替代标准 lookup:
o^t_l = scatter(0, {p_l(k)}_{k=1}^K) · O
即把 K 维概率散射到完整词表对应位置形成稀疏 |V| 向量, 乘 token embedding 表 O ∈ ℝ^{|V|×D}。当 p_l(·) 退化为 one-hot 时, 此式恰好还原成标准 embedding lookup, 同时对 tokenizer 参数全程可微。
2. Annealed Inference Alignment (温度退火, 破训练-推理差异)
线性退火 τ:
τ(step) = τ_max − (step / total_step) · (τ_max − τ_min)
τ 越小, 软分布越尖, 概率质量集中到最近码字, 软加权 embedding 逐渐收敛到硬分配的确定性 embedding。早期 τ 大 → 允许梯度流动和语义探索; 后期 τ 小 → 行为对齐推理时的硬 ID。实验里 τ_max ∈ {0.01, 0.05} 退火到 τ_min = 0.001。
消融洞察 (Fig 3): Fixed-High (τ=0.01) 码本碰撞率始终居高; Fixed-Low (τ=0.001) 碰撞低但缺探索; 退火策略前期像 Fixed-High (探索), 后期降到 比 Fixed-Low 还低 —— 兼得探索与低碰撞。
3. Codeword Uniformity Regularization (码字均匀性正则, 破坍缩)
对 batch 平均的码字分配概率施加多样性 loss (负熵), 等价于最小化 batch 平均分布与均匀分布的 KL:
L_CU = Σ_{l=1}^L Σ_{k=1}^K p̄_l(k) · log p̄_l(k)
p̄_l(k) 是第 l 层第 k 码字在 batch 内的平均分配概率。最小化 = 最大化熵 → 鼓励码字均衡使用。
消融 (Fig 4): λ_CU 从 0 增到 1e-4, 碰撞率显著下降、性能达峰; 超过 1e-2 后过度正则反而破坏语义重构, 碰撞反弹、性能跌。Stage 1 用 λ_CU = 1e-4。
4. Dual Collaborative Distillation (双路协同蒸馏, 破协同信号不足)
用预训练 SASRec 当 teacher, 把它的 ID embedding 里的协同先验从两侧蒸馏进来:
Tokenizer 侧 (注入码本空间) — 取 recommender encoder 对历史序列的表征 h_Enc (对 H_Enc 平均池化), 与 teacher 对目标 item 的 embedding h_Tea, 各过一个线性层投到 tokenizer 输入维度, 喂进 tokenizer 得到两套码字分配分布 P^Enc_l, P^Tea_l, 用对称 KL 对齐:
L^T_CD = Σ_l [ D_KL(P^Enc_l ‖ P^Tea_l) + D_KL(P^Tea_l ‖ P^Enc_l) ]
Recommender 侧 (注入 item embedding 空间) — 取 decoder 对目标 item 的表征 h^Dec_i (对 H_Dec 取首 token 池化), 投到 teacher 维度, 与 teacher embedding h^Tea_i 做 in-batch 双向 InfoNCE (cosine 相似度, τ′=0.07):
L^R_CD = L_InfoNCE({h^Dec_i}, {h^Tea_i}) + L_InfoNCE({h^Tea_i}, {h^Dec_i})
实验设置与结果
数据集: Amazon Beauty / Pet (公开) + Upwork (自家自由职业平台私有数据, 雇主=user、自由职业者=item, 雇佣事件=交互)。5-core 过滤, 历史截断/补齐到 20, leave-one-out 划分。
| Dataset | #User | #Item | #Interaction | Sparsity | AvgLen |
|---|---|---|---|---|---|
| Beauty | 22362 | 12083 | 198313 | 99.93% | 8.87 |
| Pet | 19855 | 8498 | 157747 | 99.91% | 7.95 |
| Upwork | 15542 | 33508 | 139217 | 99.97% | 8.96 |
Baseline: 传统 (Caser / GRU4Rec / SASRec / BERT4Rec / HGN) + 生成式 (TIGER / LETTER / EAGER / OneRec / ETEG-Rec / DiscRec-T)。指标 Recall@K、NDCG@K (K=5,10), 全量排序 (非负采样), 生成式方法用 constrained beam search (beam=30)。
关键实现超参: 初始 item embedding 用 sentence-t5-base 抽 (Beauty/Pet, 768→384 维), Upwork 直接用线上模型 embedding。Stage1: bs=1024, lr=1e-3。Stage2: AdamW (weight decay 0.05), bs=512, T5 backbone lr ∈ {2e-3,5e-3,8e-3}, 可微 tokenizer lr ∈ {2e-7,2e-8} (注意 tokenizer 学习率极小), λ_Recon=0.5, λ_T_CD/λ_R_CD ∈ {0.01,0.05,0.1,0.5,1.0}。
主结果 (RQ1): UniGRec 在三数据集全部指标第一, ETEG-Rec 第二。摘录:
| Dataset | Metric | SASRec | TIGER | ETEG-Rec | UniGRec |
|---|---|---|---|---|---|
| Beauty | Recall@10 | 0.0550 | 0.0617 | 0.0809 | 0.0825 |
| Beauty | NDCG@10 | 0.0244 | 0.0346 | 0.0448 | 0.0457 |
| Pet | Recall@10 | 0.0425 | 0.0563 | 0.0693 | 0.0701 |
| Pet | NDCG@10 | 0.0202 | 0.0305 | 0.0370 | 0.0389 |
| Upwork | Recall@10 | 0.0872 | 0.0701 | 0.0913 | 0.0967 |
| Upwork | NDCG@10 | 0.0432 | 0.0364 | 0.0461 | 0.0499 |
(Upwork 上 SASRec 这个强协同基线 Recall@10=0.0872 反超 TIGER 0.0701, 印证「协同信号」在该业务的重要性, 也解释了为何 UniGRec 要专门蒸协同。)
消融 (RQ2, Beauty, 从 TIGER 逐步加模块):
| Method | Recall@5 | Recall@10 | NDCG@5 | NDCG@10 |
|---|---|---|---|---|
| M0: TIGER | 0.0432 | 0.0617 | 0.0281 | 0.0346 |
| M1: +Soft Identifier | 0.0464 | 0.0697 | 0.0310 | 0.0385 |
| M2: +Joint Training | 0.0489 | 0.0742 | 0.0333 | 0.0410 |
| M3: +L_CU | 0.0503 | 0.0746 | 0.0337 | 0.0415 |
| M4: M3+L^T_CD | 0.0509 | 0.0760 | 0.0345 | 0.0425 |
| M5: M3+L^R_CD | 0.0540 | 0.0810 | 0.0366 | 0.0453 |
| M6: UniGRec (Full) | 0.0548 | 0.0825 | 0.0368 | 0.0457 |
读法: 软标识符 (M0→M1) 和联合训练 (M1→M2) 各贡献一档; 均匀性正则 (M2→M3) 小幅提升; recommender 侧协同蒸馏 L^R_CD (M3→M5) 是单项最大增益 (Recall@10 0.0746→0.0810), tokenizer 侧 L^T_CD 增益较小, 两者叠加得最优。
深度分析 (RQ4):
- 码本分析 (Fig 5): UniGRec 码字 embedding 的 PCA 分布更弥散/各向同性, 占满隐空间; 码字使用熵显著更高 (Layer1: TIGER 4.77 → UniGRec 7.91; Layer2 7.64→7.81; Layer3 7.50→7.89), 即更均匀、几乎不坍缩。
- 标识符演化分析 (Fig 6): 联合训练后码字改变率随层加深递减 (L1 22.6% / L2 14.9% / L3 11.3%), 符合残差量化「由粗到细」原则; 超过 93% 的 item 至多改一层或不变 —— 说明端到端联合训练是「推荐感知的微调」而非破坏性重训。性能增益来自两点: 硬→软标识符的转变, 以及推荐感知的标识符精修。
思考与可参考价值
这篇解决的真问题: 生成式推荐里 tokenizer 与 recommender 的「目标错位」是公认痛点 —— 静态 Semantic ID 与下游推荐目标无关。UniGRec 给出一个干净的可微桥 (软标识符 + scatter 加权 embedding), 让推荐损失成为唯一统一目标, 比 ETEG-Rec 的交替更新更彻底。
对电商/搜推可借鉴点:
- 软标识符 + scatter 加权 embedding 是一个通用 trick: 任何「离散 ID 查表」环节想做可微联合训练, 都可以把 argmin 换成温度 softmax, 再 scatter 回完整词表加权聚合, 退化时无损还原 lookup。可迁到检索侧 Semantic ID、用户聚类 ID 等。
- 温度退火对齐 soft 训练 / hard 推理 是落地关键。软训练涨点但线上必须出确定性 ID, 退火让训练末态≈推理态, 是这条路能用的前提 —— 任何 STE/Gumbel/soft-quant 上线都该考虑。
- 码字均匀性正则 + 预训练阶段 是防 Semantic ID 坍缩的实用配方; 用使用熵 (Fig 5) 监控码本健康度值得抄进生产监控。
- 双路协同蒸馏: item 级协同信号 (SASRec ID embedding) 与细粒度语义互补。在协同强的业务 (如 Upwork, SASRec 反超 TIGER) 尤其重要; recommender 侧 InfoNCE 蒸馏增益最大, 是性价比最高的一项。
局限:
- 依赖一个预训练好的协同 teacher (SASRec) 且需两个蒸馏损失, 链路偏重, 作者自己也把「更轻量地融协同」列为 future work。
- 实验规模偏学术 (万级 user/item, T5 backbone), 未在大规模工业数据上验证可扩展性 (作者明确把这列为 future work), 软标识符的 scatter 到完整 |V| 词表在超大 corpus 下的显存/速度代价存疑。
- tokenizer 学习率极小 (2e-7~2e-8) 暗示联合训练对 tokenizer 是「轻微微调」, 若 base tokenizer 质量差, 端到端能纠偏的空间有限 —— 这也和「93% item 至多改一层」的观察一致, 即增益主要来自 soft 化而非大幅重排码本。
- 协同蒸馏的 teacher 把推荐能力上限部分锁定在 SASRec 量级, teacher 弱则蒸馏天花板低。