TokenMinds: Pretrained User Tokens and Embeddings for User Understanding in Large Recommender Systems
Google DeepMind × YouTube
把 Semantic ID 从「物品侧」扩到「用户侧」。用一个 encoder-decoder(从预训练 LLM/Gemini 适配而来)同时产出两种用户表示——decoder 自回归生成离散的「SID-based 用户 token」(语义锚定、可解释、抗词表漂移),encoder 池化出传统「稠密用户 embedding」(兼容现有下游)。关键认知:离散 token 与稠密 embedding 捕捉互补信号,二者同时喂下游收益叠加;且共享 SID 词表天然支持长短视频跨场景统一建模(multi-context decoding 一次 encoder 前向解多场景),在 YouTube 十亿用户全量上线。
核心思路
一句话问题:工业推荐里”用户表示”几乎都是稠密 embedding(把用户全部兴趣压进一个定长向量),受限于固定维度、丢失细粒度信号;而用 LLM 生成”文本用户画像”又只抓到话题共现、抓不到序列行为动态、且和非文本下游有模态鸿沟。物品侧的 Semantic ID(SID) 已被证明能提升泛化(TIGER/PLUM),但用户侧的离散 SID 表示几乎没人做。
关键 idea:把 SID 范式从物品搬到用户。用一个 encoder-decoder 同时吐出两种用户表示——
- decoder 自回归生成离散的 SID-based 用户 token(语义锚定到物品 SID 词表、可解释、抗词表漂移);
- encoder 池化出稠密用户 embedding(无缝兼容现有依赖 dense 向量的下游)。
这是”dual-output(稀疏 token + 稠密 embedding)用户表示”范式——论文证明二者互补(一起用收益叠加),且共享 SID 词表顺手解决了长/短视频跨场景统一建模。
整体实现思路
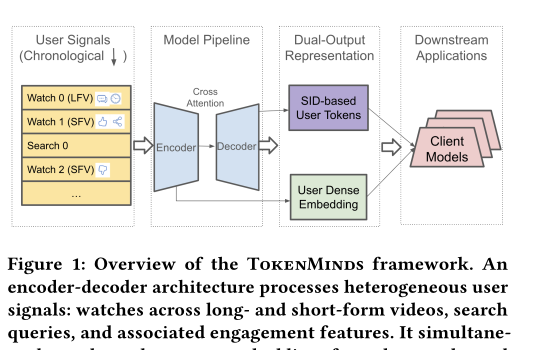
输入:用户时序行为(长短视频观看 + 搜索 query + 互动特征如时长/点赞/设备)
  → 每个 watch 用「物品 SID 前缀」+ 非SID特征 token 化
  → encoder-decoder (从 Gemini V1.5 CPT 检查点初始化)
        ├─ encoder:池化 → 1152 维稠密用户 embedding
        └─ decoder:beam search → B 条 SID 序列(截到 prefix-L) = 离散用户 token
  → 异步生成 + KV 缓存 → 下游 ranking 模型按需取用
两条关键设计线:(1) 表示学习与下游目标解耦(产出”通用”用户理解,不绑定某个下游 loss,区别于 GPR 那种对齐下游 metric 的做法);(2) 重表示生成与实时打分解耦(靠异步 UBS 服务 + 缓存,让十亿用户可负担)。骨干不用 decoder-only 而用 encoder-decoder:encoder 更全面捕捉全历史序列模式、且能自然池化出 dense embedding;encoder/decoder 还能解耦部署(重 encoder 低频刷、轻 decoder 高频刷)。
子模块实现(可复现细节)
模块 A — 用户输入的 token 化(SID 前缀 + 软/硬特征)
视频表示:每个观看的视频不用随机 VID,而用 RQ-VAE 生成的层次化 SID(L_full=8 级码本),但只保留 prefix-L 码(L=4)——利用 SID 层次性,用更粗粒度表示视频,鼓励多样性、抑制记忆化(消融证明截断很关键)。
每个 watch token 化 = condition token(场景 <LFV>/<SFV>)+ prefix-L=4 个 SID 硬 token + M=1 个软 token(非 SID 特征):
- 硬 token:把稠密特征分桶、或类别/文本特征映射到词表。
- 软 token:每个特征独立 embedding → 拼接 → MLP 投影到 M 个 embedding。论文用
M=1(牺牲约 5% 离线 recall 换大幅缩短序列)。
输入序列示例:A12 B278 C23 D77 | 100.0s 20% IOS | …(前 4 个是某视频 SID 前缀,后面是时长/完播率/设备等特征)。每用户取最近 1,200 个观看 + S=10 条搜索 query 交织,最大序列长 1,024 token。
模块 B — 双输出训练(look-ahead 多目标 + 奖励加权)
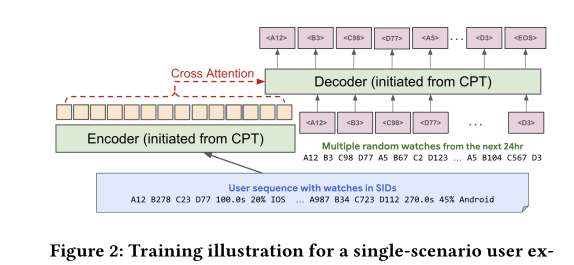
两个关键departure(都被消融验证):
- look-ahead 采样:不预测紧邻的下一个观看
W_{t+1},而是从未来窗口{W_{t+1},…,W_n}(cutoff T 后 24h 内)随机选最多 N=15 个目标——防过拟合紧邻行为、逼近”近未来兴趣”。 - 多目标同时预测:一次预测多个目标,提升训练效率。
损失函数(只作用于 decoder,且只在 prefix-L 个 SID token 上算):
L = − Σ_{i=1..N} r(W_i) · Σ_{j=1..L} log P(SID_{i,j} | W_1..W_t, W_{<i}, SID_{i,<j})
i索引 N 个采样目标,r(W_i)是互动奖励(鼓励多样、高价值消费,由多种用户信号组合)。- 实现上:按奖励正比采样训练样本、在 loss 里等权,比直接加不同权重更高效。
- encoder 不直接受监督:梯度只经 decoder 的 cross-attention 回流,隐式监督 encoder 产出”利于 SID 生成”的表示。
骨干 & 训练:encoder-decoder 基于 Gemini V1.5,370M MoE encoder + 370M dense decoder,均从 CPT(Continued Pre-Training)检查点初始化(让 LLM 先对齐 SID 这个新模态)。JAX + Pathways;持续训练(每天用最新数据增量训,每天百万级样本,比传统 LEM 需要十亿级交互更省样本);连续训练下恒定学习率比 warmup+cosine 更抗日间分布漂移。
模块 C — 跨场景统一建模(multi-context decoding)
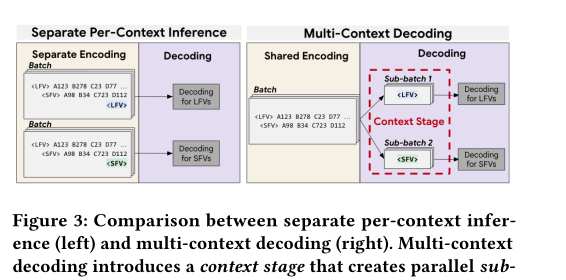
长视频(LFV)和短视频(SFV)ID 空间不相交、消费模式不同,但近半用户两者都看、SID 词表前两级约 40% 重叠 → 值得统一。
- 统一训练:每个 watch 前加
<LFV>/<SFV>条件 token;搜索 query 前加<Search>token 交织进序列;目标采样同时含 LFV/SFV;condition token 不计入 loss(太好预测会拖累 SID 预测质量)。 - multi-context decoding(核心效率创新):朴素做法要为每个场景跑一次推理(重复处理历史)。改为:共享一次 encoder 前向 → context stage 分叉出每场景一个并行子 batch → 各自用对应 condition token 独立 beam search,但全部复用同一份 encoder 隐状态。一次 prefill 同时出 LFV 和 SFV 用户 token。
模块 D — 下游适配(离散 token → 连续向量)
下游 LEM 要稠密向量,需把离散 SID token 投影回连续空间,三种方法:
- Prefix Embedding Mapping(EM,静态):把预测的 L-prefix SID 映回生成它的原始内容 embedding;多个视频塌到同一前缀时对它们原始 embedding 取均值。
- N-gram Embedding(LE,可学):SID 切成定长 N-gram 子词(N=2 即相邻码元对),各查一张随机初始化、随下游端到端训练的 embedding 表,求和。
- SPM Embedding(LE):同 N-gram 但用 SentencePiece 学变长子词。
beam search 出 B 条 SID 序列 → 各自得 SID embedding → 池化(attention/mean/max/top-k 拼接)成单个用户向量。结论:(2)(3) 这类可学 embedding(LE) 优于静态 EM;池化方式对结果影响很小(说明收益来自 token 本身信息)。
模块 E — 异步 serving
为十亿用户在严格延迟下服务:基于 UBS(User Behavior Service)异步框架,把”重表示生成”与”实时打分”解耦——用户 embedding/token 异步生成并缓存进 KV 存储,实时打分直接取缓存;缓存过期/缺失则后台 Refresh Service 读最新历史重新推理回写。24 小时刷新节奏;每用户取 1152 维 dense embedding + beam search 解 B=40 条 SID(20 LFV + 20 SFV)。
实验设置与结果
数据/场景:YouTube 长短视频观看历史 + 搜索 query,多个生产 surface,全量用户(十亿级)线上 A/B(7 天)。指标:离线 Recall@10(Session Recall 用近全历史预测末位;Cold-Start Recall 用截断历史预测未来窗口随机一个);线上 Engaged Users / Satisfied Engagement / Fresh Engagement。
训练目标消融(Table 1,Recall@10):
| 配置 | Session Recall | Cold-Start Recall |
|---|---|---|
| TokenMinds(完整) | 0.291 | 0.210 |
| w/o 多目标 | 0.265 (−8.9%) | 0.203 (−3.3%) |
| w/o look-ahead 窗口 | 0.278 (−4.5%) | 0.189 (−10.0%) |
| w/o SID 截断(用全长 SID) | 0.247 (−15.1%) | 0.174 (−17.1%) |
→ SID 截断和 look-ahead 对冷启动尤其关键。
初始化 & 搜索信号(Table 2,相对随机初始化无搜索的 Δ%):
| 初始化 | +搜索 query | Session | Cold-Start |
|---|---|---|---|
| CPT | 否 | +5.3% | +8.7% |
| 随机 | 是 | +12.5% | +16.9% |
| CPT | 是 | +23.5% | +31.5% |
→ CPT > 通用预训练 Gemini > 随机;搜索 query 普遍加分,且与强初始化正交叠加。
线上下游(Table 4,SFV surface):
| 表示 | Engaged Users | Satisfied Engagement |
|---|---|---|
| Embed-only | 0.00% | +0.05% |
| Token-only | +0.04% | +0.40% |
| Embed+Token | +0.11% | +0.62% |
→ 核心证据(RQ2):离散 token 单独有正增量,与 dense embedding 一起用收益叠加(互补)。下游 EM vs LE 对比中 LE 更优。
跨场景效率(Table 6):统一模型 vs 两个独立模型——上游训练 compute −50%、上游 serving compute −31%(multi-context decoding 共享 encoder:481 chips vs 698 chips),核心指标不降,Fresh Engagement 反升(SFV +0.33% / LFV +0.19%)。
其他:token 存储 1,280 字节 vs dense 4,608 字节(−72% 存储);serving 缓存命中率 96.4%(1.44M reads/s);每用户生成 ~339ms(后台吸收);embedding 稳定性 Sim(扰动同用户)=0.993 ≫ Sim(不同用户)=0.761;beam search 多样性 CDF 与真实观看分布相当(不塌缩)。
思考与可参考价值
定位:这是 Semantic ID 范式从”物品侧”正式扩到”用户侧”的工业代表作,建立在 TIGER(SID 起源)+ PLUM(把 SID 词表对齐进 LLM 的 CPT 框架)之上,是 gen-rec 这条线在”用户表示”维度的重要补全。
真正的创新点(区分新颖 vs 工程):
- 🔴 概念:用户的”稀疏 SID token + 稠密 embedding”dual-output 互补——把 LIGER/COBRA 在物品侧的稀疏-稠密互补搬到用户侧,并用线上 A/B 证明叠加增益。
- 🟡 方法:multi-context decoding(一次 encoder 前向、按场景前缀并行解码)是省算力的巧设计;look-ahead 多目标 + 奖励正比采样的训练目标。
- 🟢 工程:UBS 异步生成+缓存解耦、CPT 初始化、encoder/decoder 异步刷新频率分离。
局限(清醒看):
- 线上绝对增益偏小(核心指标 +0.11%、互动 +0.62%)——工业体量下显著但幅度有限,且全是内部指标、无法外部复现。
- 全栈绑 Gemini + YouTube 内部数据/基建(UBS、RQ-VAE SID、Pathways),外部几乎不可复现。
- 只验证了 ranking 一个下游(retrieval/LLM 下游仅提及);离散 token “可解释/语义锚定”的 claim 缺直接证据(更多是结构性论证)。
- SID 仍来自冻结的物品 RQ-VAE,新内容/词表更新问题没碰(与 OneRetrieval「可编辑码本」是互补缺口)。
对电商/搜推/Agent 可直接借鉴:
- 用户表示也可以”离散化”:把用户兴趣编成共享 SID 词表的离散 token,和现有 dense 用户向量并存互补喂下游——是缓解”定长向量丢细节”的现成思路,且离散 token 抗物品词表漂移(长历史建模尤其受益)。
- multi-context decoding 是任何”一套用户编码、多场景/多目标出口”系统的省算力模板(共享 encoder prefill、分支并行解码)。
- 表示与下游解耦 + 异步缓存 serving:重生成模型想上线但实时算不起时,UBS 式”异步生成→KV 缓存→下游直取”是可套用的工业架构(与本站 RaG 的 SID 缓存、Sortify 的解耦思路一脉)。
- CPT 把新模态(SID)对齐进 LLM 再做下游,比随机初始化大幅提升——做”LLM + 自定义离散 ID”的团队应优先复用。