Text Is All You Need: Learning Language Representations for Sequential Recommendation
UC San Diego × Amazon
彻底丢掉 item ID,把每个 item 的 key-value 属性「拍平」成一句话,整条用户序列就是「句子的序列」,用一个改造过 embedding 层的 Longformer 直接编码并检索下一句(下一个 item)。语言即 item 表征,因此天然可跨域迁移、可处理冷启动 item,零样本就能逼近全量训练的 ID 模型。
核心思路
传统序列推荐(GRU4Rec / SASRec / BERT4Rec)的根基是 item ID + 可训练 item embedding 表:embedding 从用户交互序列里学出来。这套范式有两个硬伤——(1) 冷启动:新 item 的 embedding 是随机初始化的,没有交互就没有信号;(2) 跨域不可迁移:item ID 和 embedding 表都是数据集专属的,换个域(笔记本 → T 恤)要重训。后来 UniSRec / ZESRec 这类「ID-Text」方法想用文本缓解,但做法是 先用冻结的 BERT 把 item 文本编码成固定特征向量,再接一个独立的序列模型,于是又冒出三个新问题:
- 语言域不匹配:BERT 在维基百科上预训练,item 文本(属性拼接)是另一种语言分布,sentence-level 特征对推荐次优;
- 粒度太粗:只给 sentence-level 文本特征,学不到 word-level 的细粒度偏好(比如「最近买的衣服都是同一个颜色」这种属性级信号);
- 两段式割裂:语言理解(MLM 训练 BERT)和推荐(next-item 训练序列模型)是分开训的,语言模型为推荐服务的潜力没被联合训练激发出来。
Recformer 的回答是把「自然语言理解」和「序列推荐」统一进同一个 Transformer,做成 ID-free 范式:
- item = 一句话:把 item 的
{(key, value)}属性字典拍平成Title 2020 MacBook Air ... Brand Apple Color Gold这样的「item 句子」(图 2); - 用户序列 = 句子的序列:一条交互序列变成多句拼接的长文本;
- 推荐 = 检索下一句:模型理解整段「句子序列」,用
[CLS]表征去和候选 item 的句子表征算余弦相似度,retrieve 下一个 item。
因为表征完全建立在 共享词表的 word token 上,模型大小与 item 数无关,知识可跨域迁移,冷启动 item 直接编码文本即可得到表征。论文标题 “Text Is All You Need” 即此意。
整体实现思路
属性字典 D_i = {(k1,v1),...,(km,vm)}
        │ flatten
        ▼
item 句子 T_i = {k1,v1,k2,v2,...,km,vm}         (图 2)
        │ 反转序列 + 前置 [CLS]
        ▼
模型输入 X = {[CLS], T_n, T_{n-1}, ..., T_1}      (最近 item 放前面)
        │ 四类 embedding 求和 + LayerNorm
        ▼
Longformer(局部窗口注意力 + [CLS] 全局注意力)
        │
        ▼
h_[CLS] = 序列表征 h_s ;单 item 当作只含一个 item 的序列 → item 表征 h_i
        │
        ▼
预测:r_{i,s} = cos(h_i, h_s),对全量 item 取 argmax
训练分三步:预训练(MLM + item-item 对比)→ 两阶段微调(先更新 item 特征矩阵、再冻结只训模型)→ 推理(提前编码全量 item 缓存,逐条算 cos)。
子模块实现(可复现细节)
1. 输入构造与序列反转
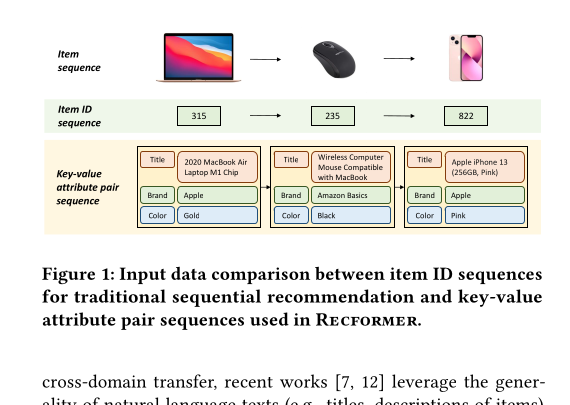
每个 item 取 title / categories / brand 三个属性(沿用 UniSRec 设定),拍平成 item 句子。用户序列 {i1,...,in} 先反转成 {in, in-1, ..., i1}——因为最近的 item 对 next-item 预测最重要,反转能保证在 token 截断时最近 item 一定进窗口。前置 [CLS],得到 X = {[CLS], T_n, ..., T_1}。
截断超参:每个属性最多 32 token,整条序列最多 1024 token,最多 50 个 item。
2. 四类 Embedding(关键改造点)
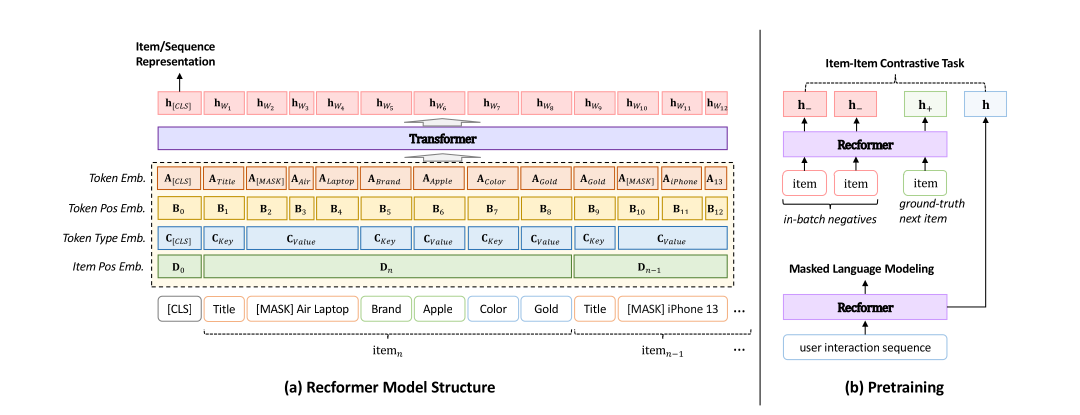
输入 token w 的 embedding 是四者求和再 LayerNorm(公式 2):
- Token embedding
A ∈ R^{V_w × d}:词表 token embedding。Recformer 没有 item embedding 表,对 item 的理解全靠这些 word token embedding,因此模型大小与 item 数无关。 - Token position embedding
B_i ∈ R^d:token 在序列中的位置(同标准 LM)。 - Token type embedding
C ∈ {C_[CLS], C_Key, C_Value}:只有 3 个向量,标记 token 来自[CLS]/ 属性 key / 属性 value。作用是让模型识别「重复出现的 key 词」(大多数 item 共享相同的 key,如 Title/Brand/Color),区分 key 和 value 的重要性。 - Item position embedding
D ∈ R^{n × d}:第 k 个 item 的所有词共享同一个D_k。这是从自注意力序列推荐器借来的核心组件,负责学习 item 级序列模式,并帮助对齐「word token ↔ item」。
注意图 1 中四类 embedding 的对齐:
item_n内部所有词共享D_n,item_{n-1}共享D_{n-1};而同一 item 内 key 词标C_Key、value 词标C_Value。只有 token type embedding 和 item position embedding 是随机初始化的,其余参数用allenai/longformer-base-4096的预训练权重初始化。
3. 编码器(Longformer)
用双向 Longformer 编码 E_X(公式 4):[CLS] 走 全局注意力,其余 token 走 局部窗口注意力(窗口 64),随序列长度线性扩展,适合长序列。论文强调选 Longformer 只为算力效率,方法本身对 BERT / BigBird 等任意双向 Transformer 开放。
h_[CLS] 作为序列/item 表征。没有 item embedding 表:把单个 item 当作「只含一个 item 的序列」X = {[CLS], T_i},得到的 h_[CLS] 即 item 表征 h_i。
4. 预测
余弦相似度打分(公式 5),对全量 item 取 argmax(公式 6):
推理时 提前把全量 item 编码缓存,避免每次重算。
5. 预训练:MLM + item-item 对比(IIC)
多任务联合(公式 11):,λ = 0.1。
- MLM(公式 7-9):照 BERT,随机 15% token,其中 80% 换
[MASK]/ 10% 换随机词 / 10% 不变。作用是 (a) 联合训练时防止遗忘词义;(b) 消除「通用语料 vs item 文本」的语言域 gap。 - IIC(公式 10,InfoNCE 形式):正例是真 next item,负例用 in-batch 其他样本的 ground-truth item(不是负采样、也不是全 softmax)。原因:item 表征来自 Recformer 本身,无法像 ID 模型那样从 embedding 表里廉价取负例并重编码;in-batch 负例避免每 batch 重编码海量 item。预训练数据量大,假负例概率低,可接受。
6. 两阶段微调(Algorithm 1,关键工程点)
小数据集上 in-batch 负例假负例多,会伤性能 → 改用 全 softmax(公式 12,分母遍历全量 item I)。但 item 表征是 Recformer 现算的,每 batch 重编码全量 item 太贵,于是维护一个 不可学习的 item 特征矩阵 I ∈ R^{|I|×d}(区别于可学习 embedding 表,里面的值全部由 Recformer 编码得到):
- Stage 1:每个 epoch 重新用当前模型编码全量 item 刷新
I(line 4),再用I当监督做对比训练(line 5),按验证集存最佳(M', I')。本质是「item 表征还能在下游继续被优化」。 - Stage 2:用 Stage 1 最佳参数重新初始化模型,冻结
I,只训模型直到验证集收敛。因为 Stage 1 里I一直在变、监督信号漂移,模型难收敛到最优;冻结后稳定优化。
微调 loss:。
7. 训练超参
Adam,lr 5e-5;batch 预训练 64 / 微调 16;early stop patience 5;Longformer 局部窗口 64;τ=0.05,λ=0.1。
实验设置与结果
数据:Amazon review 多品类。预训练用 7 类(Automotive / Cell Phones / Clothing / Electronics / Grocery / Home & Kitchen / Movies & TV)当源域,留 CDs & Vinyl 作验证;预训练集 360 万用户 / 102 万 item / 3359 万交互。下游 6 个目标域:Scientific / Instruments / Arts / Office / Games / Pet。5-core 过滤、丢无 title 的 item、按时间排序、leave-one-out 切分(最后一个 item 测试、倒数第二验证)。
指标:NDCG@10、Recall@10、MRR,全量 item 排序(非采样)。
baseline 三组:ID-Only(GRU4Rec / SASRec / BERT4Rec / RecGURU)、ID-Text(FDSA / S³-Rec)、Text-Only(ZESRec / UniSRec)。
主结果(全监督,节选 Table 2)
| 数据集 | 指标 | SASRec | BERT4Rec | S³-Rec | UniSRec | Recformer | 相对提升 |
|---|---|---|---|---|---|---|---|
| Scientific | NDCG@10 | 0.0797 | 0.0790 | 0.0451 | 0.0862 | 0.1027 | +19.14% |
| Scientific | MRR | 0.0696 | 0.0759 | 0.0392 | 0.0786 | 0.0951 | +20.99% |
| Arts | NDCG@10 | 0.0848 | 0.0942 | 0.1026 | 0.0894 | 0.1252 | +16.47% |
| Office | NDCG@10 | 0.0832 | 0.0972 | 0.0911 | 0.0919 | 0.1141 | +17.39% |
| Games | NDCG@10 | 0.0547 | 0.0628 | 0.0532 | 0.0580 | 0.0684 | +8.92% |
| Pet | NDCG@10 | 0.0569 | 0.0602 | 0.0742 | 0.0702 | 0.0972 | +28.91% |
| Pet | MRR | 0.0507 | 0.0585 | 0.0710 | 0.0650 | 0.0940 | +32.39% |
| Instruments | Recall@10 | 0.0995 | 0.0972 | 0.1110 | 0.1119 | 0.1052 | —(唯一不赢) |
平均 NDCG@10 +15.83% / MRR +15.99%(对第二名)。唯一没拿第一的是 Instruments 的 Recall@10。
零样本(Figure 4)
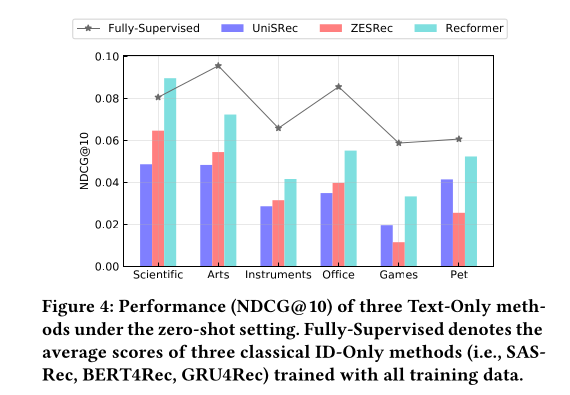
三个 Text-Only 方法预训练后直接测下游(ID 方法无法零样本)。Recformer 零样本在六个域全面超过 UniSRec / ZESRec;在 Scientific 上零样本 NDCG@10 甚至超过三个 ID 方法全量训练的平均值。论文报告零样本设定平均提升 39.78%(NDCG@10)。
低资源(Figure 5)
1%/5%/10%/50%/100% 训练数据下,带文本的 UniSRec/Recformer 全面碾压 SASRec,越少数据差距越大(SASRec 在低资源下大量测试 item 未见过、embedding 随机)。Scientific 上 1%/5% 数据 Recformer 大幅领先。
冷启动(Table 3,In-Set vs Cold)
把数据切成 in-set(测试 item 都在训练里见过)和 cold(从未在训练出现),只在 in-set 训练、两边都测。SASRec 给只出现一次的 item 用 cold token 兜底。
| 数据集 | 指标 | SASRec Cold | UniSRec Cold | Recformer Cold |
|---|---|---|---|---|
| Scientific | N@10 | 0.0213 | 0.0441 | 0.0520 |
| Arts | N@10 | 0.0071 | 0.0395 | 0.0406 |
| Pet | N@10 | 0.0013 | 0.0101 | 0.0225 |
| Pet | R@10 | 0.0019 | 0.0175 | 0.0400 |
SASRec 冷启动几乎崩溃(Pet N@10=0.0013),文本方法显著更好,Recformer 在 in-set 和 cold 两边都赢 UniSRec——「学语言表征」优于「取文本特征」。
消融(Table 4)
| 变体 | Scientific N@10 | Instruments N@10 |
|---|---|---|
| (0) Recformer 完整 | 0.1027 | 0.0830 |
| (1) 去两阶段微调 | 0.1023 | 0.0728 |
| (5) 去预训练(从头微调) | 0.0722 | 0.0598 |
| (6) 去 item-pos + token-type emb | 0.1018 | 0.0518 |
要点:(a) 预训练最关键——去掉后 item 特征矩阵 I 没被训过,监督信息差,两个域都大跌;(b) 两阶段微调在预训练表征本来就好的域(Scientific)几乎无差,在表征差的域(Instruments)有明显增益,作用是「修复次优的预训练 item 表征」;(c) item-position + token-type embedding 在预训练/微调 gap 大的域(Instruments 0.0830→0.0518)很关键。
预训练步数(Figure 6)
零样本性能 约 4000 步就到顶,再训反而伤迁移。原因:大部分参数来自已 MLM 预训练好的 Longformer,从通用语言到 item 文本的域适应很快;且不同品类有各自专属词表,过度预训练会过拟合源域语言分布。
思考与可参考价值
为什么有效(一句话):把 item 从「opaque ID」变成「可被语言模型理解的句子」,于是冷启动 = 编码新句子、跨域迁移 = 共享词表语义,全部免费获得;联合 MLM + 对比训练让语言模型真正为推荐服务,而非两段式拼接。
局限:
- 推理成本:要对全量 item 跑一遍 Longformer 编码再缓存,item 量级到亿级(工业电商)时编码+刷新成本高,文中也是「每 epoch 才刷一次
I」来妥协;线上实时性、增量更新都是问题。 - 属性依赖:效果系于 title/brand/category 的文本质量与可得性;属性缺失/噪声大的品类(如纯视频、UGC)红利变小。
- 纯文本未必够:协同信号(行为共现)这里完全靠文本相似度+序列模式隐式承载,对「文本不相似但行为强相关」的 item 对(互补品)可能弱于 ID 模型。
- 规模:用的是 base 级 Longformer,没探到大 LLM 尺度;这是 2023 年早期工作,可视作后续 LLM4Rec / Semantic ID 的前身。
对电商/搜推可借鉴:
- ID-free + 属性拍平是处理冷启动和跨类目最直接的范式,对电商「新品/长尾/跨站点冷启」尤其契合——新品上架即可被检索,无需等交互;
- token-type / item-position embedding 这套「把推荐序列结构注入语言模型 embedding 层」的改造很轻量,可直接迁到任何想拿 LM 做序列推荐的场景;
- 两阶段微调(先刷新缓存特征再冻结) 是「item 表征由模型现算、又想用全 softmax」时绕开重编码的实用工程模式,做 dense retrieval / 双塔召回时可复用;
- in-batch 负例(预训练)→ 全 softmax(微调) 的切换策略,平衡了大数据效率与小数据精度,值得在自家召回训练里照搬;
- 「预训练 4000 步就够、过训伤迁移」 提醒做迁移式推荐预训练时别盲目堆步数,源域语言/分布过拟合会反噬下游。