Taiji: Pareto Optimal Policy Optimization with Semantics-IDs Trade-off for Industrial LLM-Enhanced Recommendation
Kuaishou (快手)
把 LLM 当推荐增强器,针对其后训练两个卡点给出系统解法:SFT 阶段用「目标物品 PPL」把开放域推荐 CoT 的质量从不可度量变成可计算标量;RL 阶段用 POPO 自适应权衡「LLM 语义奖励」与「推荐协同 ID 奖励」,达到两目标 Pareto 最优而非此消彼长。已在快手广告上线服务 4 亿+ 日活。
核心思路
一句话问题: 在 LLM-as-Enhancer 范式下,如何同时解决 LLM4Rec 后训练的两个卡点——SFT 阶段「开放域推荐 CoT 的质量无法度量」、RL 阶段「LLM 语义奖励与推荐协同奖励冲突时只会固定权重加和、此消彼长」?
关键 idea:
- SFT 卡点 → 用目标物品 PPL 把 CoT 质量变成可计算标量。推荐是开放生成任务,一条推理链「好不好」没有标准答案。Taiji 把「在给定这条 CoT 作为上下文时,用户真实下一购买物品的困惑度 PPL」当成 CoT 质量代理:PPL 越低说明这条推理给真值物品分配了越高概率、推理越可靠。配合 RUPR (逆向工程)——蒸馏时把真值物品作为已知条件喂给教师模型让它倒推「为何买它」,保证答案 ground-truth 有效。
- RL 卡点 → POPO 自适应权衡两类异构奖励,求 Pareto 最优。语义奖励 (r_s)(文本空间余弦相似度)与协同奖励 (r_{id})(CTCVR,数值空间)梯度方向常冲突。POPO 用「梯度对齐指标」动态调权重:某奖励梯度大且与整体方向一致就加权,冲突就降权,可证为双层优化的镜像下降一阶解,把策略推向 Pareto 前沿而非牺牲一方。
- 范式: LLM 不进在线主链路,而是离线/近线产出对用户偏好的推理表示,量化成稀疏特征 + 跨用户检索特征,喂给广告排序模型当增强输入。已在快手广告上线服务 4 亿+ 日活,全量 Revenue +3.30%。论文名「太极」隐喻 LLM 世界知识与推荐协同信号两股力量的动态统一。
整体实现思路
端到端四阶段 pipeline,如总体架构图所示:
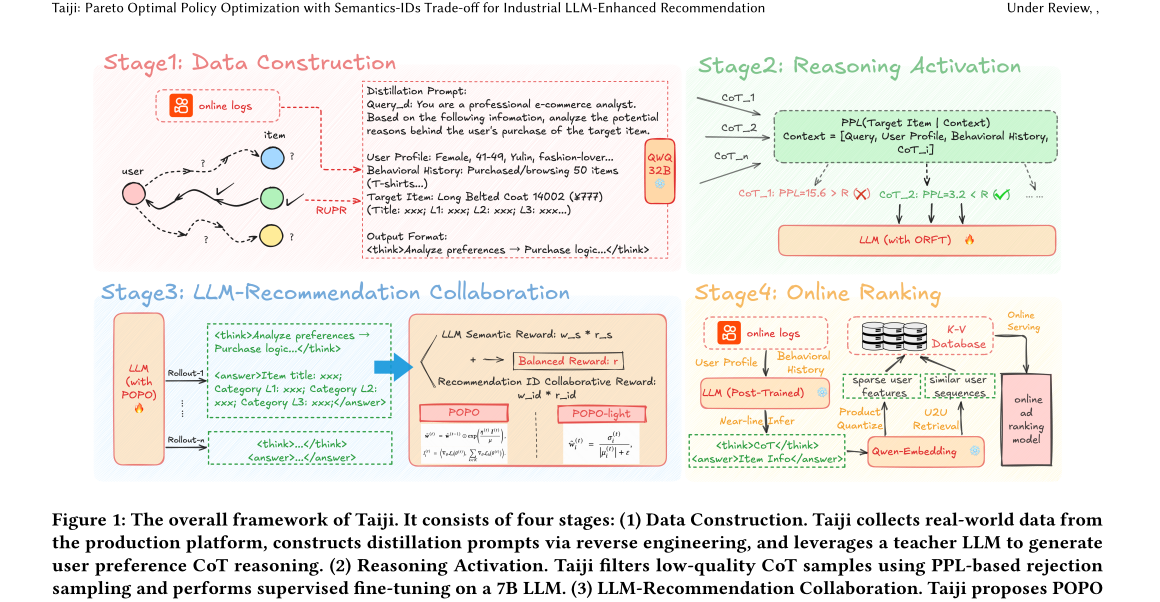
- Data Construction (数据构造): 从快手短视频/广告生产日志采集多模态用户画像 + 近 50 条行为序列,序列化成自然语言 prompt;用 RUPR 把用户「真实下一购买物品」作为条件喂给教师 QwQ-32B,逆向生成解释性 CoT。
- Reasoning Activation (推理激活): 每个 prompt 让教师生成 (k=3) 条候选 CoT,用 PPL 拒绝采样(阈值 (R)=median)筛掉低质量链;在筛后数据上对 DeepSeek-R1-7B 做全参 SFT (ORFT),激活其推荐推理能力。
- LLM-Recommendation Collaboration (协同强化对齐): GRPO 框架下用两类奖励 (r_s)(Qwen3-Emb 余弦)+(r_{id})(排序模型 CTCVR),由 POPO 每步自适应调权重,推向 Pareto 前沿;配离线奖励模拟环境避免每步查线上。
- Online Ranking (在线增强): RL 后的 LLM 近线推理,CoT+Item 经 Qwen-Emb 编码 → 乘积量化成稀疏 ID 特征 (Intra-User);并检索 Top-1 相似用户的近 100 条行为做跨用户特征 (Cross-User),二者拼到传统特征喂广告排序模型。
子模块实现(可复现细节)
1. RUPR — 逆向工程用户偏好推理 (数据构造)
- 输入: 单用户的画像 + 行为序列 + 该用户真实下一购买物品 (y)(item title + 三级类目)。
- 输出: 解释性 CoT 推理链(
<think>...</think>)+ 复述的答案(<answer>...</answer>)。 - 关键设计: 传统蒸馏让教师直接「预测」用户会买什么,开放域无法校验对错;RUPR 把真值物品作为已知条件写进蒸馏 prompt,让 QwQ-32B 倒推「为何这个用户会买它」。这样推理链天然锚定在 ground-truth 上,给 CoT 上「双重语义保险」。
- 数据来源: 整合多表的多模态画像——基础人口属性(性别/年龄/城市等级/婚育/学历)、设备与消费层级、短视频互动偏好(活跃 app、搜索 query、点赞收藏评论、直播互动、历史电商/广告行为);行为序列保留最近 50 条逆时序广告交互,每条模板化为
Item title:...; Category L1:...; L2:...; L3:...。
2. ORFT — 开放式拒绝采样微调 (推理激活)
CoT 质量度量 (核心)——用真值物品困惑度 PPL 作为 CoT 质量代理:
[ \mathrm{PPL}=\exp!\Big(-\tfrac{1}{T},\mathrm{log_likelihood}\Big),\quad \mathrm{log_likelihood}=\sum_{t=1}^{T}\log P(y_t\mid \text{context},y_1,\dots,y_{t-1}) ]
- 符号: (\text{context}=[\text{query},\text{用户画像},\text{行为历史},\text{CoT}]);(y=[y_1,\dots,y_T]) 是真值答案 token 序列(放在
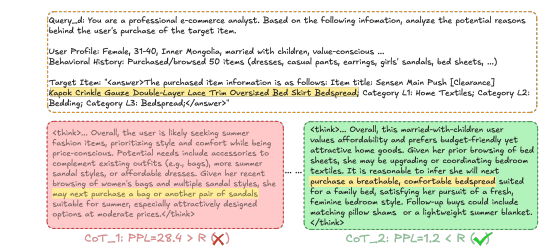
<answer>内);(T) 为 token 数。PPL 低 = CoT 给真值物品分配高概率 = 推理可靠。 - 拒绝采样流程: 每 prompt 用 QwQ-32B 生成 (k=3) 条候选 CoT,仅保留 (\mathrm{PPL}<R) 的(每 prompt 留 0–3 条)。阈值 (R) 取 PPL 分布的中位数(50 分位),论文实测 (R=4.6)(在 2.3K 验证子集上算)。
- 下图是 PPL 拒绝采样的真实例子:同一用户(目标买床罩),CoT₁ 误推「夏季时装需求」PPL=28.4>R 被拒,CoT₂ 正确推「家纺升级意图」PPL=1.2<R 被保留。
SFT 训练——在筛后 CoT 上对 DeepSeek-R1-7B 全参微调,标准 next-token loss(同时覆盖 <think> CoT 与 <answer>):
[ \mathcal{L}{\mathrm{ORFT}}=-\frac{1}{N}\sum{i=1}^{N}\sum_{j=1}^{l_i}\log P(t_j\mid q_i,t_{<j}) ]
- (q_i) 输入 query(含画像+行为历史),(t_j) 第 (j) 个输出 token,(l_i) 输出总长,(N) batch size。
- 关键超参: 全参 SFT 1 epoch,lr (1\times10^{-7}),per-GPU batch 32。
3. POPO — Pareto 最优策略优化 (RL 协同对齐)
两类奖励:
- LLM 语义奖励: (r_s=\mathrm{CosineSim}(e_{\text{pred}},e_{\text{gt}})),其中 (e_{\text{pred}}=\text{Qwen3-Emb}(\text{Answer}{\text{LLM}}))、(e{\text{gt}}=\text{Qwen3-Emb}(\text{Item}_{\text{gt}}))(均用 Qwen3-Embedding-0.6B 编码,文本语义空间)。
- 推荐 ID 协同奖励: (r_{id}=\mathrm{CTCVR}(u,i)=P(\text{click}\wedge\text{conversion}\mid u,i)),取自线上广告排序模型,对原始 CTCVR 做 min-max 归一化(数值协同空间)。
- 离线奖励模拟环境: 从生产系统采样 user-item 对及其预测分,构成离线模拟器,RL 训练时直接查表算 reward,避免每步打线上、大幅加速。
POPO 权重更新规则(指数梯度 / 镜像下降):
[ \boldsymbol{w}^{(t)}=\frac{\tilde{\boldsymbol{w}}^{(t)}}{\sum_{k\in\mathcal{K}}\tilde{w}_k^{(t)}},\quad \tilde{\boldsymbol{w}}^{(t)}=\tilde{\boldsymbol{w}}^{(t-1)}\odot\exp!\Big(\tfrac{\eta^{(t)}\boldsymbol{I}^{(t)}}{\mu}\Big) ]
- (\mathcal{K}={s,id}) 奖励源集合,(\eta^{(t)}) 学习率,(\mu>0) 正则因子,(\odot) Hadamard 积。
- 梯度对齐指标: (I_i^{(t)}=\big\langle \nabla_\theta\mathcal{L}i(\theta^{(t)}),\ \sum{k\in\mathcal{K}}\nabla_\theta\mathcal{L}_k(\theta^{(t)})\big\rangle),衡量第 (i) 个奖励梯度与全体奖励聚合梯度方向的一致性。梯度大且对齐 → 加权(协同推进);梯度冲突 → 自动降权(防止把策略拖离 Pareto 前沿)。
- Pareto 保证: 上式是双层优化的一阶解——下层对 (\theta) 做加权 GRPO,上层在最优响应策略上优化权重 (\boldsymbol{w}\in\Delta^{|\mathcal{K}|})(概率单纯形);其稳定点满足 Pareto 最优条件(不存在另一策略在所有 (\mathcal{L}_k) 上都不差且至少一项严格更优)。
POPO-light (工业轻量版)——避免每步算跨域梯度内积(显存/时延开销大),改用 rollout 级奖励统计:
[ \tilde{w}_i^{(t)}=\frac{\sigma_i^{(t)}}{\mu_i^{(t)}+\varepsilon} ]
- (\mu_i^{(t)})、(\sigma_i^{(t)}) 是奖励 (r_i) 在组内的均值与标准差,(\varepsilon) 数值稳定常数。本质是奖励的变异系数 (std/mean):组内方差相对幅值大 = 当前策略沿该方向仍可区分 = 给大权重;奖励饱和(方差→0)则自动衰减权重。只依赖前向 reward 标量,零额外反向计算,可无缝插进 GRPO 训练环,适合 web-scale 部署。
最终训练目标 (GRPO + POPO 动态权重):
[ \mathcal{L}{\mathrm{POPO}}(\theta)=\mathbb{E}\Big[\tfrac{1}{G}\sum{i=1}^{G}\tfrac{1}{|o_i|}\sum_{t=1}^{|o_i|}\big(\min(\rho_{i,t}\hat A_{i,t},,\mathrm{clip}(\rho_{i,t},1-\varepsilon,1+\varepsilon)\hat A_{i,t})-\beta,\mathbb{D}{\mathrm{KL}}[\pi\theta|\pi_{\text{ref}}]\big)\Big] ]
- (\rho_{i,t}=\pi_\theta(o_{i,t}\mid q,o_{i,<t})/\pi_{\theta_{\text{old}}}(\cdot)) 重要性比;(\hat A_{i,t}) 组归一化优势;(G) 组大小(rollout 数);(\varepsilon,\beta) 裁剪比/KL 系数;(\pi_{\text{ref}}) 是 SFT 初始化的参考策略。
- 每条 rollout 的标量奖励 = POPO 加权组合: (\tilde r_i=w_s^{(t)}r_s(o_i)+w_{id}^{(t)}r_{id}(o_i)),权重来自 Eq.(5)/(7)。
- 关键超参: RL 1 epoch,lr (2\times10^{-5}),per-GPU batch 16,rollout 组 (G=4),max prompt 13,000 tokens,max completion 2,048 tokens,权重初始化 (w_s=w_{id}=0.5)。训练在 3 节点 × 8×A800。
4. 在线排序增强
- Intra-User 量化特征: 每个用户请求 → 后训练 LLM 生成
<think>CoT</think>;<answer>Item Info</answer>→ Qwen-Embedding-0.6B 编码 CoT&Item Info → 乘积量化 (product quantization) 成稀疏 ID 向量,喂排序模型。 - Cross-User 检索特征: 在 embedding 空间用余弦相似度为目标用户 (u) 检索 Top-1 最相似用户,取其近 100 条行为序列聚合成附加特征,引入跨用户协同信号(尤其补稀疏用户)。
- 融合: 量化稀疏特征 + 跨用户序列 + 传统特征拼接 → 在线广告排序模型。
实验设置与结果
数据集: 快手生产系统采样 111 万用户记录(画像+近一月行为)。划分: 100 万 SFT(每用户 QwQ-32B 生成 (k=3) CoT,PPL 阈值 (R=4.6))、10 万 RL、1 万测试。真值标签为 item title + 三级类目。
Baseline: DeepSeek-R1-7B(未调骨干)、QwQ-32B(蒸馏教师);RL 基座对照 GRPO(固定权重 (w_s=w_{id}=0.5))。
指标定义:
- Semantic Hit-Rate(LLM 推理质量): 三级类目准确率 Category_L{1,2,3}_ACC、标题命中 Title_Hit-Rate@{50,100}。
- Preference Hit-Rate(线上偏好对齐): 离线模拟 CTCVR。
- 在线: ADVV(广告主价值)、Revenue(平台收入)。
离线主结果(Table 1,↑ 为相对 DeepSeek-R1-7B 提升):
| 指标 | DeepSeek-R1-7B | QwQ-32B | Taiji(ORFT) | Taiji(ORFT+POPO-light) | Taiji(ORFT+POPO) |
|---|---|---|---|---|---|
| Category_L1_ACC | 0.1560 | 0.1974 | 0.2012 | 0.2347 (↑50.45%) | 0.2433 (↑55.96%) |
| Category_L2_ACC | 0.0608 | 0.0767 | 0.0690 | 0.0877 (↑44.24%) | 0.0888 (↑46.05%) |
| Category_L3_ACC | 0.0251 | 0.0039 | 0.0245 | 0.0307 (↑22.31%) | 0.0347 (↑38.25%) |
| Title_Hit-Rate@50 | 0.0496 | 0.0563 | 0.0449 | 0.0558 (↑12.50%) | 0.0567 (↑14.31%) |
| Title_Hit-Rate@100 | 0.0646 | 0.0733 | 0.0606 | 0.0762 (↑17.96%) | 0.0720 (↑11.46%) |
| CTCVR | 0.003417 | 0.003675 | 0.003723 | 0.003802 (↑11.27%) | 0.003816 (↑11.68%) |
在线 A/B(Table 2,10% vs 10% 流量跑一周):
| 设置 | Intra-User ADVV | Intra-User Rev | Cross-User ADVV | Cross-User Rev | 总 ADVV | 总 Revenue |
|---|---|---|---|---|---|---|
| all | +1.06% | +1.35% | +1.77% | +1.95% | +2.83% | +3.30% |
| long-tail(稀疏用户) | +2.78% | +4.12% | +2.48% | +1.20% | +5.26% | +5.32% |
消融结论:
- RUPR(Table 3): SFT 后格式正确率已 ~99%(Think 标签存在率 0.9947);用真值引导 vs 直接蒸馏在细粒度类目提升显著——Category_L3_ACC +32.43%、L2 +28.97%、L1 +19.83%。
- POPO(Table 4,相对固定权重 GRPO): POPO 同时拉高语义与偏好 Hit-Rate(L3_ACC +29.00%、L1 +11.61%、CTCVR +0.74%),验证它把策略推向 Pareto 前沿而非牺牲一方;POPO-light 多数指标第二、Title_Hit-Rate@100 反超完整 POPO(0.0762 vs 0.0720)。
- ORFT 副作用: 相比 7B 骨干类目级大涨(L1 +28.97%、CTCVR +8.96%),但标题级 Hit-Rate 下降(SFT 泛化有限,只学到粗粒度匹配),这正是后续 RL 优化的动机。
思考与可参考价值
局限:
- 离线主对照只有未调骨干 + 蒸馏教师,未与同期 LLM-as-Enhancer 方法(KAR / RLMRec / Rec-R1 等)直接对比,学术身位不明。
- 仅在快手广告单场景验证;方法地基「用户真实下一购买物品」在电商转化场景才清晰,泛内容推荐难复制。
- PPL 作 CoT 质量代理有天花板: PPL 低 ≠ 推理因果正确,可能学到捷径(高频共现物品天然低 PPL)。
- ORFT 有副作用(细粒度标题能力下降);7B LLM 近线推理的时延/成本账未充分交代。
对电商/搜推/Agent 的可借鉴点:
- PPL-as-CoT-quality: 无标准答案的开放域推理(如「解释用户为何点击/转化」),可用「给定推理链时目标事件的困惑度」做自动质量打分,比 LLM 自评/裁判模型客观、零额外模型。可直接迁到推送/点击预测 user simulator 的 CoT 筛选。
- POPO 异构奖励权衡: 任何 RL 后训练里有「语义合理性 vs 业务指标对齐」两类冲突奖励的场景(电商生成式推荐、Agent 多目标对齐),POPO 的梯度对齐自适应权重 + Pareto 保证是通用范式;POPO-light(变异系数当权重)几乎零成本,值得作为固定权重 GRPO 的第一替代实验。
- 离线奖励模拟环境: 用排序模型 CTCVR 打分构成离线 reward 表,RL 每步查表而非打线上——「用真实日志做离线 reward」对任何高时延在线奖励场景都适用。
- 逆向工程造数据(RUPR): 把已知结果作为条件让教师倒推解释,是开放域蒸馏保证标签有效性的通用技巧,可推广到「已知转化/留存倒推归因 CoT」。
- 后续方向: 更鲁棒的 CoT 质量度量(超越 PPL)、POPO 扩展到 >2 个异构奖励、跨场景迁移。