Semantic IDs for Joint Generative Search and Recommendation
Spotify
在「搜索+推荐」统一生成式模型里,Semantic ID 该用哪种 embedding 来构造是决定性因素。任务专属 embedding(搜索调优 / 推荐调优)只在单任务上强、在另一任务上崩。用一个对搜索和推荐联合微调的 bi-encoder(Multi-task)产出共享 Semantic ID 空间,能在两任务间取得最佳折中,且不增加 token 预算。
核心思路
在 LLM 驱动的生成式模型里,item 必须被映射成离散 token 才能被生成。传统做法用唯一 ID(SASRec)或启发式序列 ID(P5),都要随冷启动 item 重训、工业上不可用。近期主流是 Semantic ID:从预训练 item embedding 量化出一组离散 code,让内容相似的 item 共享 token,从而具备泛化和冷启动能力。
但 Semantic ID 的好坏严重取决于用来构造它的 embedding 空间。已有工作(RIPOR / TokenRec)证明:为某个任务(搜索 or 推荐)专门微调 embedding,能在该任务上得到最好的 Semantic ID。本文要回答的关键问题是:
当搜索和推荐被放进同一个生成式模型(Joint S&R)时,能不能造出一套对两个任务都好的 Semantic ID?
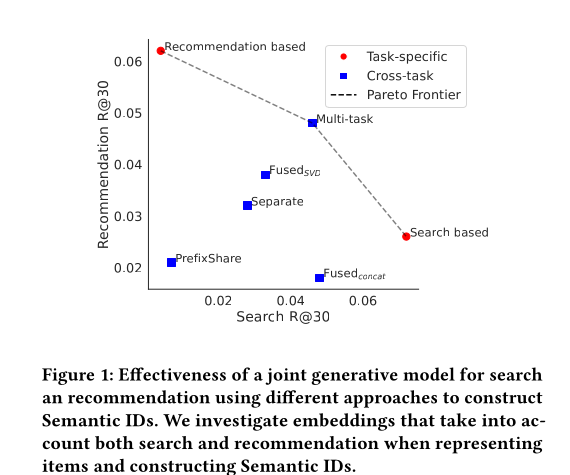
核心发现(也是 Pareto 图 Figure 1 的结论):
- 任务专属 embedding 存在根本性 trade-off:用推荐调优的 embedding,搜索 R@30 从 0.072 跌到 0.004(-94%);用搜索调优的 embedding,推荐 R@30 从 0.062 跌到 0.026(-60%)。优化一个任务就牺牲另一个。
- 不是靠”每个任务造专属 ID”取胜,而是靠一个对搜索+推荐联合微调的 bi-encoder(Multi-task)先产出共享 embedding、再统一量化成一套 Semantic ID,能落在 Pareto 前沿、两任务都不差,且不膨胀 token 预算。
- 量化器(tokenizer)层面,轻量的 RQ-KMeans 反而打败了 RQ-VAE 等学习型自编码量化器。
整体实现思路
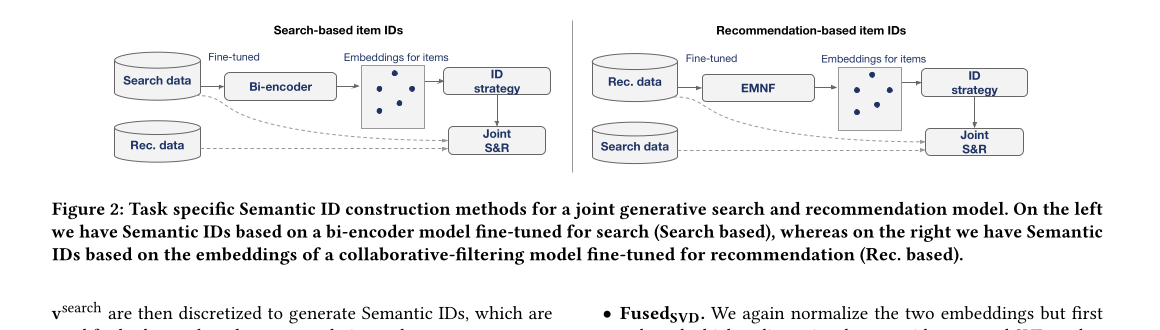
整条链路三段式:(1) 选 embedding 来源 → (2) 用 ID strategy(量化器)把 embedding 离散成 Semantic ID → (3) 把 Semantic ID 喂进一个对搜索和推荐联合训练的生成式模型(flan-t5-base)做生成式检索。本文唯一变量是第 1、2 段(embedding 来源 + 量化方法),第 3 段(生成模型)固定。
作者把 embedding/ID 构造方法分两大族、共 7 种:
- Task-specific(任务专属):Search-based、Rec-based —— 只用单任务监督信号训 embedding。
- Cross-task(跨任务):Separate、Prefix-share、Fused_concat、Fused_SVD、Multi-task —— 显式引入两个任务的信息。
所有方法产出的 Semantic ID 都进同一个 Joint S&R 生成模型,用同样的指标对比,从而隔离出”ID 构造方式”这一个因素的影响。
子模块实现(可复现细节)
数据集构造
- 基于 MovieLens-25M,沿用 Penha et al.[14] 的 S&R 数据集:62,138 部电影、1.24M user–item 交互(按时间切分,每个 user 最后一次交互作测试)。
- 搜索 query:每个 item 用 Gemini-2.0-flash 生成 20 条自然语言 query(10 train / 10 test)。prompt 要求 query 不含电影标题、描述电影内容/主题/类型,且半数是前半的同义改写。
- 关键细节:每个 item 都有 10/10 条 query → 搜索数据无热度偏置(uniform 分布)。这与推荐数据的热度分布差异很大,作者明确指出真实场景两分布更相似时结果应更乐观。
- 内容类方法用 title、year、description、genres、tags、genome tags 拼接做 item 文本。
Embedding 模型
- Content-based:直接用
all-mpnet-base-v2(sentence-transformers)对拼接 metadata 编码,不为任一任务微调。 - Search(bi-encoder):从同一预训练模型起,在搜索数据上用 in-batch 随机负例(MultipleNegativesRankingLoss)微调 —— 5 epoch、batch 512、LR 2e-5、Adam。产出 v_search(386 维)。
- Recommendation(ENMF):用 RecBole 训 Efficient Neural Matrix Factorization[2] —— 30 epoch、batch 512、embedding 256 维、LR 0.001、Adam。产出 v_rec(256 维)。
Cross-task 五种方法(关键差异在”在哪一层融合”)
1) Separate(token 分离):直接给两套任务专属 ID 加任务前缀标签:
ID_sep = ⟨SEARCH:ID_search, REC:ID_rec⟩。搜索 prompt 只输出 search token,推荐 prompt 只输出 rec token。
代价:词表翻倍(共加 1024 个新 token),且一个任务学到的知识无法迁移到另一任务的专属 token,丧失了 Penha et al.[14] 提的跨任务正则化效果。
2) Prefix-share:借鉴 Shi et al.[20],分三套 codebook —— 一套 SHARED + 两套任务专属前缀。单个 encoder 吃拼接 embedding [v_search; v_rec],两个 decoder 学各自 codebook 的重建。最终 ID = 共享 token + 任务专属 token 拼接。本文里 256 shared + 512 task-specific token。
3) Fused_concat(embedding 拼接):对 v_search、v_rec 做 ℓ2 归一化后直接拼接:v_concat = [v_search; v_rec],再量化。
问题:两个空间维度不等(386 vs 256),维度大的空间会被过度表征。
4) Fused_SVD:先归一化,再用 truncated SVD 把高维降到相同维度 d,然后逐元素相加:v_svd = v_search + v_rec,再量化。相比 Fused_concat 提升了推荐、轻微降了搜索。
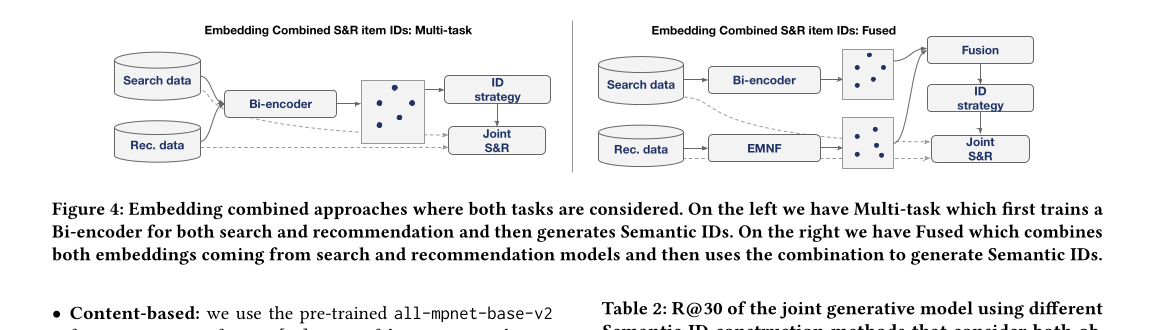
5) Multi-task(本文推荐):把 bi-encoder 同时在两种监督信号上训 —— 搜索的 query–item 对(来自 D_S)+ 推荐的 co-occurring item 对(来自 D_R),共享 encoder 用两个 contrastive loss 之和优化,产出同时携带检索与协同过滤线索的 v_mt,再统一量化成一套 Semantic ID。
量化(ID tokenisation)
- 默认 2 个 codebook,每个 size 256(共 512 token)。
- 默认量化器:RQ-KMeans(FAISS residual quantizer)。
- 消融对比:MiniBatchDictionaryLearning(sklearn)、ResidualLFQ、RQ-VAE(vector-quantize-pytorch)。
生成模型
google/flan-t5-base,对搜索+推荐联合训练 3 epoch(LR 0.002、batch 128、AdamW、weight-decay 0.01)。- 解码用 diversified beam search:beam 60、diversity penalty 0.25、30 groups —— 用于提高检索到的不同 item 数。
实验设置与结果
- 指标:Recall@30。每个模型 5 个随机种子跑 5 次取均值,配对 t 检验(95% 置信)+ Bonferroni 校正。
- Head/Torso 切分:Head = 训练集中最热门 1% item,Torso = 其余。搜索数据无热度偏置。
动机表:任务专属 embedding 的 trade-off
| Embedding 空间 | Search R@30 | Rec R@30 |
|---|---|---|
| Content-based (DSI/TIGER 类) | 0.013 | 0.023 |
| Search based (RIPOR 类) | 0.072 | 0.026 |
| Rec. based (TokenRec 类) | 0.004 | 0.062 |
搜索调优把检索拉高约 5x,但推荐掉 60%;推荐调优反之。验证”优化一个就牺牲另一个”。
主结果(Table 2,R@30)
| 构造方法 | Search (All) | Rec (All) | Rec (Head) | Rec (Torso) |
|---|---|---|---|---|
| Task-specific · Search based | 0.072 | 0.026 | 0.090 | 0.070 |
| Task-specific · Rec. based | 0.004 | 0.062 | 0.170 | 0.035 |
| Cross · Separate | 0.028 | 0.032 | 0.120 | 0.051 |
| Cross · Prefix-share | 0.007 | 0.021 | 0.058 | 0.010 |
| Cross · Fused_concat | 0.048 | 0.018 | 0.045 | 0.041 |
| Cross · Fused_SVD | 0.033 | 0.038 | 0.105 | 0.060 |
| Cross · Multi-task | 0.046 | 0.049 | 0.135 | 0.024 |
要点:
- Multi-task 是唯一两任务都接近各自最优的方法(Search 0.046、Rec 0.049),落在 Pareto 前沿;Fused_SVD 次之。
- Separate 虽显式有两任务信息,但词表翻倍、跨任务知识不共享,反而不如先融合 embedding 再量化的方法。
- Prefix-share 整体偏弱,主因是其底层量化方式在本数据上不灵(见下方量化消融)。
- Fused_concat 的拼接缺陷:维度大的 bi-encoder(386) 压过 ENMF(256),导致偏搜索;Fused_SVD 拉平维度后推荐变好、搜索略降。
- Head/Torso 观察:Rec-based 在 Head(热门)极强(0.170)但 Torso 弱;Search-based 在 Torso 反而最强(0.070)。说明热度在推荐数据里很关键,长尾 item 更该依赖内容信号。
量化方法消融(Table 3,固定 Multi-task embedding)
| 量化方法 | Search | Rec |
|---|---|---|
| RQ-KMeans | 0.046 | 0.049 |
| Dictionary encoding | 0.019 | 0.029 |
| ResidualLFQ | 0.018 | 0.023 |
| RQ-VAE | 0.002 | 0.024 |
RQ-KMeans 全面胜出,尤其 RQ-VAE 在搜索上几乎崩(0.002)。与 Hong et al.[8] 一致 —— 他们也发现 RQ-VAE 不稳定、改用层次 k-means。作者把”为什么轻量 k-means 打败学习型自编码量化器”留作 future work。
思考与可参考价值
局限:
- 只在 MovieLens-25M 单数据集、单模型规模(flan-t5-base)上验证;搜索 query 是 LLM 合成且 uniform 分布(无真实搜索日志),与工业真实分布有 gap —— 作者自己承认真实分布下结果可能更乐观。
- 指标只看 Recall@30,没有 NDCG/MRR 等位置敏感指标,也没线上实验。
- Multi-task 在 Rec-Torso(长尾推荐)上偏弱(0.024),说明联合 embedding 仍偏热门/搜索侧。
- 未探索 Matryoshka 目标来对齐维度(作者点名留作 future work)。
对电商/搜推/Agent 的可借鉴点:
- 搜推一体生成式建模时,Semantic ID 的 embedding 来源是一等设计变量,别照搬”为单任务调 embedding 出最强 ID”的结论 —— 它在联合模型里会拖垮另一任务。电商里”搜索+推荐+广告”共用一套生成式 item token 时尤其要注意。
- 优先在 embedding 层做联合监督(Multi-task bi-encoder),而非在 ID/token 层做拼接或分离。“先融合 embedding 再统一量化”显著优于”各任务造专属 token 再拼前缀”,且不膨胀词表 —— 对工业级大词表很关键。
- 融合两套异构 embedding(内容/检索 vs 协同过滤)要先对齐维度,否则高维空间会主导量化;SVD 降维+相加是个便宜可用的折中。
- 量化器选型:先试 RQ-KMeans 这类轻量层次聚类,别默认上 RQ-VAE。多篇工作(本文 + EAGER-LLM)都报告 RQ-VAE 训练不稳,hierarchical k-means 更稳更强,工程落地更省事。
- 长尾 item 更依赖内容信号、热门 item 更依赖协同信号的 Head/Torso 观察,可指导电商里”对长尾商品给内容 embedding 更高权重”的融合策略。