Reinforced Preference Optimization for Reasoning-Augmented Recommendations
City University of Hong Kong × Kuaishou (香港城市大学 × 快手)
RPORec 把 LLM 的显式 CoT 推理「以文本为接口」接进推荐,而不是耦合 hidden state。两阶段迭代:阶段一冻 LLM、训一个把 CoT 当辅助信号的轻量检索头 Rechead;阶段二冻 Rechead、用它产出可验证奖励(格式/NDCG/CoT 质量)用 GRPO 反过来精炼 LLM 推理。文本接口避开了 SID 与 LLM 词表的语义鸿沟。快手广告线上 A/B(10% 流量、4000 万用户、21 亿曝光)Revenue +1.348%、ADVV +1.058%。
核心思路
把 LLM 的「显式推理(CoT)」接进推荐,业界已有两条路,但都有结构性缺陷:
- 联合优化(hidden-state 耦合):代表 R2ec,双头架构,把 LLM 隐状态直接拿去训推荐目标。问题是推荐梯度会直接改写 LLM 的内部表示,破坏(disrupt)其原生推理结构,可解释性和推理质量一起退化。
- 微调生成式:代表 ReRe(自由文本生成 + 约束 beam search)、LatentR3(把推理压进 latent space、不保留显式 CoT)。问题是「自由文本 → 离散 item ID / SID」要做近似检索或约束解码,精度受损;即使用 Semantic ID(SID),SID 空间与 LLM 原生词表之间的 tokenization 差异造成持续的语义鸿沟(semantic gap),对训练期未见过的 item 尤其差。
RPORec 的核心主张是:不要用 hidden state 当接口,用「文本」当接口。LLM 只负责产出结构化文本 <think>CoT</think><answer>item title + 属性</answer>;一个专门的检索头 Rechead 把这段文本(连同用户历史)编码成向量,与预编码好的 item 向量做点积检索。这样既保住了 LLM 显式推理的完整性(推荐梯度不碰 LLM 内部),又把检索任务交给专用模块(避开 SID/词表鸿沟)。
为了让两个模块互相协同又不互相破坏,采用两阶段迭代:先冻 LLM 训 Rechead(让 Rechead 学会用 CoT),再冻 Rechead 用它当「可验证奖励的裁判」用 GRPO 反过来精炼 LLM 的推理质量。这就是 RPORec(Reinforced Preference Optimization for Reasoning-augmented Recommendation)。
整体实现思路
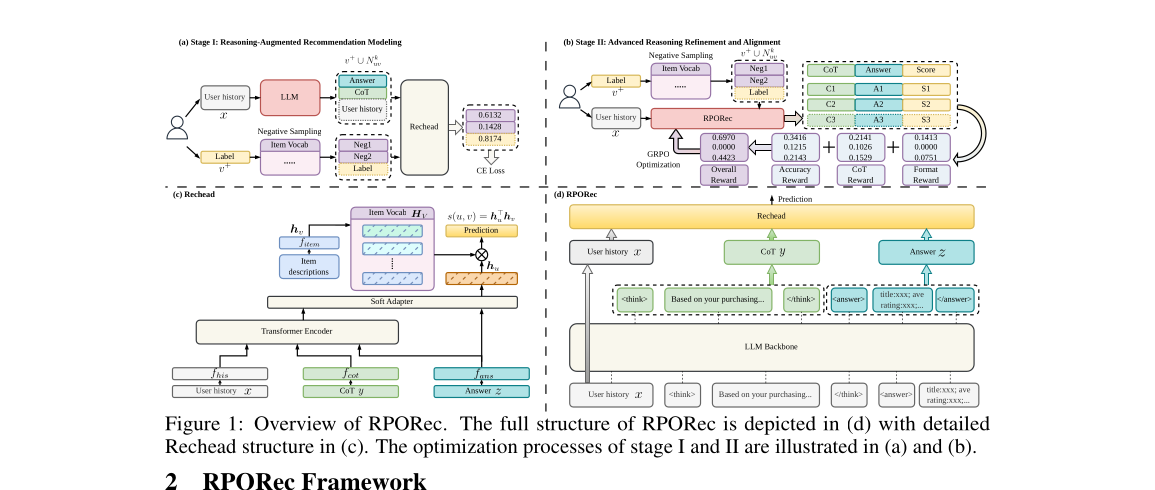
两个核心组件:
- LLM Backbone:生成结构化输出,含一段推理 segment(CoT,记为
y)和一段答案 segment(描述推荐 item 的标题与属性,记为z)。论文用 Qwen3-0.6B(小模型满足推荐时延要求)。 - Rechead:轻量检索头。输入用户历史
x、CoTy、答案z,输出用户表征h_u,与 item 向量库做点积检索。不需要做 text/token 级对齐。
训练分两阶段迭代(Algorithm 1):
- Stage I — Reasoning-Augmented Recommendation Modeling:冻结 LLM,对每个训练样本
(x, v+)用 LLM 一次性预生成 固定的y、z,然后训练 Rechead(负采样 + CE loss)建模推荐信号。Rechead 收敛后冻结。 - Stage II — Advanced Reasoning Refinement and Alignment:冻结 Rechead,把它当稳定的、任务特定的奖励来源。LLM 现场生成
y、z→ Rechead 打分 → 算多路奖励(格式 / 准确率 / CoT 质量)→ 聚合后用 GRPO 更新 LLM。
迭代设计的理由:同时优化多个模块、且 Rechead 还在变(non-stationary)会导致奖励不稳定,所以「先固定一个、训另一个」。
子模块实现(可复现细节)
Rechead 结构
输入三段文本 x(用户历史)、y(CoT)、z(答案),各自经一个编码函数 f(预训练 small sentence transformer + 前馈网络)编码到 R^d:
r_x = f_his(x), r_y = f_cot(y), r_z = f_ans(z)
item 也由 small sentence transformer f_item 从文本描述编码成 dense 向量 h_v,存进 item 词表矩阵 H_V ∈ R^{|V|×d}。
主表征选择(primary selection)——处理 CoT 与答案纠缠、或答案缺失/解析失败:
r_sel = r_z   if answer z 解析成功
      = r_x   otherwise
即答案 malformed 时回退到直接用历史建模,稳住预测。
CoT 去噪——原始 CoT 又长又不可控、噪声大,直接用无效。用一个轻量 Transformer encoder 建模三者交互、过滤无关内容,产出 reasoning-augmented 表征:
r_rea = TransformerEncoder([r_x; r_y; r_sel])
门控自适应调权(soft adapter / gating)——决定 r_rea 对最终表征贡献多少:
γ0 = γ · σ( f_gate([r_sel ∥ r_rea]) − 0.5 )
h_u = γ0 · r_rea + r_sel
γ ∈ (0,1) 是超参,σ 是 sigmoid,∥ 是拼接。门控抑制噪声/跑题 CoT,同时保留有用的关系线索。注意 r_sel(基础项)始终保留,CoT 只作为「增量增强」加进去——这是稳健性的关键设计。
检索打分——共享空间点积,取最高分 item:s(u, v) = h_u^⊤ h_v。
Rechead 优化(Stage I)
预计算每个样本的 y、z。推理时在全 item 空间 H_V 上打分;训练时穷举太贵,用负采样:对每个实例采 k 个负样本 N^k_uv,与正样本 v+ 一起算 CE loss:
L_rec = − log [ exp(s(u,v+)) / Σ_{v ∈ {v+}∪N^k_uv} exp(s(u,v)) ]
LLM 精炼(Stage II):三类、六项奖励
用 GRPO(RLVR)精炼 LLM,冻结的 Rechead 当 verifier。三类奖励:
(1) Format Reward(格式)
r_fmt = 1.0当输出严格符合<think>y</think><answer>z</answer>格式,否则0.0。- 清洁惩罚
r_clean = max(0, 1 − L_out/κ),L_out是 tag 之外文本长度,κ=100,惩罚标签外的多余内容。
(2) Accuracy Reward(准确率,ranking-based)
给定用户 u、正样本 v+ 与 k 个负样本,用 Rechead 分数在候选集 {v+}∪N^k_uv 上算 NDCG:r_ndcg = NDCG@k( rank(v+) ),rank() 是 v+ 在候选集里的排名。
(3) CoT Reward(推理质量,本文核心创新)——三个子项:
- 语义一致性
r_sim:用冻结 LLM 当 summarizer,把原 CoTy压成短 rationaleŷ(专门设计的压缩 prompt)。用预训练 sentence transformere(·)算r_sim = 1{ cos(e(y), e(ŷ)) > δ }。鼓励原 CoT 压缩后仍保留核心语义(否则说明原文有冗余/不可压)。 - 压缩奖励
r_comp:r_comp = clip( |ŷ|/|y|, 0, 1 ),偏好「难以被进一步简化」的紧凑轨迹,惩罚冗余。r_sim与r_comp合起来推 LLM 产出语义密集、信息浓缩、需要多轮总结才能压缩的 CoT。 - 熵奖励
r_ent:借 [Wang et al. 2025] 的「80/20 高熵 minority token」观察——高熵 token(尤其 top 20%)是关键「决策点」。定义 CoT 的平均熵E_μ = (1/|T|) Σ_t E_t与 top-20% 平均熵E_20%,则r_ent = E_20% − E_μ。奖励「有突出高信息 token(高 E_20%)但整体不发散(低 E_μ)」的轨迹。
聚合(要求 r_fmt 非零才生效,强制格式):
r = r_fmt · ( α0·r_fmt + α1·r_clean + α2·r_ndcg + α3·r_sim + α4·r_comp + α5·r_ent )
GRPO 部分还结合 entropy-guided optimization:token 熵 E_t = −Σ π_θ(ô_t) log π_θ(ô_t),只对 batch 内熵超过 top-ρ 阈值(ρ=20%)的 token 子集 S 做梯度更新,聚焦最有信息的决策 token、降噪降算力。
迭代算法(Algorithm 1)
- Stage I:用 LLM 一次性生成固定
y_j, z_j→ 多 epoch 训 Rechead(Eq.1-6)→ 收敛则冻结Θ*_R。 - Stage II:每 batch 现场生成
y_j, z_j→ Rechead 打分 → 算六项奖励 → 聚合 → GRPO 更新Θ_LLM→ 收敛返回(Θ*_LLM, Θ*_R)。
实验设置与结果
数据:3 个最新 Amazon Reviews 2023 子集(Musical Instruments / CDs and Vinyl / Video Games)。取最近一年、每集至少 10k 有效 item;不做 5-core 过滤(保留自然行为);历史按时间序截最近 20 个;8:1:1 划分;在全 item 集上评测。
| Dataset | Users | Items | Interactions |
|---|---|---|---|
| Musical Instruments | 15,656 | 10,320 | 34,373 |
| CDs and Vinyl | 7,701 | 12,024 | 13,435 |
| Video Games | 29,230 | 10,144 | 63,502 |
实现:4 GPU;非 LLM 方法 batch 256,LLM 方法 batch 8;所有 LLM 方法(含 RPORec)backbone 用 Qwen3-0.6B;最大生成长度 768;Rechead 的 sentence transformer 用 static-retrieval-mrl-en-v1;超参 grid search;报告 10 次运行均值。
Baseline:传统(GRU4Rec / Caser / SASRec)、生成式联合优化(TIGER / BIGRec / D3)、微调生成 & RL(S-DPO / SPRec / R2ec / ReRe / LatentR3)。
主结果(RQ1,Table 1,节选 N@10 / H@10):
| Method | MI H@10 | MI N@10 | CDs H@10 | CDs N@10 | VG H@10 | VG N@10 |
|---|---|---|---|---|---|---|
| SASRec | 0.0252 | 0.0128 | 0.0145 | 0.0073 | 0.0364 | 0.0191 |
| TIGER | 0.0243 | 0.0123 | 0.0105 | 0.0052 | 0.0245 | 0.0114 |
| SPRec | 0.0281 | 0.0143 | 0.0216 | 0.0108 | 0.0453 | 0.0211 |
| R2ec | 0.0306 | 0.0156 | 0.0190 | 0.0095 | 0.0403 | 0.0188 |
| ReRe | 0.0318 | 0.0162 | 0.0224 | 0.0115 | 0.0442 | 0.0206 |
| LatentR3 | 0.0295 | 0.0155 | 0.0224 | 0.0112 | 0.0418 | 0.0198 |
| RPORec | 0.0348 | 0.0178 | 0.0288 | 0.0131 | 0.0478 | 0.0223 |
| Improve | +9.43% | +9.88% | +28.57% | +13.91% | +5.52% | +5.69% |
RPORec 在几乎所有数据集/指标上 SOTA,CDs and Vinyl(最稀疏)上提升最大(H@10 +28.57%、H@20 甚至 +46.05%),说明显式 CoT 在稀疏场景补世界知识最有用。
消融(RQ2,Figure 2,CDs and Vinyl,看 H@10/N@10):
-cot(Stage I 去掉 CoT 输入):明显掉,证明 Rechead 真用上了 CoT 而非只靠 backbone 输出。-I(去掉整个 Stage I 和 Rechead,直接用 LLM 文本检索):大幅退化,证明自由文本不足以精确检索,Rechead 是「推理↔推荐」的必需桥梁。-fmt/-clean/-sim/-comp/-ent(逐个去 Stage II 奖励):都掉,互补。-sim掉得最多——相似度奖励是 CoT 优化的语义锚,没它r_comp会把推理压短但压跑题。-II(去掉整个 RL 阶段):急剧下降,证明 RL 精炼不可或缺。
backbone 泛化(Table 2):换 Llama3.2-1B,CDs and Vinyl 上 H@10 0.0294 / N@10 0.0128,与 Qwen3-0.6B(0.0288 / 0.0131)基本一致,说明方法不依赖特定 backbone。
Case study / CoT 质量(RQ3):用 GPT-5.4 当 judge 打两个分(Information Density、Recommendation Utility,0~1)。加 CoT reward 后单例 0.34→0.78、0.41→0.73;测试集均值 0.31→0.79、0.43→0.71。CoT 长度随训练显著下降(Figure 4,从约 700 降到 100 量级),既降噪又提推理效率。
线上 A/B(快手大规模广告系统):
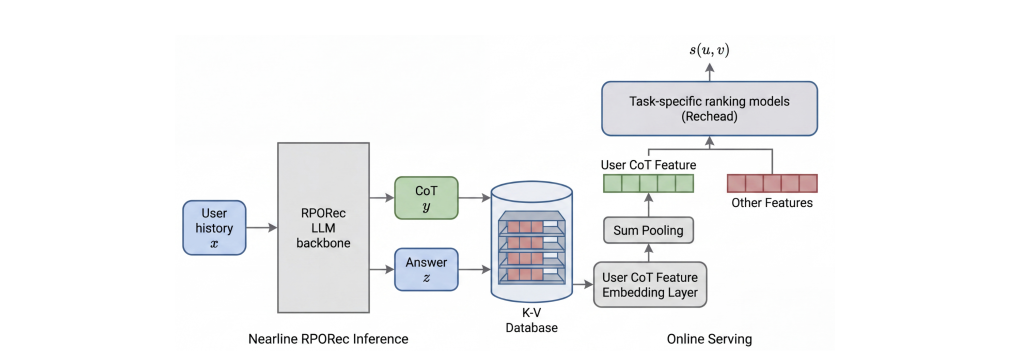
- 部署形态:LLM backbone 当近线(nearline)用户理解模块,分析用户画像属性 + 历史行为预测兴趣;抽出 CoT/Answer 存进 K-V 数据库;在线服务时 CoT token embedding 成 dense 向量,作为辅助用户特征喂给下游排序模型(线上 Rechead)。这解决了 LLM 推理时延无法直接在线的问题。
- 基线:当前生产 SOTA 排序模型,含大量手工特征 + GSU-ESU 模块,0.8B 稀疏 + 0.2B dense 参数。
- 规模:7 天、10% 流量、约 4000 万用户、21 亿广告曝光。
- 结果:Revenue +1.348%、Advertiser Value (ADVV) +1.058%。
思考与可参考价值
这篇真正解决的问题:LLM-for-Rec 落地的两大老大难——(1) hidden-state 耦合破坏推理;(2) 文本/SID 与离散 item ID 的语义鸿沟。RPORec 用「文本接口 + 专用检索头 + 两阶段冻结迭代」一次性绕开两者,思路干净。
对电商/搜推可借鉴点:
- 「LLM 当近线用户理解,CoT embedding 当排序辅助特征」是当前最现实的 LLM4Rec 上线姿势。它把 LLM 从在线主链路解耦到近线,CoT 落 K-V 库、embedding 喂排序模型,完美规避在线时延。这套架构(Figure 5)几乎可以直接照搬到电商精排/召回,对接现有 GSU-ESU/DIN 类排序模型。+1.348% Revenue 在大盘广告上是实打实的量级。
- CoT 不要直接当文本拼进去,要先去噪 + 门控调权。Rechead 的「primary selection 回退 + Transformer 去噪 + sigmoid 门控(基础项始终保留、CoT 只做增量)」是处理「LLM 生成又长又噪」的可复用范式。比直接 concat CoT token 稳得多。
- CoT 质量奖励的三件套(sim / comp / ent)可迁移。把「让 CoT 可被压缩但压缩后语义不变」当奖励(sim+comp),是一种无需人工标注的 CoT 质量信号;熵奖励
E_20% − E_μ借力 80/20 高熵 token 理论,鼓励「有决策点但不发散」。消融显示 sim 最关键——压缩类奖励必须配语义锚,否则会优化跑偏,这个教训值得记。 - 两阶段冻结迭代 vs. 联合优化:当一个组件(Rechead)会变成另一个组件(LLM)的奖励源时,「冻结一个训另一个」能避开 non-stationary reward 的不稳定。这对任何「用一个学到的模型给 RL 当 verifier」的场景都适用。
局限:
- CoT 质量仍有提升空间,作者自己点了缺多样性奖励、缺幻觉抑制。
- 离线实验只在 Amazon 三个小数据集 + Qwen3-0.6B / Llama3.2-1B 小模型,规模有限;线上是广告排序辅助特征,与离线的「检索头点积」不是同一形态,离线结论到线上的迁移性需要谨慎看。
- 阶段一 CoT 是一次性预生成、固定不变的,而阶段二才让 CoT 进化——存在「Rechead 学的是旧 CoT 分布、LLM 后来产出新 CoT 分布」的潜在 train/serve 偏移,论文用迭代缓解但未量化分析。
- 无开源代码,超参(α0~α5、γ、δ、k)论文未给具体值,复现需自行 grid search。