Recommender Systems with Generative Retrieval (TIGER)
Google DeepMind × University of Wisconsin-Madison
生成式推荐的奠基作。用 RQ-VAE 把物品内容嵌入量化成「层次化 Semantic ID」(一串由粗到细的语义码元组),再训一个 seq2seq Transformer 直接自回归生成下一个物品的 Semantic ID——彻底取代传统「item embedding + ANN 最近邻检索」。范式转变带来三件传统模型做不到的事:相似物品共享码元→知识迁移、冷启动物品可被召回、温度采样可控多样性;且 embedding 表从 N(物品数) 缩到码本大小(1024)。
核心思路
一句话问题:传统检索式推荐把 query 和 item 都映射进同一向量空间,再用 ANN/MIPS 做最近邻召回——需要给每个物品存一个 embedding(embedding 表随物品数 N 线性膨胀),且用的是随机原子 ID(atomic item ID),相似物品之间不共享任何信息,新物品(无交互历史)根本召不回来。
关键 idea:把”检索”重新定义为”生成”。给每个物品一个语义化的离散标识符 Semantic ID(一串码元,如 (5,25,55)),让一个 seq2seq Transformer 像生成文本一样,自回归地逐个码元吐出”下一个物品的 Semantic ID”。Transformer 的参数本身就成了”可微的检索索引”(differentiable index),不再需要单独建 ANN 索引。
这是从 “匹配范式”(match)到 “生成范式”(generate) 的转变,也是后续所有”生成式推荐 / Semantic ID”工作(OneRec、OneRetrieval、UniSID 等)的共同源头。
整体实现思路
两阶段 pipeline,先离线给全库物品打 Semantic ID,再训生成模型:
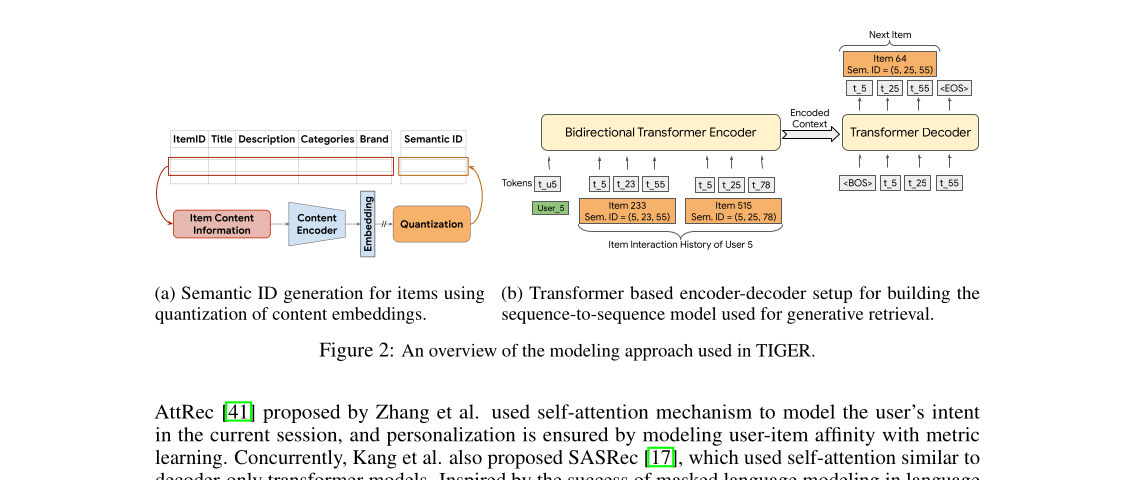
阶段1(离线,一次性):物品文本特征(标题/价格/品牌/类目)
        → Sentence-T5 编码成 768 维语义嵌入 x
        → RQ-VAE 残差量化 → m 元语义码 (c0,c1,c2) + 防碰撞第4码
        → 冻结,得到 ItemID↔SemanticID 双向查找表

阶段2(训练+推理):用户历史物品序列 → 展平成 Semantic ID token 序列
        → T5 encoder-decoder seq2seq
        → 自回归 beam search 解码出下一物品的 4 个码元
        → 查表还原成真实物品
两阶段解耦:RQ-VAE 训完即冻结,查找表生成一次后不再变;seq2seq 在固定的 Semantic ID 词表上训练。
子模块实现(可复现细节)
模块 A — RQ-VAE:把内容嵌入量化成层次化 Semantic ID
目标:把 768 维稠密内容嵌入 x 压成一个由粗到细的码元组,且满足”内容相似 → 码元重叠”。例如 (10,21,35) 应比 (10,23,32) 更接近 (10,21,40)。
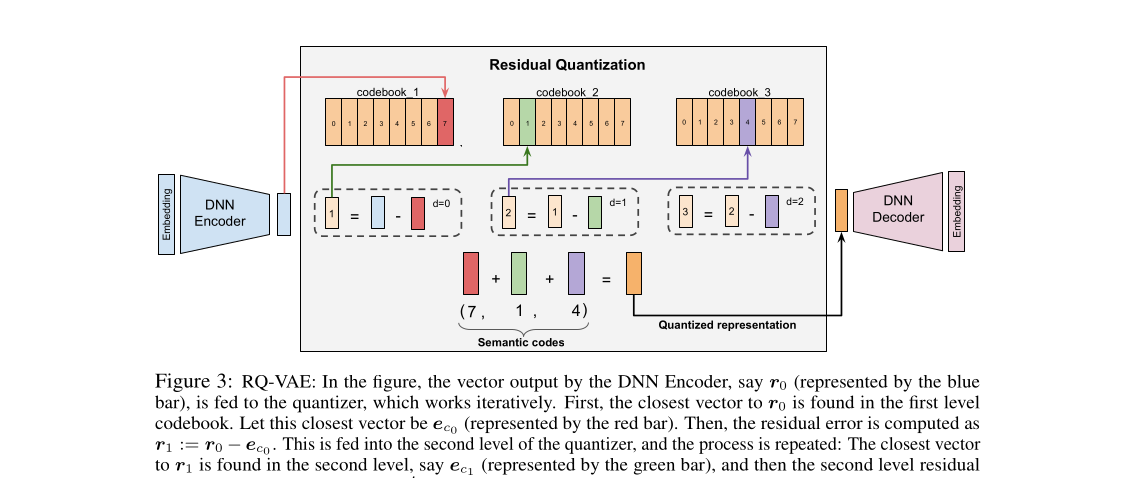
残差量化流程(核心,逐级递归):
- 编码:
z = E(x),初始残差r0 := z - 每一级 d 有独立码本
C_d = {e_k}_{k=1..K}:- 取码元
c_d = argmin_k ‖r_d − e_k‖(找最近码本向量) - 更新残差
r_{d+1} = r_d − e_{c_d}
- 取码元
- 递归 m 次 → 得到 m 元 Semantic ID
(c0,…,c_{m-1}) - 量化重建
ẑ = Σ_d e_{c_d},再过 decoder 还原x̂
为什么”残差”+“每级独立码本”:残差范数逐级减小,天然形成”粗→细”层次——第 1 码 = 高层类目,第 2/3 码 = 细分。这正是后面冷启动/多样性能力的来源。用 m 个 K 大小的码本(而非 1 个 mK 码本)就是为了让不同粒度用不同码本。
损失函数:
L(x) = L_recon + L_rqvae
L_recon = ‖x − x̂‖²
L_rqvae = Σ_d ‖sg[r_d] − e_{c_d}‖² + β·‖r_d − sg[e_{c_d}]‖²
sg[·] 是 stop-gradient;前项更新码本向量靠近残差,后项(commitment loss)拉残差靠近码本,β=0.25。k-means 初始化码本(用首个 batch 的聚类质心)防止 codebook collapse(大量输入塌到少数码本向量)。
关键超参(可复现):
| 项 | 值 |
|---|---|
| 内容编码器 | Sentence-T5,输出 768 维 |
| DNN encoder | 512→256→128→latent 32,ReLU |
| 量化级数 m | 3(+1 防碰撞码 = 4) |
| 每级码本 K | 256,码本向量维度 32 |
| β | 0.25 |
| 训练 | Adagrad,lr 0.4,batch 1024,20k epochs(码本利用率 ≥80%) |
碰撞处理:多个物品可能量化到同一组 (c0,c1,c2),在末尾追加一个唯一第 4 码区分(如 (7,1,4,0)、(7,1,4,1))。即使无碰撞也补 0。最终每个物品 = 长度 4 的 Semantic ID。
模块 B — seq2seq 生成式检索
输入构造:把用户历史按时间排序,每个物品替换成它的 4 个码元,展平成一长串 token;序列最前面加一个 user ID token(原始 user id 用 Hashing Trick 映射到 2000 个桶,控制词表)。历史最多取 20 个物品。
词表:256×4 = 1024 个语义码元 token + 2000 个 user token。注意——embedding 表只需为这 1024 个码元学嵌入,而非为 N 个物品各学一个,这是相比传统模型的内存关键优势(1024·d vs N·d)。
训练目标:标准 seq2seq 交叉熵——给定历史 token 序列,预测下一物品的 4 个码元 (c_{n+1,0},…,c_{n+1,3})。
架构超参:T5X 框架,encoder/decoder 各 4 层,6 个 attention head(dim 64),d_model=128,MLP=1024,dropout 0.1,ReLU,约 13M 参数。训练 200k steps(Beauty/Sports)/ 100k(Toys),batch 256,lr 前 10k step 为 0.01 后接 inverse-sqrt 衰减。
推理:beam search 自回归解码出 4 个码元 → 查 SemanticID→ItemID 表还原物品。
实验设置与结果
数据:Amazon Product Reviews 三个类目 Beauty / Sports / Toys;leave-one-out(末位测、次末位验);过滤 <5 条评论的用户;历史截断 20。 指标:Recall@5/10、NDCG@5/10。
| 数据集 | 指标 | 次优 baseline | TIGER | 提升 |
|---|---|---|---|---|
| Beauty | NDCG@5 | 0.0249 (SASRec) | 0.0321 | +29.0% |
| Beauty | Recall@5 | 0.0387 (S³-Rec) | 0.0454 | +17.3% |
| Toys | NDCG@5 | 0.0306 | 0.0371 | +21.2% |
| Sports | NDCG@5 | 0.0161 | 0.0181 | +12.6% |
消融 1 — ID 生成方式(最关键证据):RQ-VAE SID ≫ LSH SID ≫ Random ID。以 Beauty NDCG@5:Random 0.0205 → LSH 0.0259 → RQ-VAE 0.0321。说明收益来自”内容语义 + 非线性量化”,不是 seq2seq 结构本身。
消融 2 — 层数:3/4/5 层差异很小(Beauty NDCG@5 0.0306→0.0321→0.0321),模型对规模不敏感。
新能力(传统 ANN 模型做不到):
- 冷启动:用 RQ-VAE 给未见过的新物品也能算 Semantic ID,靠前 3 码做 prefix 匹配召回;引入超参 ε 控制召回里新物品比例,ε≥0.1 时全面超过 Semantic_KNN。
- 可控多样性:解码时温度采样,Entropy@10 从 T=1.0 的 0.76 升到 T=2.0 的 1.38;且因 Semantic ID 有层次,采第 1 码 = 跨粗类目多样,采第 3 码 = 类目内多样。
- Invalid ID:自回归可能生成不存在的 ID,但 top-10 仅 0.1%–1.6% 无效(4 万亿 ID 空间里只有 1–2 万有效),加大 beam + 过滤即可。
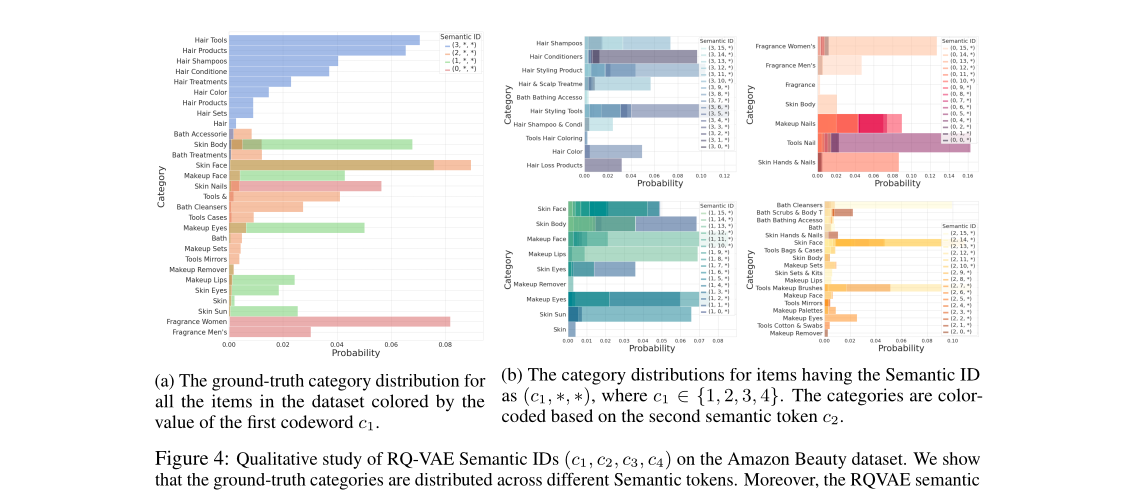
层次性可视化(下图):第 1 码对应高层类目(c1=3 几乎全是”Hair”),第 2/3 码细分——证明 RQ-VAE 学到的 Semantic ID 确实是语义层次结构,而非随机编码。
思考与可参考价值
为什么重要:TIGER 是”生成式推荐”这一整条技术路线的奠基论文——后续 OneRec、OneRetrieval、UniSID、Better-Generalization-with-SID 等都建立在它的两个核心构件(RQ-VAE Semantic ID + seq2seq 生成)之上。理解它是理解本 topic 下绝大多数论文的前提。
局限(要清醒看):
- 推理贵:beam search 自回归解码比 ANN 一次最近邻慢得多,论文自己承认”没优化推理效率”,工业大规模落地是后来者(如 OneRetrieval 的可编辑码本、各家 serving 优化)要解决的问题。
- 只在 10K–20K 物品的学术数据集验证,亿级物品的码本容量/碰撞/长尾冷启动 embedding 学不动等问题没碰(后续工作证明这是真痛点)。
- Semantic ID 一旦冻结就静态:新词/新品牌进不来要重训 RQ-VAE——这正是 OneRetrieval「可编辑码本」要补的洞。
- RecLoop/热度偏置:码本可能被高频物品主导,长尾物品码元学不充分(本文未深究)。
对电商/搜索推荐可直接借鉴:
- Semantic ID 作为统一物品标识:把”内容嵌入→离散码元”当成召回/排序/广告的通用物品表示,能跨任务共享、缓解冷启动——这是字节 OneRec 系、快手 OneSearch 系的共同基建思路。
- RQ-VAE 的层次性可被利用:粗码做类目级召回/多样性控制,细码做精排,是个被反复复用的设计。
- embedding 表压缩:当物品达亿级、为每个物品存 embedding 不可行时,“只为码元存 embedding”是实打实的内存解法。
- 但落地前必须先解两道工程题:自回归解码延迟、以及 Semantic ID 的”可编辑性/可更新性”(否则运营无法实时注入新品/活动词)。