Recommendation as Generation: Unifying Personalized Video Generation and Recommendation at Industrial Scale
Kuaishou Technology × 北航
提出「推荐即生成」(RaG)范式——把推荐从"在固定视频池里检索排序"改为"按推断出的用户兴趣现场生成个性化视频"。桥梁是解耦语义ID(D-SIDs,内容/风格分离);真正训练的是 GRM/IM/VGAs 三组 LLM + SCRL/GDPO 约束式联合 RL,底层文生视频是自研预训练工具。快手广告线上 A/B 增收 +5.46%(其中纯生成贡献 +1.87%)。
核心思路
传统短视频/广告推荐是 content-first:先有一个固定的、预生产好的视频池,DLRM 把用户兴趣映射到池中已有 item 做检索+排序。这种范式对长尾、细粒度、动态兴趣覆盖不足——你想要的那条视频可能根本不存在于池里。
RaG 把范式翻过来:推荐 = 按推断出的用户兴趣,现场生成一条个性化视频(interest-conditioned video generation)。
关键认知(避免误读):这不是一个端到端的视频扩散大模型,而是一条 LLM 智能体链路。真正被训练/对齐的是三组 LLM——GRM(生成式推荐)、IM(指令模型)、VGAs(视频生成智能体)——以及把它们串起来联合优化的 SCRL/GDPO 约束式强化学习。底层把指令真正渲染成像素的「文生视频 / 图生视频」是自研预训练工具,论文未展开其内部结构。
把推荐域(离散 SID)和生成域(连续视频)缝在一起的接口,是 解耦语义ID D-SIDs:把每条视频拆成「内容码 (卖什么:实体/主题)」和「风格码 (怎么呈现:风格/节奏/氛围)」两套正交的离散 token——内容与风格解耦,使得”换风格不换内容""命中内容补风格变体”成为可控操作。
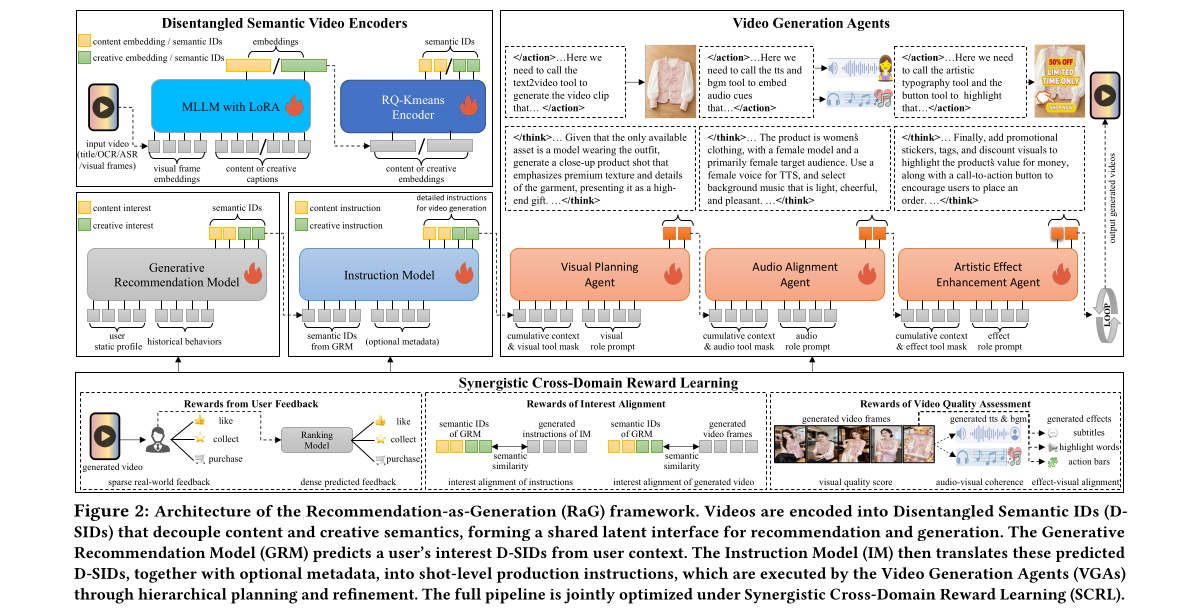
整体实现思路(端到端 pipeline)
用户上下文 c_user
  │  [GRM: 实时 ~100ms, 7层 Transformer decoder, beam=512, 130 QPS]
  ▼
用户兴趣 D-SIDs = [ s_content^{1:L} ; s_creative^{1:L} ]   (自回归生成的离散兴趣 token)
  │  [reverse RQ-Kmeans 还原连续向量 e_content/e_creative
  │   + 可学习投影器 φ 对齐到 LLM 空间: h_D-SIDs = φ(e), 可选元数据 D_meta]
  ▼
IM (Qwen3-8B, ~2.5s)  ── 产镜头级"生产脚本"(场景构图/运镜/节奏/影视风格)
  │  [VGAs: Qwen2.5-32B 共享骨干]
  ▼
VGAs (VPA 视觉规划 → AAA 音频对齐 → AEEA 艺术增强, 有界反思 ≤2 轮, ~180s)
  │  调"自研预训练 t2v/i2v + 外部音频/特效 API"
  ▼
个性化视频 V
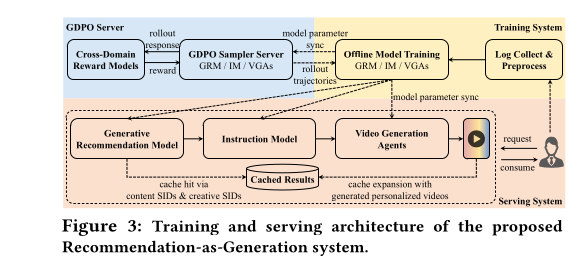
在线推理:SID 索引缓存分层命中策略(工业落地关键,把”生成”和”实时服务”解耦):
- Case 1 — 内容 SID 命中:直接返回预生成视频,近零延迟。若只命中内容 SID(风格不同) → 返回内容一致的缓存视频,同时异步补生成对应风格变体入库。
- Case 2 — 内容 SID 未命中:用最近邻 SID 的现成视频先顶上(保障延迟),并把该 SID 入队优先生成,结果回填缓存。
- 净效果:生成与实时服务完全解耦,个性化视频库随流量滚雪球式扩充,命中率越来越高——这就是为什么 180s 的重生成能在 4 亿 DAU 的广告流上线。
子模块实现(可复现细节,重点)
1. D-SIDs 构建 — 解耦语义视频编码 + 残差量化
目标:把一条视频压成两套正交的离散码,作为推荐域与生成域的统一接口。
- 视觉编码:Qwen2.5-VL-7B-Instruct 提取视觉 token 。
- 解耦 dense captioning:内部描述模型给每条视频生成两段文本——内容描述 (实体/主题) 与创意描述 (风格/节奏/氛围):。
- 多模态融合 → 表征:把 与各模态文本 token 一起喂回 VLM,取最后一层末 token hidden state,L2 归一化得 。
- 训练目标(解耦表征):
- 每模态对比损失 。
- 正交约束(防内容/风格串味) 。
- 总损失 。
- 离散化(RQ-Kmeans):对每个 独立做残差量化 K-Means, 层、每层码本 8192,得 。最终 D-SIDs ,共 个 token。
效果(Table 2):语义检索 R@1=0.896(基线 Qwen2.5-VL 0.769);离散化碰撞率 2.62%(QARM 18.24%)、压缩失真 1.02(QARM 1.14)——既检索得准、又量化得稳。
2. GRM — 生成式推荐模型(在线,~100ms)
做什么:自回归地从用户上下文预测兴趣 D-SIDs:。
架构/部署:7 层 Transformer decoder(hidden 768, FFN 3072, 12 heads, vocab 8192), FlashAttention;推理 beam=512, 130 QPS,作为唯一实时模块在线服务。后续进 GDPO 联合 RL。
3. IM — 指令模型(Qwen3-8B,~2.5s)
把离散兴趣 SID 翻成 VGAs 能执行的「镜头级生产脚本」。
- 输入:reverse RQ-Kmeans 还原的连续嵌入 ,拼成 ,经可学习投影器对齐到 LLM 空间 ;可选元数据 token (产品信息,缺失则 mask)。
- 输出:镜头级脚本(场景构图/运镜/节奏/影视风格),长度 。
- 监督:Gemini 2.5 Pro 蒸馏—— 作目标(式 10)。
- 目标:next-token (式 12)。
- 三段训练:① 冻结 LLM,只训投影器 做对齐 → ② 联合微调 +LLM → ③ GDPO 强化。
- 选型:8B + 1M 样本保真度 0.8212;32B 0.8096 但成本高 → 选 8B。
4. VGAs — 视频生成智能体(Qwen2.5-32B,三角色共享骨干,~180s)
三个角色共享同一个 Qwen2.5-32B 骨干,靠状态里的 role prompt + attention mask 区分:
- VPA 视觉规划 → clip 级 storyboard(场景切分/布局/时间边界) ;
- AAA 音频对齐 → 语音 + 音乐时间对齐 ;
- AEEA 艺术增强 → 字幕/特效/转场/CTA 。
真渲像素:(式 16),其中 调”自研预训练 t2v/i2v 模型 + 外部音频/特效 API”,内部未披露。
- 序列化状态 (式 14):/ 是共享前缀, 为前面 agent 的输出累积。
- KV-Cache 复用:状态 append-only + 共享骨干 → 每个下游 agent 只需编码自己的 role prompt,省掉重复前缀编码,这是把多 agent 延迟压到 180s 的关键。
- 有界反思:Observe→Think→Act 最多 2 轮再规划。
- 训练:高质量视频整理出 agentic 监督数据做 SFT,再 GDPO。
5. SCRL + GDPO — 跨域协同奖励的约束式 RL
三类奖励:
- 质量 (视觉美学/音画同步/特效对齐,各由 Transformer 奖励模型给);
- 对齐 (SID↔指令、SID↔生成视频 的语义相似度);
- 反馈 (真实点击/赞/购买 稀疏 + 排序模型预估 稠密)。
约束式复合奖励(用户反馈为主目标,质量/对齐为约束,式 17):
- 阈值 ; 越大约束越严:VGAs (最严) > IM > GRM (最松)——越靠近生成端、越要守质量底线。
- 乘子 由 PID 控制器在线更新(约束违反就加压)。
- 组解耦归一化 (式 18)。
- GDPO 目标(GRPO 风格,式 19): + clip + KL。
Stage 3:GRM / IM / VGAs 三者都用 GDPO 联合更新——这就是 “Synergistic”(协同) 跨域优化:推荐域和生成域不是各练各的,而是被同一套用户反馈奖励端到端拉齐。
实验设置与结果
平台:快手广告,>4 亿 DAU,主指标=广告收入。评测用三裁判集成(GPT-5.1 + Gemini-2.5 + Claude-4.5),外加 20 人 ×50 = 1000 对人工 GSB 盲评。
模块延迟(Table 5) — 只有 GRM 实时,其余近线:
| 模块 | D-SIDs(近线) | GRM(在线) | IM(近线) | VGAs(近线) |
|---|---|---|---|---|
| 延迟 | ~4s | ~100ms | ~2.5s | ~180s(瓶颈) |
线上 A/B(Table 1,baseline=生产 DLRM) — 逐级拆解增量:
| 方法 | vs DLRM | vs GRM |
|---|---|---|
| GRM | +3.526% | — |
| GRM + D-SIDs | +4.460% | +0.902% |
| 完整 RaG (GRM+D-SIDs+IM+VGAs+SCRL) | +5.462% | +1.870% |
纯”生成”链路(IM+VGAs+SCRL)在已经很强的 GRM 之上还能再贡献 +1.87% 收入——这是”推荐=生成”首次在工业规模被线上验证有正收益。
D-SIDs 质量(Table 2):R@1/5/10 = 0.896/0.985/0.994(基线 0.769);碰撞 2.62%(QARM 18.24%);失真 1.02(QARM 1.14)。
VGAs vs 工作流基线(Table 3):
| 指标 | 工作流基线 | VGAs |
|---|---|---|
| 自动评分(均值) | 62.4 | 71.3(+14.3%) |
| 自动胜率(GSB) | 28.7% | 70.1% |
| 人工胜率 | 34.4% | 52.9% |
奖励消融(Table 4):加各质量子奖励,对应维度自动胜率——视觉 29.3→50.7%(+21.4pp)、音频 24→48%(+24pp)、特效 22.7→41.3%(+18.6pp)、三合一 37.3→56%(+18.7pp);再加对齐奖励,对齐分 0.707→0.828。
思考与可参考价值
创新:① 首次把”推荐=生成内容”做成工业规模闭环并线上验证(纯生成 +1.87% 收入);② D-SIDs 内容/风格解耦做推荐↔生成的统一接口;③ 多智体共享骨干 + KV-Cache 复用压多 agent 延迟;④ 约束式 GDPO(收入为主目标、质量/对齐为约束、阈值随模块层级收紧)。
局限:VGAs 180s 只能近线(做不到真正实时按需生成,作者自认是瓶颈,靠 SID 缓存兜底);全 Qwen 系,未验证跨模型族;重度依赖 LLM-judge 评测(奖励模型与评测可能重叠、有过拟合风险);现场生成广告的真实性/合规/版权完全回避;只证广告单场景,泛化未知。
对电商 / 搜推 / Agent 的可借鉴点:
- D-SIDs 解耦”卖什么 / 怎么呈现” 可直接迁移到电商素材生成(同一商品换风格出多套创意)。
- 约束式奖励”收入为主、质量/合规为约束(不许跌破及格线)“比简单加权和更稳——多目标排序/生成都适用。
- 多智体共享骨干 + KV-Cache 复用 是压低多 agent 链路延迟的现成范式。
- SID 索引缓存分层命中 + 异步预生成 是解耦”重生成 vs 实时服务”的工业架构模板——任何”想上线但单次推理太慢”的生成式服务都能套。