RecGPT-V3 Technical Report
Taobao (阿里淘天)
淘宝 RecGPT 系列第三代:把 LLM 推荐从「无状态一次性重扫全历史」升级为「有状态记忆驱动」。三件事——Memory Hub 把长期行为蒸馏成可增量演化的结构化记忆单元(用户建模算力 −55.8%);Hybrid-modal 基座让 LLM 在文本 tag 之外原生生成 Semantic ID,打通 tag→item 的有损瓶颈;Latent Intent Reasoning 把 ~2800 token 的显式 CoT 内化成 10 个可解码 latent token(200:1)。线上 A/B 相对 V2:IPV +1.28%、CTR +1.00%、TC +1.97%、GMV +3.97%,端到端算力 −52.4%。
核心思路
问题:LLM 驱动的推荐系统(RecGPT-V1/V2 已在淘宝线上)规模化运营后暴露三个结构性瓶颈:
| 挑战 | 具体表现 | |
|---|---|---|
| C1 | 无状态行为建模 | 每次请求从零重扫全量行为序列(高活用户 ~55K token),Global Planner 独占 agentic 意图分析 ~95% 算力,且反复重新发现「复购周期 / 品牌忠诚 / 季节漂移」这些早已算过的模式 |
| C2 | tag→item 信息瓶颈 | LLM 只输出自然语言 tag 交给下游检索。粗 tag(如「旋转可调羽毛球拍支架」)对应一大堆异质候选,无法传递 item 级细粒度证据 |
| C3 | 显式推理低效 | CoT 平均 ~3000 token 串行自回归生成,十亿用户 + 高 QPS 下延迟与算力不可承受 |
关键 idea:分别用状态化(记忆)、换接口(离散 item 标识)、换介质(latent token) 三招正面拆解,且三者收益可叠加——最终做到「精度和算力同时改善」而非二选一。
整体实现思路
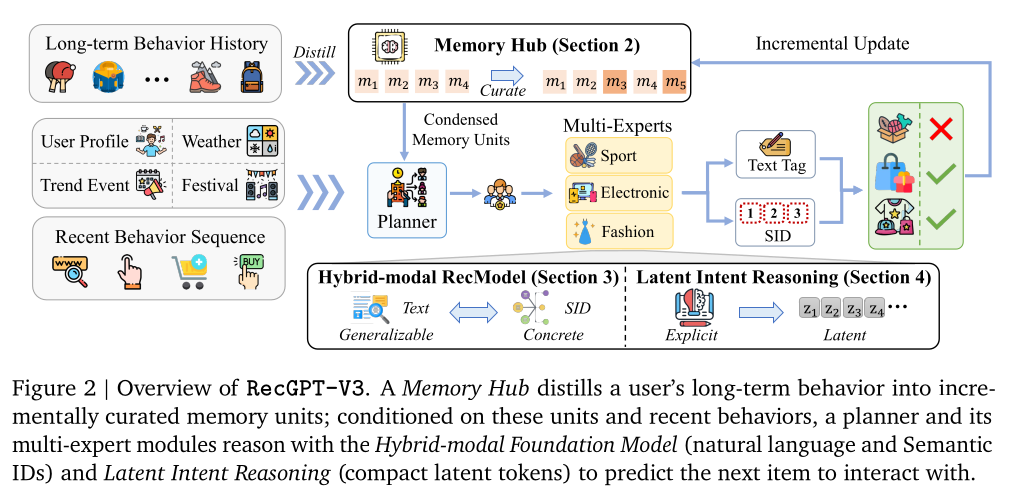
端到端 pipeline:
长期行为历史 B (~55K token)
   │ ① Structured Behavior Compression(一次性)
   ▼
结构化记忆单元 M = {m_1 … m_K}   ←── ② Evolving Memory Curation(每 2 个月增量)
   │                                     ↑
   │                             近期行为增量 ΔB
   ▼
Global Planner(输入 = 压缩记忆 M + 近期增量 ΔB,不再是全量 B)
   │  拆解成多个 intent persona,分派给多专家(Sport / Electronic / Fashion …)
   ▼
Hybrid-modal Foundation Model(Qwen3-14B + 65,536 个 SID token)
   │  + Latent Intent Reasoning:10 个 <cot> latent token 取代 ~2800 token 显式 CoT
   ▼
输出双通道:文本 Tag(泛化) + Semantic ID(具体)
   ▼
混合检索模型(tag embedding ‖ SID embedding → Target Attention)→ 候选 item
   ▼
生产排序模型 → 曝光;其 CTRScore 反过来作为 RLRF 的奖励信号
三个模块的分工是正交的:Memory Hub 改的是输入(省 Planner 算力),Hybrid-modal 改的是输出接口(提检索精度),Latent Reasoning 改的是中间过程(省专家侧延迟)。
子模块实现(可复现细节)
模块 A — Memory Hub
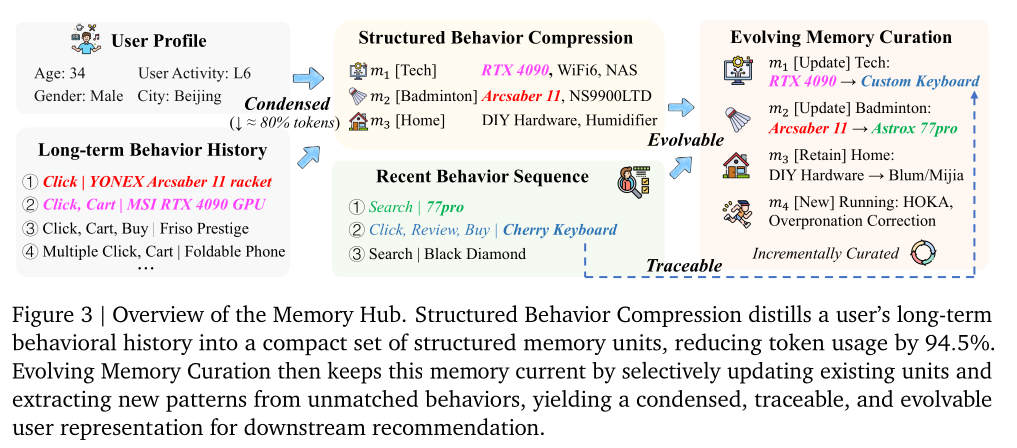
A.1 Structured Behavior Compression(初始压缩,跑一次)
- 输入:用户全量行为序列
B = {b_1, …, b_N} - 输出:结构化记忆单元集合
M = {m_1, …, m_K},K ≪ N - 形式化:
F_φ : B → M,M = F_φ(B)(φ 是 LLM)
每个记忆单元的 schema(两个核心字段 + 四个元数据):
| 字段 | 说明 | 示例 |
|---|---|---|
p_k Behavior Pattern | 分类标签,取自数百个预定义电商行为原型的 taxonomy;无现成模式匹配高置信簇时允许受控扩展 | K-pop Fandom |
s_k Preference Summary | 自然语言描述该模式下的偏好 / 趋势 / 消费特征 | 「某女团深度粉丝,从专辑预售到周边收集到线下演出全链路参与,重视收藏完整性与保存」 |
| Representative Indices | 溯源指针——指回原序列的整数下标 | 549, 553, 558, 563, … |
| Preferred Brands | 品牌偏好 | SingBA, 时代良品, 珍琢, … |
| Temporal Activity | 时间活跃画像 | 「2023-03 首现,2023-06 与 08–10 达峰」 |
| Timestamp | 创建时间 | Created: 2023-10-31 |
注意这里存的是整数指针而非行为原文——这是 token 压缩率能到 94.5% 的关键,也是溯源准确率(95.27%)之所以重要的原因。
A.2 Evolving Memory Curation(增量演化,线上每 2 个月一次)
- 输入:上一轮记忆
M^(t)+ 区间[t, t+δ)新增行为ΔB^(t,t+δ) = {b_{N+1}, …, b_{N+ΔN}} - 输出:
G(M^(t), ΔB^(t,t+δ)) → (M^update, M^new),最终M^(t+δ) = M^update ∪ M^new - 关键约束:G 不访问全量 B,只吃压缩记忆 + 增量
两步操作(共享同一次 forward,不做多轮串行调用):
(1) 选择性更新
m_k^(t+δ) = Update(m_k^(t), ΔB_k^rel)   if ΔB_k^rel ≠ ∅
          = m_k^(t)                     otherwise
其中 ΔB_k^rel ⊆ ΔB 是与 m_k 语义相关的新行为子集。原则:有证据才更新,无证据不打扰。
(2) 新模式抽取
ΔB^novel = ΔB^(t,t+δ) \ ΔB^rel,   其中 ΔB^rel = ∪_k ΔB_k^rel
M^new    = Extract(ΔB^novel)      (无连贯新模式时为 ∅)
语义连续性设计(重要):每次 Update 是把该单元整段重新合成为当前状态的快照,而不是把新行为追加到旧摘要后面——否则陈旧偏好和新兴偏好会在同一个单元里堆叠。例:婴儿护理 单元从「0–6 月奶粉尿布」整体改写成「6–12 月,新增学步车与幼儿玩具」,而非两段并列。
| 操作 | 触发条件 | 例 |
|---|---|---|
| Update | 有相关新行为 | Infant Care:0–6 月 → 6–12 月 |
| Retain | 无相关新行为 | Outdoor Running 原样不动 |
| New | 行为不属于任何已有单元 | Pet Parenting(首次养宠) |
模块 B — Hybrid-modal Recommendation Foundation Model
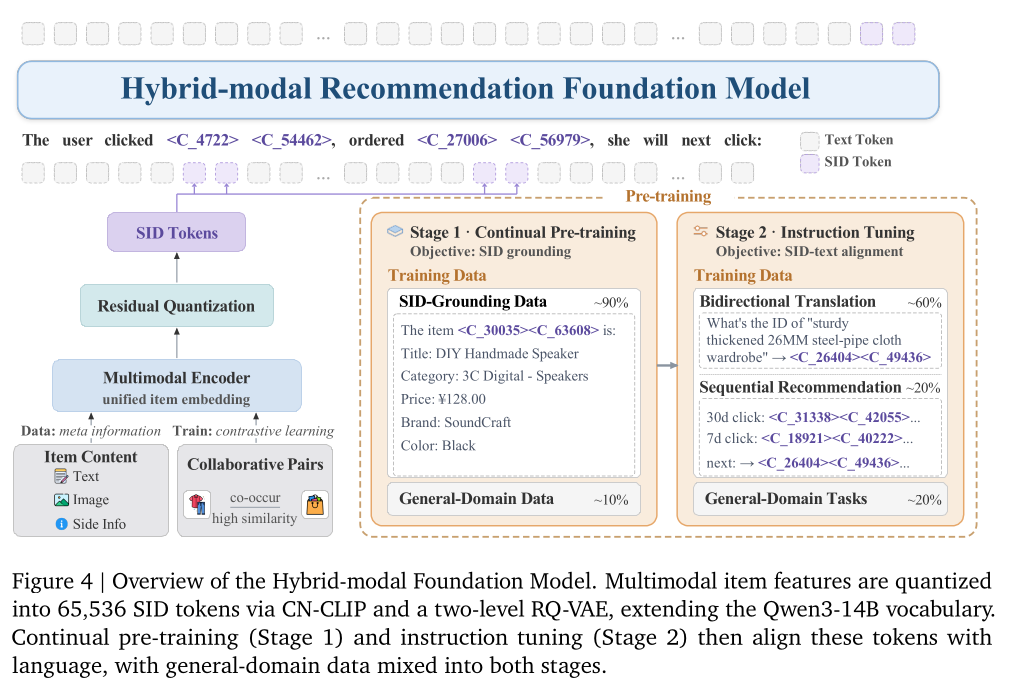
B.1 Hybrid Tokenization(SID 怎么造)
Step 1 — 多模态 item 表征(对比学习)
- 用 CN-CLIP(记作
E)分别编码:H_text^i = E(I_text^i)、H_image^i = E(I_image^i);side info 先转成文本再编码得H_side^i - 用 Q-Former(记作
F)融合:H^i = F(E(I_text^i), E(I_image^i), E(I_side^i)) - 正样本挖掘:行为日志中高频共现的 item 对作候选,再用多模态相似度过滤掉低相似的伪共现
- 损失(融合级 + 各模态级同时做):
L_InfoNCE = f(H^i, H^{i+}, H^{i-}) + f(H_text^i, H_text^{i+}, H_text^{i-}) + f(H_image^i, H_image^{i+}, H_image^{i-})
批内其他 item 作负样本。论文明确指出:这一步的作用是让后续量化稳定——well-separated 的嵌入空间才能防止 RQ-VAE 码本塌缩。
Step 2 — 残差量化(RQ-VAE)
- 两级码本,每级 32,768 → 合计 65,536 个新 token
<C_0> … <C_65535> - 一个 item 的 SID = 两个码,如
<C_18921><C_40222>:首码 = 粗粒度语义簇,次码 = 簇内细分 - 设计效果:语义相近的 item 共享前缀,模型可借此在相关 item 间泛化;两级也把新增词表规模控制在可接受范围
B.2 两阶段预训练(backbone: Qwen3-14B)
新 SID token 追加到原词表,嵌入随机初始化后学习。
Stage 1 · Continual Pre-training(目标:SID grounding)
- ~90% SID-grounding 数据:把 SID 与 item 属性配成自然语言陈述,让模型能只凭 SID 还原 item 内容:
The item with Semantic ID <C_18921> <C_40222> has the following information: Title: Insulated Lock Rod Insulated Construction Scaffolding ... Category: Scaffolding. - ~10% 通用域数据:数学推理、代码、科学文献、医学文本、指令跟随——防灾难性遗忘
Stage 2 · Instruction Tuning(目标:SID–text 对齐)
| 类别 | 任务 | 映射 | 占比 |
|---|---|---|---|
| 双向翻译(~60%) | sid2title | sid → title | 13.8% |
| title2sid | title → sid | 14.7% | |
| sid2tag | sid → tag | 11.5% | |
| tag2sid | tag → sid | 6.2% | |
| sid2cmd | sid → 品类 | 13.8% | |
| 序列推荐(~20%) | sid2sid | 点击史 → 下次点击 SID | 20.0% |
| 通用域(~20%) | 推理 / 实体抽取 / 电商任务 | — | ~20% |
sid2sid 的输入按多粒度时间窗组织(3 天 / 2 天 / 1 天 / 12 小时 / 1 小时),且完全不给文本描述——这是「模型是否真的把协同过滤信号内化进 SID token」最直接的证据。通用域那 20% 的作用被明确标注为「保住 JSON 格式正确性与多约束指令跟随」。
模块 C — Latent Intent Reasoning
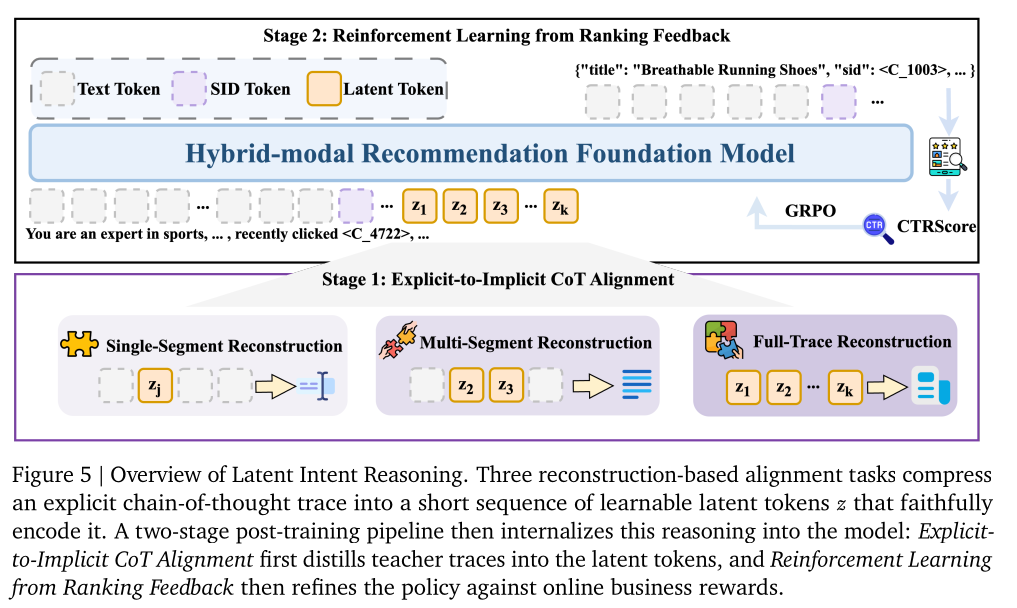
C.1 压缩机制
原来的显式分解:
p_θ(R, y | x) = p_θ(R | x) · p_θ(y | x, R)
x = Planner 给的 persona + 近期点击史(每个 item 用 SID + 短标题表示),R = N 步换行分隔的推理链,y = 输出 item tag。成本全压在 R 上(串行 decode,长度远超 y)。
替换为 latent 分解:
p_θ(z, y | x) = p_θ(z | x) · p_θ(y | x, z), z = (z_1, …, z_K), K ≪ N
确定性位置划分:把 R 切成每段至多 C 步的 K 个连续不重叠段,z_j 编码 R_j:
K = min(⌈N / C⌉, K_max)
生产配置 C = 20, K_max = 10 → ~2700 token 的 trace 压到 ≤10 个 latent token(≈200:1)。trace 不足 C·K_max 步时尾部 latent 覆盖更短/空段;超出则只覆盖前 K_max 段(截断)。
C.2 训练 latent token(两步)
(a) Warm-up:随机选 trace 的若干连续片段替换成 latent token 形成混合 trace R̃,在 w = (x, R̃, y) 上做标准自回归损失
L_warm = − Σ_{t ∈ T} log p_θ(w_t | w_<t)
T 只索引存活的文本 token,latent 位置仅作上下文参与。作用:把分布外的随机初始化嵌入拉回预训练表示空间,给后续段级对齐一个良态初始化。
(b) 多粒度掩码重建:给掩码集合 J ⊆ {1..K},未掩码段留文本、掩码段换成 z_j:
c(J) = (x, e_1, …, e_K, y),   e_j = z_j  if j ∈ J
                                   = R_j  otherwise
L(J) = − log p_θ(R_J | c(J), P)      # P 是任务提示,指明要恢复哪些位置
三个任务只在 J 的取法上不同:
| 任务 | J | 作用 |
|---|---|---|
| Single-Segment | {j} | 上下文最丰富,重建最容易 → 给每个 latent 一个逐位置的编码信号,把它绑定到自己那一段 |
| Multi-Segment | 2 ≤ |J| < K | 掩码跨段边界 → 逼每个 token 在部分上下文缺失时仍然有信息量 |
| Full-Trace | {1..K} | 上下文退化成 (x, z, y) → 逼整个 latent 序列足以恢复完整推理链 |
Full-Trace 这一项就是「可解码性」的显式训练约束:z 被训成 R 的充分编码,因此线上需要时可以从 (x, z, y) 反解出人类可读 rationale(附录 C 给了三个生产 case)。
C.3 后训练两阶段
Stage 1 · Explicit-to-Implicit CoT Alignment
- 推理蒸馏:用 DeepSeek-V3.2 作教师生成显式 CoT(平均 ~2300 token)做 SFT
- Latent 内化:用 §C.2 的课程压成 latent。数据配比:
| 任务 | 占比 |
|---|---|
| ❶ 推理对齐(single 6.45% / multi 6.56% / full-trace 8.42%) | 21.43% |
| ❷ 通用推理(防遗忘) | 69.58% |
| ❸ Tag 预测(对齐部署格式) | 8.43% |
Tag 预测那一项只监督输出 token,刻意不碰 latent 位置——避免 latent 表示塌缩。
Stage 2 · RLRF(Reinforcement Learning from Ranking Feedback)
V2 用 HitRate 作奖励有两个毛病:奖励稀疏(GRPO 组内 rollout 同分 → advantage 归零 → 无梯度)与链路不一致(离线代理 ≠ 真实 serving 结果)。V3 把奖励直接从生产排序模型读:
r_ctr(y) = (1/K) · Σ_{k=1..K} s_k # s_k = 检索到的 item 中第 k 大的 CTRScore,K = 100
即:用生成的 m 个 tag 去检索候选 → 每个候选用生产 ranker 打分 → 取 Top-100 均值。既稠密又与真实链路对齐。
保留 V2 的 Constrained Reward Shaping——对齐度 / 多样性 / 长度作为门控而非加权项,全部达标 r_ctr 才生效:
R(y) = r_ctr(y) · 1[align(y) ≥ τ_align] · 1[div(y) ≥ τ_div] · 1[len(y) ≥ τ_len]
align 由人类偏好对训练的奖励模型给出。策略用 GRPO 优化(组内相对优势)。
模块 D — 混合检索模型(附录 B)
上游现在输出双通道,下游得能同时消费。
- 架构:tag 与 SID 各过独立嵌入层后拼接投影
q_i = W_proj · [e_t^(i) ‖ e_d^(i)] + b, W_proj ∈ R^{d × 2d}{q_1, …, q_M}作为 Target-Attention 的 query,注意候选 item 表示后出检索分。早层保通道特有信息,注意力层做跨通道交互。 - 偏好层级(不能只用点击信号,否则会被热度混淆、召回「好点但不忠于意图」的爆款):
Clicked ∩ Relevant > Unclicked ∩ Relevant > Unclicked ∩ Irrelevant - 联合损失:
L_util = − (1/|C|) Σ_{i∈C} log [ exp(s_i) / (exp(s_i) + Σ_{j∉C} exp(s_j)) ]
L_rel  = − (1/N) Σ_i (1/|P(i)|) Σ_{j∈P(i)} log [ exp(s_j) / (exp(s_j) + Σ_{k∈N(i,j)} exp(s_k)) ]
L      = α · L_util + β · L_rel        # 生产取 α = 1, β = 0.5
N(i,j) 限制为优先级不高于正样本 j 的候选(优先级按交互深度 clicked > exposed > non-exposed),防相关性目标与点击效用互相打架。
实验设置与结果
线上 A/B(主结果)
- 场景:淘宝首页「猜你喜欢」,数亿 DAU
- 流量:实验组 / 对照组各 1%
- 对照:线上 RecGPT-V2(即纵向对比自家上一代)
| 场景 | IPV | CTR | PV | DAU | TC | GMV |
|---|---|---|---|---|---|---|
| Item 场景 | +3.08% | +0.98% | +2.02% | – | +3.10% | +7.51% |
| Feed 场景 | +1.28% | +1.00% | +0.83% | +0.56% | +1.97% | +3.97% |
Item 场景涨幅明显更大,且 GMV 涨幅远超 CTR 涨幅——说明收益不只是「骗到更多点击」,而是候选与购买意图更对齐。
Memory Hub 评估
质量(人工标注)
| 评估对象 | 标注量 | 准确率 |
|---|---|---|
| Behavior Pattern(模式判定是否正确) | 2,514 | 82.89% |
| Behavior Index(溯源指针是否指对) | 21,268 | 95.27% |
算力(相对 V2 全序列 = 100%)
| 系统 | 组成 | 成本 |
|---|---|---|
| RecGPT-V2 | 全序列编码 | 100% |
| RecGPT-V3 | 单次推理 | 33.43% |
| 周期性记忆 curation 摊销 | 10.77% | |
| 合计 | 44.20%(净降 55.80%) |
本质是把「每次请求都付」的开销换成「两个月付一次」的摊销开销,请求量越大越划算。
基座能力评估
通用能力保持(w/ 表示混了 ~10–20% 通用域数据)
| Benchmark | Qwen3-14B | w/ General Data | w/o General Data |
|---|---|---|---|
| GSM8K | 94.31 | 92.65 (−1.66) | 4.70 |
| MMLU | 75.9 | 73.3 (−2.65) | 0.12 |
| CMMLU | 80.5 | 76.0 (−4.49) | 0.01 |
| IFEval | 81.52 | 75.60 (−5.92) | 23.29 |
不混通用数据 = 直接归零。这张表是全文最有说服力的消融之一。
SID–文本对齐(两变体基本持平,说明混通用数据不损伤 SID 映射能力)
| 任务 | 指标 | w/ General | w/o General |
|---|---|---|---|
| sid2title | ROUGE-L | 0.1590 | 0.1567 |
| sid2tag | ROUGE-L | 0.2867 | 0.2909 |
| title2sid | HR@30 | 0.0842 | 0.0773 |
| tag2sid | HR@30 | 0.0394 | 0.0366 |
下游推荐质量(混通用数据的真实收益体现在这里)
| 模型 | 平均 tag 数 | 平均品类数 | HR@30 (Category) |
|---|---|---|---|
| w/ General-Domain Data | 28.77 | 41.73 | 0.3050 |
| w/o General-Domain Data | 23.88 | 32.49 | 0.2250 (−26.2%) |
Latent Reasoning 评估
后训练消融(HR@30 = 品类级命中率;CTR = 输出检索到的 Top-100 item 的平均 CTR)
| 配置 | HR@30 (Category) | CTR |
|---|---|---|
| Qwen3-14B | 0.2276 | – |
| + Native Reasoning | 0.2347 | – |
| Hybrid-modal Foundation Model | 0.3050 | 0.0624 |
| + Explicit CoT (SFT) | 0.3508 | 0.0638 |
| + Latent Reasoning | 0.3462 | 0.0649 |
| + RL(完整 RecGPT-V3) | 0.3693 | 0.0679 |
两个值得注意的点:① 无域内训练时开 CoT 几乎没用(0.2276 → 0.2347),说明推理收益依赖域内对齐;② latent 单独看略逊于显式 CoT(0.3462 < 0.3508),是靠 RL 才反超到 0.3693。
推理效率(1,000 样本,同硬件)
| 模式 | 输出长度 | Input TPM | Output TPM | 总耗时 |
|---|---|---|---|---|
| Explicit CoT | 2,840 | 166K | 531K | 1,020s |
| Latent Reasoning | 122 (−95.7%) | 498K | 66.7K | 295s (−71.1%, 3.46×) |
Input TPM 从 166K 涨到 498K 证实:瓶颈从串行 decode 转移到了可并行的 prefill——这正是 latent 化的机理。
成本总账(很诚实):SID 进出 + latent 让上下文变长,专家模型反而 +15% 开销;但 Global Planner 算力约是专家模型的 20 倍,Planner 侧降 55.8% 加权后整体净省 52.4%。
SID vs Tag 模态分析
| 指标 | Text Tag | SID |
|---|---|---|
| 平均类目广度 C̃ | 1.40 | 0.84 |
| 跨用户类目重合度 J | 11.36% | 4.61% |
即使把一个 tag 下的 K 个 SID 聚合起来,类目集合仍比单个 tag 窄——tag 覆盖广(靠世界知识)、SID 更个性化(靠协同信号)。PCA 可视化上 tag 召回的 item 分散在多个区域,SID 召回的成紧凑簇。
互补性(item 级命中率)
| 配置 | HR@500 | HR@1000 |
|---|---|---|
| Tag | 0.1503 | 0.2044 |
| SID | 0.1539 | 0.2144 |
| Hybrid | 0.1571 | 0.2168 |
结论明确:双通道并存 > 二选一,SID 不是 tag 的替代品。
思考与可参考价值
局限
- 技术报告体裁,关键超参大面积缺失:记忆单元数 K 的分布、行为原型 taxonomy 的规模与构造方式、RQ-VAE 训练细节、GRPO 的 group size / KL 系数 / 学习率——全都没有。想复现只能自己试。
- 只有纵向对比:所有结果都是相对 RecGPT-V2,没有与 OneRec / OpenOneRec / GR2 等外部生成式推荐系统横向比较,也没有公开数据集上的可复现实验。
- Curation 频率粗:两个月一次的增量 curation,对大促、突发热点这类快速漂移只能靠 recent delta 兜底;论文没做频率的敏感性分析。
- 记忆错误的下游传导未分析:pattern 准确率 82.89% 意味着近 1/5 记忆单元的模式判定有问题,但这些错误如何影响最终推荐,文中没有讨论。
- K_max = 10 是拍的:没给 K 与质量的 trade-off 曲线;trace 超过
C·K_max步直接截断到前 K_max 段,长推理的信息损失完全没评估。 - Latent 本身其实略输显式 CoT(0.3462 vs 0.3508),是 RL 救回来的——叙事上这点被弱化了。严格说「latent 无损」的说法只在「latent + RL」这个组合下成立。
- RLRF 的回音室风险:奖励读的是当前生产 ranker 的偏好,策略被优化去迎合它,长期可能强化既有偏置、压制新兴长尾。CRS 的多样性门控只能部分缓解,论文未展开讨论。
可直接借鉴(电商 / 搜推 / Agent)
- 有状态用户建模是最容易迁移的一条。任何有 LLM 参与用户理解的链路,把「每次请求重扫全历史」换成「持久化结构化记忆 + 近期增量」都能立刻省算力。两个设计细节值得照抄:溯源指针(存整数下标而非原文,既省 token 又可审计可 debug)、有证据才更新 + 更新时整段重合成(防止陈旧与新兴偏好在同一单元里堆叠)。
- 优化重心放在重算力模块,而不是均匀优化。Planner 类全局模块算力常是专家模块的十几二十倍——V3 甚至能容忍专家侧 +15% 去换全局 −52.4%。这个「算加权总账而非局部账」的思路比具体方法更值得复制。
- tag → 离散 item 标识的接口升级是通用解法。任何「上游 LLM 出自然语言、下游模型做检索」的两段式链路都有同样的有损瓶颈。但注意论文的实测结论是互补而非替代(Hybrid > SID > Tag),别急着把文本通道砍掉。
- Latent CoT 是长 CoT 真正上线的现实路径。核心机理是把成本从串行 decode 挪到可并行 prefill(Input TPM 166K→498K 是直接证据),同时用 Full-Trace 重建保住可解码性——对「CoT 有效但延迟吃不消」的场景(SEO 推词、意图理解、query 改写)是可直接照搬的模板。落地时建议先把
K做成可调并测 trade-off 曲线,别直接抄 10。 - 奖励接生产排序模型(Top-K CTRScore 均值)比离线 HitRate 又稠密又对齐链路,是很实用的一招;但务必配多约束门控(对齐度 / 多样性 / 长度)防回音室,且门控用乘性 indicator 而非加权和——达不到阈值直接归零,比软惩罚干净。
- 垂域继续预训练必须混 10–20% 通用数据。这篇给了「不混就归零」(MMLU 0.12 / CMMLU 0.01)的极端证据,而且混了之后不仅不损伤域内 SID 对齐,下游 HR@30 反而 +26.2%——通用能力在这里不是要付的税,是净收益。