RecGPT-V2 Technical Report
Taobao (阿里淘天) × 中国人民大学
淘宝 RecGPT 第二代(V3 的前作):把 V1 的「多路并行 LLM 独立重扫全历史」重构成协同的分层多智能体系统。四件事——Hybrid Representation Inference 用 adaptor 把每个商品/query 压成 1 个 [entity] atomic token(32K→11K,7×压缩,LLM 冻结只训 adaptor);Hierarchical Multi-Agent System(Planner→Experts→Arbiter)消除路由间 13.46% 冗余;Constrained Reward Shaping 用乘性 indicator 门控把次要奖励当硬约束、解决多奖励梯度打架;Agent-as-a-Judge + Judge-as-a-Reward 把评估拆成多维子评估器再蒸馏成稠密 reward,形成自改进飞轮。线上 A/B 相对 V1:CTR +3.01%、IPV +3.64%、GMV +3.39%、NER +11.46%,GPU 算力 −60%。
这是 RecGPT-V3 的直接前作。V3 里的 Global Planner、Constrained Reward Shaping(CRS)、GRPO 训练框架、tag→item 检索链路都源自本文,读 V3 前把 V2 过一遍会顺很多。
核心思路
问题:RecGPT-V1 首创把 LLM 推理放进 user interest mining + item tag prediction,把推荐从「行为模式匹配」升级为「显式意图推理」,已线上见效。但规模化暴露四个瓶颈:
| 限制 | 具体表现 | |
|---|---|---|
| L1 | 多路架构算力低效 + 认知冗余 | V1 部署后扩成多路 LLM 检索通道(各自侧重 weather/trending/seasonal),每路都重扫全量行为序列(平均 32K token,占输入 95.89%),且路由间产出 13.46% 重复候选 |
| L2 | 固定模板解释缺多样性 | 固定 prompt 模板产同质化解释,不能纳入实时上下文信号 |
| L3 | 静态数据 SFT 泛化差 | SFT 锚死在固定分布,面对 diversity/novelty/relevance 多目标多约束的动态需求泛化不足 |
| L4 | 结果导向评估太简单 | LLM-as-a-Judge 一步出分,塌缩了人类多维多步评估过程,与人类标准对不齐 |
关键 idea:四招分别对应四个瓶颈——压表示(adaptor 把实体压成单 token)、改结构(分层多智能体去冗余)、改 RL(约束式奖励门控解决多目标冲突)、改评估(Agent-as-a-Judge 飞轮)。目标是「生成质量与算力同时改善」。
整体实现思路
用户全量行为序列 B (~32K token)
   │ ① Hybrid Representation Inference:每个 item/query → 1 个 [entity] atomic token
   ▼
Hybrid Context C = {B(压缩), U(画像,自然语言), E(环境信号,自然语言)}  ~11K token
   │ ② Hierarchical Multi-Agent System
   ▼
Global Planner —— 一次性分解成 K 个互补 persona {p_1 … p_K}
   │ 分派
   ▼
Distributed Experts —— 各领 persona 出 tag:T_k = f_expert(p_k)   (SFT + GRPO/CRS 训练)
   │ 汇聚
   ▼
Decision Arbiter —— 联合评估全候选池 T_all=∪T_k,去冗余出 top-N tag → 下游检索
   │
   ▼
Meta-Prompting 解释生成(③ 两阶段:先合成 style,再按 style 出解释;CRS 优化)
   ▲
   │ reward 信号
   └── ④ Agent-as-a-Judge(多维子评估器 + Senior Reviewer 三档 S/A/B)
          └── Judge-as-a-Reward(listwise LTR 蒸成稠密 reward)→ 回喂 GRPO(自改进飞轮)
子模块实现(可复现细节)
模块 A — Hybrid Representation Inference(表示压缩)
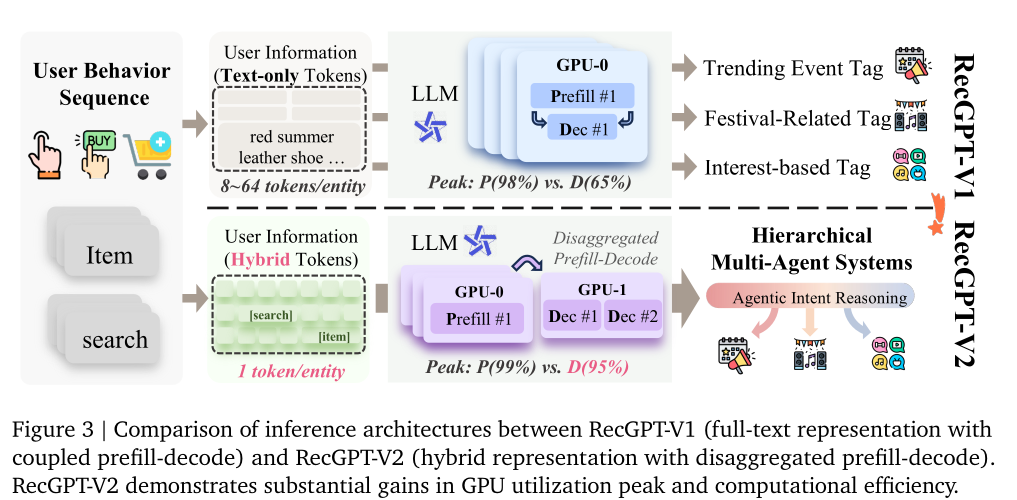
Transformer prefill 复杂度 O(L_in²)、decode O(L_in × L_out);V1 里用户终身行为占输入 95.89%,是算力/显存瓶颈。
A.1 Atomized Entity Compression(两阶段)
Stage 1 · Atomic Encoding
- 实体文本
x = [w_1, …, w_n]过预训练 embedding(BGE / Qwen3-Embedding / TBstars):h = f_embed(x) ∈ R^{d_emb} - 两层 adaptor 投到 LLM 输入空间:
z = f_adapt(h) = W_2 · ReLU(W_1 h + b_1) + b_2 ∈ R^{d_LLM}
W_1 ∈ R^{d_hidden × d_emb},  W_2 ∈ R^{d_LLM × d_hidden}
- 一个实体 = 1 个
[entity]token(案例:12 token 中文标题 → 1 token,12:1)
Stage 2 · Hybrid Adaptation(冻结 LLM,只训 adaptor)
两类监督数据:
- Self-Perception(“what-is-it”):用 GPT-4 对每个实体自动生成属性型 QA 对
{(q_i, a_i)}_{i=1}^K = LLM(x),探测 atomic 表示的语义完整性(问材质/季节/防滑/场景…,答案必须能从原文得出) - Production-Oriented:把 atomic unit 塞进 User Interest Mining / Item Tag Prediction 两个生产任务,用全文 prompt 的 frozen-LLM 输出当 ground truth
统一训练目标:混合 prompt 要复现全文 prompt 的响应
P_hybrid = φ(P_full),   φ(x_e) = f_adapt(f_embed(x_e))  ∀e ∈ E   (实体→atomic 替换)
L(θ_adapt) = − Σ_{t=1}^{|y*|} log p(y*_t | P_hybrid, y*_<t)       (frozen LLM 分布)
adaptor 相对扩词表(LC-Rec / CoLLM)的三个优势:① 参数高效(只训 adaptor);② 泛化好(冻结 LLM 保通用能力,adaptor 学「投影到语义空间」而非逼模型认全新 token);③ 模块化(可插拔换 embedding / LLM)。整段序列 21349 → 5158 token(−76%),用户属性/时间戳保留自然语言。
A.2 Infrastructure Engineering Optimization
- Disaggregated Prefill-Decode:prefill 计算密集(
O(L_in²),算完 KV cache 可传走)给大 GPU 池;decode 访存密集(O(L_in × L_out),频繁访 KV cache)给小池;两阶段经 KV cache 传输通信。推荐任务「输入 ~10K、输出数百」的极端不对称正适合。 - XQA kernel 换 FlashInfer,H20 上跑 FP8(FlashInfer 主要为 BF16 优化,XQA 对 FP8 量化更快)。
- 效果:MFU 11.56% → 17.04%,prefill QPS ×69.30、decode TPS ×7.35。
模块 B — Hierarchical Multi-Agent System(去认知冗余)
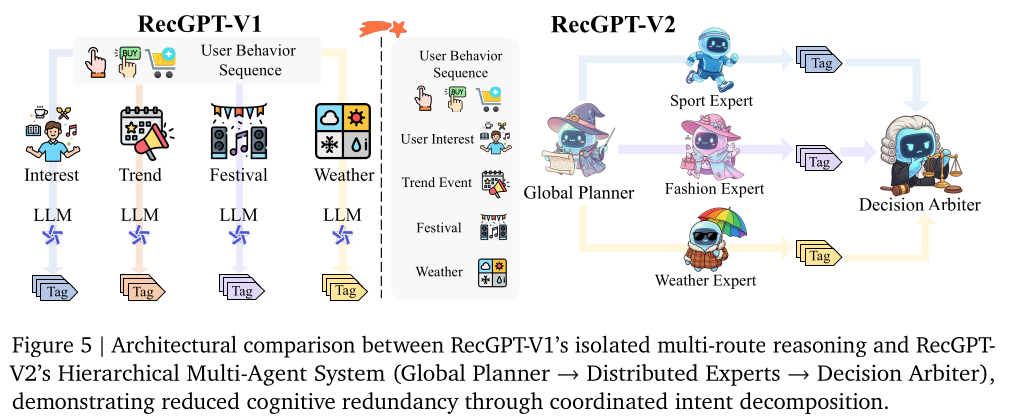
三层:Planner → Experts → Arbiter。
B.1 Global Planner
- 输入 hybrid context
C = {B, U, E}:B用户行为(atomic 压缩),U = {U_attr, U_int}(静态属性 + 动态兴趣,自然语言),E环境信号(天气/季节/热点,自然语言)
- 一次性分解成 K 个互补 persona:
{p_1, …, p_K} = f_planner(C) - 两个目的:① 消除算力冗余(intent 分解只在压缩上下文上做一次,而非每个 expert 各扫原序列);② 认知协同(显式编排互补视角,防 expert 探索重叠语义)
B.2 Distributed Experts
- 各领 persona 出 tag:
T_k = f_expert(p_k) = {t_1^k, …, t_{M_k}^k} - SFT:用 GPT-4 判定用户 next 行为里哪些品类与 persona 语义对齐
C_k^rel = {c ∈ C_next | f_GPT-4(c, p_k)=True},构造固定 15 元 target 标签集(不足用 GPT-4 合成 tag 补齐、超出随机采 15),标准 next-token CE:L_SFT = −E log p_θ(C_k^target | p_k) - 训练数据配比:
| 数据类型 | 占比 |
|---|---|
| 纯行为模式 | 32.17% |
| 热点/事件 | 6.97% |
| 天气相关 | 1.19% |
| 其他情境信号 | 7.36% |
| 通用语言建模 | 52.31% |
- RL(GRPO):组内采 G 个输出,组归一 advantage
 = R − (1/G)Σ R_i,带 KL 惩罚防 reward hacking。四个奖励:
| 奖励 | 定义 |
|---|---|
R_acc | tag→cate 映射后命中真实交互品类的召回:(1/|C_gt|)Σ_c 1[c ∈ f_tag2cat(T_k)] |
R_align | 人类偏好 RM 打分均值 (1/M_k)Σ f_RM(t_i, p_k) |
R_div | BGE 嵌入两两余弦距离均值(越大越多样) |
R_len | tag 词数 6–11 给 1.0、4–6 或 11–13 给 0.5、否则 0 |
B.3 Decision Arbiter
- 联合评估全候选池
T_all = ∪_{k} T_k,考虑 tag 间互补/去冗余,出 top-N:T_final = f_arbiter(T_all, C) - 在线出词后:Poly-Encoder K 个可学习 context code 抽多兴趣向量
{u_1, …, u_K};二次规划做流量分配平衡探索(cognitive 通道)/ 利用(utility 通道),闭式解按复合分h_i = s_i + α(o_i − ō) + r决定曝光,上线简化成硬阈值x_i=1 iff h_i>λ。
模块 C — Constrained Reward Shaping(多目标 RL 核心,被 V3 继承)
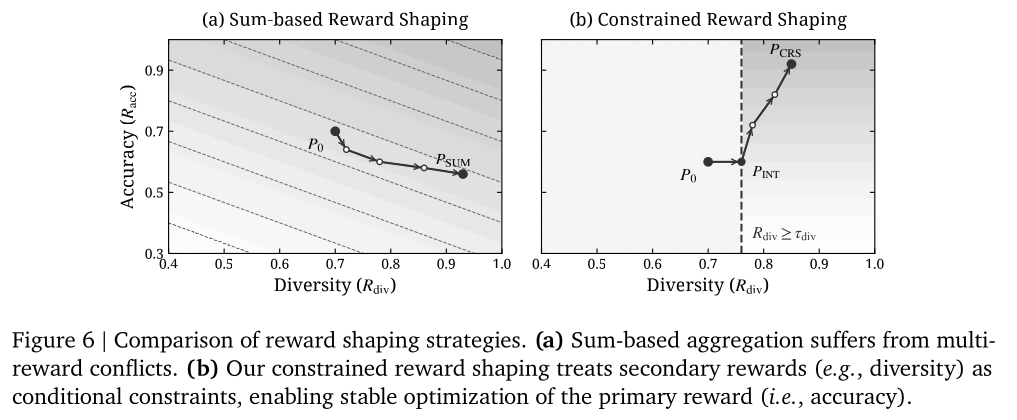
问题:多奖励直接加权求和(SUM)会梯度互扰——简单目标(diversity)主导、牺牲关键目标(accuracy),轨迹从 P0 漂到次优 P_SUM。
CRS 解法:把次要奖励当硬约束乘性门控,先跨可行边界满足约束(P0→P_INT)、再优化主 accuracy(P_INT→P_CRS):
R_total = R_acc · 1[R_align ≥ τ_align] · 1[R_div ≥ τ_div] · 1[R_len ≥ τ_len]
任一 indicator 返 0 则 reward 归零,解耦「约束满足」与「主目标优化」,消除梯度互扰。训练动态上 CRS 相对 SUM 梯度范数更低、KL 更稳、accuracy 与 diversity 同时正向。
解释生成侧同理:R_total = R_align · 1[R_div ≥ τ_div],其中 R_div 用 IDF 式(大小 160 的 FIFO buffer 统计 token 稀有度,R_div = (1/L)Σ_i log(|M| / (含 w_i 的条数 + 1)))。Meta-Prompting 两阶段:Stage 1 先合成 style guideline g = f_meta(U, I, S),Stage 2 按 style 出解释 e = f_exp(g, U, I, S)。
模块 D — Agentic Judge Framework(评估飞轮,被 V3 继承)
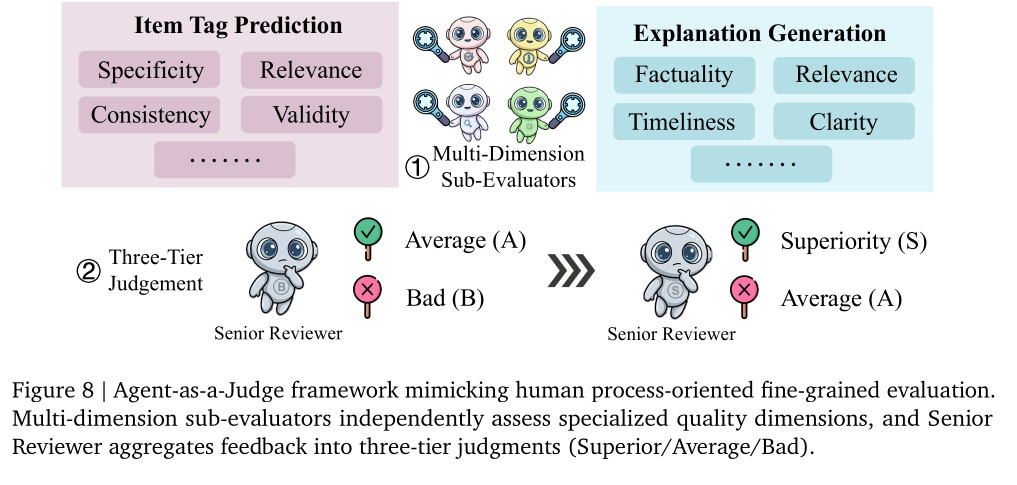
D.1 Agent-as-a-Judge
- 多维子评估器:每个评估维度一个
s_i = E_i(y, d_i)(Item Tag 维度:Specificity/Relevance/Consistency/Validity;Explanation 维度:Factuality/Relevance/Timeliness*/Clarity/Informativeness*/Attractiveness*/Safety,*为 V2 新增) - Senior Reviewer 三档裁决 S/A/B:(a) Defect Detection——任一维度不满足判 B;(b) Excellence Elevation——无缺陷则按正反馈比例用阈值 τ 分 S/A
- 训练:Qwen3-32B-Instruct SFT(in-batch shuffle 造 relevance 负样本 + 人标混合)
D.2 Judge-as-a-Reward
- 从 Agent Judge checkpoint 初始化、换 scalar value head(sigmoid 到 [0,1]):
r = f_RM(y, U, I, S) - listwise learning-to-rank 保住 S≻A≻B 全序(S 的负样本含 A+B、A 的含 B):
L_RM = − Σ_{g∈{S,A}} Σ_{y_g∈Y_g} log [ exp(f_RM(y_g)) / (exp(f_RM(y_g)) + Σ_{g'<g} Σ_{y_{g'}} exp(f_RM(y_{g'}))) ]
- prefix sharing 加速(组内共享 context prompt,只算一次前缀)
D.3 自改进飞轮
Policy 生成 → Agent 评估(S/A/B)→ Judge-as-a-Reward 蒸稠密 reward → GRPO 优化 policy → 循环。一次人标后自主运转,reward 蒸馏保效率、多维评估保全维度质量。
实验设置与结果
线上 A/B(主结果)
- 场景:淘宝首页「猜你喜欢」,实验/对照各 1% 流量,对照 = RecGPT-V1,两周
- 短期指标 IPV/CTR/TV/GMV/ATC,长期指标 NER(新颖曝光率)/ LT-14 / LT-30
| 场景 | IPV | CTR | TV | GMV | ATC | NER | LT-14 | LT-30 |
|---|---|---|---|---|---|---|---|---|
| Item | +3.64% | +3.01% | +2.11% | +3.39% | +3.47% | +11.46% | – | – |
| Feed | +1.29% | +1.50% | +0.34% | +1.53% | +0.99% | +4.49% | +0.04% | +0.05% |
算力
- MFU 11.56% → 17.04%(+53.1%),prefill QPS ×69.30、decode TPS ×7.35,GPU −60%
- 独占召回 9.39% → 10.99%,解释多样性 +7.3%
Tag 预测 HR@30(Qwen-14B base,CRS 消融)
| 方法 | HR@30 |
|---|---|
| RecGPT-V1 | 26.29% |
| V2-Base | 23.08% |
| + SFT | 29.20% |
| + GRPO (SUM) | 27.38% |
| + GRPO (CRS) | 32.60% |
关键:GRPO(SUM) 反而低于 SFT(证实加权求和梯度冲突),CRS 超 SFT +3.40pp、超 V1 +6.31pp。
Reward Model 训练策略消融
| 方法 | HR@30 (Tag) | Quality (Explanation) |
|---|---|---|
| RecGPT-V1 | 26.29% | 36.03% |
| V2 (Point-wise RM) | 31.24% | 37.64% |
| V2 (List-wise RM) | 32.60% | 40.73% |
相对 V1:HR@30 +24.1%、质量 +13.0%;listwise 相对 pointwise 再 +4.4% / +8.2%。
Agent-as-a-Judge vs LLM-as-a-Judge(S 档人机一致性,人标为准)
| 任务 | 模型 | Acc V1→V2 | F1 V1→V2 |
|---|---|---|---|
| Item Tag | Qwen3-SFT | 0.8210 → 0.8248 | 0.8095 → 0.8228 |
| Explanation | Qwen3-SFT | 0.6885 → 0.7006 | 0.6787 → 0.7307 |
Item Tag 三模型 accuracy +0.10/+0.20/+0.38pp;Explanation 侧 Qwen3-SFT F1 +5.20pp 最显著(但 Qwen3-Base 在 Explanation 上略降,收益不稳)。
思考与可参考价值
局限
- 依旧全是纵向对比:所有结果相对 V1,无外部系统(OneRec 等)横向 baseline、无公开数据集。
- 压缩信息损失上界没量化:把一个商品塞进 1 个 token,self-perception QA 只能证「大部分属性可答」,长尾属性 / 多属性组合是否丢失未评。
- 关键超参缺失:persona 数 K、CRS 三个阈值 τ、GRPO 超参基本没给,复现困难。
- 长期留存收益其实很弱:LT-14/LT-30 只 +0.04%/+0.05%,被 NER +11.46% 的叙事盖过。
- Agent-as-a-Judge 提升不稳:相对 LLM-as-a-Judge 多在 +0.1~1.2pp,部分配置(Explanation/Qwen3-Base)甚至略降。
- 二次规划流量分配未真部署:上线时简化成硬阈值(
0<h_i≤λ直接丢弃),理论最优解只在纸面。
可直接借鉴(电商 / 搜推 / Agent)
- adaptor 式实体压缩是长序列 LLM 的现实解——冻结 backbone 只训 adaptor 把 item/query 压成单 token,7× 压缩且保通用能力、可插拔,比扩词表微调轻得多;长序列用户建模 / 商品上下文注入直接可用。
- Constrained Reward Shaping 是多目标 RL 的通用模板——凡 accuracy/diversity/relevance/length 多奖励打架,把次要目标做成乘性 indicator 硬门控(达不到阈值 reward 归零)而非加权求和,根治梯度互扰。这一招被 V3 的 RLRF 原样继承,是 RecGPT 系列最可复用的一招。
- Planner→Experts→Arbiter 分层多智能体:意图分解只做一次再分派,比多路各自重扫全上下文既省算力又去冗余,适配多目标召回 / 多兴趣建模。
- Agent-as-a-Judge + Judge-as-a-Reward 飞轮:评估拆成多维子评估器 + 三档裁决再蒸成稠密 reward,一次人标后自改进循环;对任何「LLM 打分驱动 RL」的生成任务(解释 / 文案 / 推词质量)可迁移,listwise LTR 蒸 reward 优于 pointwise。
- disaggregated prefill-decode 对「输入长输出短」的推荐 / 搜索生成任务是标准优化,值得在自家 serving 复用。