Reasoning over Semantic IDs Enhances Generative Recommendation
National University of Singapore × University of Science and Technology of China × Tencent
让 LLM 在 Semantic ID(SID)上做显式推理再出物品。先用「多任务对齐 + 教师模型扩写的 SID-语言富文本语料」把 itemic token 接进语言空间,再用 GRPO 以"命中下一个物品"为 outcome reward 自探索推理轨迹,免标注、学术规模数据即可超越非推理生成式推荐,并带来跨域泛化与可解释性。
核心思路
生成式推荐近年走向「把 item 量化成一串离散 Semantic ID(SID)token,把序列推荐建模成在 SID 上的自回归生成」。把 SID token 扩进 LLM 词表后,模型理论上能「用语言推理、用 SID 推荐」,统一在一个表征空间里。但要让 LLM 真正在 SID 上做有效推理,有两个本质障碍:
- SID 对 LLM 不是天然有意义的 token:SID 是新加入词表、随机初始化的 embedding,模型在对齐前完全不知道
<a3><b7><c5>指什么;现有成功案例靠工业级预训练砸算力做对齐。 - 推荐推理质量难评估、监督稀缺:用户偏好是隐式的,没有”正确推理过程”这种 ground truth,高质量 reasoning trace 既贵又不可得。
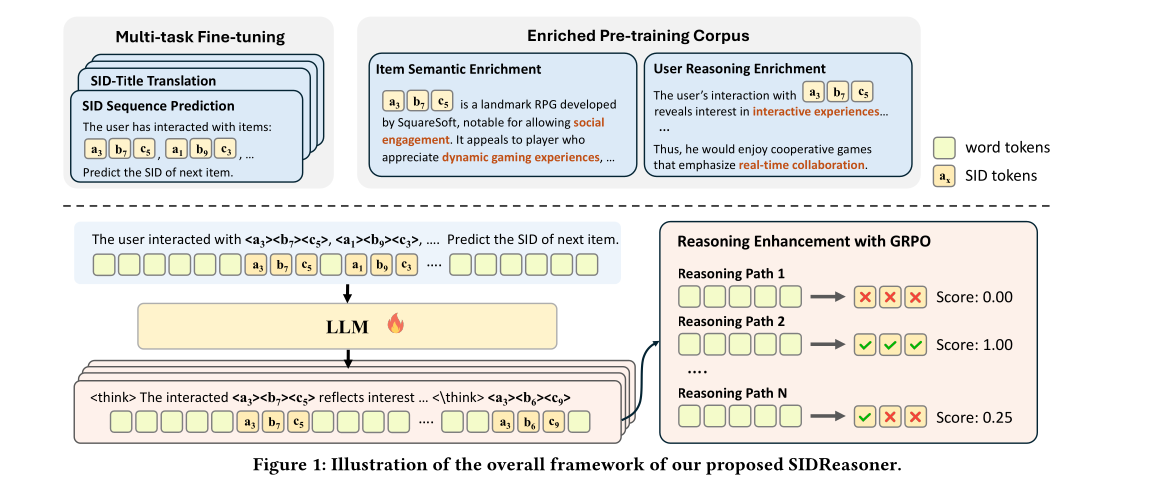
SIDReasoner 的核心主张是:与其去采集大量推荐专属的推理标注,不如先把 SID-语言对齐做强,让 LLM 通用的世界知识和推理能力”迁移”到推荐任务上。 据此设计两阶段框架:
- 阶段一 · 富化 SID-语言对齐:在「多任务对齐」基础上,用更强的教师模型(GPT-4o-mini)基于 item title 做语义扩写,合成一份 SID 居中、语义多样的富文本语料,把 itemic token 锚定到丰富的语义/行为上下文里。
- 阶段二 · 强化推理增强:在已对齐的模型上,用 GRPO 以”是否命中真实下一个物品”作为 outcome reward,让模型自探索对推荐有效的推理轨迹,完全不需要显式推理标注。
结论:在三个学术规模 Amazon 数据集上(每个仅约 3.5k–3.9k items、4.5w–6w interactions),即可让 LLM 做出有效的推理式生成推荐,超越 TIGER/LETTER/LCRec 等生成式 baseline 和 ReaRec/R2ec 等推理式 baseline,并额外带来跨域泛化与可解释性。
整体实现思路
问题形式化。 用户 的时序交互历史 ,目标生成下一个物品 。每个 item 映射成定长 SID 序列 。LLM 词表扩成 (语言 token + itemic token)。历史展平成 itemic-token 上下文 ,配上指令 prompt 得到上下文 。生成时模型先产一段推理序列 ,再产下一个物品的 SID:
即推理 是显式中间步骤,直接塑造后续 SID 解码轨迹(不是事后解释)。生成一个 item = 步连续 next-token 预测。
两阶段流水线:
- 富化 SID-语言对齐(阶段一,监督式 next-token 预测)
- 1a. RQ-VAE 量化得到 SID;
- 1b. 多任务微调(item prediction + SID translation)建立基础对齐;
- 1c. 教师模型扩写的富语料做额外预训练,并混入通用推理数据防遗忘。
- 强化推理增强(阶段二)
- 2a. Cold-start 推理激活:用教师生成的推理做 1 个 epoch SFT,固化”先 think 再推荐”格式;
- 2b. GRPO:以命中真实物品的 outcome reward 自探索推理。
子模块实现(可复现细节)
1. Item 量化(RQ-VAE)
对每个 item,把文本 metadata (title / category / 可选简述)经文本编码器编成连续向量 ,再多级残差量化:维护 个 codebook ,每个 含 个码向量。第 级残差 选最近码字、更新残差:
得到 。联合损失:
为 stop-gradient, 控制 commitment 强度。图中示例 SID 形如 <a3><b7><c5>( 级、每级一个 token)。
2. 多任务微调(建立基础 SID-语言对齐)
SID token 初始随机、对模型无意义。用一组推荐任务在统一 next-token 目标下联合训练,让 SID token 与语言 token 在多种场景共现。两大类(附录 B 共 8 个模板、4 个功能类):
- Item prediction(4 个模板):给历史预测下一交互,item 用 SID 或文本表示,覆盖 title→title / title→SID / SID→title / SID→SID 四向;既学行为模式,又把 SID 接到语义。
- SID translation(2 个模板):title↔SID 双向翻译,把 SID 词表锚到自然语言,使模型可在两种表征间互换推理。
- Item-centric semantic enrichment(1 个模板):把 SID 嵌进一段带 category/feature/use-case 的连贯描述。
- User-centric reasoning augmentation(1 个模板):把交互史写成 SID 与语言交织的”故事 + 分析师式偏好推理”叙事。
3. 教师扩写的富语料预训练(关键贡献)
多任务格式有限 → SID 与语言的关联重复、单薄。用强教师(GPT-4o-mini API)做语义扩写,合成更富的 item-语言语料。两路两阶段 prompt(附录 C):
- Item-centric semantic enrichment:Stage1 让教师对 title/brand/category/description/features 推理,产出 refined description、主要 use-case、目标人群、关键特征、相关关键词等结构化洞见;Stage2 融成一段连贯段落,强约束:每次提到该 item 都用其 SID token 而非 title。
- User-centric reasoning enrichment:Stage1 让教师以分析师人设从交互史推断隐式偏好与兴趣漂移,产第一人称推理独白(不泄露 held-out 的下一个物品);Stage2 把原始交互序列与推理融成一段叙事,每个 item 都只用 SID 引用。
此外混入通用域推理数据,防止过拟合推荐任务、保住通用语言/推理能力。
4. Cold-start 推理激活
对齐后模型已具备”边推理边推荐”能力,但推理时不一定默认先输出 reasoning。用对齐阶段教师生成的推理构造监督样本,标准 SFT 强制”reason-then-recommend”格式:先产 再产 (条件于 )。仅训 1 个 epoch,作用是稳定输出格式(让推理稳定出现在推荐之前),不是从零教推理 —— 推理能力已在对齐阶段建立。
5. GRPO 强化推理增强
奖励(reasoning + 预测 ):
- Stepwise rule-based reward(核心,按前缀渐进给分):设 为 item 表征长度、 为 与 ground-truth 的最长正确前缀长度,则 匹配 token 越多奖励越大,全对趋近 1。这是逐级 SID 解码的关键设计——不是 0/1 命中,而是给部分前缀正确以平滑梯度。
- Format reward: 当 映射到目录中真实存在的 item,否则 0;鼓励生成合法 itemic 序列。
对每个 采 条 reasoning-prediction 轨迹 ,组内归一化优势 ,最大化 clipped surrogate:
为轨迹级重要性比, 为 clip 阈值, 控 KL。
实验设置与结果
数据:3 个 Amazon 域 —— Video Games / Office Products / Industrial & Scientific。5-core 过滤,滑窗最大长度 10,按时间 8:1:1 切分 train/val/test。
| 数据集 | #Items | #Interactions | Train | Val&Test |
|---|---|---|---|---|
| Games | 3,858 | 61,417 | 49,133 | 6,142 |
| Office | 3,459 | 48,656 | 38,924 | 4,866 |
| Industrial | 3,686 | 45,325 | 36,259 | 4,533 |
评估:full-item ranking(全库排序,非采样负例),Recall@K / NDCG@K,。
Baseline:判别式(Caser / GRU4Rec / SASRec)、生成式(TIGER / HSTU / LETTER / LCRec)、推理式(ReaRec 隐式推理、R2ec 显式文本推理)。
实现:backbone = Qwen3-1.7B,全程全参微调。对齐阶段 AdamW,batch 1024,按预测 SID 早停;富语料用 GPT-4o-mini 合成。推理激活 1 epoch。GRPO 基于 verl,rollout=16,KL 系数 ,batch 256,format reward 权重 ,学习率固定 。
主结果(RQ1)
| Models | Games R@5 | N@5 | R@10 | N@10 | Office R@5 | N@5 | R@10 | N@10 | Indus R@5 | N@5 | R@10 | N@10 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| SASRec | .0501 | .0345 | .0723 | .0416 | .1019 | .0824 | .1167 | .0871 | .0807 | .0647 | .0964 | .0697 |
| TIGER | .0489 | .0300 | .0763 | .0402 | .1270 | .1037 | .1429 | .1121 | .1003 | .0823 | .1325 | .0924 |
| LETTER | .0445 | .0294 | .0709 | .0378 | .1315 | .1074 | .1520 | .1139 | .1080 | .0850 | .1389 | .0950 |
| ReaRec | .0568 | .0381 | .0843 | .0470 | .1173 | .0988 | .1385 | .1057 | .0973 | .0796 | .1205 | .0870 |
| R2ec | .0655 | .0399 | .0931 | .0525 | .1147 | .0894 | .1486 | .1004 | .0880 | .0774 | .1253 | .0774 |
| SIDReasoner | .0710 | .0460 | .1031 | .0563 | .1373 | .1119 | .1648 | .1208 | .1109 | .0905 | .1438 | .1010 |
SIDReasoner 全部指标最优。推理收益与领域语义知识强相关:Games(语义丰富、与 LLM 世界知识对齐好)推理增益最大;Industrial(LLM 领域知识少)增益最小——R2ec 也呈现高度一致趋势。
跨域泛化(RQ1 · Figure 3)
构建覆盖三域的统一 SID 空间,在混合语料上做对齐;随后只在单域(Games 或 Office)或全量上做 RL。结论:单域 RL 能一致提升 in-domain 与 out-of-domain 的推理效果,说明学到的是”如何在推荐中有效推理”的通用知识,可跨域迁移,而非绑定特定 item 分布。
消融:对齐策略决定推理上限(RQ2)
四种 backbone 设置,越往后语料越富。用 Best-of-N(采 N 条推理、按 ground-truth 选最优)衡量推理上限,再看 RL 收敛值;二者高度一致 → Best-of-N 是 RL 优化潜力的有效指标。
| Models | Games R@10 | N@10 | Office R@10 | N@10 |
|---|---|---|---|---|
| S1 = Multi-task Alignment | .0414 | .0206 | .0388 | .0201 |
| - After RL | .0741 | .0355 | .1539 | .0970 |
| S2 = S1 + Enriched Alignment | .0632 | .0320 | .0619 | .0363 |
| - After RL | .0957 | .0470 | .1607 | .1178 |
| S3 = S2 + General Reasoning | .0806 | .0450 | .1231 | .0883 |
| - After RL | .1031 | .0563 | .1648 | .1208 |
要点:① 直接对 vanilla Qwen3 做推理激活不够——显式 SID-语言对齐是必要前提;② 多任务对齐给基础语义 grounding;③ 富语料进一步多样化 SID-语言关联、显著抬高推理上限;④ 混通用推理数据既缓解灾难性遗忘又提升推荐推理。
消融:对齐对通用能力的影响(RQ2)
| Models | MMLU | IFEval | GSM8K |
|---|---|---|---|
| Vanilla Qwen3-1.7B | 0.6085 | 0.1793 | 0.6850 |
| S1 = Multi-task Alignment | 0.2760 | 0.0906 | 0.0060 |
| S2 = S1 + Enriched Alignment | 0.4464 | 0.0739 | 0.0330 |
| S3 = S2 + General Reasoning | 0.5580 | 0.1497 | 0.5430 |
只做多任务对齐对数学(GSM8K)几乎抹平(0.685→0.006);富语料缓解但不够;混通用推理数据把 GSM8K 救回 0.543、MMLU 回 0.558——保住通用能力对推荐推理本身也重要。
教师模型质量(RQ3)
| Enrichment | R@10 | N@10 |
|---|---|---|
| Metadata(规则拼接,无 LLM 改写) | 0.0703 | 0.0466 |
| Qwen3-8B | 0.0727 | 0.0480 |
| Qwen3-32B | 0.0858 | 0.0498 |
| GPT-4o-mini | 0.1031 | 0.0563 |
教师越强、合成语料越富 → 对齐越有效。意味着 SIDReasoner 能随通用 LLM 进步自然受益。
RL 中推理的演化(RQ3)
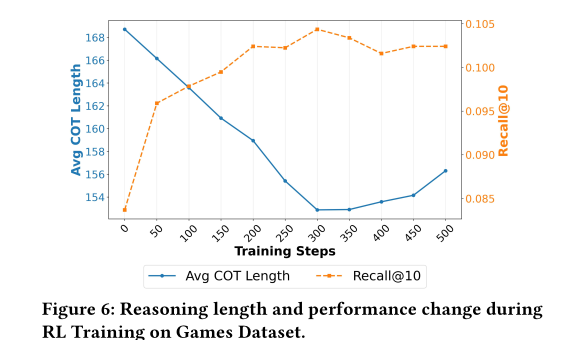
RL 早期推理长度明显下降并收敛到更短,而 Recall@10 稳步上升。解释:对齐阶段从教师(GPT-4o-mini)学到的推理含冗余/无用片段;RL 快速识别并丢弃,转向更短、更聚焦决策的轨迹。有效推荐推理不需要更长的链,而是更高效的链。
案例研究(RQ3)
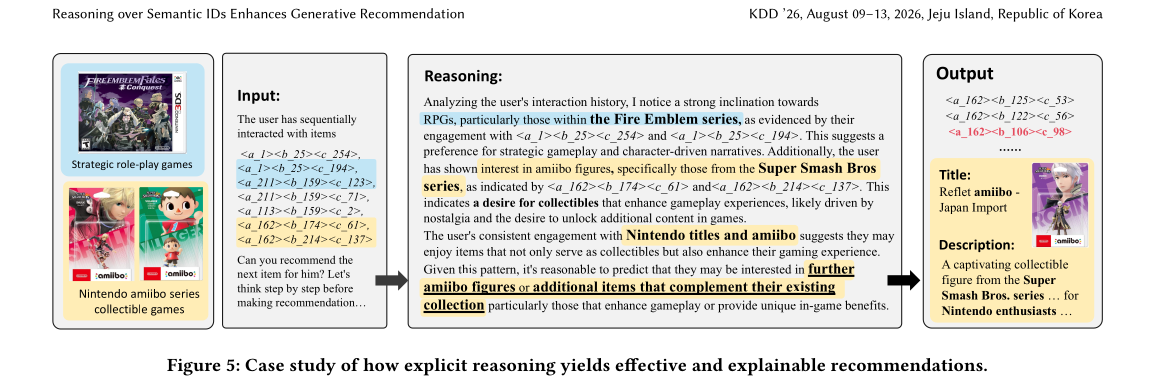
给定 SID 编码的交互史,模型先在 <think> 里总结用户兴趣(策略 RPG + Nintendo amiibo 收藏),推断其偏好收藏类且能增强游戏体验的物品,进而把 SID 解码轨迹导向 Nintendo amiibo 相关 item,成功命中目标。推理直接塑造解码轨迹与推荐列表,是透明的决策过程而非事后解释。
思考与可参考价值
局限:
- 学术规模数据(每域约 3.5k items),未验证更大 backbone 与工业规模数据下的表现(作者列为 future work)。
- 推理收益强依赖领域语义知识:LLM 知识稀薄的垂类(Industrial)增益有限——电商长尾/冷门类目可能复现这一短板。
- 全参微调 Qwen3-1.7B + GRPO(rollout 16),训练成本不低;通用能力即使加通用数据仍未完全恢复到 vanilla 水平。
- RQ-VAE 是冷构 SID,未深入比较融合协同信号的 SID(LETTER 类)在该框架下的上限。
对电商/搜推/Agent 可借鉴点:
- “对齐优先于标注”范式:与其采集昂贵的推荐推理标注,不如把 itemic token(SID/商品 ID)对齐做强,让 LLM 通用推理迁移过来——对自建商品 token 体系的电商生成式推荐很有参考价值。
- 教师扩写 SID 居中语料是低成本可复用的数据合成配方:item-centric(SID 嵌进富描述)+ user-centric(SID 嵌进偏好推理叙事),关键约束是”凡提及 item 一律用 token 替代 title”,强制 token-语义绑定。值得迁移到 query 改写、商品理解、用户画像生成等环节。
- Stepwise 前缀奖励 :逐级码本解码场景下,把 0/1 命中改成”最长正确前缀”平滑奖励,能给 GRPO 更稠密的信号——对任何分层/分级 ID 解码(层级类目、多级 SID)都通用。
- Best-of-N 作为 RL 潜力的廉价探针:上线 RL 前先用 Best-of-N 评对齐 backbone 的推理上限,预测收敛点,省去反复 RL 试错。
- 混通用数据防遗忘:推荐专属 SFT/RL 会严重侵蚀通用能力(GSM8K 0.685→0.006),混通用推理数据是必要保险——对要保留通用对话/解释能力的电商 Agent 尤为关键。
- “短而精”的推理:RL 自发缩短推理链同时提升精度,提示线上推理式推荐不必追求长 CoT,可在延迟与效果间取得好折中。