PLUM: Adapting Pre-trained Language Models for Industrial-scale Generative Recommendations
Google DeepMind × YouTube
把预训练 LLM(Gemini-1.5 MoE)改造成 YouTube 工业级生成式召回模型。三阶段:Semantic ID 物品 token 化(SID-v2,多模态融合+多分辨率码本+共现对比)、领域续训 CPT(SID 词表对齐文本)、生成式召回 SFT(beam search 自回归生成下一视频 SID)。相比大 embedding 表召回模型,样本效率更高、有效曝光多样性大幅提升,已上线 YouTube 服务十亿级用户。
核心思路
工业推荐长期被「大 embedding 表」范式主导(LEM, Large Embedding Models):item ID / 高基数类别特征用海量 embedding 表表征,绝大部分参数压在 embedding 层,神经网络很薄。这套范式擅长「记忆」用户-物品交互,但与 LLM 的 scaling 方向(把参数压在神经网络、把输入压成紧凑 token)背道而驰,且训练大 Transformer 需要海量数据、成本高。
PLUM 的核心主张:把物品表示从 embedding 表迁移到离散 token(Semantic ID),让模型复杂度从输入 embedding 转移到神经网络本体,从而能直接复用预训练 LLM 的序列建模能力和世界知识。 整个 pipeline 三段式,对齐 LLM 训练范式:
- Item tokenization(SID-v2):每个 item → 一串离散 codeword(语义 ID),用 RQ-VAE 量化。在 TIGER/RQ-VAE 基础上做三项改进:多模态内容融合、多分辨率码本+渐进掩码、共现对比正则。
- Continued Pre-Training(CPT):扩充预训练 LLM 词表加入 SID token,在「领域 item 数据 + 用户行为序列 + 通用文本」混合语料上继续 next-token 预训练,把 SID 这个新模态对齐到 LLM 既有知识。
- Task-specific SFT(生成式召回):decoder-only 模型自回归生成用户下一个会交互视频的 SID,beam search 解码出候选集,再映射回真实视频。无需维护独立 item 索引,也绕开了 embedding 召回的点积表达力上限。
关键工程结论:PLUM 召回模型 dense 参数是 LEM 的 100 倍,但因为收敛快、样本效率高,整体训练成本与 LEM 相当(< 0.55x FLOPs,每天只训 ~250M 样本 vs LEM 的数十亿),已在 YouTube 长视频和 Shorts 多个核心场景上线。
整体实现思路
三阶段串联,每阶段产出下游阶段的输入:
- SID 模型离线训练好后,对全量 item corpus 做量化,得到每个 video 的 SID 元组(5 级 codeword)。这套 SID 词表是后续所有阶段的「物品语言」。
- CPT 在通用预训练 LLM checkpoint(Gemini-1.5 MoE 家族)基础上,把 SID token 加入词表,用混合语料续训。产出一个「SID 与文本语义已对齐」的 base checkpoint,本身已具备基于用户历史生成下一视频 SID 的能力,还保留了 few-shot in-context learning(能在 SID 上下文里续写合理文本)。
- 生成式召回 SFT 从 CPT checkpoint 出发,引入更丰富的实时上下文特征、用 reward 加权采样,专门优化召回任务。线上用 beam search 解码多条 SID 序列作为候选。
子模块实现(可复现细节)
1. Semantic ID(SID-v2)
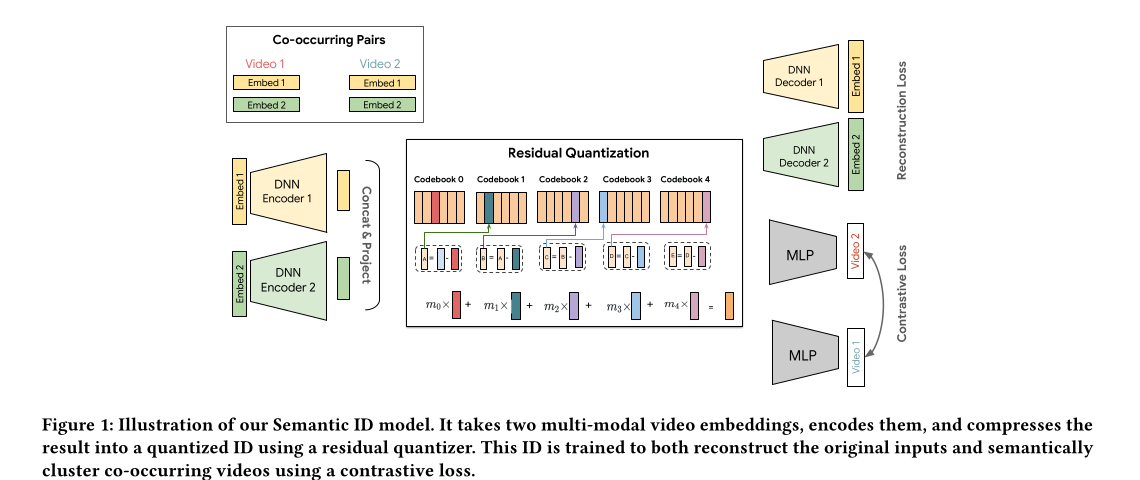
SID 是从 item 内容特征导出的离散 codeword 元组,两阶段:(a) 把高层内容特征编码成稠密语义 embedding;(b) 把该 embedding 量化成分层 codeword 元组。基于 RQ-VAE(Residual-Quantized VAE)。三项改进:
(a) 多模态内容融合(Fused Multi-Modal)
- 输入:每个 item 一组异构 embedding 向量 (如视频的文本元数据 / 视觉 / 音频 embedding)。
- 每个模态 过独立 embedding encoder 编码成隐向量 ,再 concat ,过一个 projection 得到统一特征向量 。
- 与 MMQ(每模态生成不同 token)不同,PLUM 直接 concat 多个 content embedding 再用 MLP 编码,灵活支持任意多个 embedding 源。
(b) 分层量化精炼
- 多分辨率码本(Multi-Resolution Codebooks):放弃 prior 的固定均匀分辨率码本(导致 SID 空间巨大且稀疏、大量码字组合从未被分配)。码本基数随量化层级递减:。即 level0=2048、level1=1024、level2=512…前几级高分辨率最具判别力,后续级编码低熵残差用低分辨率,SID 更紧凑高效。
- 渐进掩码(Progressive Masking):强化分层可解释性。定义二值掩码 , 为码本层级,,其中 是随机整数、 是总码本层数。训练时随机只选前 级码本参与(强迫前缀层级自身可重建)。
(c) 共现对比正则(Co-occurrence Contrastive)
- 动机:纯内容导出的 SID 不一定符合「用户视角的相似」。常被一起观看的视频往往语义相关。多数 prior 把 CF item embedding 融进 content embedding,但 CF embedding 随热度动态变化、需频繁重训量化器;PLUM 改用 CF 信号作对比损失目标来引导量化器,避免重训。
- 损失(batch 内 个视频, 是含正样本对的展开):
其中 是 batch 内某视频表示, 是与视频 共现的视频表示, 是点积相似度。鼓励共现视频生成相似 SID、推远不共现的。
(d) 总损失
- 重建:(每个模态各自重建)。
- 残差量化:, 是第 级码本中最近码字, 是递归残差(), 为 stop-gradient。
- 最终量化向量带渐进掩码加权求和:,再喂给每个解码器 重建 。
2. Continued Pre-Training(CPT)
目标:建立一个 SID token 语义已 grounding、且与 base LLM 文本 token 对齐的 base checkpoint。next-token 预测,语料两类各占 50%:
- 用户行为数据(个性化 / watch history):每条样本是用户观看历史 + watch 特征。schema 示例:
wh = <sid_1> <channel_name> <watch_ratio> <watch_time> <hours_since_final_watch> <sid_2> <channel_name> ... || <sid_n> - 视频元数据语料(建立 SID↔文本关联):每条含视频 SID、title、description、ASR 字幕、channel 名、合成数据。schema 示例:
- SID+title:
Video <sid> has title (en): <video_title> - SID+topics:
The topics in video <sid> are: <topics>
- SID+title:
训练配置:50%/50% 混合;1M steps,batch size 16,约 260B tokens。评测三块:基于用户历史生成 SID 的性能、held-out 视频元数据上 SID+语言联合建模能力、标准文本 benchmark 上通用语言能力退化追踪。CPT 后模型保留自由文本生成 + few-shot ICL 能力(附录例子:能在「The video
3. 生成式召回 SFT
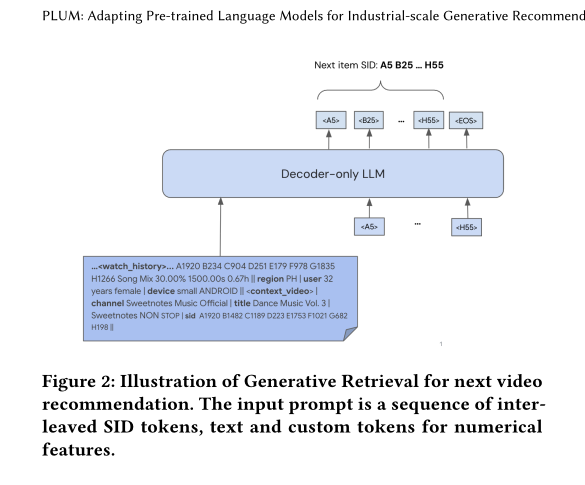
从 CPT checkpoint 出发,标准自回归最大似然,预测 ground-truth 视频(用户日志中 clicked 视频)的 SID token:
- 是 clicked 视频 的 SID, 是每次 click 的手工 reward 信号。
- 实操:按 reward 采样训练样本,采样后在 loss 里等权(而非直接 reward 加权),控成本。
- 输入 prompt 是 SID token、数值特征 custom token、文本特征交错的序列,格式:
watch history | user features | context video features,watch history 是按时序的观看序列(每次观看=SID token+其他特征 token concat)。本研究固定输入序列长 1,536 tokens,约覆盖最近 100 次观看 + 其他特征。SFT label 用 YouTube 上的 next watch,按用户 engagement/satisfaction 信号下采样。
推理:beam search 解码多条 SID 序列作为召回候选,每条 SID 映射回十亿级 corpus 中真实视频。可能产生无效 SID(hallucination)或 SID→video 碰撞,但实测 SFT 后 hallucination 率 < 5%,SID→video 映射唯一性高。beam search 比随机解码效果好(牺牲一些多样性)。
实验设置与结果
主实验:生成式召回 vs LEM 生产模型
- 模型:从 Gemini-1.5 MoE 家族训的 900M 激活参数 PLUM 模型(总参约 4.2B),同时覆盖长视频 LFV 和 Shorts,从 Gemini warm-start,持续 fine-tune 新 engagement 数据,beam search 解码。
- Baseline(LEM):当前生产最优召回模型,高度优化(可溯到 Chen et al. 2019),同为 Transformer 但参数主要在 embedding 层,input/output item ID 词表 O(10M)。LEM 神经网络仅占总参 0.4%,PLUM 占 90%。
推荐质量(数字均为 PLUM/LEM 比值):
| Metric | LFV | Shorts |
|---|---|---|
| Effective Vocab Size(覆盖 95% 曝光所需 unique 视频数) | 2.60x | 13.24x |
| CTR | 1.42x | 1.33x |
| WT/View(观看时长) | 0.72x | 1.13x |
| WF/View(观看比例) | 1.32x | 1.03x |
PLUM 有效词表大幅扩大(更利于个性化长尾发现),用户反应指标整体有竞争力(LFV 上 WT/View 略低)。
线上 A/B(把 PLUM 召回加入候选池;为公平,给生产最优召回模型加同等 quota 作为 baseline LEM+,报相对 LEM+ 的变化):
| Metric | LFV | Shorts |
|---|---|---|
| Engaged Users | +0.07% | +0.28% |
| Panel CTR | +0.76% | +4.96% |
| Views | +0.80% | +0.39% |
| Satisfaction | +0.06% | +0.39% |
证明 PLUM 能在现有系统之上贡献增量价值,且是 YouTube 首个无大 embedding 表的神经召回模型。
样本效率:900M MoE 每天训 ~250M 样本,LEM 每天数十亿;训练 < 0.55x FLOPs(单样本训练成本更高,但收敛快总成本相当)。
SID-v2 消融
900M MoE PLUM 召回(无 CPT、去掉 prompt 中 watch history 的简化设置)。报 SID 唯一性 + Video Recall@10:
| SID Model | SID Uniqueness | VID Recall@10 |
|---|---|---|
| SIDv1(baseline,prior TIGER) | 94.0% | 12.3% |
| SIDv2(本文) | 96.7% | 14.4% |
| Ablate Multi-Resolution | 94.8% | 13.2% |
| Ablate Multi-Embedding | 96.9% | 12.8% |
| Ablate Co-occurrence | 91.8% | 12.6% |
所有改进都提升召回;其中共现对齐对 SID 唯一性和 recall 提升最大(去掉后唯一性掉到 91.8%、recall 掉到 12.6%)。
CPT 与预训练 LLM 影响(2×2 消融,MoE-900M)
| Model | 预训练 LLM | CPT | Recall@10(第 8 天) |
|---|---|---|---|
| R1 | No | No | 0.19 |
| R2 | Yes | No | 0.23 |
| CR1 | No | Yes | 0.27 |
| CR2(完整 PLUM) | Yes | Yes | 0.28 |
结论:(1) CPT 帮助巨大(R1→CR1:0.19→0.27;R2→CR2:0.23→0.28),且带 CPT 的模型收敛快得多——多下游任务共享同一 CPT 模型时尤其划算。(2) 从预训练 LLM 初始化一致优于随机初始化(无论有无 CPT),作者推测来自 LLM 既有的自然语言理解 / 通用序列处理能力可直接迁移到推荐。
Scaling 研究
Gemini-1.5 MoE 四档:MoE-110M / 370M / 900M / 3B(激活参数),总参 <1B 到 >10B。数据:YouTube「下一个看什么」场景,候选生成阶段,corpus 十亿级视频。输入序列固定 1,536 token;训练用 2025 年 7 月连续 7 天 shuffle 数据,评测第 8 天。硬件:1,024 块 v6e TPU(32GB HBM),4 个 trainer 并行各 256 TPU。所有模型从各自 CPT checkpoint(Iso-FLOPS )warm-start,CPT FLOPs 不计入。
超参(恒定学习率,batch 饱和 HBM):
| Model | Learning Rate | Global Batch Size |
|---|---|---|
| MoE-110M | 1e-4 | 25,600 |
| MoE-370M | 7e-5 | 15,360 |
| MoE-900M | 5e-5 | 7,680 |
| MoE-3B | 2e-5 | 3,584 |
发现:(1) 训练 loss 对 Iso-FLOPS 呈幂律,随预算增加最优模型尺寸从 110M→370M→900M 逐步右移;(2) 评测 loss 也幂律但最终饱和,且评测 loss 前沿比训练 loss 更早移向大模型——大模型对未来数据分布泛化更好;(3) 评测 Recall@10 放缓迹象更弱,随算力持续提升;小模型已过多个 epoch(MoE-110M 训了 4.24 epoch 仍无过拟合)。
局限:MoE-3B 在所考虑算力预算下未超过 MoE-900M。原因可能是超参未调优——同等训练资源下大模型 batch 被迫更小(HBM 限制),训练末 MoE-3B 只过了 0.57 epoch(约 5B 样本),比第二大模型差 2x+。结论:generative retrieval 的 compute-optimal 训练需要训练样本量与模型尺寸同步 scaling。
思考与可参考价值
对电商 / 搜推的可借鉴点:
-
「embedding 表 → 离散 SID + 厚神经网络」的迁移路径是工业可行的,且关键卖点不是绝对指标碾压,而是样本效率 + 有效词表多样性。电商场景 item 长尾、冷启动严重,PLUM 把 LEM 的 13x Effective Vocab Size(Shorts)拉起来,对长尾商品曝光分发很有参考价值。本文也是「首个无大 embedding 表的上线神经召回」,给想摆脱海量 item embedding 表运维负担的团队一个落地样本。
-
SID-v2 三件套都可直接拿来用:多模态 concat+MLP 融合(比 MMQ 的逐模态 token 更灵活)、多分辨率码本(,省 SID 空间)、共现对比正则(消融里增益最大)。尤其「用 CF 信号做对比损失目标、而非把动态 CF embedding 融进 content」这招,规避了量化器频繁重训——电商热度变化快,这个工程考量很实在。
-
CPT 是被严重低估的一步:2×2 消融显示 CPT 的增益(0.19→0.27)大于预训练 LLM 初始化的增益(0.19→0.23),且 CPT 模型收敛快、可被多个下游任务(召回 / 排序 / 个性化搜索)共享。对想搭统一推荐 foundation model 的团队,CPT 是核心枢纽而非可选项。
-
生成式召回绕开点积上限 + 不维护独立索引,beam search hallucination < 5% 在工业级 corpus 上是可接受的,这打消了「生成式召回会大量产无效 ID」的顾虑。
局限与开放问题:
- 主实验只报相对 LEM 的比值,无绝对数;A/B 增量偏小(多数 +0.x%,Shorts Panel CTR +4.96% 是亮点)。LFV 上 WT/View 0.72x 说明长视频观看时长仍弱于 LEM,并非全面碾压。
- Scaling 在 3B 处失败(未超 900M),作者归因于超参/batch 受限而非方法上限,但这意味着「scaling 必然更好」尚未被证实,落地选型仍需按算力预算挑最优档。
- 模型是 Gemini-1.5 MoE + 1024 TPU + 260B token CPT,复现门槛极高,无开源代码。中小团队更现实的是借鉴 SID-v2 设计 + CPT 思想,用更小的开源 LLM 试。
- 只做了召回,排序 / 个性化搜索 / SID 与自然语言无缝混合生成、候选多样性新解码策略都列为 future work——这些恰是电商 Agent 化推荐(生成式排序、对话式推荐)可接力的方向。