OneRec-Think: In-Text Reasoning for Generative Recommendation
Kuaishou
把「显式可控的文本 CoT 推理」装进生成式推荐——同一个 LLM 在一次自回归里先吐 <think> 推理、再吐目标 item 的 semantic ID,统一了对话/推理/个性化推荐三件事。三阶段训练(Itemic Alignment 把 item token grounding 进语言空间 → Reasoning Activation 用剪枝上下文蒸馏 CoT → Reasoning Enhancement 用 Rollout-Beam reward + GRPO 强化),并提出 Think-Ahead 部署架构把重推理离线化、在线只做受约束补全。快手短视频线上 App Stay Time +0.159%,公开 benchmark SOTA。
核心思路
OneRec 这一类端到端生成式推荐(GR)把推荐重写成 seq2seq:把每个 item 编成一串 itemic token(semantic ID),模型自回归地把用户历史 token 序列直接解码成下一个目标 item 的 token。它们成功地把 LLM 的「生成」能力用进了推荐,但本质上仍是 隐式预测器(implicit predictor)——只会直接吐答案,丢掉了现代 LLM 最值钱的能力:显式、可解释、可控的链式推理(CoT)。
OneRec-Think 的核心命题:让同一个 LLM 在一次自回归里先生成文本推理 τ,再生成目标 item 的 itemic token,把「对话 + 推理 + 个性化推荐」统一进一个模型。形式化地,传统 GR 是
OneRec-Think 改写为先推理后推荐的单次自回归:
其中 是文本 rationale, 是为推荐构造的 prompt。
为把这件事真正做稳,作者点出两个非平凡难点,并对应设计了三阶段:
- 语义鸿沟:itemic token 是离散、随机初始化的新 token,和 LLM 的连续语言空间是割裂的,不对齐就没法在它上面做语言推理 → Itemic Alignment。
- 工业序列又长又噪:真实用户行为序列冗长、噪声大,直接让模型 CoT 会推不出有效推理 → 先在剪枝过的「干净上下文」里蒸馏出推理轨迹,再迁移到原始噪声序列 → Reasoning Activation。
- 奖励稀疏 + 用户偏好多解:推荐里大多数 rollout 命不中目标 item,pass reward 全 0,GRPO 的组内 advantage 被抹平;而且用户「下一个会点什么」本就有多个合理答案(multi-validity)→ Rollout-Beam reward + GRPO。
最后用 Think-Ahead 架构解决「多步推理 vs 实时延迟」的部署矛盾。
整体实现思路
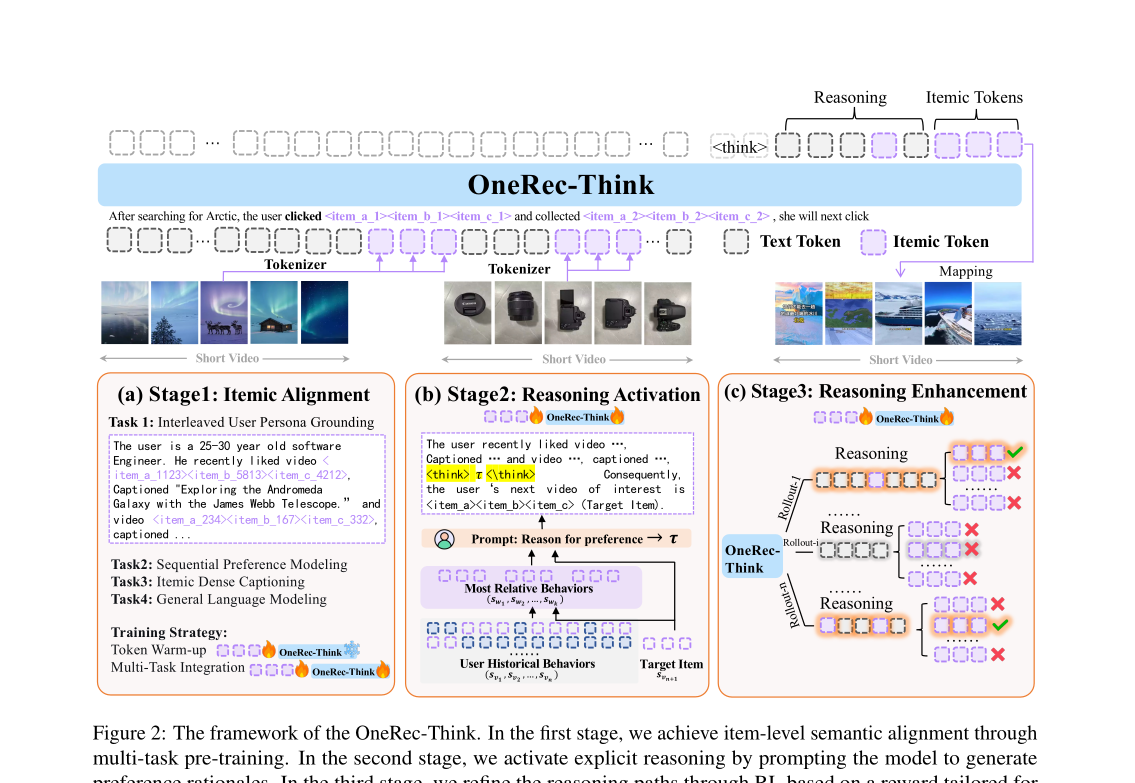
三阶段串行训练 + 一套部署架构:
- Stage 1 · Itemic Alignment(多任务预训练):把 recommender 知识 grounding 进 LLM 语言空间。四个 NTP 任务混训,并切成两子阶段:先 Token Warm-up(冻结 backbone,只训新 item token embedding),再 Multi-Task Integration(解冻全参/或 LoRA 联合训)。
- Stage 2 · Reasoning Activation(SFT 激活推理):先用相似度函数把用户历史剪枝成 top-k 最相关 item,让已对齐的模型在干净上下文上生成高质量 rationale(蒸馏);再用这些 rationale 当监督,教模型从原始噪声序列里既生成 rationale 又预测目标 item(contextual distillation)。
- Stage 3 · Reasoning Enhancement(RL 强化):在 GRPO 框架下,用 Rollout-Beam reward——对每条 CoT rollout 做 beam search,取 beam 内与目标 item token 逐位匹配数的最大值作为奖励,缓解 0/1 稀疏奖励问题。
- 部署 · Think-Ahead:离线用全量 OneRec-Think 跑推理 + 生成 item 的前两级 token(粗意图),缓存成候选前缀集合;在线用实时更新的轻量 OneRec 在「前缀受约束」的空间里补全最后一级 token,兼顾推理质量与延迟。
主干模型:公开 benchmark 用 Qwen3-1.7B,工业用 Qwen-8B。
子模块实现(可复现细节)
Stage 1 · Itemic Alignment
itemic token 词表。工业场景:3 级层次化 semantic ID,每级 8192 token,共扩词表 24,576 个新 token,外加两个边界 token <|item_begin|>、<|item_end|>。公开 benchmark:4 级 semantic ID,每级 256 token,共扩 1,024 token + 两个边界 token。
四个预训练任务(NTP):
- Interleaved User Persona Grounding:把 itemic token 与自然语言交错——序列化静态画像(如「25-30 岁男性,北京」)、主动搜索词、点赞/评论/关注等带 caption 的行为、用户兴趣总结,强制建立 item token ↔ 真实语义的双向映射。
- Sequential Preference Modeling(核心推荐任务):给最近交互序列(最长 256 item),预测下一个 item,loss 只算在目标 item 的 token 上。
- Itemic Dense Captioning:给一个 itemic token,生成它的文本描述,loss 算在目标文本上——让模型能反向把 item token 翻成语义。
- General Language Modeling:混通用语料续训,保住语言能力不退化。
两子阶段 + 任务配比:
- Token Warm-up:冻结 LLM backbone,只训新 item token embedding,学习率 5e-4(高 lr 让随机初始化 embedding 快速收敛到语义空间合适位置)。工业用 6B token 的 Interleaved Persona Grounding 语料。
- Multi-Task Integration:公开 benchmark 训全参;工业解冻 backbone 用 LoRA,学习率 3e-4。任务配比(Table 5):Sequential Preference Modeling 65.73%、Interleaved User Persona Grounding 24.30%、Itemic Dense Captioning 4.94%、General LM 5.03%。配比刻意保留语义/captioning 任务,防止模型把 item token 退化成普通无语义 ID。
Stage 2 · Reasoning Activation
Bootstrapping with Pruned Contexts(蒸馏干净 rationale):对每个 (history, target) 对,用相似度函数 (基于预训练 item embedding 的 cosine 相似度)取 top-k 最相关历史 item(实验 k=10):
再用已对齐模型,在这剪枝上下文上生成解释「为什么这个用户会交互目标 item」的 rationale:。得到的 rationale 逻辑自洽、与目标对齐。
Learning to Reason from Noisy Sequences(迁移到原始序列):用上一步蒸馏的 rationale 当监督,目标是在完整噪声历史上同时生成 rationale 和目标 item,loss 为两段 NLL 等权之和:
第一项学「从噪声序列里内部蒸馏出连贯推理」,第二项学「在推理条件下准确预测目标 item」。公开 benchmark 因序列短稀疏,改用人工构造的 category-based CoT 作为剪枝内容,保证语义引导稳定。训练:全参 / 工业用 LoRA,lr 3e-4。
Stage 3 · Reasoning Enhancement(Rollout-Beam reward + GRPO)
问题:标准 verifiable pass reward 在推荐里极稀疏——绝大多数 rollout 没命中目标 item,奖励全 0,GRPO 组内 advantage 被抹平。
Rollout-Beam reward:不要求一步命中,而是评估「模型在一个受约束 beam 内能达到的最好表现」。生成完推理轨迹 τ 后,在分布 上做 width- 的 beam search 得候选集 ,奖励取 beam 内与目标 item token 逐位匹配数的最大值:
这把「用户偏好多解」转成更稠密的奖励信号,且 reward 计算与 beam-search 推理对齐(train-inference consistency)。
RL 超参:框架 VERL,算法 GRPO;每步采 条 CoT path,每条做 width K=32 的 beam search 算 reward;训练 2 epoch,lr 1e-5,KL 系数 ,clip ratio 。
部署 · Think-Ahead 架构
把推理解耦成离线/在线两段,解决「重推理 vs 实时延迟」。
Stage 1(离线,Reasoning-Guided Prefix Generation):对用户 u 的历史 ,采 T 条多样推理路径 ;对每条路径只 beam search 解码 item 的前两级 token(捕捉粗意图):
把所有路径的前缀并起来得用户个性化候选前缀空间 (含 T×m 个高潜前缀),缓存进分布式存储。
Stage 2(在线,Prefix-Constrained Finalization):请求到来时取 ,用实时更新的轻量 OneRec()在「前两级 token 必须 ∈ 」的约束下补全最后一级 token:
工业层次 token 。这样重推理离线跑、在线只做受约束的最后一跳,既留住推理质量又满足延迟。
工业训练 pipeline:每日增量训练,80 张旗舰 GPU,每天处理约 20B token 追新用户数据。
实验设置与结果
公开 benchmark
数据:Amazon review 的 Beauty / Toys / Sports;leave-one-out 切分;丢交互<5 的稀疏 user/item;历史最长 50 item;评估 beam width=10。 baseline:经典序列模型 BERT4Rec / HGN / GRU4Rec / SASRec;生成式 TIGER / HSTU / ReaRec。 指标:R@5/10、N@5/10。
主结果(Table 1,OneRec-Think vs 次优;粗体=最优):
| 数据集 | 指标 | 次优(谁) | OneRec-Think | 相对提升 |
|---|---|---|---|---|
| Beauty | R@5 | 0.0450 (ReaRec) | 0.0563 | +25.1% |
| Beauty | N@5 | 0.0280 (HSTU) | 0.0398 | +42.1% |
| Beauty | R@10 | 0.0704 (ReaRec) | 0.0791 | +12.4% |
| Sports | R@5 | 0.0268 (HSTU) | 0.0288 | +7.5% |
| Sports | N@5 | 0.0173 (HSTU) | 0.0199 | +15.0% |
| Toys | R@5 | 0.0523 (ReaRec) | 0.0579 | +10.7% |
| Toys | N@5 | 0.0300 (SASRec) | 0.0412 | +37.3% |
| Toys | N@10 | 0.0376 (ReaRec) | 0.0482 | +28.2% |
结论:带推理的架构(ReaRec、OneRec-Think)整体优于传统序列与纯生成式;OneRec-Think 在所有 benchmark 全部最优,尤其 NDCG 提升最猛(说明排序质量提升明显)。
消融(Table 2,Beauty):每个组件都不可或缺。
| 配置 | R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|
| Base(裸 itemic token 序列) | 0.0460 | 0.0654 | 0.0314 | 0.0377 |
| Base + IA(加 Itemic Alignment) | 0.0532 | 0.0735 | 0.0342 | 0.0402 |
| Base + IA + R(加推理增强,full) | 0.0563 | 0.0791 | 0.0398 | 0.0471 |
Itemic Alignment 提供语义地基,推理机制再叠一层显著增益(N@5 0.0342→0.0398)。
工业(快手短视频,亿级 DAU)
线上 A/B:1.29% 流量实验组,对比线上模型一周。主指标 App Stay Time +0.159%(工业里 0.1% 即显著),且 Watch Time +0.169%、Video View +0.150%、Follow +0.431%、Forward +0.758%、Collect +0.098%、Like +0.019% 全正。
Itemic Alignment 工业消融(Table 4,BertScore):评 Token Warm-up(TW) 与 Multi-Task Integration(MI)。
| Benchmark | Qwen3 (Base) | +TW | +TW+MI |
|---|---|---|---|
| User Understanding | 0.6588 | 0.6492 | 0.7053 |
| Short Video Understanding | 0.6031 | 0.6443 | 0.7300 |
文本重的 User 任务上 TW 增益有限(LLM 本就能处理文本),MI 才带来大跳;纯 item token 的 Short Video 任务上 TW、MI 各自递增——印证两子阶段对「解释非文本 item 信息」都必要。
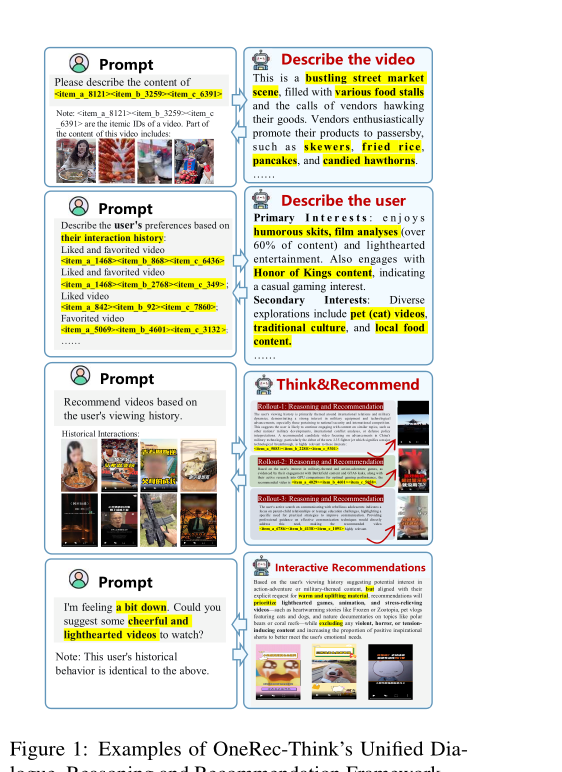
Case Study:(1) 对话场景(Fig 3)用户表达负面情绪时,模型主动把推荐从一般兴趣切到轻松治愈内容;(2) Fig 4 生成细粒度推理路径(具体玩法机制/叙事模式),超越粗主题匹配;(3) Fig 5 在中间推理步做 beam search,推理文本与推荐 item 强一致——证明推理是真正驱动生成而非事后辩护;(4) Fig 6 itemic-textual 交错推理:item token 做内容锚点、文本 token 做因果articulation。
思考与可参考价值
局限(作者自陈 + 观察):
- 公开数据撑不起推理:Amazon 序列短、item 空间小,Reasoning Activation/Enhancement 学不出工业级推理质量,作者在公开 benchmark 上是「简化版」(用人工 category CoT 代替蒸馏 rationale)。真正的推理价值主要靠工业数据兑现,可复现性打折。
- 线上增益与「推理」的因果不够干净:Think-Ahead 在线最后一跳实际是实时 OneRec 补全,+0.159% 里有多少来自「显式推理」、多少来自工程化召回扩展(前缀候选空间变大),没有拆分消融。
- 推理成本高:RL 每步 16 path × beam 32,且 Think-Ahead 要离线缓存 T×m 前缀,存储与算力开销不小。
- 奖励仍是 token 逐位匹配,未引入观看时长/转化等业务稠密反馈(作者把 dense RL reward 列为 future work)。
对电商/搜推/Agent 的可借鉴点:
- Rollout-Beam reward 思路通用:凡是「目标稀疏、多解、pass reward 全 0」的 RL 推荐/检索(电商 query→商品、广告召回),都可以把 reward 从「是否命中」换成「beam 内最佳逐位匹配数」,把多解性转成稠密信号,且让 reward 与线上 beam-search 推理对齐——这是缓解 GRPO advantage 塌缩的实用 trick。
- Think-Ahead 解耦是工业上推理落地的关键范式:把重 CoT + 粗粒度意图(前 2 级 semantic ID)离线算好缓存,在线只做「前缀受约束」的最后一跳。任何想把慢思考塞进低延迟链路的系统(Agent 调用、个性化排序)都可借这套「离线思考物化成候选前缀 / 在线约束补全」的两段式。
- Itemic Alignment 的 captioning + interleaved grounding:把 semantic ID grounding 进语言空间、并刻意在任务配比里保留 captioning/persona 任务防止 ID 退化成无语义符号——对任何用 semantic ID 的电商 LLM4Rec(商品/广告/SID)都是必要的「保语义」工程纪律。
- 剪枝上下文蒸馏 CoT 再迁移噪声序列:工业行为序列又长又噪直接 CoT 推不动,先在 top-k 相关 item 的干净上下文里蒸馏 rationale、再迁移——这套 contextual distillation 配方对「长噪声用户序列上做可解释推理」很可复用。
- 可解释性变现:显式 rationale 既能提精度,又天然支撑对话式可控推荐(按用户即时约束调整)与用户信任,是把推荐做成「可对话 Agent」的现成抓手。