OneReason Technical Report
Kuaishou
把 LLM 的「先想再答」真正做进生成式推荐,并第一次让「思考模式」在真实推荐基准上稳定超过「不思考直接出结果」。核心论点是把推荐推理拆成 感知(Perception) 与 认知(Cognition) 两根地基——感知=让 itemic token ground 到底层语言语义(不再是 opaque ID),认知=把用户行为序列重组成由粗到细、逻辑连贯的兴趣点链。并提出推荐推理是「溯因(abductive)」而非「演绎」:无唯一答案、意图不可观测,只能假设潜在兴趣点→建模演化→论证候选契合。快手本地生活广告线上落地,组合部署曝光 +10.33% / 收入 +8.23%,ROI>5。
核心思路
一句话问题:OneRec 系列已经吃到了生成式推荐的「Scaling 红利」(短视频/直播/广告/电商全面落地),但第二个红利——「Reasoning(先想再答)」——一直激活不了:前作 OneRec-Think / OpenOneRec 成功把「think-before-answer」形式泛化到推荐,却出现反常现象——思考模式在推荐指标上并不比不思考强。
关键 idea:作者借多模态大模型(MLLM)的「同病」诊断根因——当模态没对齐时,模型会机械地「读」表面信号而非真推理。映射到生成式推荐:itemic token(离散 item ID)与文本 token 共享隐空间但错位,CoT 越长,泛文本先验越占主导、稀释 ID 证据(论文称之为 textual inertia,引自 Zhang et al. 2026b 对 OpenOneRec 的诊断)。因此真正会「思考」的推荐模型需要两根支柱:
- 感知(Perception):让 itemic token ground 到底层语言语义,成为可指代、可组合的语义单元,而不是 opaque identifier。
- 认知(Cognition):在对齐的基础上,用由粗到细、逻辑连贯的 CoT 结构 scaffold 对用户历史和 item 属性的深思熟虑。
更上层的范式判断:推荐推理是「溯因(abductive)」而非「演绎(deductive)」。经典数学/代码推理有唯一答案、约束确定;而推荐同时容许多个合理 item、用户意图永不可直接观测,只能从一长串历史 itemic token 里假设潜在兴趣点 → 建模其时序演化 → 论证候选为何契合当前上下文。这一判断直接驱动了训练与评测设计:把推荐推理沿两个维度分解成 4 个诊断能力 R0 感知 / R1 推导 / R2 演化 / R3 推荐。
骨干 Qwen3-8B,开源 OneReason-8B / OneReason-0.8B。
整体实现思路
端到端 pipeline 为 预训练(感知)→ SFT(认知 CoT)→ RL(先专精后统一)→ 部署(快慢思考),并以自建 OneReason-Bench(按 R0–R3 四层组织)贯穿监控每一步。总体架构如下图:
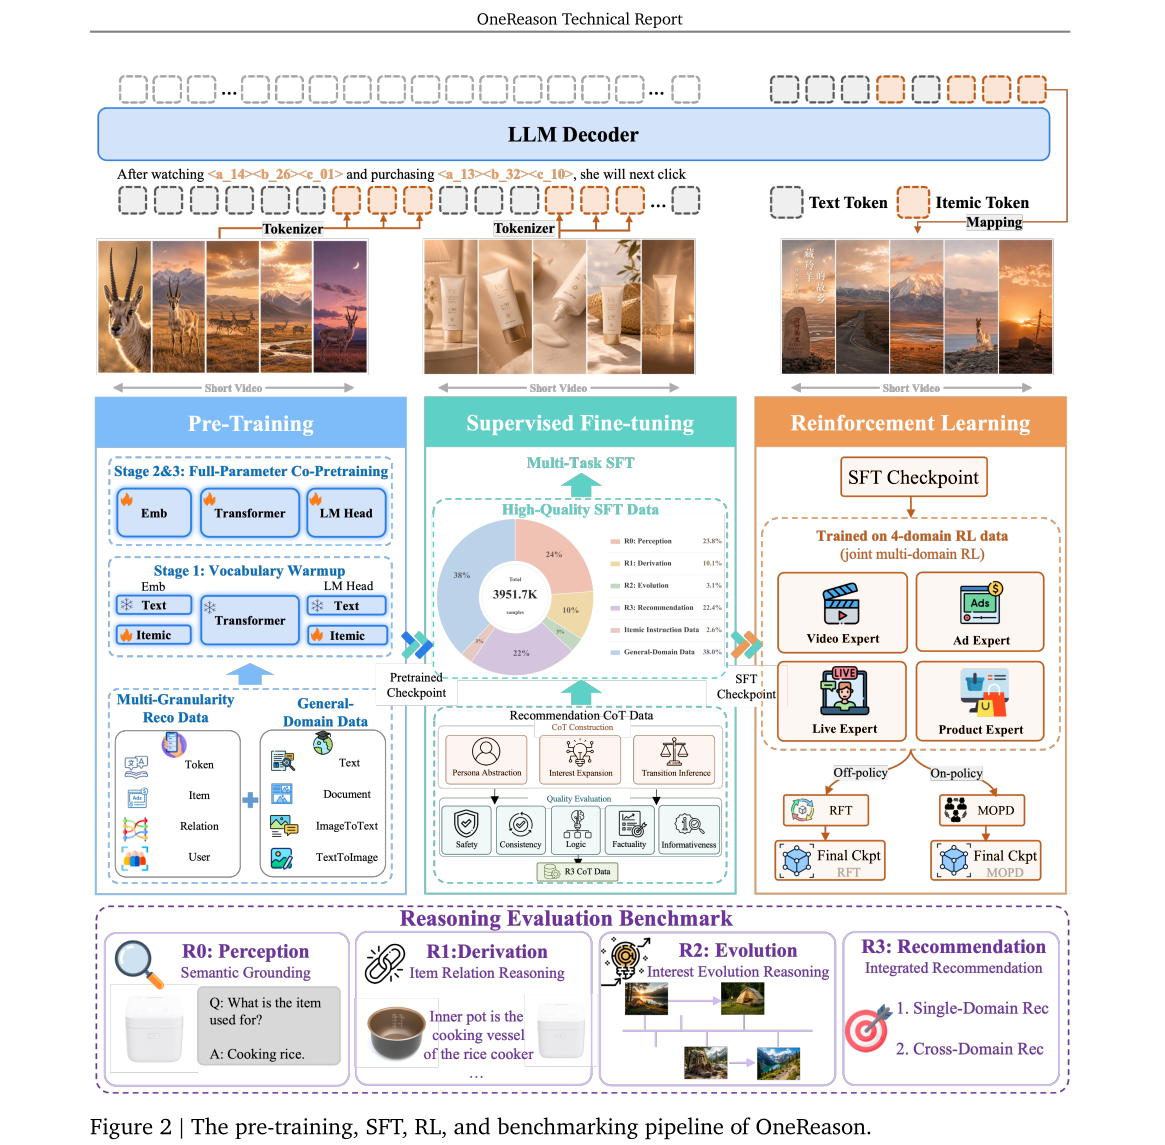
四个阶段的职责分工:
- 预训练(感知地基):itemic tokenizer 用「内容理解任务」(非对比学习)把多模态内容蒸成 dense embedding,再 RQ-KMeans 量化成离散 token;578B token(合 R0 后总对齐预算)做**四粒度(token / item / relational / user)**对齐,让 item 成为可指代、可组合的语义单元。
- SFT(认知 CoT):沿 R0–R3 层级构造高质量 CoT。R0 把 itemic pattern 显式翻成由粗到细的语义(地基);R1 学单 item → item-to-item 一跳桥;R2 把同兴趣 item 当时序过程建模长/短/周期偏好;R3 把前三者组合成 persona 抽象 → 兴趣扩展 → 转移推断 的标准结构,产出 next-item 决策 CoT。
- RL(先专精后统一):关键发现是多域混合 RL 下思考仍打不过不思考,但单域 RL 时思考稳定胜出 → 每域(Video/Product/Ad/Live)单独 GRPO 训域专家 teacher 先吃满思考红利,再用 RFT(拒绝采样微调)或 MOPD(多教师 On-Policy 蒸馏)合成统一底座。
- 部署(快慢思考):慢链路(近线)离线推理写 Redis 候选池;快链路(在线)用 Thinking Token 把 OneReason 知识蒸进实时 OneRec,规避 8B 实时延迟。
子模块实现(可复现细节)
1. Itemic Tokenizer(离散化 item)
- 输入:item 的多模态内容(封面图、视频帧、文本描述、音频)。Encoder = ViT + 从 Qwen3-VL 初始化的 LLM + audio encoder,蒸成一个 dense embedding;这个 embedding 作为 soft prefix 喂给一个独立 decoder LLM,后接 item 文本描述做 end-to-end 优化(内容理解任务监督,而非对比学习——这是与多数 RQ-VAE 路线的关键区别)。
- 量化:RQ-KMeans,三层 codebook,每层 8192 codes。每个 item = 一个 domain-aware begin token + 三个子 token,形如
<|domain_begin|><a_5028><b_6733><c_2559>,domain ∈ {video, prod, ad, living, sid(通用多模态)}。 - 与 OpenOneRec 不同:丢掉尾部 end token,省下上下文长度留给推理 trace。
- 重要张量约定:第一个子 token
<a_*>大体决定后续解码、捕获粗粒度类目——RL 的多样性奖励就建在「第一位 digit」上。
2. 预训练四粒度语料(感知对齐)
把语料从「按任务类型混训」重构成四个递进粒度,从微观 token 语义到宏观用户行为:
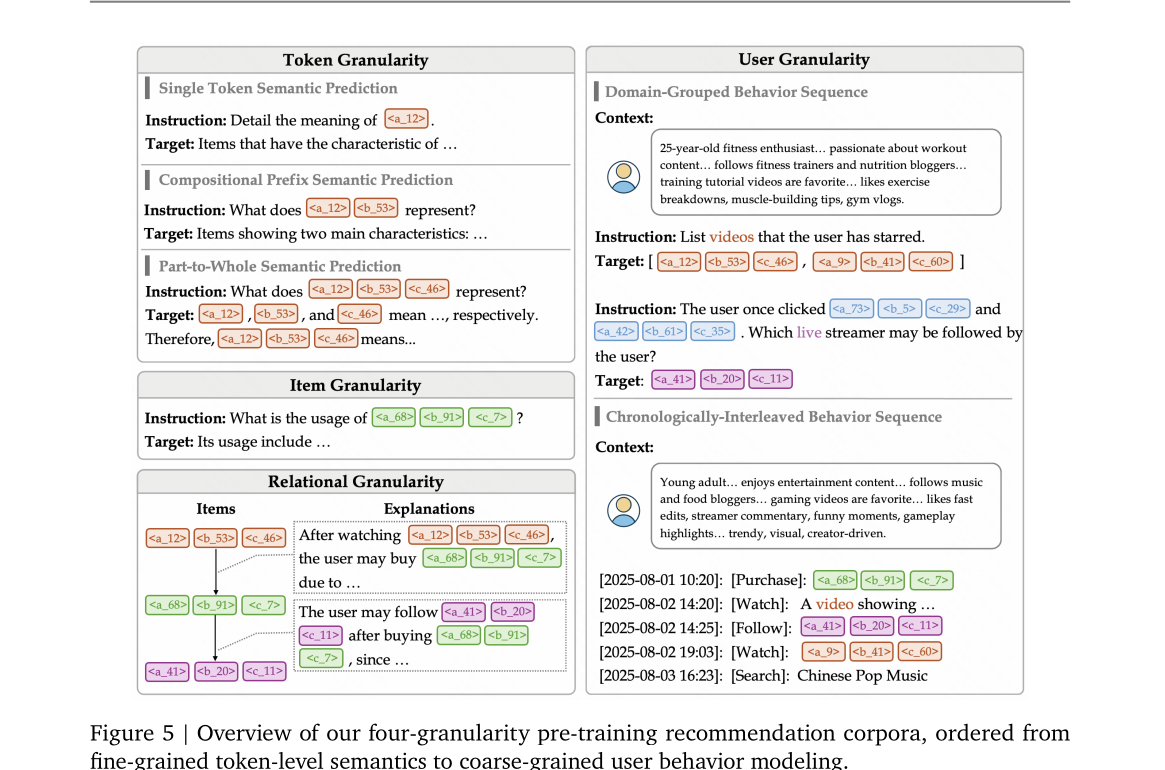
- Token Granularity:显式建模「子 token 语义如何组合成完整 item 语义」。两个新任务:(i) Compositional Prefix Semantic Prediction——预测前缀子 token 对
<a_xxxx><b_xxxx>的合并语义(及反向 Prefix Itemic Token Grounding);(ii) Part-to-Whole Semantic Prediction——先逐个子 token 解释、再综合成整体 caption。 - Item Granularity:itemic pattern ↔ caption 双向映射 + 两项增强:(i) Capacity-Aware Caption Coarse-Graining——因为只有 3 个子 token,必须先把 caption 粗化(去 OCR/ASR/日期/型号噪声;连续属性映射到桶,如精确价格→价格带、精确年龄→「young adult」;保留类目/品牌/IP/卖点/受众骨架),否则强对齐过细 caption 会逼模型幻觉、污染语义空间;(ii) Multi-Perspective Item QA(受众偏好、核心卖点、视觉风格、负反馈理由等多角度)。
- Relational Granularity:用交错序列显式编码协同信号——
Itemic_Pattern0 → Textual_Explanation0 → Itemic_Pattern1 → ... → Itemic_Patternn(公式 1)。 n=1 为 direct item-to-item(来自内部 search-after-play 表);n>1 为 multi-item interest flow(额外用 TagNext CF Relations + 滑窗共现对,并从跨用户全局 item 图采链;为防 trivial,采间隔子链[Item0, Item_interval, Item_2·interval, ...],相邻语义相似度超阈值则丢弃;解释由 LLM 基于中间节点 caption 生成)。 - User Granularity:先用开源 LLM 重写用户画像去噪,再两种格式:(i) Domain-Grouped Behavior Sequences——画像 + 按域分组的 itemic pattern,用多轮 QA 对话动态查询(常用一个域历史去预测另一个域);(ii) Chronologically Interleaved Behavior Sequence——严格按时间戳交错全域行为,并概率性把部分 itemic pattern 替换成对应 caption,逼模型在统一序列里做深度模态融合。
- 通用语料:保留数学/代码/科学/医学/通用指令文本 + 多模态语料(图文/交错文档/图编辑三元组/文生图,仅保留粗粒度视觉语义样本)。数据组合策略:从 instruction-tuned Qwen3 续训,统一 next-token 目标,把噪声 template 业务数据路由进 loss-masked context,只让高质量文本承载 loss;有效训练目标天然约 1:1 QA-style : free-form。
对齐量化指标:作者提出 positive–negative similarity margin(正负对相似度之差,而非孤立报正/负相似度)。Figure 6 显示替换为四粒度语料后,四个域 margin 分布整体右移(Ad 0.0342→0.0530、Live 0.0213→0.0450、Product 0.0589→0.0899、Video 0.0421→0.0715),证明跨模态对齐更强。
三阶段训练 recipe(Table 4,packed 序列 48K token):
| 配置 | Stage 1 | Stage 2 | Stage 3 |
|---|---|---|---|
| 可训参数 | 仅扩展词表 + LM head | 全参 | 全参 |
| 学习率 | 2e-4 → 1e-4 | 1e-4 → 1e-5 | 1e-5 → 1e-6 |
| Token 预算 | 110B | 449B | 19B |
| 单样本最大长度 | 4K | 4K | 32K(全用户历史长程依赖) |
Stage 1 冻结骨干、只让新 itemic embedding 落位;Stage 2 全参吸收推荐知识;Stage 3 放开到 32K 训长历史。
3. SFT 的 R0–R3 认知 CoT
统一任务形式 Y=F(X),X=指令 I + 上下文 C(itemic pattern / 画像 / 历史),Y=itemic pattern / 选项 / 自然语言 / 演化链。两条训练轴:compression(把长噪历史压成 typed persona state + 紧凑兴趣演化 motif) 与 reasoning(R1 一跳桥、R2 时序演化、R3 转移判断)。
-
R0: Perception(约 941K 样本:682K caption + 259K QA)。把预训练学到的层级 itemic-token 空间转成显式 SFT 监督:thinking 变体先逐 token 解释「
<a_*>给粗类型 →<b_*>收窄证据 →<c_*>支撑结论」再产 caption;unCoT 变体直接出 caption 保效率。 -
R1: Derivation(约 400K,从 358K TagNext CF + 388K after-play-search 精炼)。学最小有用的 source-to-follow-up 桥:输入只给 source item(source prompt 不计 loss),输出
<think>桥 + target itemic token。teacher 侧用 flagship LLM 给每对打 explicitly related / unrelated / uncertain,只留可被可见 item 证据直接支撑的对;并抽出 bridge 变量(source need / bridge type / abstract bridge / continuation direction 等)防 target 泄漏。 -
R2: Evolution(约 130K)。从全域时间线抽「演化节点」成候选链,再用独立 LLM-as-Judge 按 11 项标准(order sensitivity、cognitive increment、trigger-source evidence、强因果排他性、evidence closure、no-mind-reading 等)二次过滤,去伪逻辑链/随机消费链/同类漂移/弱接地转移。三个任务族:Evolution Action Selection / Topic Generation / Direct Generation。
-
R3: Recommendation(推荐级组合层)。每样本 = 用户画像
P_u+ 时序时间线H_u+ ground-truth 后续交互y+_u(仅作监督答案,严禁出现在 trace 里)。核心范式 = 两轴压缩 + 转移判断:- persona-type 压缩(稳定偏好先验、人口/生命阶段、节律、内容偏好、价格敏感、交互深度、共享设备歧义);
- interest-evolution-type 压缩(触发搜索、需求扩张、参数收窄、场景延续、饱和替代、跨域回声、浏览→购买闭环)。
形式化三阶段协议(公式 2–3):
其中
C_u压缩用户态、Z_u扩展出的候选兴趣假设集、d目标域、s(·)综合证据强度/近因性/时序连续性/persona 兼容/目标域兼容的评分。对应实现三步:Persona Abstraction → Interest Expansion → Transition Inference。关键超参——兴趣扩展宽度 n:Figure 8 显示
n∈{1,3,5}在四个域上的 think-mode Pass@64/Recall@64 一致优于 n=10/20——候选集太大会带入弱分支、稀释最强转移信号。这与「压缩」视角一致。trace 写作约束(防泄漏/可决策):evidence priority、transition bridge(feedback/bottleneck/认知精炼/场景延续/参数收窄/需求完成,单纯主题相似不够)、granularity calibration(证据够细就别停在粗类目)、conflict resolution、leakage control。trace 质量按 5 维 LLM 打分:Safety 4.94 / Consistency 3.53 / Logic 3.51 / Factuality 4.09 / Informativeness 3.66(Figure 9)。
-
Itemic Instruction Data(约 103K):让含 itemic token 的输入仍可被指令控制(而非自动当成推荐分析),任务涵盖转换/检索/匹配/比较/生成/编辑/摘要 + 显式 instruction-control(如「忽略下方所有 itemic token,回答……」)。
-
General-Domain Data:约 1.5M,取自 Step-3.5-Flash-SFT,去掉 tool-use trace、只留 system/user/assistant 三角色,稳住通用指令遵循。
4. RL:specialize-then-unify
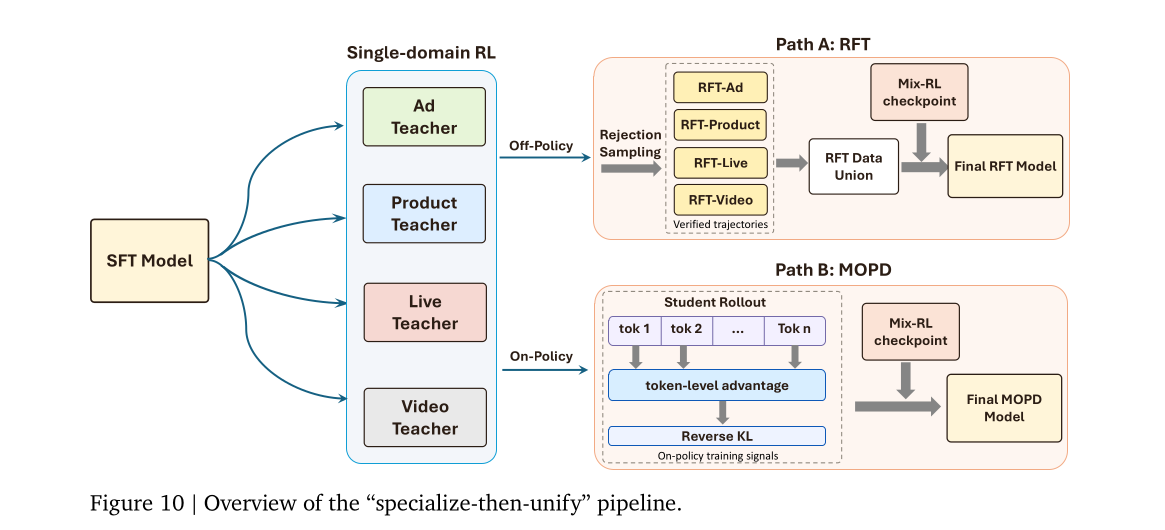
域内 GRPO:对用户 u、上下文 q,采一组 rollout G_u={(CoT_{u,i}, c_{u,i})},每个 rollout 得 outcome reward R_{u,i},组内归一化得相对优势(公式 5):
四个针对推荐稀疏奖励的关键设计:
-
两阶段 rollout(摊销推理成本):每用户先采 N 条 reasoning trace,每条 trace 并行生成 K 个 itemic token 序列
c_{u,i,j}=[<|domain_begin|>, c^{(1)}, c^{(2)}, c^{(3)}](公式 6),得 N×K 个有效 rollout 但只生成 N 条长 trace——奖励覆盖大涨、算力几乎不变(Figure 13 验证:每步训练时间显著降、性能尤其 thinking 模式提升)。 -
多样性奖励(公式 7–9):
R_{u,i,j}=R_rule(c_{u,i,j})·R_div(CoT_{u,i})。R_rule=I[c∈C+_u](是否命中 ground-truth 集);R_div基于同一 trace 派生的 K 个序列里第一位子 token 的不同取值数m^{(1)}_i:鼓励粗类目覆盖,Recall@K 在大 K 时增益更明显(Figure 14)。
-
stage-wise clipping(公式 11–12):reasoning token 用较松 clip 范围
ε_CoT、itemic token 用较紧ε_item——两类 token 行为差异大(trace 长、主探索;itemic 短、直接定奖励),同一 clip 会让 itemic 分布变化过猛、熵塌缩。 -
negative-sample down-weighting(公式 13):命中 rollout 权重 1.0,未命中权重
β<1,压制海量零奖励样本对梯度的主导,防训练塌缩(Figure 16 显示去掉会更易生成非法 itemic token)。
统一阶段两条路(都从 Mix-RL checkpoint 续训):
-
RFT(拒绝采样微调,off-policy):每个域专家 teacher 生成轨迹,只留命中
C+_u且 CoT 一致的「golden」轨迹,跨四域合并成D_RFT,标准 next-token 目标续训(公式 14–15,y_u=[CoT_u; c_u])。Figure 17:RFT 在大 K(候选覆盖)上一致占优,Recall@1 不一定提升——更利于「召回一组覆盖多兴趣的 item」。 -
MOPD(多教师 On-Policy 蒸馏,on-policy):Monte-Carlo RL 形式,只在 student 自采 token 上算 log-prob ratio(teacher 只需单点 log-prob,无需全词表分布)。token 级蒸馏优势(reverse-KL,公式 16):
配截断重要性权重
w_t(θ)(公式 17)纠 off-policy 偏差,surrogate loss(公式 18)。信息增益感知轨迹过滤:用s(y_j)=\frac{1}{T_i}\sum_t|\hat{A}_{\text{MOPD},j,t}|作 label-free 信息增益打分(公式 19),按降序取覆盖目标信息增益比 ρ(如 0.8)的最小前缀 M(公式 20),只优化高信息样本——解决海量「head item 已对齐 → 优势≈0」导致的梯度稀释。
5. CoT 分析诊断(2×2 框架)
为判断 CoT 是否真贡献预测,作者建 2×2 诊断矩阵(Symbolic vs Probabilistic × Local vs Global,Table 10):
- C1 ΔLL(CoT 似然增益,公式 21):
ΔLL=log p(y_GT|x,c)−log p(y_GT|x)。正值=CoT 提升对正确目标的置信。Figure 23:SFT 全四域为负(−5.19/−5.22/−4.94/−2.69),RFT 全转正(0.63/1.27/0.57/1.10)——RFT 让 CoT 从「干扰」变「有用证据」。 - C2 ℓ_t 沿 CoT 进展:
ℓ_t=log p(y_GT|x,c_1..c_t),应随推理段递增。RFT 比 SFT 更早饱和(暗示可做 CoT 压缩/早停)。 - C3 item 合法率 γ_legal(公式 24):SFT/RFT 四域均 100%(不再是瓶颈)。
- C4 历史接地率 γ_hist|legal(公式 25):RFT 在 Video(+2.50pt)/Ad(+4.27pt) 收紧、但 Live(−1.18pt)/Product(−14.59pt) 反降——与 Table 9 中 RFT 在 Live/Product 增益偏小一致,符号诊断与下游指标对齐。
实验设置与结果
数据/任务:自建 OneReason-Bench(扩展 RecIF-Bench),按 R0–R3 四层组织;R3 含 Single-Domain 与 Cross-Domain 推荐(Video/Product/Ad/Live)。指标:推荐与 grounding 用 Pass@K / Recall@K(itemic pattern 先解码成 item id 再算 item 粒度);QA/I2I 用 Accuracy;Evolution Selection 用 F1;Evolution 生成用 Action–Logic Score;Item Understanding 用 LLM-as-a-Judge。
Baselines:ID-Based(SASRec/HSTU)、Text-Based(Qwen3-8B/32B/235B、DeepSeek-V3.2、Claude-Opus-4.6、Gemini-3-Preview、GPT-4o-mini、GPT-5.4,零样本 + Qwen3-Embedding-8B ANN 检索)、Itemic-Token-Based(TIGER、LC-Rec 三变体)。
主结果(Cross-Domain,Pass@64,Table 14):
| 模型 | Cross-Video | Cross-Product | Cross-Ad | Cross-Live |
|---|---|---|---|---|
| SASRec / HSTU(ID) | 0.03 / 0.10 | 0.31 / 0.32 | 1.04 / 2.79 | 1.76 / 2.32 |
| GPT-5.4(文本,最强 LLM) | 0.24 | 1.43 | 1.64 | 7.20 |
| TIGER | 0.88 | 0.21 | 7.65 | 2.32 |
| LC-Rec-PT-SFT-8B(用本文预训练 ckpt 初始化) | 1.49 | 3.95 | 15.85 | 19.32 |
| OneReason SFT non-thinking | 1.33 | 3.94 | 15.73 | 18.05 |
| OneReason SFT thinking | 0.71 | 2.18 | 9.16 | 16.43 |
| OneReason RFT non-thinking | 2.08 | 5.20 | 17.56 | 21.01 |
| OneReason RFT thinking | 2.41 | 5.47 | 17.78 | 21.10 |
关键读法:① SFT 阶段 thinking 反而劣于 non-thinking(如 Cross-Ad 9.16 vs 15.73)——这正是「思考红利消失」的反常现象;② 经 RFT 后,thinking 全面反超 non-thinking——首次让思考模式在真实推荐基准上稳定占优;③ 通用 LLM 不随智能/规模线性变好(缺协同信号 + ANN caption→item 检索误差),OneReason 直接解码 itemic token 绕过该步;④ 33.69% 目标 item id 在训练中未见(冷启动重灾),而仅 11.55% 目标 itemic pattern 未见——itemic 表示天然抗冷启动。
优化策略对比(Cross-domain Recall@K,Table 9 摘录 Cross-Live thinking):
| 指标 | SFT | Mix-RL | Single-RL | RFT | MOPD |
|---|---|---|---|---|---|
| Recall@8 | 5.63 | 8.29 | 8.39 | 8.70 | 8.82 |
| Recall@32 | 11.17 | 13.03 | 14.69 | 14.63 | 14.82 |
| Recall@64 | 14.32 | 16.03 | 18.62 | 18.35 | 18.89 |
结论:所有 post-SFT 方法都显著超 SFT;Mix-RL 普遍弱于 Single-RL(异质域冲突信号)→ 验证 specialize-then-unify。RFT vs MOPD 各有域强项:RFT 保证 thinking>non-thinking 全域成立(蒸纯 golden CoT)、Video/Ad 大 K 稳定占优;MOPD 在 Product/Live 更强(甚至超 Live teacher),但因 on-policy 吸收噪声 CoT,thinking/non-thinking 提升高度同步、non-thinking 被大幅强化。
通用能力 sanity check(Table 16):
| 模型 | MMLU-Pro | GPQA-Diamond | MATH-500 | GSM8K |
|---|---|---|---|---|
| Qwen3-8B thinking | 72.35 | 56.06 | 95.20 | 95.68 |
| OneReason RFT thinking | 72.08 | 54.04 | 95.40 | 94.69 |
| OneReason SFT thinking | 71.01 | 51.52 | 95.60 | 95.00 |
| LC-Rec-SFT-Only-8B | 9.73 | 17.17 | 41.80 | 14.03 |
| LC-Rec-PT-SFT-8B | 39.72 | 35.86 | 81.00 | 51.55 |
OneReason 思考模式基本保住 Qwen3-8B 通用能力,而 LC-Rec 系列灾难性退化(MMLU-Pro 掉到 9.73–45)。
思考红利渗进不思考(Table 17,固定 0.25B token,全用 non-thinking 解码):
| 指标 | 设置 | Cross-Video | Cross-Product | Cross-Ad | Cross-Live |
|---|---|---|---|---|---|
| Pass@64 | 100K unCoT | 1.64 | 4.38 | 16.08 | 18.12 |
| Pass@64 | 40K CoT + 50K unCoT | 1.95 | 4.86 | 15.84 | 20.32 |
| Recall@64 | 100K unCoT | 0.18 | 3.33 | 6.72 | 15.59 |
| Recall@64 | 40K CoT + 50K unCoT | 0.21 | 3.67 | 6.68 | 17.69 |
即使推理只在训练时存在、推理时被抑制,CoT 监督仍能改善 non-thinking 解码(Video/Product/Live),唯 Cross-Ad 是反例(略降)。100K 样本固定的配比 sweep(Figure 25)进一步显示:多数域有中间最优(Video 偏平衡、Product 偏 CoT-heavy、Live 偏平衡/偏 CoT),Ad 曲线最平、最优点偏 unCoT 侧。作者给出概念性分解(公式 28):G_d(α)=B_d+A^uncot_d(α)+I^cot_d(1−α)−C^trace_d(1−α)−C^format_d(α,1−α),但明确声明这只是行为层证据,未能区分 compression vs reasoning 的贡献。
线上 A/B(最硬证据,快手本地生活广告,10 天,5% 流量,Fast-Slow Thinking)Table 18:
| 部署模型 | Impressions(曝光) | Revenue(收入) |
|---|---|---|
| OneReason(慢链路召回) | +0.940% | +4.528% |
| OneReason for OneRec(快链路 Thinking Token 注入) | +6.831% | +4.636% |
| Combined(组合部署) | +10.332% | +8.234% |
折合快手平台年化数亿 RMB 商业收入,ROI > 5,服务规模级用户。部署架构见下图:
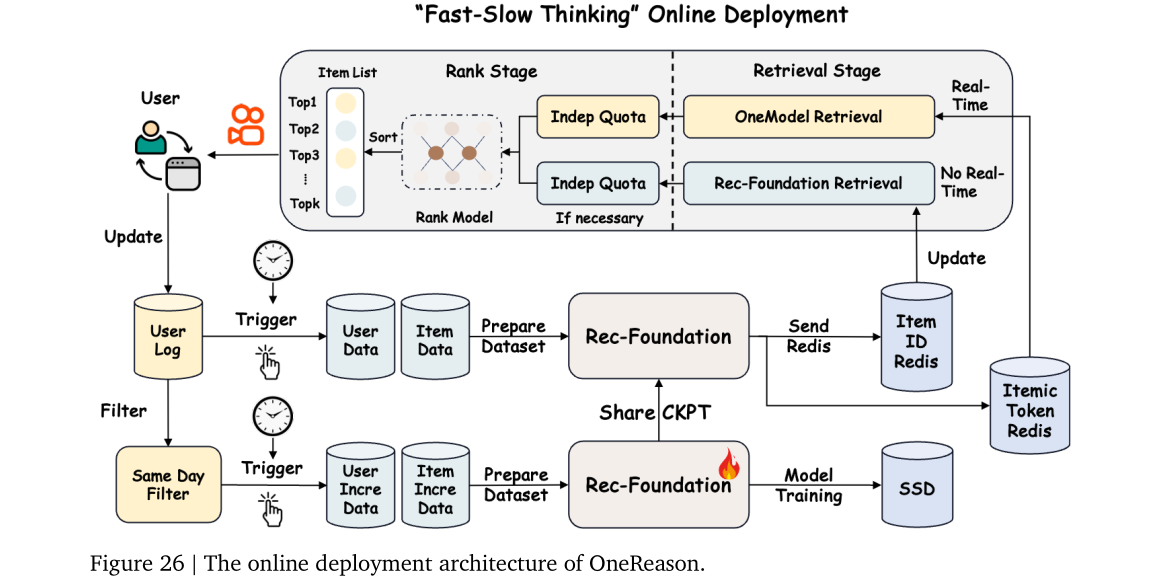
部署四步:① 解耦近线召回管线(不参与早期竞争,下游 ranking 联合打分,无结果时 fallback OneRec);② 数据触发(日/小时聚合行为/画像/内容,端到端飞轮);③ 离线推理(载最新 ckpt 预测 next itemic token,专用解码成 item id);④ 在线服务(写 Redis 候选池,与实时 OneRec 联合融合)。在线增量训练分预训练(窗口内新 item 续训 + 混采通用语料防遗忘)与 SFT(当日交互当监督,建模短期兴趣漂移)。两种应用范式:慢链路直接用 OneReason 召回;快链路「OneReason for OneRec」把最相关 itemic token 转 embedding,经专门 Thinking Token 把 OneReason 知识蒸进在线 OneRec。
思考与可参考价值
局限:
- 延迟靠近线离线绕道而非真正解决——「实时思考推荐」仍未实现,8B 推理塞进在线靠 Redis 候选池 + Thinking Token 蒸馏。
- CoT 起效机制黑盒——为何 CoT 监督能反哺 non-thinking 解码,作者坦诚「行为层证据,未能区分 compression vs reasoning」,公式 28 也只是概念性分解。
- 范式有适用边界——Cross-Ad 是 CoT 渗透的反例(短期转化/曝光信号更主导),说明不能默认全域上 CoT。
- 验证生态单一——仅 Qwen3 骨干 + 快手,跨模型族/跨平台泛化未证;线上仅本地生活广告一个子场景、5% 流量、10 天,覆盖窄。83+ 作者工程堆叠多、基准自造、对照口径偏自家,独立复现门槛高,且未开源代码(仅承诺开源 8B/0.8B 模型权重)。
对电商/搜索推荐/Agent 方向的可借鉴点:
- CoT/unCoT 配比是「依域而定」的可调旋钮——电商类(Cross-Product)偏 CoT-heavy、广告/转化类(Cross-Ad)偏 unCoT。值得在自己的 push/推荐场景做等 token 预算的配比 sweep(公式 26–27 的相对增益口径可直接复用),别一刀切上 CoT。
- 思考红利能渗进不思考解码——即使线上只能 System-1 直接解码,离线用 CoT 数据训练仍可能白赚增益(Table 17),低成本可试;这把 CoT 数据变成「数据飞轮」的一部分:CoT 强化骨干 → 更好的 non-thinking 候选/过滤信号 → 仅对难 cohort 保留显式思考。
- 「先专精后统一」对治多域冲突——多域混合 RL 思考红利消失、单域稳定胜出,是很可迁移的诊断;RFT(off-policy 蒸 golden CoT,保 thinking>non-thinking)与 MOPD(on-policy 多教师,强化 non-thinking 直觉)的取舍逻辑可直接套到多业务线统一模型。
- 推荐 RL 的稀疏奖励工程——两阶段 rollout(摊销 reasoning 成本)、第一位子 token 的多样性奖励、stage-wise clipping(reasoning 松/itemic 紧)、negative down-weighting、MOPD 的信息增益过滤——这套「让稀疏命中下 GRPO 不塌缩」的配方对任何「长 CoT + 短动作」的生成式决策都有参考价值。
- 「近线写 Redis 候选池 + Thinking Token 蒸馏」 是把大模型推理塞进实时推荐的现实工程解,比纠结实时推理更可落地。
- 下一个关键开放问题 = 作者没解的 compression vs reasoning 归因——能在受控环境分离两者本身即有价值的工作;以及「溯因式推荐推理」框架对 Agent 多智体兴趣建模的潜在迁移。